GCP AI/MLエコシステム:Vertex AI、AutoML、BigQuery ML、事前学習済みAPIとその使い分け
1. GCP MLの全体像
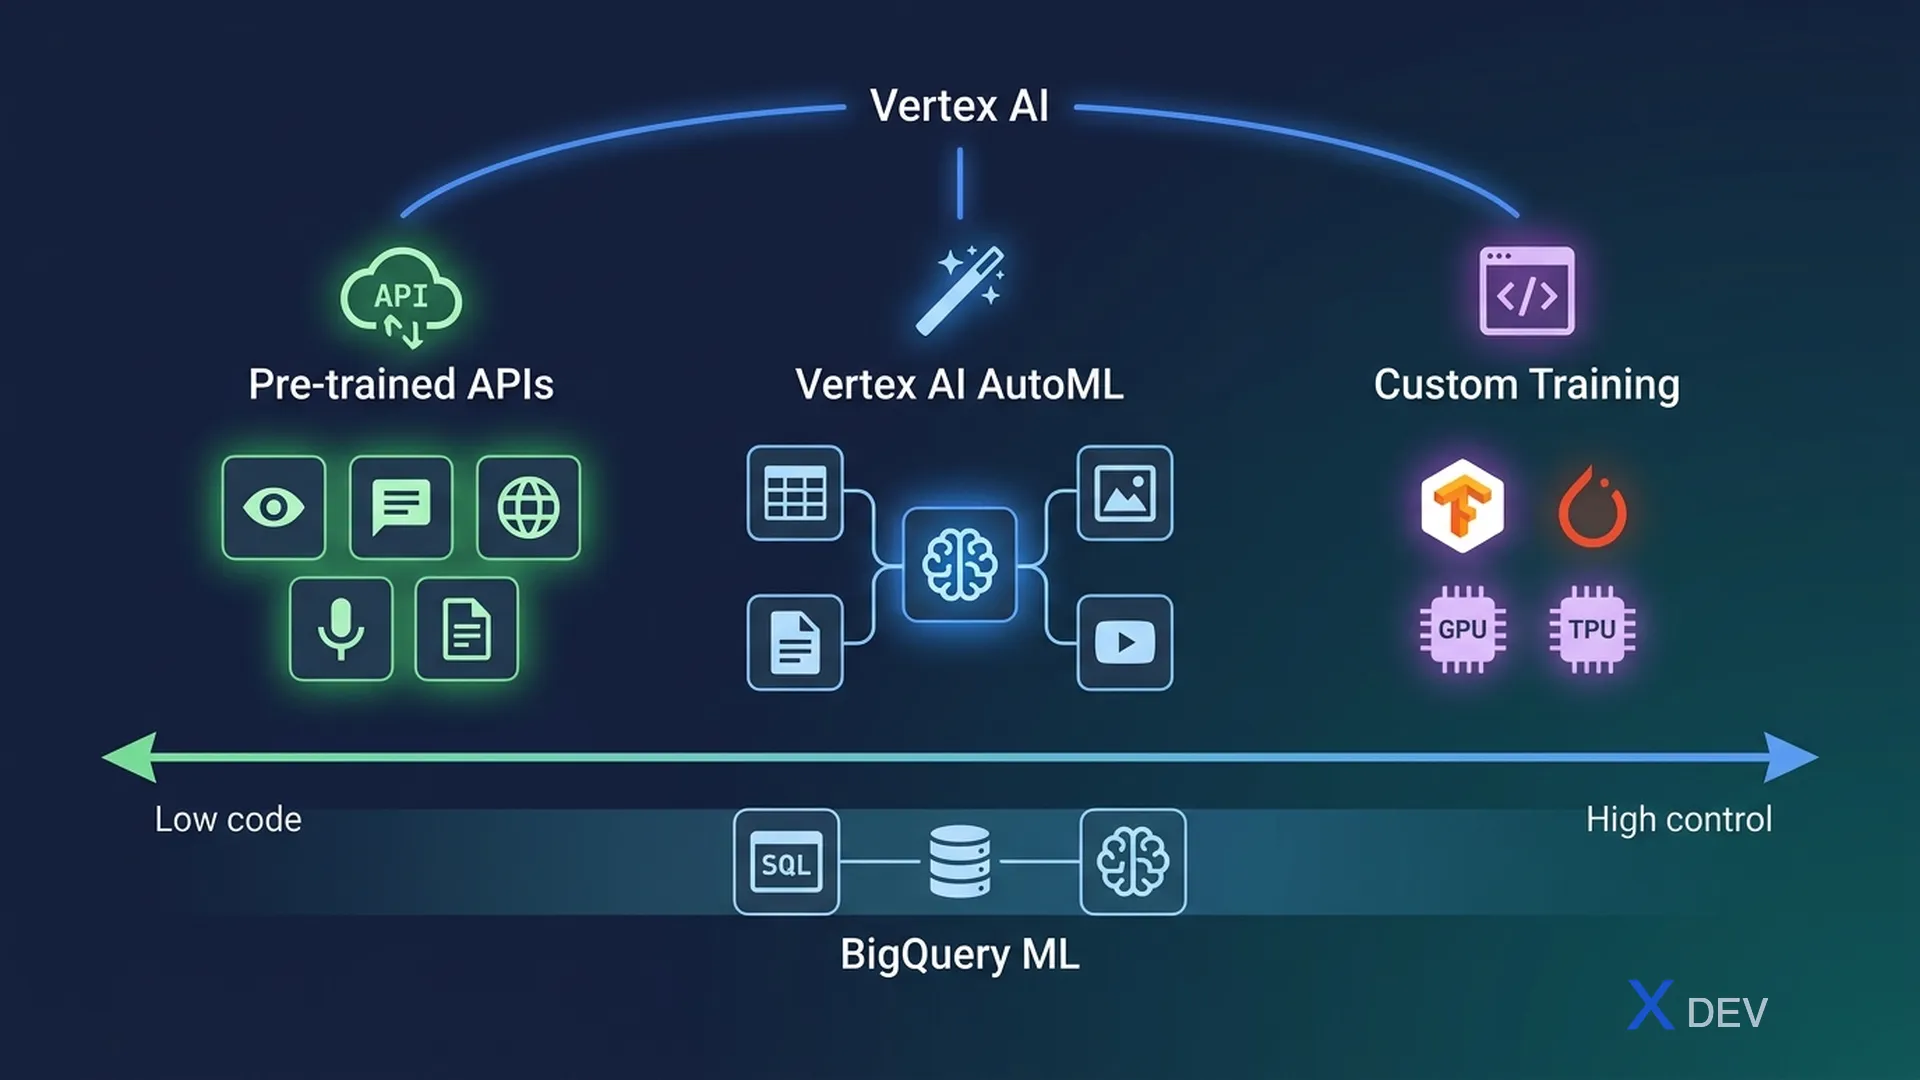
GCP ML Capability Spectrum:

LOW CODE ◄────────────────────────────────────► HIGH CONTROL
  │                        │                           │
  ▼                        ▼                           ▼
Pre-trained APIs      Vertex AI AutoML        Custom Training
(Vision, NLP,         (no code needed,        (full control,
Translation)          you bring data)         you bring code)
  │                        │                           │
No ML expertise       Some domain              ML expertise
needed                expertise               required

BigQuery ML ────── SQL interface for ML on warehouse data
2. Vertex AI — 統合MLプラットフォーム
Vertex AIはGCPのMLライフサイクル全体を統合するプラットフォームです。各コンポーネントを理解することは試験で必須です。
| コンポーネント | 目的 |
|---|---|
| Vertex AI Workbench | データサイエンティスト向けのマネージドJupyterノートブック |
| Vertex AI Training | カスタムトレーニングジョブ(CPU、GPU、TPU) |
| Vertex AI AutoML | ノーコードモデルトレーニング(Tabular、Image、Text、Video) |
| Vertex AI Endpoints | オンライン予測用のモデルデプロイ |
| Vertex AI Batch Prediction | 非同期バッチスコアリング |
| Vertex AI Feature Store | 学習/推論間で一貫した特徴量の提供 |
| Vertex AI Pipelines | Kubeflow PipelinesベースのMLワークフローオーケストレーション |
| Vertex AI Experiments | 実行の追跡、メトリクスの比較 |
| Vertex AI Model Registry | モデルのバージョン管理 |
| Vertex AI Model Monitoring | 特徴量スキューと予測ドリフトの検出 |
3. AutoML vs. カスタムトレーニング
| 基準 | AutoML | カスタムトレーニング |
|---|---|---|
| 必要なML専門知識 | 最小限 | 必要 |
| トレーニング時間 | 数時間(自動化) | 可変(制御可能) |
| モデルの解釈可能性 | 限定的 | 完全制御 |
| コスト | モデルあたり高額 | 使用した計算リソース分のみ |
| 最適な用途 | 迅速なプロトタイプ、標準的なタスク | カスタムアーキテクチャ、研究 |
| 対応データ型 | Tabular、Image、Text、Video | 任意(コードを記述) |
試験のヒント: 「チームにML専門知識がない」や「最短でデプロイ」→ AutoML。「カスタムニューラルアーキテクチャ」や「トレーニングループの完全制御」→ カスタムトレーニング。
4. BigQuery ML
BigQuery MLはSQLでMLモデルのトレーニングとサービングを可能にします — BigQueryからデータをエクスポートする必要はありません。
| モデルタイプ | SQLキーワード | ユースケース |
|---|---|---|
| 線形回帰 | LINEAR_REG | 価格予測 |
| ロジスティック回帰 | LOGISTIC_REG | 分類 |
| K-Meansクラスタリング | KMEANS | 顧客セグメンテーション |
| XGBoost | BOOSTED_TREE_CLASSIFIER/REGRESSOR | テーブルデータの分類/回帰 |
| ディープニューラルネットワーク | DNN_CLASSIFIER/DNN_REGRESSOR | 複雑なパターン |
| 行列分解 | MATRIX_FACTORIZATION | レコメンデーション |
| インポートしたTFモデル | TENSORFLOW | カスタムTFモデル |
5. 事前学習済みAI API
| API | 機能 | ユースケース |
|---|---|---|
| Cloud Vision API | ラベル、OCR、顔検出、ロゴ、セーフサーチ | トレーニング不要の画像分析 |
| Cloud Natural Language API | エンティティ、感情分析、構文解析、カテゴリ | テキスト分析 |
| Cloud Translation API | 100以上の言語ペア | 多言語コンテンツ |
| Cloud Speech-to-Text | 文字起こし、話者分離 | 音声処理 |
| Cloud Text-to-Speech | WaveNet音声、SSML | 音声UI、アクセシビリティ |
| Document AI | フォーム解析、請求書抽出 | ドキュメント自動化 |
| Recommendations AI | リアルタイム商品レコメンデーション | ECパーソナライゼーション |
6. サービス選択デシジョンツリー
WHICH GCP ML SERVICE?

Do you have LABELED DATA?
│
├── NO → Pre-trained API sufficient for your task (Vision, NLP)?
│         YES → Use Pre-trained API
│         NO  → Vertex AI Custom Training (unsupervised)
│
└── YES → Is your data already IN BigQuery?
          │
          ├── YES → BigQuery ML (SQL-based, fast, no export)
          │
          └── NO → Need rapid prototyping, no ML team?
                    │
                    ├── YES → Vertex AI AutoML
                    │
                    └── NO  → Vertex AI Custom Training
7. 練習問題
Q1: データ分析チームはBigQueryにペタバイト規模の顧客取引データを持っています。既存のSQLスキルを活用し、データをエクスポートせずに解約予測モデルを構築したいと考えています。最適なアプローチはどれでしょうか?
- A) Cloud Storageにエクスポートしてから、Vertex AIカスタムトレーニングを使用する
- B) Cloud Natural Language APIを使用する
- C) BigQuery MLでCREATE MODEL LOGISTIC_REGRESSIONを使用する ✓
- D) Vertex AI AutoML Tabularを使用する
解説:BigQuery MLは、既存のデータインフラとスキルを活用して、SQLで直接BigQueryデータ上で分類モデルをトレーニングできます。データがすでにBigQueryにある場合、これが最速のパスです。
Q2: 小規模なスタートアップが顧客レビューに感情分析を追加したいと考えています。MLチームはなく、ラベル付き感情データもありません。最も少ない労力で実現できるソリューションはどれでしょうか?
- A) Vertex AI AutoML Text Sentiment
- B) Vertex AI上でカスタムBERTモデルをトレーニングする
- C) Cloud Natural Language APIの感情分析 ✓
- D) BigQuery ML DNNクラシファイア
解説:Cloud Natural Language APIは、トレーニングデータ、ML専門知識、インフラのセットアップが不要な、事前学習済みのフルマネージドサービスです。APIを呼び出すだけです。AutoMLにはラベル付き感情データが必要で、カスタムBERTにはかなりの専門知識が必要です。
Q3: モデルのトレーニング時に使用された特徴量の値が予測時にも同一であることを保証するために、チームが使用すべきVertex AIコンポーネントはどれでしょうか?
- A) Vertex AI Experiments
- B) Vertex AI Feature Store ✓
- C) Vertex AI Model Registry
- D) Vertex AI Pipelines
解説:Vertex AI Feature Storeは、ML特徴量の保存、提供、共有のための集中型リポジトリを提供します。トレーニングとオンライン/バッチ予測の両方で同じ特徴量定義と値を使用することで、学習-推論の一貫性を確保し、学習-推論スキューを防止します。