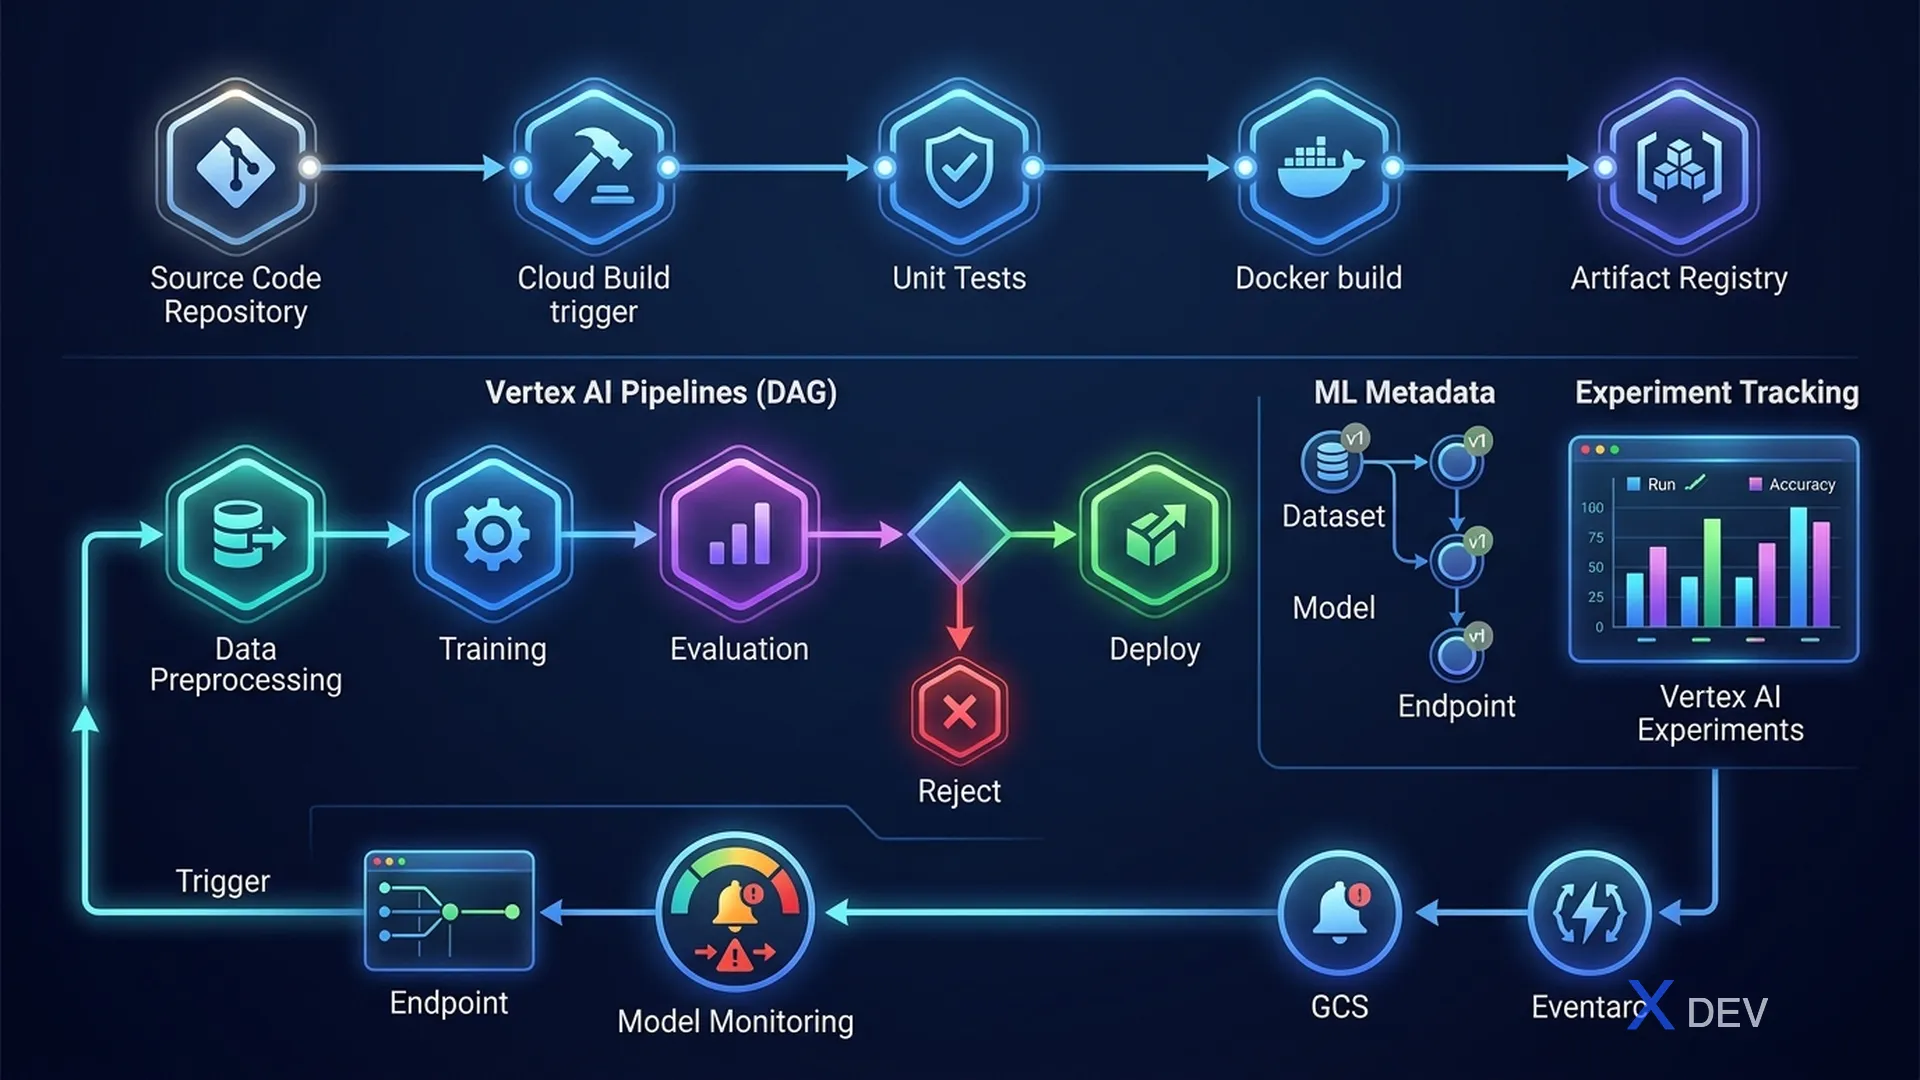
Vertex AI MLOps:Pipelines、CI/CD、Model Registry、本番ML向けモニタリング
1. MLOps成熟度レベル
| レベル | 説明 | 自動化 |
|---|---|---|
| レベル0 | 手動プロセス、スクリプトのみ | なし |
| レベル1 | MLパイプラインの自動化、継続的トレーニング | トレーニングパイプライン |
| レベル2 | ML向けの完全なCI/CD、自動再トレーニングトリガー | すべて |
2. Vertex AI Pipelines
Vertex AI PipelinesはKubeflow Pipelines(KFP)のマネージド実行環境です。パイプラインはPython SDKで定義され、YAMLにコンパイルされます。
Vertex AI Pipeline Structure:

@component (preprocess_data)
     ↓
@component (train_model)
     ↓
@component (evaluate_model)
     ↓ (if accuracy > threshold)
@component (deploy_model)

Each component = isolated Docker container
Artifacts (data, models) stored in Cloud Storage
Metadata tracked in Vertex ML Metadata Store
| パイプラインSDK | 備考 |
|---|---|
| Kubeflow Pipelines SDK v2 | Vertex AI Pipelinesの主要SDK |
| TFX | TensorFlow固有のパイプラインコンポーネント |
| Google Cloud Pipeline Components | Vertex AIサービス向けのビルド済みコンポーネント |
3. Vertex AI Model Monitoring
| モニタリングタイプ | 検出対象 |
|---|---|
| 特徴量スキューモニタリング | サービング時の特徴量分布 ≠ トレーニングベースライン |
| 特徴量ドリフトモニタリング | サービング時の特徴量分布が時間とともに変化 |
| 予測ドリフト | モデル出力分布が変化(間接的なラベルドリフト) |
Model Monitoring Workflow:

Training Data Baseline (BigQuery/GCS)
     ↓ (establish distribution)
Deploy to Endpoint with Monitoring enabled
     ↓ (collect serving requests)
Periodic Analysis (hourly/daily)
     ↓ (compare distributions)
Alert if skew/drift > threshold
     ↓
Retrain trigger → new Pipeline run
4. Vertex AI ExperimentsとMetadata
| コンポーネント | 目的 |
|---|---|
| Vertex AI Experiments | 実行間のハイパーパラメータ、メトリクス、アーティファクトを追跡 |
| ML Metadata Store | リネージの追跡:データ → モデル → エンドポイント |
| Vertex AI TensorBoard | トレーニングメトリクスの可視化(損失、精度曲線) |
5. GCP上のML向けCI/CD
ML CI/CD Pipeline on GCP:

Code Push to Cloud Source Repositories
     ↓
Cloud Build trigger (CI)
     ├── Unit tests for ML components
     ├── Data validation tests
     └── Build Docker image → push to Artifact Registry
          ↓
Vertex AI Pipeline trigger (CD/CT)
     ├── Data preprocessing
     ├── Model training
     ├── Model evaluation
     └── Conditional deployment → Vertex AI Endpoint
試験のヒント: ML向けCI/CD = Cloud Build(コードテスト + Dockerビルド)+ Vertex AI Pipelines(トレーニング + デプロイメントオーケストレーション)。Cloud Source RepositoriesはGCPのGitホスティングです。Artifact RegistryがContainer Registryに代わってDockerイメージを保存します。
6. 練習問題
Q1: 本番MLモデルの予測分布が3週間にわたって大幅にシフトしていますが、精度を直接測定するためのグラウンドトゥルースラベルはまだ利用できません。これを検出するVertex AIモニタリングタイプはどれでしょうか?
- A) 特徴量スキューモニタリング
- B) 予測ドリフトモニタリング ✓
- C) トレーニングデータバリデーション
- D) Vertex AI Experimentsベースライン比較
解説:予測ドリフトモニタリングは、モデルの出力分布が時間とともにどのように変化するかを追跡し、グラウンドトゥルースラベルが利用できない場合でもモデル劣化の間接的なシグナルとして機能します。特徴量スキューは、サービング時とトレーニング時の特徴量分布を比較します(既知のトレーニングベースラインが必要)。
Q2: チームが、データ前処理、モデルトレーニング、デプロイメントを含むVertex AI Pipelineを構築しています。監査可能性と再現性のために、すべての入力、出力、モデルアーティファクトを追跡する必要があります。このリネージ情報を保存するサービスはどれでしょうか?
- A) Cloud Logging
- B) Vertex AI ML Metadata Store ✓
- C) Cloud Storageバージョニング
- D) Vertex AI Experimentsダッシュボード
解説:Vertex AI ML Metadata Store(Vertex ML Metadataとも呼ばれる)は、どのデータセットがどのモデルを生成し、どのモデルがどのエンドポイントにデプロイされたかを、ハイパーパラメータや評価メトリクスを含めて自動的に追跡し、完全な来歴追跡を可能にします。
Q3: 企業が、Cloud Storageに新しいトレーニングデータが利用可能になるたびにMLモデルを自動的に再トレーニングしたいと考えています。再トレーニングはVertex AI Pipelineを実行し、メトリクスが閾値を超えた場合にデプロイする必要があります。パイプラインをトリガーするGCPサービスはどれでしょうか?
- A) Vertex AI Schedules
- B) Cloud Storage通知 + Cloud Functions/Eventarc → Vertex AI Pipelines ✓
- C) BigQueryスケジュールクエリ
- D) Cloud Scheduler単体
解説:Cloud Storageのオブジェクト完了通知はCloud FunctionsまたはEventarcをトリガーでき、それがプログラム的にVertex AI Pipelineの実行を開始します。これにより、イベント駆動の継続的トレーニング(MLOpsレベル1)が実現されます。Cloud Schedulerはデータの可用性ではなく時間に基づいてトリガーします。