はじめに
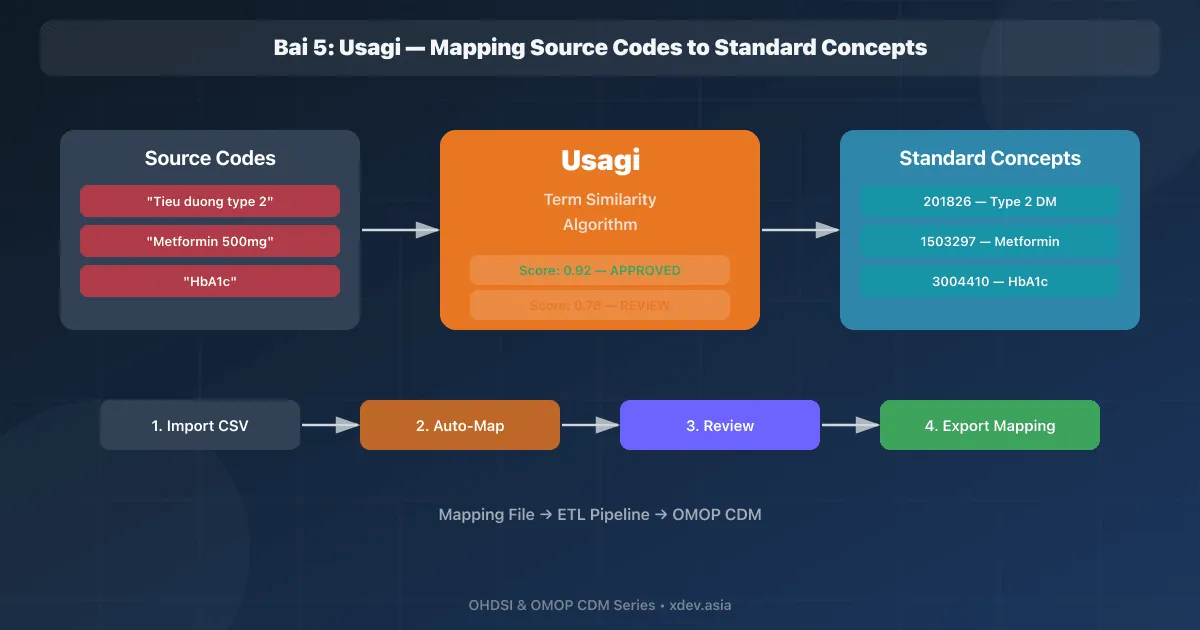
ETL プロセスで最も重要なステップは、ソース コード → 標準概念のマッピングです。多くのソース コード (ICD-10、社内医薬品コード、病院検査コード) には、Athena で使用できるマッピングがありません。
Usagi は、手動マッピング プロセスをサポートするツールです。用語類似性アルゴリズムを使用して候補を提案し、専門家がレビュー/承認するためのインターフェイスを提供します。
1.Usagi をインストールする
1.1 要件
# Java 17+
java -version

# Download Usagi từ GitHub
# https://github.com/OHDSI/Usagi/releases

# Download Vocabulary Index (cần thiết để Usagi hoạt động)
# Tải vocabulary từ Athena → Usagi sẽ build index tự động
1.2 起動
# Chạy Usagi
java -jar Usagi.jar

# Lần đầu: Usagi yêu cầu path đến vocabulary CSV files
# → Chọn thư mục chứa CONCEPT.csv, CONCEPT_RELATIONSHIP.csv, etc.
# → Usagi build Lucene index (~10-20 phút lần đầu)

# Sau khi index xong: Usagi sẵn sàng sử dụng
1.3 メインインターフェイス
┌─────────────────────────────────────────────────────────────┐
│  Usagi — Code Mapping Tool                                  │
│                                                             │
│  File  │  Help                                              │
│                                                             │
│  Source Codes          │  Mapping Candidates               │
│  ┌────────────────────┐│  ┌────────────────────────────────┐│
│  │ Code │ Name        ││  │ Concept ID │ Name    │ Score  ││
│  │──────┼─────────────││  │────────────┼─────────┼────────││
│  │ I10  │ Tăng HA     ││  │ 320128     │ Essent  │ 0.85   ││
│  │ E11  │ ĐTĐ type 2 ││  │ 316866     │ Hypert  │ 0.72   ││
│  │ J06  │ NKHHCT      ││  │ 4228112    │ Second  │ 0.65   ││
│  │ K29  │ Viêm DD    ││  │            │         │        ││
│  │ ...  │ ...         ││  │            │         │        ││
│  └────────────────────┘│  └────────────────────────────────┘│
│                        │                                    │
│  Status: [UNCHECKED ▼] │  [Approve] [Flag] [Search]        │
└─────────────────────────────────────────────────────────────┘
2. ワークフローうさぎ
2.1 ソースコードの準備
# Tạo file CSV với source codes cần mapping
# Columns bắt buộc: sourceCode, sourceName
# Columns tùy chọn: sourceFrequency, sourceAutoAssignedConceptIds

sourceCode,sourceName,sourceFrequency
I10,"Essential (primary) hypertension",15000
E11.9,"Type 2 diabetes mellitus without complications",12000
J06.9,"Acute upper respiratory infection unspecified",8000
K29.7,"Gastritis unspecified",5000
N18.9,"Chronic kidney disease unspecified",3000
AMLO5,"Amlodipine 5mg tab",10000
MET500,"Metformin 500mg tab",8000
GLUC,"Glucose mau",25000
HBA1C,"HbA1c",15000
ベトナムのデータに関する注記:
# Nếu source codes có tên tiếng Việt, thêm cột English translation
sourceCode,sourceName,sourceNameEnglish,sourceFrequency
I10,"Tăng huyết áp nguyên phát","Essential hypertension",15000
E11.9,"Đái tháo đường type 2","Type 2 diabetes mellitus",12000
J06.9,"Nhiễm khuẩn hô hấp trên cấp","Acute upper respiratory infection",8000
2.2 ソースコードのインポート
Bước 1: File → Import codes
Bước 2: Chọn CSV file đã chuẩn bị
Bước 3: Map columns:
         - Source code → sourceCode
         - Source name → sourceName
         - Source name English → sourceNameEnglish (nếu có)
         - Source frequency → sourceFrequency
Bước 4: Chọn target domain filter (Condition, Drug, Measurement...)
Bước 5: Click Import → Usagi chạy term similarity search
2.3 マッピング候補の確認
Cho mỗi source code, Usagi suggests mapping candidates:

Source: I10 — "Essential (primary) hypertension"
┌─────────────┬──────────────────────────────┬───────┬──────────┐
│ Concept ID  │ Concept Name                 │ Score │ Vocab    │
├─────────────┼──────────────────────────────┼───────┼──────────┤
│ 320128      │ Essential hypertension       │ 0.95  │ SNOMED   │ ← Best match
│ 316866      │ Hypertensive disorder        │ 0.75  │ SNOMED   │
│ 4133004     │ Malignant essential HTN      │ 0.72  │ SNOMED   │
│ 4228112     │ Secondary hypertension       │ 0.65  │ SNOMED   │
└─────────────┴──────────────────────────────┴───────┴──────────┘

Actions:
✅ Approve: Xác nhận mapping đúng (chọn concept 320128)
🔍 Search: Tìm thêm concepts nếu candidates không phù hợp
🚩 Flag: Đánh dấu cần review thêm bởi domain expert
❌ Skip: Bỏ qua (concept không có standard mapping)
2.4 マッピングステータス
UNCHECKED  → Chưa review
APPROVED   → Đã xác nhận mapping đúng
FLAGGED    → Cần review thêm (gửi cho bác sĩ/chuyên gia)
INVALID    → Không thể mapping (concept không tồn tại trong SNOMED)

Best practice:
- Luôn đặt APPROVED cho mappings chắc chắn
- FLAGGED cho các trường hợp cần domain expertise
- Tracking: frequency × status = ưu tiên review
3. 特殊なケースの処理
3.1 ICD-10 ベトナム
Vấn đề: ICD-10 Việt Nam có mở rộng nội địa
- ICD-10 quốc tế: I10 (Essential hypertension)
- ICD-10 VN: I10.0, I10.1 (mã mở rộng không có trong OMOP)

Giải pháp:
1. Map I10.0, I10.1 → parent concept I10
2. Hoặc tìm SNOMED concept tương đương trực tiếp
3. Document deviations trong ETL specification
3.2 国内医薬品
Vấn đề: Thuốc Việt Nam có tên thương mại không có trong RxNorm
- "Amlodipin STELLA 5mg" → không có trong RxNorm
- "Metformin Hậu Giang 500mg" → không có trong RxNorm

Giải pháp:
1. Map theo hoạt chất + liều + dạng bào chế
   "Amlodipin STELLA 5mg" → Amlodipine 5 MG Oral Tablet (RxNorm 1332419)

2. Sử dụng RxNorm Extension cho thuốc quốc tế

3. Nếu hoạt chất không có → map ở mức Ingredient
   "Thuốc ABC" → Ingredient concept trong RxNorm
3.3 内部テスト
Vấn đề: Mã xét nghiệm bệnh viện không phải LOINC
- "XN001" = "Glucose máu đói"
- "XN002" = "HbA1c"

Giải pháp trong Usagi:
1. Dùng tên tiếng Anh: "Fasting blood glucose"
2. Usagi search → LOINC 1558-6 (Fasting glucose)
3. Review unit: mg/dL vs mmol/L
4. Approve mapping
4. マッピング結果のエクスポート
4.1 CSV のエクスポート
File → Export source_to_concept_map

Output file chứa:
sourceCode,sourceConceptId,sourceVocabularyId,targetConceptId,targetVocabularyId,validStartDate,validEndDate,invalidReason
I10,45566052,ICD10CM,320128,SNOMED,2024-01-01,2099-12-31,
E11.9,45541578,ICD10CM,201826,SNOMED,2024-01-01,2099-12-31,
AMLO5,0,MY_HOSPITAL,1332419,RxNorm,2024-01-01,2099-12-31,
GLUC,0,MY_HOSPITAL,3004410,LOINC,2024-01-01,2099-12-31,
4.2 OMOP CDM へのインポート
-- Load mapping results vào SOURCE_TO_CONCEPT_MAP
\COPY source_to_concept_map
FROM '/path/to/usagi_export.csv'
WITH (FORMAT csv, HEADER true);

-- Verify mapping
SELECT
  stcm.source_code,
  stcm.source_vocabulary_id,
  c.concept_name AS target_concept,
  c.vocabulary_id AS target_vocabulary
FROM source_to_concept_map stcm
JOIN concept c ON stcm.target_concept_id = c.concept_id
LIMIT 20;
5. 品質指標のマッピング
5.1 カバレッジ分析
-- Tính coverage: bao nhiêu % source codes đã được mapping?

-- Total distinct source codes
SELECT COUNT(DISTINCT source_code) AS total_source_codes
FROM source_to_concept_map
WHERE source_vocabulary_id = 'MY_HOSPITAL';

-- Mapped codes (target_concept_id > 0)
SELECT COUNT(DISTINCT source_code) AS mapped_codes
FROM source_to_concept_map
WHERE source_vocabulary_id = 'MY_HOSPITAL'
  AND target_concept_id > 0;

-- By frequency (quan trọng hơn)
-- Ví dụ: 80% codes = 95% records
5.2 合格基準
Mục tiêu mapping coverage:
- Conditions (ICD-10): ≥ 95% by frequency
- Drugs: ≥ 90% by frequency
- Measurements: ≥ 90% by frequency
- Procedures: ≥ 85% by frequency

Nếu chưa đạt → focus vào high-frequency unmapped codes
6. ヒントとベストプラクティス
1. Bắt đầu với high-frequency codes
   → Sort by sourceFrequency DESC → mapping codes phổ biến trước

2. Sử dụng English translations
   → Usagi term similarity hoạt động tốt nhất với tiếng Anh

3. Batch review theo domain
   → Conditions trước, rồi Drugs, rồi Measurements
   → Mỗi domain cần chuyên gia khác nhau

4. Lưu file Usagi thường xuyên
   → File .usagi format → có thể share và continue mapping

5. Version control mapping files
   → Commit mapping CSV vào Git
   → Track thay đổi qua thời gian

6. Tổ chức mapping review sessions
   → 1 data engineer + 1 bác sĩ/dược sĩ
   → Engineer thao tác Usagi, expert validate clinical correctness

7. Re-run khi vocabulary update
   → Vocabulary mới có thể có mapping tốt hơn
概要
| コンセプト | 説明 |
|---|---|
| うさぎ | ツール マッピング ソース コード → OMOP 標準概念 |
| 用語の類似性 | 名前に基づいて最も近い概念を見つけるアルゴリズム |
| 承認済み | マッピングは専門家によって確認されました |
| フラグ付き | マッピングはドメインの専門家によるさらなるレビューが必要です |
| ソース_TO_CONCEPT_MAP | OMOP CDM テーブルにはカスタム マッピングが保存されます。 |
| 取材範囲 | 正常にマッピングされたソース コードの割合 |
次の記事: ETL パイプラインの構築 — ソース データから OMOP CDM まで