はじめに
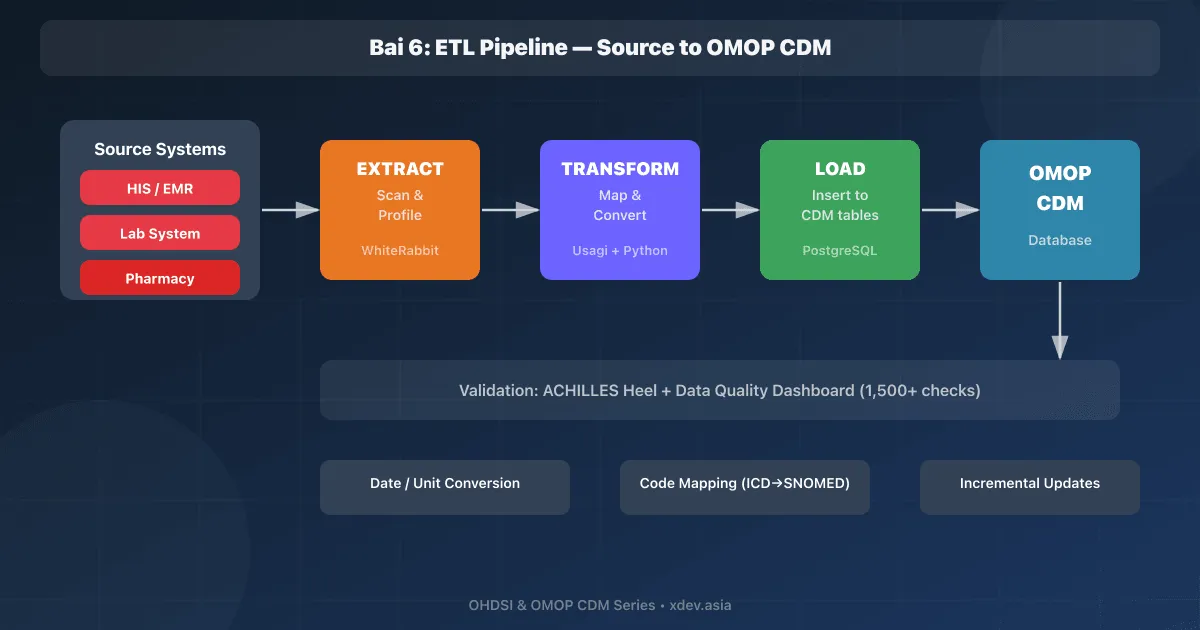
データをスキャンし (WhiteRabbit)、マッピングを設計し (Rabbit-in-a-Hat)、ソース コードをマッピング (Usagi) した後、次のステップは、実際の ETL パイプラインを実装して、データをソースから OMOP CDM に変換することです。
1. ETL パイプライン アーキテクチャ
1.1 概要
Source Database              Staging Area              OMOP CDM Database
┌──────────────┐    Extract  ┌───────────┐   Load     ┌──────────────┐
│ HIS Database │ ──────────→ │  Staging  │ ─────────→ │  OMOP CDM    │
│              │             │  Tables   │            │  Schema      │
│ patients     │             │           │            │              │
│ encounters   │    ┌────────┤ Transform │            │ PERSON       │
│ diagnoses    │    │        │  + Map    │            │ VISIT_OCC    │
│ medications  │    │        │  + Clean  │            │ CONDITION    │
│ lab_results  │    │        └───────────┘            │ DRUG_EXP     │
└──────────────┘    │                                 │ MEASUREMENT  │
                    │        ┌───────────┐            └──────────────┘
                    │        │ Mapping   │
                    └────────┤ Tables    │
                             │ (Usagi)   │
                             └───────────┘
1.2 ロード順序 (重要 - FK 制約)
1. LOCATION            ← Không có FK dependency
2. CARE_SITE           ← FK: location_id
3. PERSON              ← FK: location_id, care_site_id
4. OBSERVATION_PERIOD  ← FK: person_id
5. VISIT_OCCURRENCE    ← FK: person_id, care_site_id
6. VISIT_DETAIL        ← FK: person_id, visit_occurrence_id
7. CONDITION_OCCURRENCE← FK: person_id, visit_occurrence_id
8. DRUG_EXPOSURE       ← FK: person_id, visit_occurrence_id
9. PROCEDURE_OCCURRENCE← FK: person_id, visit_occurrence_id
10. MEASUREMENT        ← FK: person_id, visit_occurrence_id
11. OBSERVATION        ← FK: person_id, visit_occurrence_id
12. DEVICE_EXPOSURE    ← FK: person_id, visit_occurrence_id
13. CONDITION_ERA      ← Derived from CONDITION_OCCURRENCE
14. DRUG_ERA           ← Derived from DRUG_EXPOSURE
2. ETL 実装 (Python + SQL)
2.1 プロジェクトの構造
ohdsi-etl/
├── config/
│   ├── source_db.yaml        # Source DB connection
│   ├── cdm_db.yaml           # CDM DB connection
│   └── etl_config.yaml       # ETL parameters
├── mappings/
│   ├── usagi_conditions.csv  # Usagi export: conditions
│   ├── usagi_drugs.csv       # Usagi export: drugs
│   ├── usagi_measurements.csv# Usagi export: measurements
│   └── custom_mappings.csv   # Manual mappings
├── sql/
│   ├── extract/              # Source extraction queries
│   ├── transform/            # Transformation logic
│   └── load/                 # CDM load scripts
├── scripts/
│   ├── etl_person.py
│   ├── etl_visit.py
│   ├── etl_condition.py
│   ├── etl_drug.py
│   ├── etl_measurement.py
│   └── etl_era.py
├── tests/
│   ├── test_person.py
│   └── test_mappings.py
├── etl_runner.py             # Main ETL orchestrator
└── requirements.txt
2.2 ETL 個人テーブル
# scripts/etl_person.py
import pandas as pd
from sqlalchemy import create_engine, text

def etl_person(source_engine, cdm_engine):
    """Transform source patients → OMOP PERSON table."""

    # Extract
    query = """
    SELECT
        patient_id,
        gender,
        birth_date,
        ethnicity,
        address_province
    FROM patients
    WHERE birth_date IS NOT NULL
    """
    df = pd.read_sql(query, source_engine)

    # Transform
    # Gender mapping
    gender_map = {'M': 8507, 'F': 8532, 'Nam': 8507, 'Nữ': 8532}
    df['gender_concept_id'] = df['gender'].map(gender_map).fillna(0).astype(int)

    # Birth date components
    df['year_of_birth'] = pd.to_datetime(df['birth_date']).dt.year
    df['month_of_birth'] = pd.to_datetime(df['birth_date']).dt.month
    df['day_of_birth'] = pd.to_datetime(df['birth_date']).dt.day
    df['birth_datetime'] = pd.to_datetime(df['birth_date'])

    # Race (default Asian for Vietnamese data)
    df['race_concept_id'] = 8515  # Asian
    df['ethnicity_concept_id'] = 0

    # Person ID (sequential)
    df['person_id'] = range(1, len(df) + 1)

    # Prepare CDM columns
    person_df = df[[
        'person_id', 'gender_concept_id', 'year_of_birth',
        'month_of_birth', 'day_of_birth', 'birth_datetime',
        'race_concept_id', 'ethnicity_concept_id'
    ]].copy()

    person_df['person_source_value'] = df['patient_id']
    person_df['gender_source_value'] = df['gender']

    # Load
    person_df.to_sql('person', cdm_engine, if_exists='append',
                     index=False, method='multi', chunksize=5000)

    # Save person_id mapping for FK references
    id_map = df[['patient_id', 'person_id']].copy()
    id_map.to_sql('_etl_person_map', cdm_engine, if_exists='replace',
                  index=False)

    print(f"Loaded {len(person_df)} persons")
    return id_map
2.3 ETL 条件の発生
# scripts/etl_condition.py

def etl_condition(source_engine, cdm_engine, person_map, visit_map):
    """Transform source diagnoses → OMOP CONDITION_OCCURRENCE."""

    # Extract
    query = """
    SELECT
        d.diagnosis_id,
        d.patient_id,
        d.encounter_id,
        d.icd_code,
        d.diagnosis_date,
        d.diagnosis_type
    FROM diagnoses d
    WHERE d.icd_code IS NOT NULL
      AND d.diagnosis_date IS NOT NULL
    """
    df = pd.read_sql(query, source_engine)

    # Transform — Code mapping via SOURCE_TO_CONCEPT_MAP
    mapping_query = """
    SELECT
        source_code,
        source_concept_id,
        target_concept_id
    FROM source_to_concept_map
    WHERE source_vocabulary_id IN ('ICD10CM', 'ICD10', 'MY_HOSPITAL')
      AND target_vocabulary_id = 'SNOMED'
      AND invalid_reason IS NULL
    """
    code_map = pd.read_sql(mapping_query, cdm_engine)
    code_map = code_map.rename(columns={'source_code': 'icd_code'})

    # Join mapping
    df = df.merge(code_map, on='icd_code', how='left')
    df['condition_concept_id'] = df['target_concept_id'].fillna(0).astype(int)
    df['condition_source_concept_id'] = df['source_concept_id'].fillna(0).astype(int)

    # Join person_id
    df = df.merge(person_map, on='patient_id', how='inner')

    # Join visit_occurrence_id
    df = df.merge(visit_map, on='encounter_id', how='left')

    # Condition type
    df['condition_type_concept_id'] = 32817  # EHR

    # Condition status
    status_map = {'MAIN': 32902, 'SUB': 32908}
    df['condition_status_concept_id'] = df['diagnosis_type'].map(status_map).fillna(0)

    # Prepare CDM columns
    condition_df = pd.DataFrame({
        'condition_occurrence_id': range(1, len(df) + 1),
        'person_id': df['person_id'],
        'condition_concept_id': df['condition_concept_id'],
        'condition_start_date': pd.to_datetime(df['diagnosis_date']),
        'condition_start_datetime': pd.to_datetime(df['diagnosis_date']),
        'condition_end_date': None,
        'condition_type_concept_id': df['condition_type_concept_id'],
        'condition_status_concept_id': df['condition_status_concept_id'],
        'visit_occurrence_id': df.get('visit_occurrence_id'),
        'condition_source_value': df['icd_code'],
        'condition_source_concept_id': df['condition_source_concept_id'],
    })

    # Load
    condition_df.to_sql('condition_occurrence', cdm_engine,
                        if_exists='append', index=False,
                        method='multi', chunksize=5000)

    print(f"Loaded {len(condition_df)} condition occurrences")
    print(f"  Mapped: {(condition_df['condition_concept_id'] > 0).sum()}")
    print(f"  Unmapped: {(condition_df['condition_concept_id'] == 0).sum()}")
2.4 ETL測定
# scripts/etl_measurement.py

def etl_measurement(source_engine, cdm_engine, person_map, visit_map):
    """Transform source lab_results → OMOP MEASUREMENT."""

    query = """
    SELECT
        lr.result_id,
        lr.patient_id,
        lr.encounter_id,
        lr.test_code,
        lr.test_name,
        lr.result_value,
        lr.result_unit,
        lr.result_date,
        lr.reference_low,
        lr.reference_high
    FROM lab_results lr
    WHERE lr.result_date IS NOT NULL
    """
    df = pd.read_sql(query, source_engine)

    # Mapping test_code → LOINC concept
    code_map = pd.read_sql("""
        SELECT source_code AS test_code,
               source_concept_id,
               target_concept_id AS measurement_concept_id
        FROM source_to_concept_map
        WHERE target_vocabulary_id = 'LOINC'
    """, cdm_engine)

    df = df.merge(code_map, on='test_code', how='left')
    df['measurement_concept_id'] = df['measurement_concept_id'].fillna(0).astype(int)

    # Unit mapping
    unit_map = {
        'mg/dL': 8840, 'mmol/L': 8753, 'g/dL': 8713,
        '%': 8554, 'U/L': 8645, 'mEq/L': 9557,
        'cells/uL': 8784, 'pg': 8564, 'fL': 8585
    }
    df['unit_concept_id'] = df['result_unit'].map(unit_map).fillna(0).astype(int)

    # Numeric value
    df['value_as_number'] = pd.to_numeric(df['result_value'], errors='coerce')

    # Join person & visit
    df = df.merge(person_map, on='patient_id', how='inner')
    df = df.merge(visit_map, on='encounter_id', how='left')

    measurement_df = pd.DataFrame({
        'measurement_id': range(1, len(df) + 1),
        'person_id': df['person_id'],
        'measurement_concept_id': df['measurement_concept_id'],
        'measurement_date': pd.to_datetime(df['result_date']),
        'measurement_type_concept_id': 32817,
        'value_as_number': df['value_as_number'],
        'unit_concept_id': df['unit_concept_id'],
        'range_low': pd.to_numeric(df['reference_low'], errors='coerce'),
        'range_high': pd.to_numeric(df['reference_high'], errors='coerce'),
        'visit_occurrence_id': df.get('visit_occurrence_id'),
        'measurement_source_value': df['test_code'],
        'unit_source_value': df['result_unit'],
        'value_source_value': df['result_value'],
    })

    measurement_df.to_sql('measurement', cdm_engine,
                          if_exists='append', index=False,
                          method='multi', chunksize=5000)

    print(f"Loaded {len(measurement_df)} measurements")
3. ETL ランナー — オーケストレーション
# etl_runner.py
from sqlalchemy import create_engine
from scripts.etl_person import etl_person
from scripts.etl_visit import etl_visit
from scripts.etl_condition import etl_condition
from scripts.etl_drug import etl_drug
from scripts.etl_measurement import etl_measurement
from scripts.etl_era import build_condition_era, build_drug_era

def main():
    source = create_engine('postgresql://user:pass@source-db:5432/hospital')
    cdm = create_engine('postgresql://user:pass@cdm-db:5432/ohdsi')

    print("=== OHDSI ETL Pipeline ===")

    # Step 1: Person
    print("\n[1/7] Loading PERSON...")
    person_map = etl_person(source, cdm)

    # Step 2: Visit
    print("\n[2/7] Loading VISIT_OCCURRENCE...")
    visit_map = etl_visit(source, cdm, person_map)

    # Step 3: Conditions
    print("\n[3/7] Loading CONDITION_OCCURRENCE...")
    etl_condition(source, cdm, person_map, visit_map)

    # Step 4: Drugs
    print("\n[4/7] Loading DRUG_EXPOSURE...")
    etl_drug(source, cdm, person_map, visit_map)

    # Step 5: Measurements
    print("\n[5/7] Loading MEASUREMENT...")
    etl_measurement(source, cdm, person_map, visit_map)

    # Step 6: Derived — Condition ERA
    print("\n[6/7] Building CONDITION_ERA...")
    build_condition_era(cdm)

    # Step 7: Derived — Drug ERA
    print("\n[7/7] Building DRUG_ERA...")
    build_drug_era(cdm)

    print("\n=== ETL Complete ===")

if __name__ == '__main__':
    main()
4. データの検証
4.1 ETL 後のチェック
-- Check: Coverage summary
SELECT 'PERSON' AS table_name, COUNT(*) AS row_count FROM person
UNION ALL
SELECT 'VISIT_OCCURRENCE', COUNT(*) FROM visit_occurrence
UNION ALL
SELECT 'CONDITION_OCCURRENCE', COUNT(*) FROM condition_occurrence
UNION ALL
SELECT 'DRUG_EXPOSURE', COUNT(*) FROM drug_exposure
UNION ALL
SELECT 'MEASUREMENT', COUNT(*) FROM measurement;

-- Check: Unmapped rates
SELECT
  'CONDITION' AS domain,
  COUNT(*) AS total,
  SUM(CASE WHEN condition_concept_id = 0 THEN 1 ELSE 0 END) AS unmapped,
  ROUND(100.0 * SUM(CASE WHEN condition_concept_id = 0 THEN 1 ELSE 0 END) / COUNT(*), 2) AS unmapped_pct
FROM condition_occurrence;

-- Check: Orphan records (person_id not in person table)
SELECT COUNT(*) AS orphan_conditions
FROM condition_occurrence co
LEFT JOIN person p ON co.person_id = p.person_id
WHERE p.person_id IS NULL;

-- Check: Future dates
SELECT COUNT(*) AS future_conditions
FROM condition_occurrence
WHERE condition_start_date > CURRENT_DATE;
5. 増分 ETL 戦略
Full ETL:
- Chạy lần đầu hoặc khi cần rebuild
- Truncate CDM tables → Load toàn bộ
- Thời gian: hours-days (tùy volume)

Incremental ETL:
- Chạy hàng ngày/tuần
- Chỉ extract records mới/thay đổi
- Track bằng: modified_date, sequence_id, CDC

Strategy:
┌─────────────────────────────────────────────────────┐
│ 1. Extract: WHERE modified_date > last_etl_date     │
│ 2. Transform: Same logic as full ETL                │
│ 3. Load: UPSERT (INSERT ON CONFLICT UPDATE)         │
│ 4. Update: last_etl_date = NOW()                    │
└─────────────────────────────────────────────────────┘
概要
| ステップ | 活動内容 | 出力 |
|---|---|---|
| 抜粋 | ソース DB からの SQL クエリ | 生データ |
| 変換 | コードマッピング、型変換、クリーニング | CDM 対応データ |
| ロード | OMOP CDM テーブルに挿入 (正しい FK 順序) | OMOP CDM が実装されました |
| 検証 | ETL 後のチェック、カバレッジ分析 | 品質レポート |
| 時代の構築 | CONDITION_ERA、DRUG_ERA を導出 | 派生テーブル |
次の記事: PostgreSQL に OMOP CDM データベースをインストールする