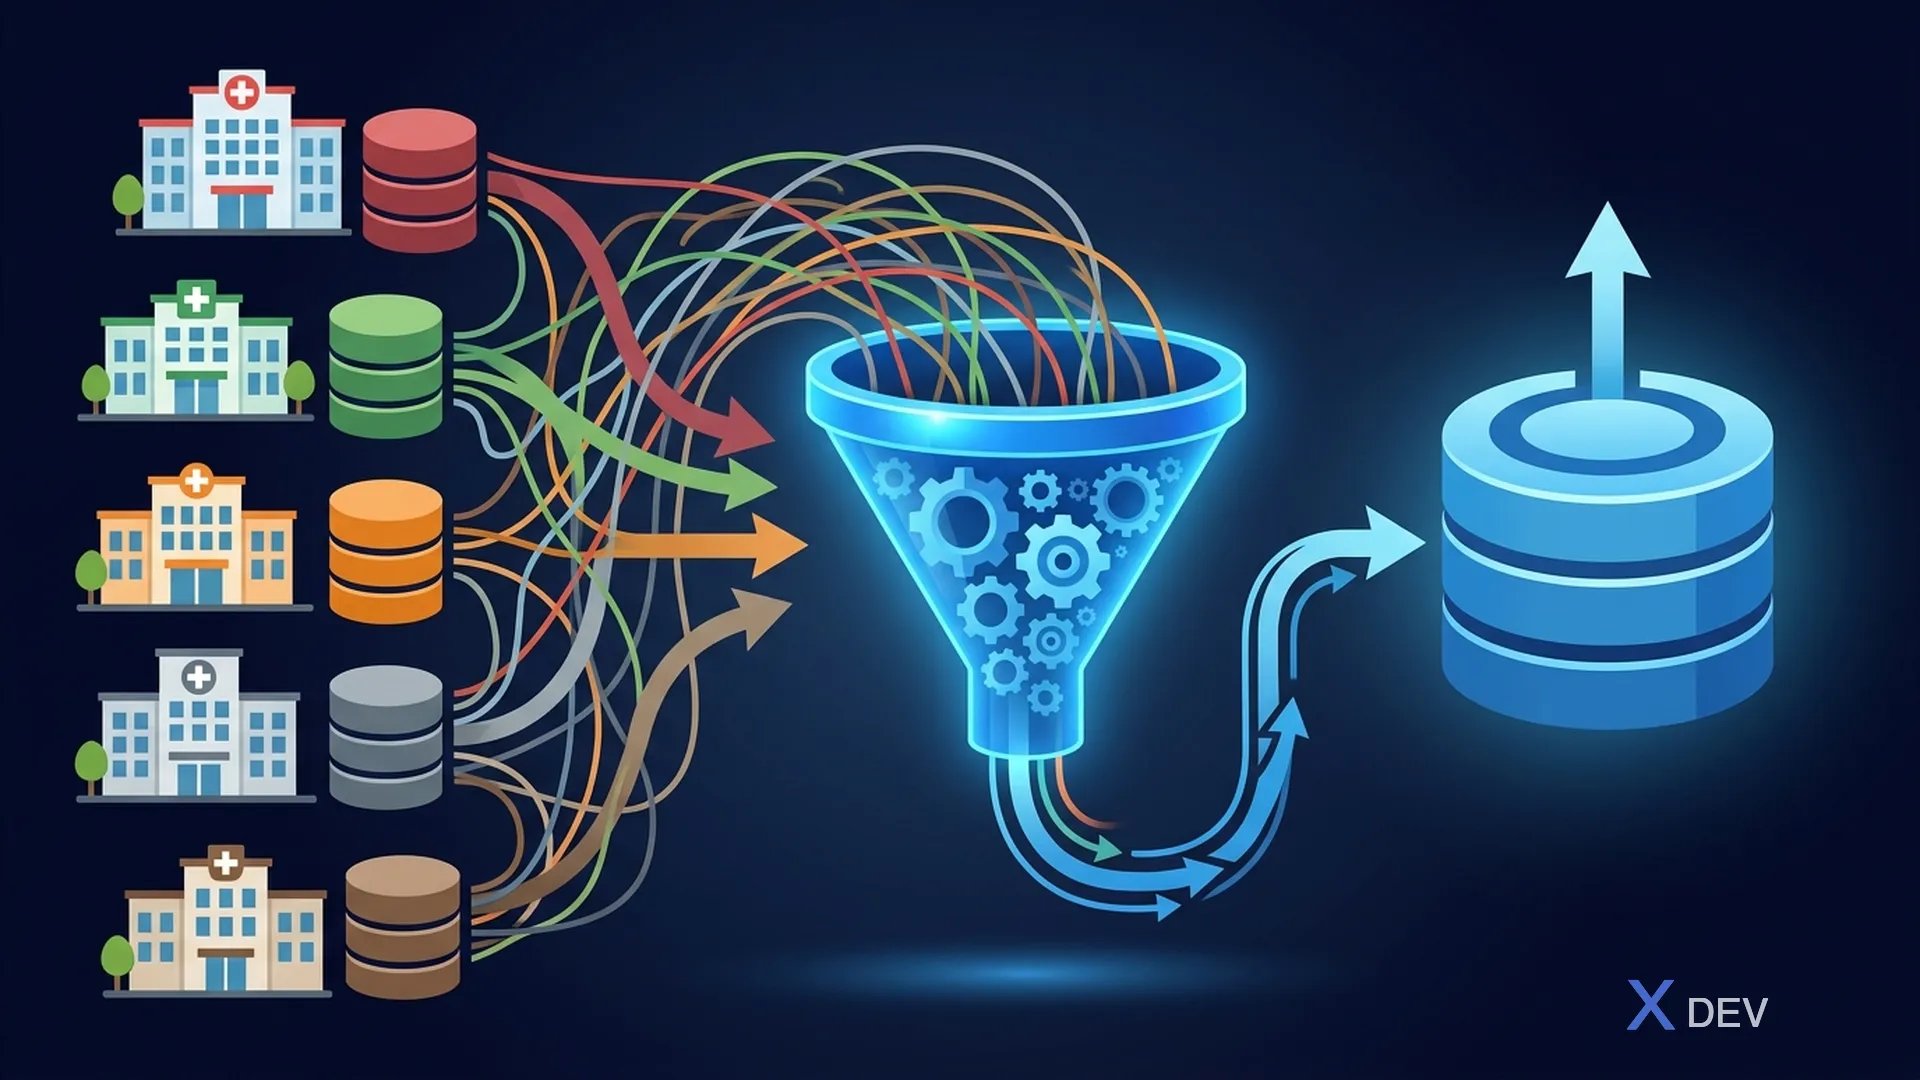
はじめに
「A 病院と B 病院は、同じ病気を治療しているにもかかわらず、なぜデータを比較できないのか」と考えたことはありますか?多くの国で 1,000 万人の患者を対象に薬の有効性を研究することがなぜこれほど難しいのでしょうか?
答えは医療データの断片化にあります。 OMOP CDM がその解決策です。
1. 問題: 医療データは断片化されている
###1.1.モデルごとに 1 つのシステム
各病院は異なる管理ソフトウェア (HIS/EMR) を使用し、データを独自の構造に保存します。
┌─────────────────────────────────────────────────────────────────┐
│  Bệnh viện Chợ Rẫy (HIS)                                       │
│  ├── BENHNHAN (ma_bn, ho_ten, ngay_sinh, gioi_tinh)           │
│  ├── KHAMBENH (ma_kham, ma_bn, ngay_kham, bac_si)             │
│  ├── CHANDOAN (ma_cd, icd10_code, loai_chandoan)              │
│  └── DONTHUOC (ma_don, ten_thuoc, ham_luong, so_luong)        │
├─────────────────────────────────────────────────────────────────┤
│  Bệnh viện Bạch Mai (EMR)                                       │
│  ├── patients (patient_id, full_name, dob, sex)                │
│  ├── encounters (enc_id, patient_id, visit_date, physician)    │
│  ├── diagnoses (dx_id, icd_code, dx_type, priority)            │
│  └── medications (med_id, drug_name, dosage, quantity)          │
├─────────────────────────────────────────────────────────────────┤
│  BHXH Việt Nam                                                    │
│  ├── HO_SO_KCB (ma_hs, ma_the, noi_kcb)                       │
│  ├── CHI_TIET_BENH (ma_benh, ten_benh)                         │
│  └── CHI_TIET_THUOC (ma_thuoc, ten_thuoc, don_gia)            │
└─────────────────────────────────────────────────────────────────┘
「患者」、「診断」、「薬」は一緒に保存されますが、次のとおりです。
- テーブル名が異なります(
BENHNHAN対patients対HO_SO_KCB) - 列名が異なります(
gioi_tinh対sex対なし) - 疾患コードは、ICD-10-VN、ICD-10-CM、または内部コードを使用できます
- 医薬品コード 有効成分 (アモキシシリン/クラブラン酸塩) ではなく商品名 (オーグメンチン) で表記
- 形式が異なります (日付 dd/mm/yyyy と yyyy-mm-dd)
###1.2.結果
| 問題 | 説明 |
|---|---|
| 合成できません | 3 つの病院のデータを統合するには数か月かかりました |
| 比較できません | 糖尿病の合併症率: 定義が異なるため異なる |
| 研究が遅い | 多施設共同研究はデータ部分だけで 1 ~ 2 年かかりました。 |
| AI/ML は実装が難しい | データ BV A の列車モデルは BV B では実行できません。 |
| 疾病監視 | 全国をリアルタイムに監視できない |
2. 解決策: OMOP 共通データ モデル
###2.1. OMOP CDM とは何ですか?
OMOP CDM (Observational Medical Outcomes Partnership Common Data Model) は、観察された健康データを編成および保存する方法を定義するオープン スタンダードです。
簡単に言うと、OMOP CDM は、あらゆる医療データ ソースに変換できる 統合データベース ブループリント です。
                    ETL (Extract-Transform-Load)

  HIS Bệnh viện A ──────┐
                         │
  EMR Bệnh viện B ──────┤     ┌───────────────────────┐
                         ├────→│   OMOP CDM Database    │────→ Phân tích thống nhất
  BHXH Data ─────────────┤     │   (PostgreSQL/SQL)     │────→ Nghiên cứu đa trung tâm
                         │     └───────────────────────┘────→ AI/ML
  Phòng khám tư ─────────┘
###2.2.主な特長
| 特長 | 説明 |
|---|---|
| 個人中心 | 患者を取り巻くすべてのデータ (PERSON 表) |
| イベントベース | 各医療イベントは個別の記録 (診察、検査、処方) です。 |
| 標準化された語彙 | 内部コードの代わりに標準辞書を使用する |
| オープンソース | 無料、オープンソース、コミュニティ開発 |
| リレーショナル モデル | 標準の RDBMS (PostgreSQL、SQL Server、Oracle) を使用する |
###2.3.視覚的な例
チョーライ病院で診察を受けた45歳の女性患者は2型糖尿病と診断され、メトホルミンを処方されました。
以前 (オリジナルの HIS):
BENHNHAN: ma_bn=12345, ho_ten='Nguyễn Thị Lan', ngay_sinh='1980-03-15', gioi_tinh='Nu'
KHAMBENH: ma_kham=K001, ngay_kham='2024-06-10', bac_si='BS. Trần Văn A'
CHANDOAN: icd10='E11', loai='chinh', ten='Đái tháo đường type 2'
DONTHUOC: ten_thuoc='Glucophage 500mg', so_luong=60, lieu='2 viên/ngày'
後 (OMOP CDM 5.4):
PERSON:       person_id=12345, gender_concept_id=8532 (Female),
              year_of_birth=1980, month_of_birth=3, day_of_birth=15

VISIT_OCCURRENCE: visit_id=V001, person_id=12345,
              visit_concept_id=9202 (Outpatient Visit),
              visit_start_date='2024-06-10'

CONDITION_OCCURRENCE: person_id=12345, visit_id=V001,
              condition_concept_id=201826 (Type 2 diabetes mellitus),
              -- [SNOMED CT concept]
              condition_source_value='E11'

DRUG_EXPOSURE: person_id=12345, visit_id=V001,
              drug_concept_id=1503297 (Metformin 500 MG Oral Tablet),
              -- [RxNorm concept]
              quantity=60, days_supply=30,
              drug_source_value='Glucophage 500mg'
重要な違い:
gioi_tinh='Nu'→gender_concept_id=8532(国際標準の考え方)icd10='E11'→condition_concept_id=201826(SNOMED CT、source_value='E11' を保持)Glucophage 500mg→drug_concept_id=1503297(RxNorm 成分 + 投与量、source_value を維持)
##3. 歴史が生まれる
###3.1. OMOPプロジェクト (2008-2013)
2008 ─── FDA khởi xướng dự án OMOP (Observational Medical Outcomes Partnership)
  │      Mục tiêu: nghiên cứu an toàn thuốc sau khi đưa ra thị trường
  │
2009 ─── Phát triển CDM phiên bản đầu tiên
  │      Áp dụng cho 10 nguồn dữ liệu tại Mỹ
  │
2012 ─── CDM v4 được phát hành
  │      Bắt đầu mở rộng ra nhiều loại dữ liệu y tế
  │
2013 ─── Dự án OMOP kết thúc → Chuyển giao cho cộng đồng OHDSI
###3.2. OHDSI コミュニティ (2014 年から現在)
2014 ─── OHDSI (Observational Health Data Sciences and Informatics)
  │      thành lập tại Columbia University
  │      Phát triển CDM v5.0
  │
2017 ─── CDM v5.2 — Thêm COST table thống nhất
  │
2018 ─── CDM v5.3 — Survey module, improved Visit model
  │
2021 ─── CDM v5.4 ← PHIÊN BẢN HIỆN TẠI
  │      Thêm EPISODE, EPISODE_EVENT tables
  │      Thêm measurement_event_id, observation_event_id
  │
2024 ─── Hơn 400 tổ chức trên 80+ quốc gia tham gia
         Hơn 800 triệu bản ghi bệnh nhân đã chuyển đổi
###3.3.なぜ CDM 5.4 なのか?
バージョン 5.4 は、OHDSI コミュニティによって推奨される最新の安定バージョンです。
- 37ポンド 科学的に整理された
- 腫瘍学サポート (がん治療ラインの EPISODE/EPISODE_EVENT)
- イベント連携の改善 (measurement_event_id、observation_event_id)
- 実稼働環境で実証済み — 400 以上の組織で導入されています
4. OMOP CDM と他の標準との比較
| 基準 | OMOP CDM | FHIR | HL7 v2/v3 | オープンEHR |
|---|---|---|---|---|
| 主な目的 | 分析と研究 | データ交換 | メッセージを渡す | EHRアーカイブ |
| データモデル | リレーショナル (SQL) | JSON/XML リソース | メッセージ | アーキタイプ |
| 語彙 | 内蔵標準セット | 柔軟 | コードシステム | 用語 |
| 使用例 | 遡及分析、RWE | API の相互運用性 | システムインテグレーション | 臨床記録 |
| 分析が簡単 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐ | ⭐⭐⭐ |
| コミュニティ ツール | アトラス、アキレス、ハデス | FHIR でスマート | さまざま | 臨床の原型 |
注: OMOP CDM と FHIR は相互に補完します。FHIR はリアルタイム データ交換用、OMOP CDM は遡及分析用です。多くの組織は、取得に FHIR → ETL → 分析に OMOP CDM を使用しています。
5. 実用化
###5.1.大規模研究
- COVID-19 Studyathon (2020): OHDSI が 20 か国以上の 21 億件の患者記録を 2 週間以内に分析
- 薬物の安全性: 1 億人以上の患者の実データから薬物の副作用を検出
- 有効性の比較: 多施設データに関する 2 つの治療法の有効性を比較します。
###5.2.ベトナムでは
- 大病院は、HIS → OMOP CDM の変換を試験的に実施しています
- 公衆衛生研究 は OMOP CDM を使用して社会保険データを分析しています
- スタートアップ HealthTech が OMOP に基づく医療データ分析プラットフォームを構築
###5.3. OMOP CDM 上の AI/ML
  OMOP CDM Database
  ┌─────────────────────────────────────────┐
  │ Chuẩn hóa → Đồng nhất → Phân tích      │
  │                                          │
  │  ┌─────────────┐   ┌─────────────────┐  │
  │  │ Cohort      │   │ Feature         │  │
  │  │ Definition  │──→│ Extraction      │────→ ML Model
  │  │ (ATLAS)     │   │ (FeatureExtract)│  │
  │  └─────────────┘   └─────────────────┘  │
  │                                          │
  │  Cùng 1 model chạy trên N databases     │
  └─────────────────────────────────────────┘
標準化されたデータのおかげで、病院 A のデータでトレーニングされた ML モデルは、コードを変更することなく病院 B のデータで検証できます。
6. OHDSI エコシステム
OMOP CDM は独立したものではなく、OHDSI エコシステムの中心にあります。
                     ┌──────────────┐
                     │   Athena     │  ← Tra cứu Vocabulary
                     └──────┬───────┘
                            │
 ┌──────────┐    ┌──────────┴──────────┐    ┌──────────────┐
 │  Usagi   │    │                      │    │  ACHILLES    │
 │ (Mapping)│───→│    OMOP CDM 5.4     │←───│ (Data Quality│
 └──────────┘    │    Database          │    │  Profiling)  │
                 │                      │    └──────────────┘
 ┌──────────┐    │  ┌──────────────┐   │    ┌──────────────┐
 │WhiteRabbit│───→│  │  WebAPI      │   │    │   HADES      │
 │(ETL Scan) │   │  │  (REST API)  │   │←───│ (R Packages) │
 └──────────┘    │  └──────────────┘   │    └──────────────┘
                 │         ↑           │
                 └─────────┼───────────┘
                           │
                    ┌──────┴───────┐
                    │    ATLAS     │  ← Phân tích & Cohort
                    └──────────────┘
このシリーズでは、OMOP CDM 5.4 構造に 100% 焦点を当てます。 OHDSI ツールについて詳しくは、シリーズを参照してください。 OHDSI および OMOP CDM — 包括的な医療データ分析。
7. 重要な用語
このシリーズに入る前に、次の用語をマスターする必要があります。
| 用語 | ベトナム語 | 説明 |
|---|---|---|
| CDM | 共通データモデル | 汎用データモデル |
| ETL | 抽出、変換、ロード | データの抽出、変換、ロードのプロセス |
| コンセプト | コンセプト | 標準化された単位 - それぞれの医療「もの」 (病気、薬、検査) に一意の Concept_id |
| 標準コンセプト | スタンダードコンセプト | OMOP によって標準として選択されたコンセプト (通常は SNOMED CT、RxNorm、LOINC から) |
| ソース値 | 元の値 | ソースシステムからの元のコード/名前 (例: ICD-10 コード、BV 薬剤名) |
| ドメイン | ドメイン | コンセプトをトピックごとにグループ化 (状態、薬剤、手順、測定など) |
| 語彙 | 語彙セット | コードシステム (SNOMED CT、ICD-10、RxNorm、LOINC...) |
| 観察期間 | 観測範囲 | 患者がシステムに「データを持っている」時刻 |
| 訪問 | 訪問・入院 | 医療システムとの 1 つの連絡 |
| RWE | 現実世界の証拠 | 実世界のデータ (臨床試験ではない) からの証拠 |
概要
この記事では、次のことを学びました。
- 断片化された医療データの問題 — 各システムは固有であり、集約することはできません
- OMOP CDM とは — 汎用、個人中心、イベントベースのデータ モデル
- 歴史 — OMOP プロジェクト (FDA、2008) から OHDSI (2014 ~現在)、CDM 5.4 (2021) まで
- FHIR、HL7 との比較 — FHIR を補完する分析用の OMOP CDM
- OHDSI エコシステム — Athena、ATLAS、ACHILLES、HADES、WebAPI
次の記事: OMOP CDM 5.4 の全体的なアーキテクチャ、つまり 37 のテーブルが 6 つのグループにどのように編成されているか、および個人中心の設計原則について説明します。