目標
このレッスンを終えると、次のことが理解できるようになります:
- Patroni とは何か、その仕組み_
- DCS (分散構成ストア) - etcd/Consul/ZooKeeper
- コンセンサス アルゴリズム(Raft)
- リーダー選挙とフェイルオーバーメカニズム_
- スプリットブレインの問題と解決策
1。 Patroni とは何ですか?
概要
Patroni は、Zalando によって開発された PostgreSQL 用のオープンソース HA (高可用性) テンプレートです。次のような PostgreSQL クラスター管理を自動化します。_
- _リーダー選出: プライマリ ノードを自動的に選択_
- 自動フェイルオーバー: プロジェクト移行プライマリ時の自動バックアップ失敗
- 構成管理: 一元化された構成管理
- ヘルスチェック: 関連ノードの正常性の監視継続
Patroniアーキテクチャ
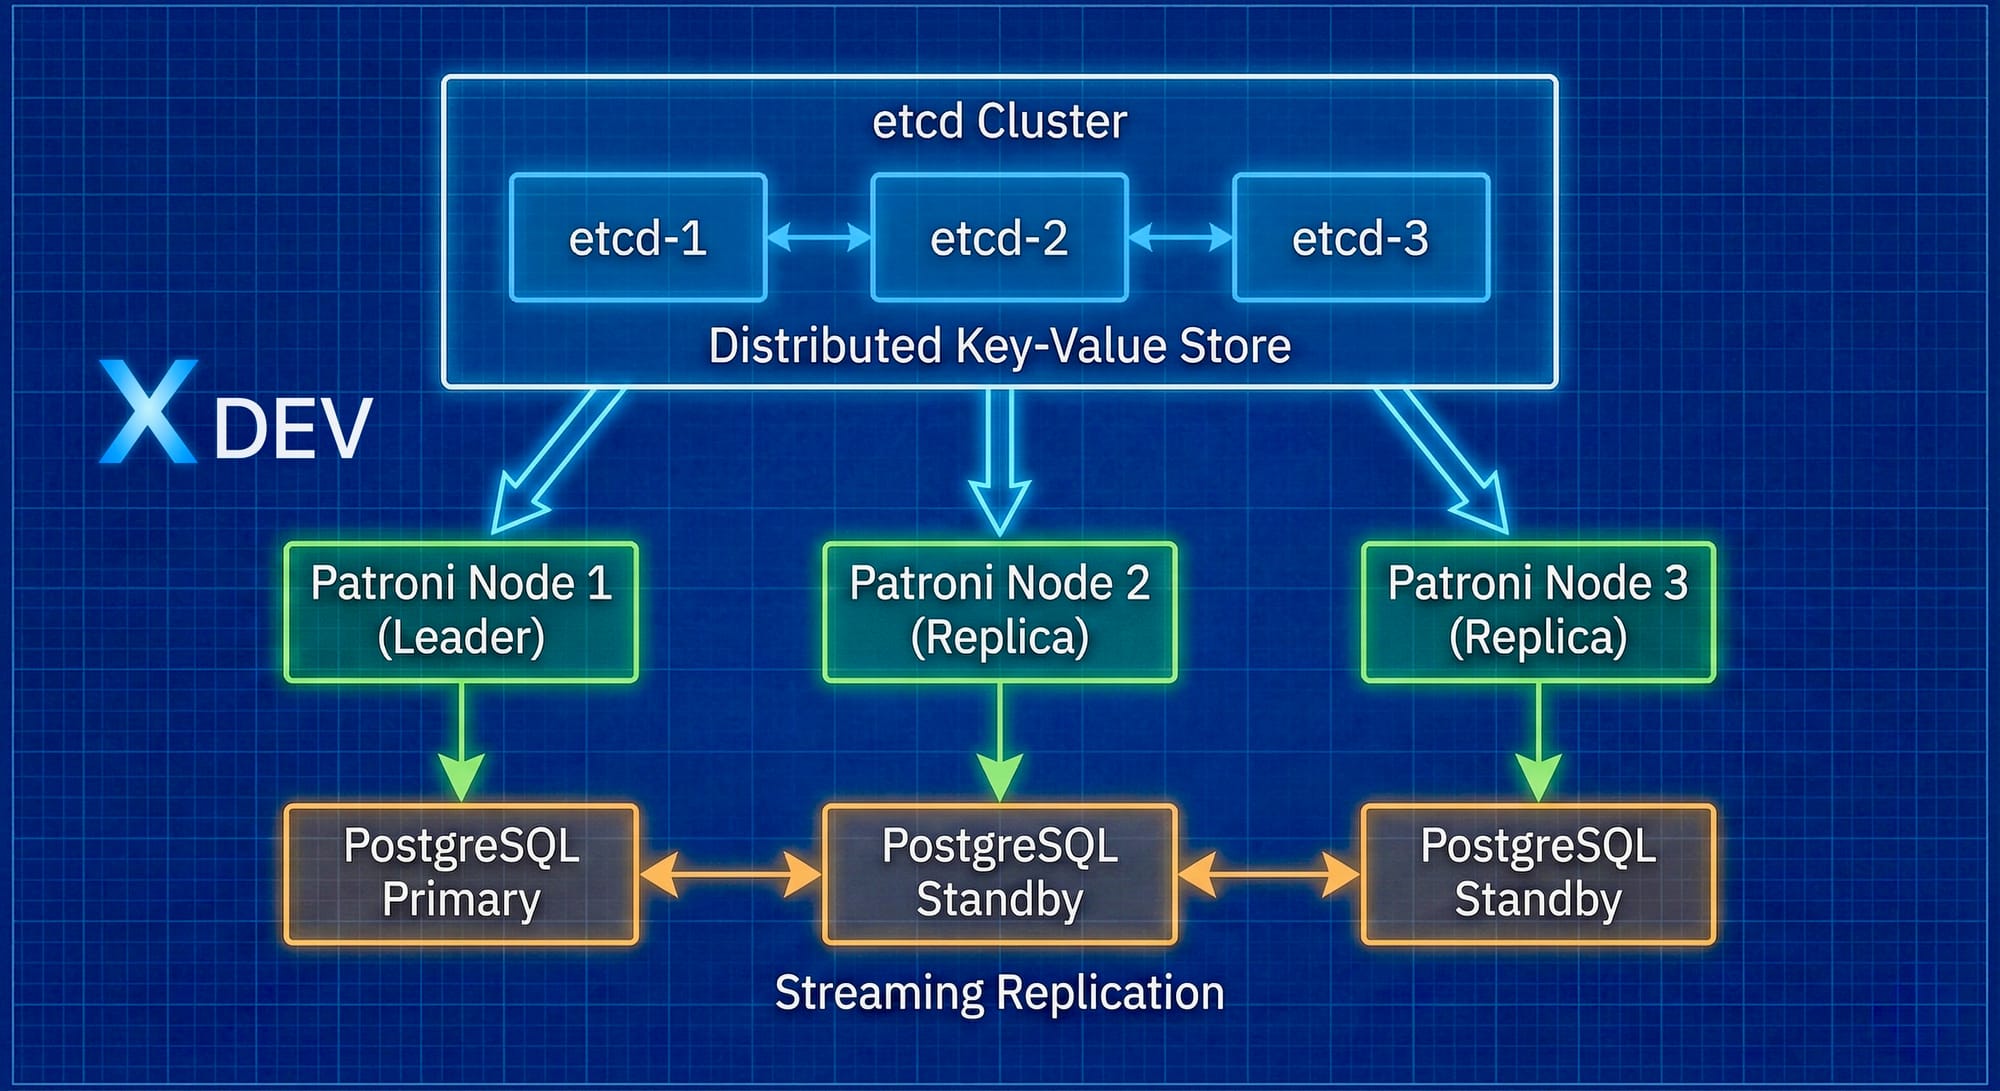
Patroni の仕組み動作_
- 開始: 各 Patroni インスタンスが DCS (etcd) に接続
- リーダー選挙: ノードがリーダーになるために競合します。 DCS
- ロールの割り当て: リーダー ロックを獲得したノードは PostgreSQL をプライマリに昇格
- ヘルスモニタリング: Patroni は継続的にチェックします:
- PostgreSQL プロセス健全性_
- レプリケーションステータス
- DCS接続
- 自動フェイルオーバー: リーダーが失敗した場合、Patroniは自動的に:
- _検出問題
- 最適なレプリカの選択
- 新しいレプリカをプライマリに昇格
- 残りのレプリカを更新_
メインコンポーネント
_Patroniデーモン
- 各 PostgreSQL ノードで実行_
- PostgreSQL のライフサイクルを管理_
- ヘルスチェックを実装
- DCS_
REST API_
- ヘルスチェックのエンドポイント:
http://node:8008/health - ヘルスチェックのエンドポイント読み取り専用:
http://node:8008/read-only - プライマリのエンドポイント:
http://node:8008/master(非推奨)または/プライマリ
patronictl
- クラスター管理用の CLI ツール
- コマンド: リスト、スイッチオーバー、フェイルオーバー、再初期化、再起動、リロード_
2。 DCS - 分散構成ストア
DCS の役割
DCS は Patroni クラスターの調整センターであり、以下を保存します。
- リーダー キー: どのノードがリーダーであるかに関する情報(TTL ベース)
- 構成: PostgreSQL と Patroni の構成_
- メンバー情報:クラスター_
- フェイルオーバー/スイッチオーバー状態: 切り替えステータス_
一般的な DCS 変数の比較
___HTMLTAG_18 4___| 計算関数 | etcd | 領事 | ZooKeepe r_ |
|---|---|---|---|
| 言語言語_ | Go | Go | _Java |
| コンセンサス | Raft_ | _Raft_ | ZAB (Paxos 風)_ |
| API_ | gRPC、HTTP | HTTP、DNS | カスタムプロトコル_ |
| _セットアップ_ | 単純_ | 中央平均 | 複雑その他_ |
| パフォーマンス___HTMLTAG_223_ __ | 高 | 高 | 中平均_ |
| _ドキュメント_ | 良い | とても良好 | 平均 |
| 使用状況 | Kubernetes、Patroni | サービスメッシュ、 HA | Hadoop、Kafka |
推奨: シンプルでパフォーマンスが高いため、ほとんどの場合 etcd を使用します。
etcd - 分散 Key-Value ストア_
機能main_:
- 強い一貫性 (CAP 定理: CP)_
- 分散型および高可用性_
- 高速 (ミリ秒未満のレイテンシー)
- シンプルな API
- リアルタイム更新の監視メカニズム
etcd のデータ構造パトロニ_:
/service/postgres/
├── config          # Cấu hình cluster
├── initialize      # Bootstrap token
├── leader          # Leader lock (TTL: 30s)
├── members/
│   ├── node1      # Thông tin node1
│   ├── node2      # Thông tin node2
│   └── node3      # Thông tin node3
├── optime/
│   └── leader     # LSN của leader
└── failover       # Failover/switchover instructions
3。コンセンサス アルゴリズム - Raft
Raft とは何ですか?
Raft は Paxos よりも理解しやすいように設計されたコンセンサス アルゴリズムであり、次のことが保証されています:
- 安全性: なしfalse の結果を返す
- Liveness: 常に進行中 (多数派ノードがアクティブな場合)
- Consistency: すべてのノードが同じように見える状態_
Raft の役割
- リーダー:_
- すべてのクライアント要求を処理_
- 複製受信ログエントリのフォロワー
- 用語内で一意
- フォロワー:
- パッシブ、からのリクエストのみを受信しますリーダー
- ハートビートを受信しない場合は、候補者になります_
- _候補者_:_
- フォロワーのタイムアウト候補者
- 他のノードからの投票をリクエスト
- 選挙に勝った場合→リーダー
リーダープロセス選挙_
選挙詳細__HTMLTAG_354___:_
- 選挙タイムアウト中にフォロワーがハートビートを受信しない (150 ~ 300 ミリ秒のランダム)
- 候補者に変換し、任期番号を増やす
- 投票する自分自身_
- RequestVote RPC をすべてのノードに送信
- 多数決を受け取った場合 (n/2 + 1):
- リーダーになる_
- すぐにハートビートを送信つまり
- タイムアウトまたは負けた場合:
- フォロワーに戻るか、新しく選挙を開始
クォーラムおよびマジョリティ_
クォーラム: システムが動的に動作するために必要なノードの最小数
Cluster size | Quorum | Tolerated failures
-------------|--------|-------------------
     1       |   1    |        0
     3       |   2    |        1
     5       |   3    |        2
     7       |   4    |        3
式: クォーラム = フロア(n/2) + 1
3 つのノードの例:
- ✅ 3 つのノードがアクティブ: クラスターは正常
- ✅ 2 つのノードがアクティブ: クラスターは動作 (クォーラムを満たす)
- ❌ 1 つのアクティブ ノード: クラスターが停止します (クォーラムなし)_
_推奨: 障害を最適化するために常に奇数のノード (3、5、7) を使用します。許容範囲。_
4。 Patroni でのリーダー選挙
リーダー ロック メカニズム
Patroni は DCS を使用して分散ロックを実装します:
リーダー ロックプロパティ:
Key: /service/postgres/leader
Value:
  {
    "version": "3.0.2",
    "conn_url": "postgres://node1:5432/postgres",
    "api_url": "http://node1:8008/patroni",
    "xlog_location": 123456789,
    "timeline": 2
  }
TTL: 30 seconds
リーダー選出プロセス
ステップ 1: 競合状態
Time: T0 - Leader crashes
Node1: Check DCS → No leader key exists
Node2: Check DCS → No leader key exists
Node3: Check DCS → No leader key exists
ステップ 2:ロックの取得の試行_
Time: T0 + 100ms
Node1: Try acquire lock → SUCCESS (first to write)
Node2: Try acquire lock → FAILED (key exists)
Node3: Try acquire lock → FAILED (key exists)
ステップ 3: 役割の割り当て_
Node1: Promote PostgreSQL to Primary
Node2: Configure as Replica, point to Node1
Node3: Configure as Replica, point to Node1
ステップ 4:メンテナンス_
Every 10 seconds: Node1 (Leader): - Renew lock (TTL extension) - Update xlog_location - Send heartbeatNode2/3 (Followers):
- Monitor leader key
- Check replication lag
Ready to take over
最適な選択基準レプリカ_
フェールオーバーの場合、Patroni は次の基準に基づいてレプリカを選択します。
- レプリケーション状態:
ストリーミング>アーカイブ内リカバリ
- タイムライン: 上位のタイムラインが優先_
- XLog位置_:
- レプリカの LSN がプライマリに最も近い
- データ損失が最も少ない
- レプリケーションなしlag:
pg_stat_replication.replay_lag = 0
- 明示的な候補: で設定します構成_
優先タグ:
tags:
nofailover: false
noloadbalance: false
clonefrom: false
nosync: false
ウォレット例:
Primary fails at LSN: 0/3000000Replica1: LSN=0/3000000, lag=0s ← BEST CHOICE Replica2: LSN=0/2FFFFFF, lag=1s Replica3: LSN=0/2FFFFFE, lag=2s
→ Patroni promotes Replica1
5。フェイルオーバー メカニズム_
自動フェイルオーバー プロセス
タイムラインの詳細詳細:
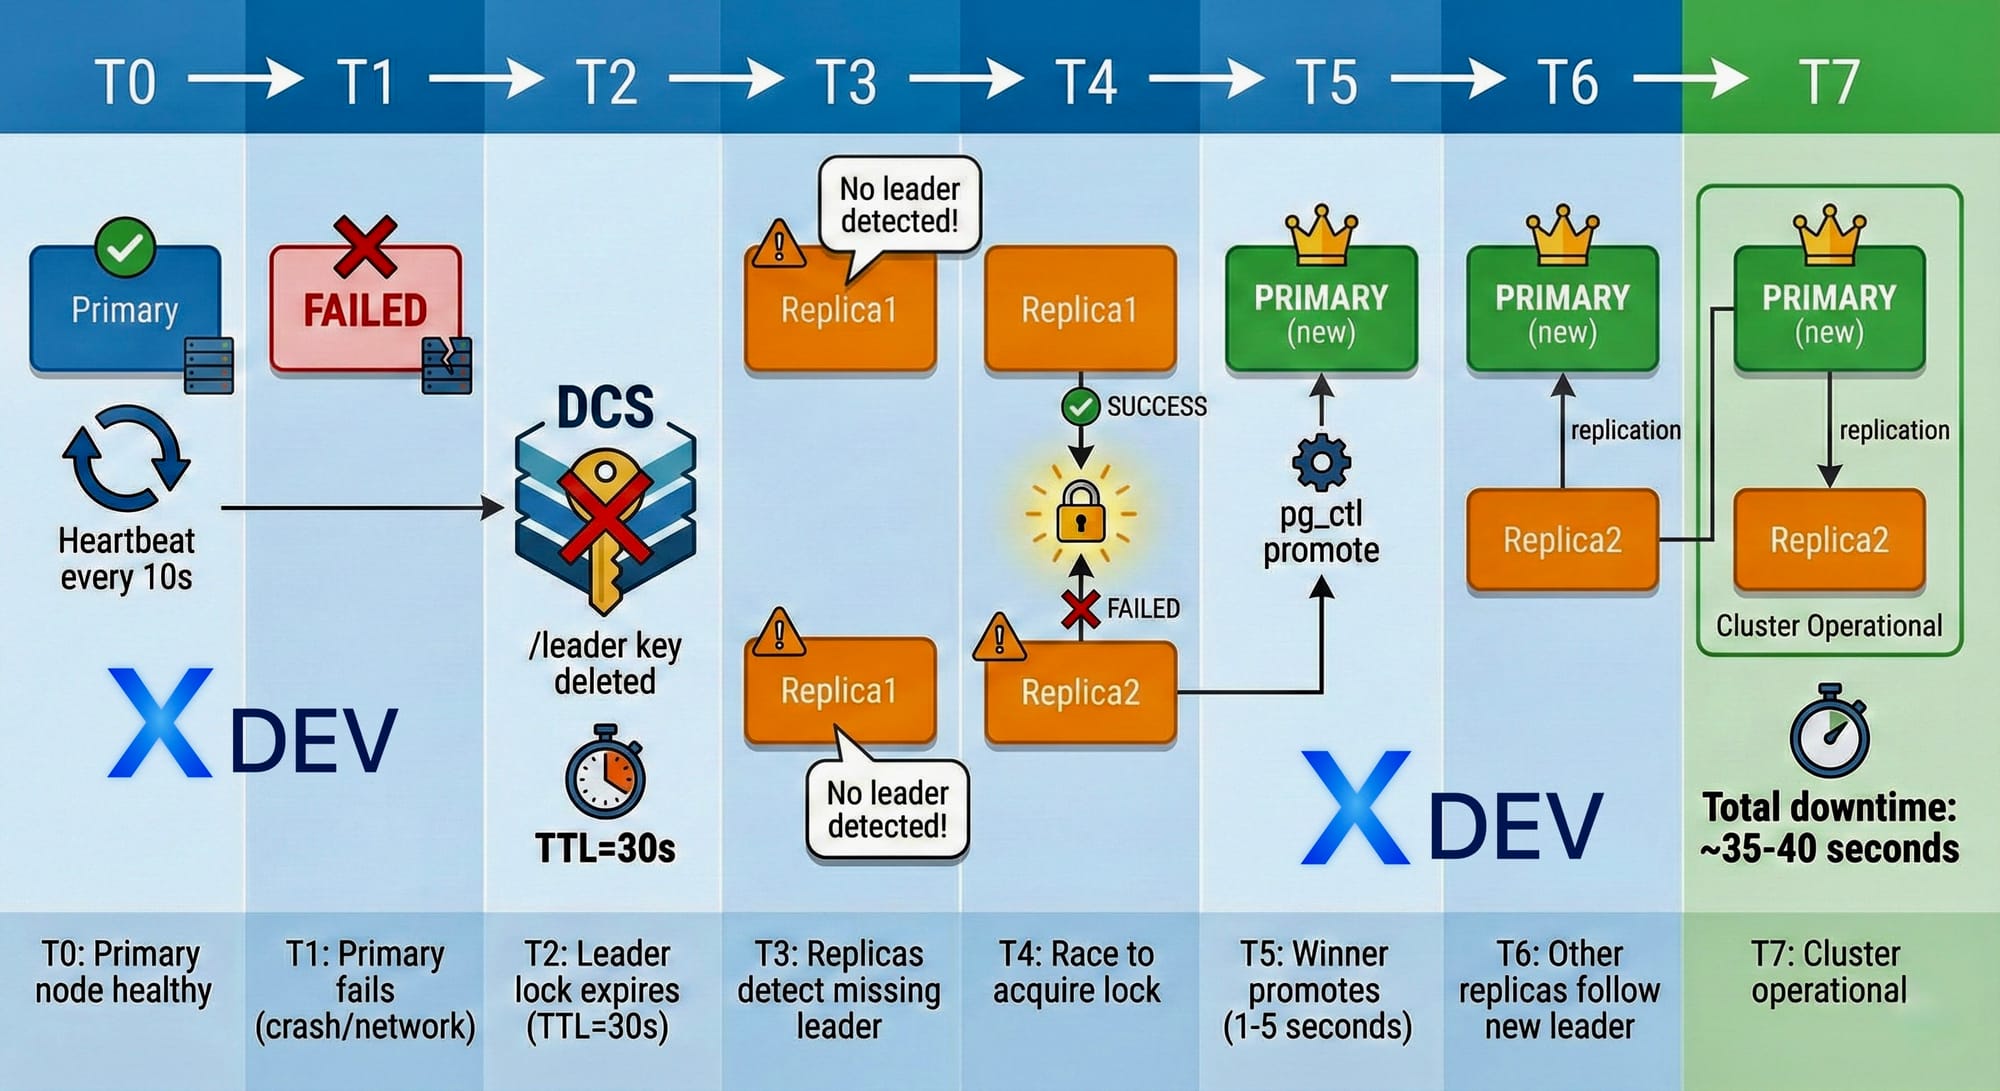
フェイルオーバー手順の詳細
ステップ 1: 障害の検出
# Patroni health check loop while True: if not check_postgresql_health(): log.error("PostgreSQL unhealthy") stop_renewing_leader_lock()if not check_dcs_connectivity(): log.error("Lost connection to DCS") demote_if_leader() sleep(10)
ステップ 2: リーダーのロック有効期限が切れます_
# In etcd $ etcdctl get /service/postgres/leaderAfter TTL: Key not found
Patroni logs on former leader
WARN: Could not renew leader lock INFO: Demoting PostgreSQL to standby
ステップ 3: レプリカのプロモーション_
# Patroni on promoted replica
INFO: No leader found
INFO: Attempting to acquire leader lock
INFO: Lock acquired successfully
INFO: Promoting PostgreSQL instance
INFO: Updating configuration
INFO: Notifying other members
ステップ 4:再構成
-- On promoted replica
SELECT pg_promote();
-- Changes primary_conninfo to null
-- Restarts as read-write
ステップ 5: フォロワーの再ポイント_
# Other replicas
INFO: New leader detected: node2
INFO: Updating primary_conninfo
INFO: Restarting replication
フェイルオーバーの監視_
重要指標_:
patroni_primary_timeline: タイムラインの変更を検出patroni_xlog_location: WAL の位置を追跡patroni_replication_lag:フェイルオーバー前のラグ_patroni_failover_count: フェイルオーバーの回数をカウントします
6。スプリット ブレインの問題_
スプリット ブレインとは何ですか?
定義_: 2 つ以上のノードがプライマリであると認識し、異なるデータを記録している状況 → データ
原因
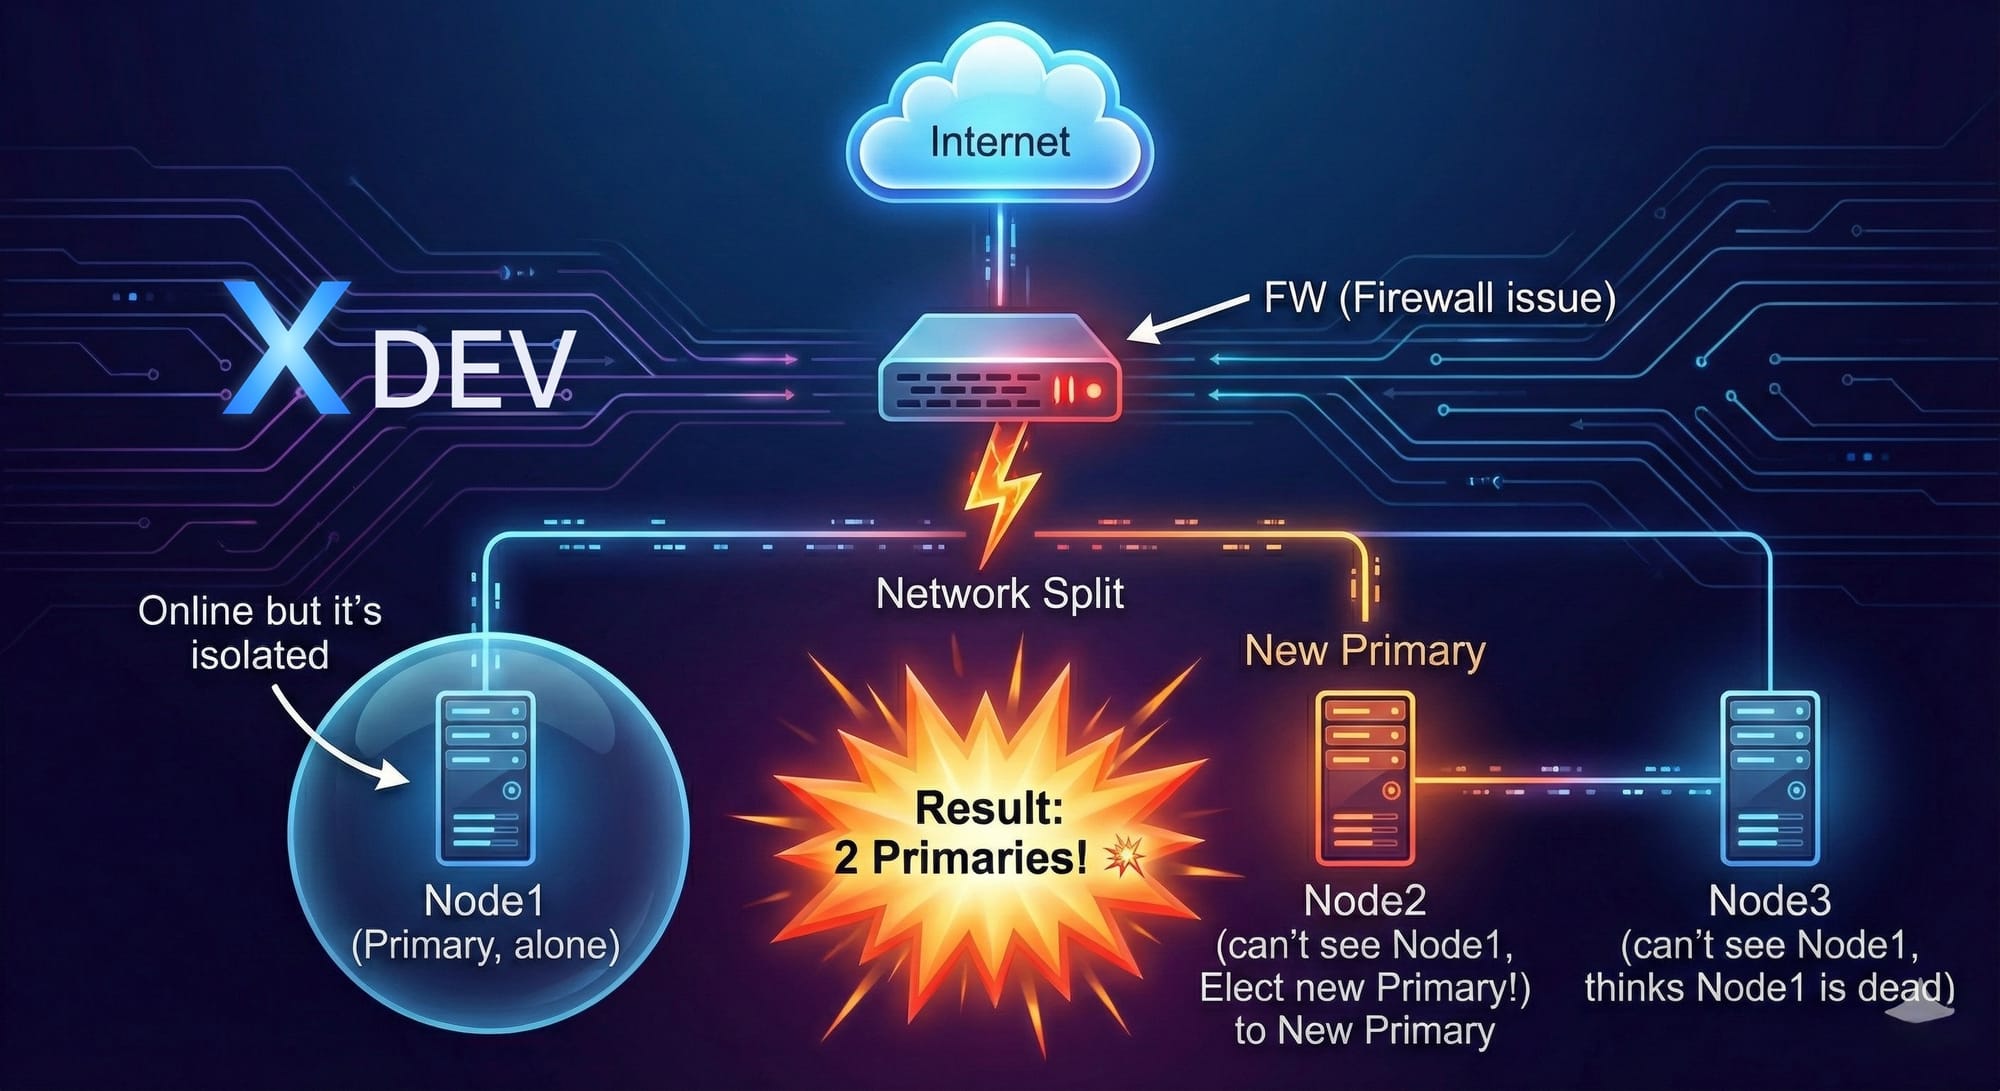
- ネットワークパーティション
- DCSパーティション: etcdクラスタースプリット_
- 遅いネットワーク: ハートビートがタイムアウトしたがノードはまだ生きている
結果スプリット ブレイン
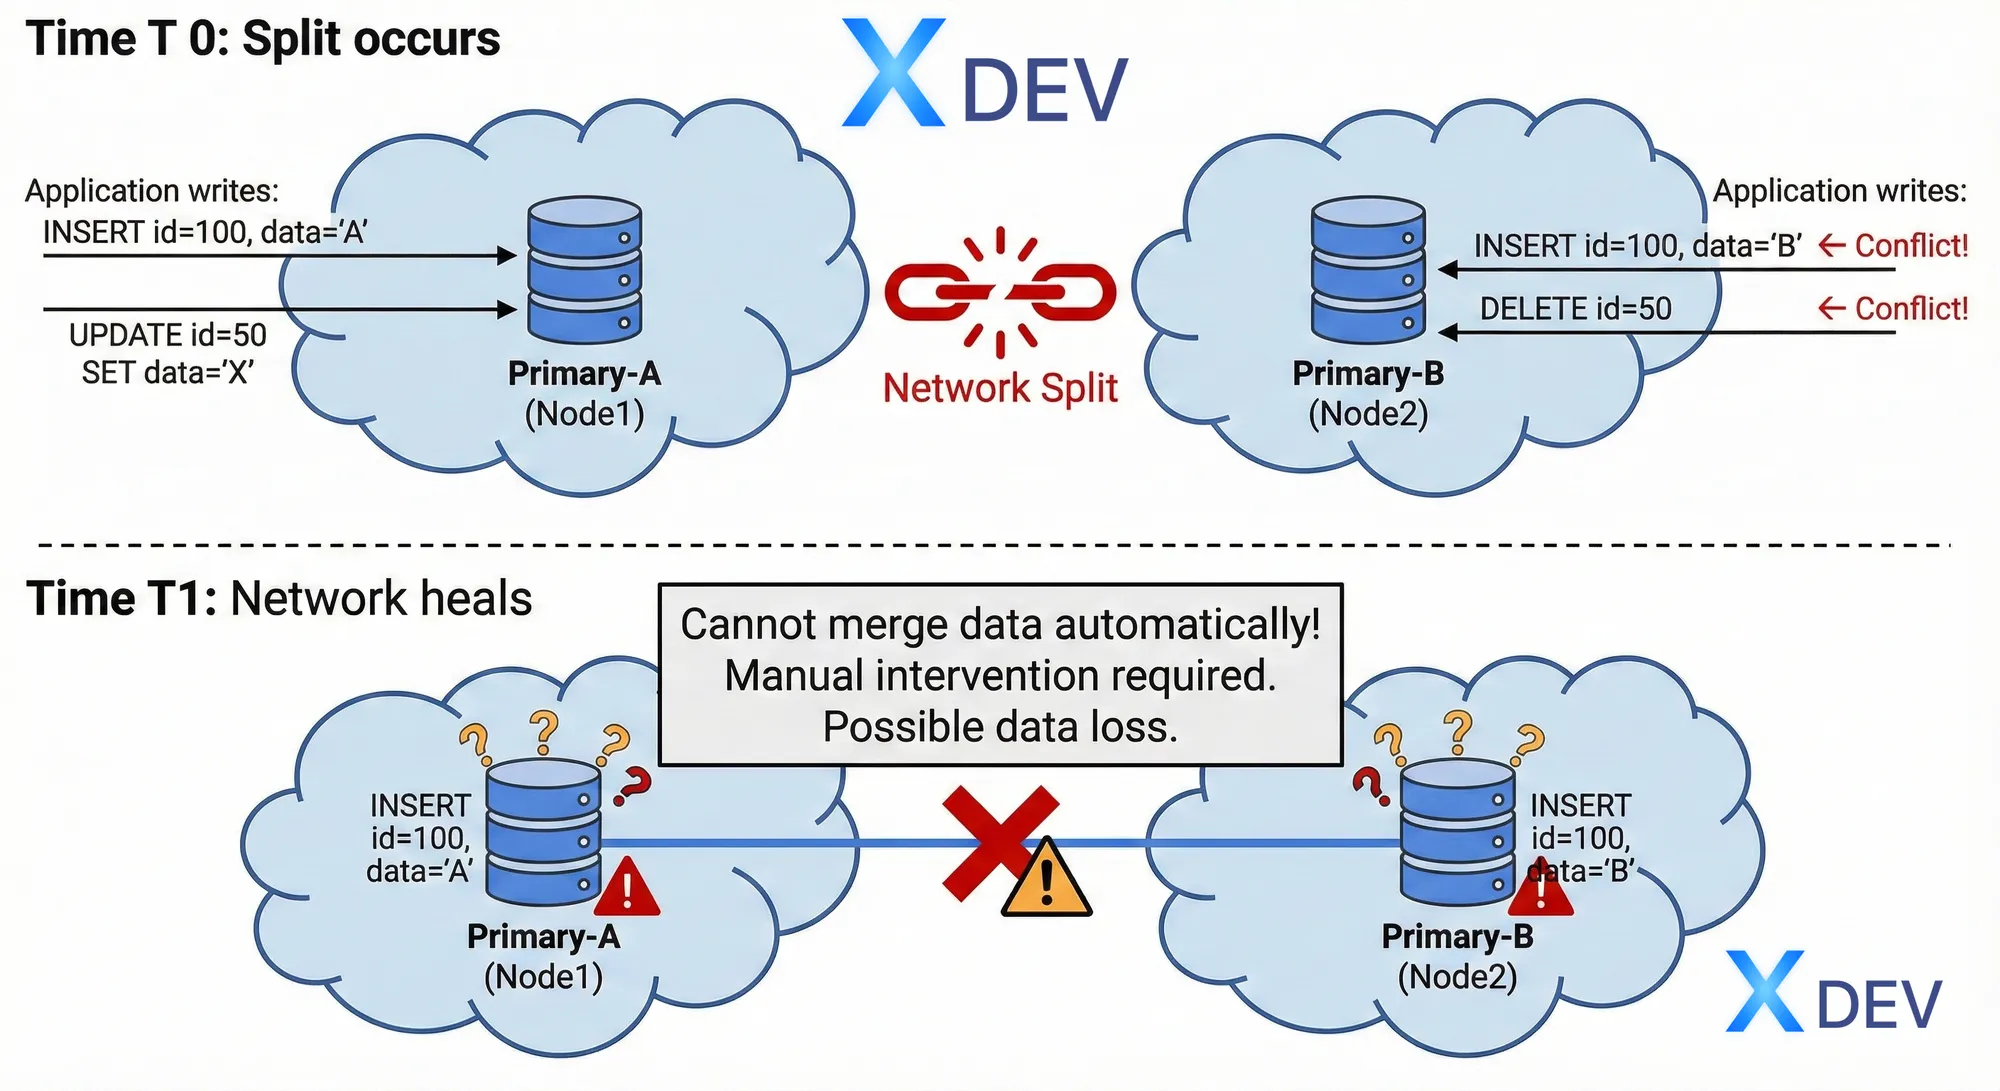
パトローニのスプリット ブレイン防止_
メカニズム 1: DCS ベースのロック (プライマリ)
def maintain_leader_lock(): while is_leader: # Must renew within TTL success = dcs.renew_lock(ttl=30)if not success: log.critical("Lost leader lock!") # Immediate demotion demote_to_standby() stop_accepting_writes() break sleep(10)
メカニズム 2: リーダー キー検証_
def before_handle_write(): leader_key = dcs.get("/service/postgres/leader")if leader_key.owner != my_node_name: # I'm not the real leader! raise Exception("Not leader anymore") demote_immediately()
メカニズム 3: タイムライン分岐検出_
-- PostgreSQL timeline
SELECT timeline_id FROM pg_control_checkpoint();
-- If timelines diverge:
-- Node1: timeline=5
-- Node2: timeline=6
-- → Data inconsistency detected
-- → Requires pg_rewind or rebuild
クォーラム要件
etcd 3 ノード:
Scenario 1: Network partition 1-2 split Partition A: Node1 (1 node) - Cannot get quorum (1 < 2) - Cannot write to etcd - Demotes to standby ✓Partition B: Node2, Node3 (2 nodes) - Has quorum (2 ≥ 2) - Can elect leader - Node2 becomes primary ✓
Result: Only 1 primary exists ✓
シナリオ 2: 完全な分離_
Node1: Isolated, loses DCS
- Tries to renew lock → FAIL
- Demotes PostgreSQL immediately
- Stops accepting connections
Node2/3: See Node1 gone
- Elect new leader
Only 1 primary in cluster ✓
ウォッチドッグ タイマー (高度な)保護)
ハードウェアウォッチドッグ:
# patroni.yml
watchdog:
mode: required  # or automatic, off
device: /dev/watchdog
safety_margin: 5
アクティブダイナミック:
- Patroni キックウォッチドッグ デバイスを 10 秒ごと_
- Patroni がハングまたは DCS を失った場合 → キックを停止
- タイムアウト後 → ウォッチドッグがノード全体を再起動
- 「ゾンビ プライマリ」を防止シナリオ_
スプリット ブレインを回避するためのベスト プラクティス
- 個別の DCS をデプロイ: 異なる AZ に etcd クラスター_
- Monitor DCS の健全性: etcd が健全でない場合のアラート
- ネットワークの冗長性: ノード間の複数のネットワーク パス
- 適切タイムアウト_:
patroni:
ttl: 30              # Leader lock TTL
loop_wait: 10        # Check interval
retry_timeout: 10    # DCS operation timeout
- ウォッチドッグを有効にする: ハードウェア保護レイヤー_
- モニタリング:
# Check for timeline divergence patronictl listExpected: All nodes same timeline
Cluster: postgres (7001234567890123456) ----+----+-----------+ | Member | Host | Role | State | TL | Lag in MB | +--------+--------------+---------+---------+----+-----------+ | node1 | 10.0.1.1:5432| Leader | running | 5 | | | node2 | 10.0.1.2:5432| Replica | running | 5 | 0 | | node3 | 10.0.1.3:5432| Replica | running | 5 | 0 | +--------+--------------+---------+---------+----+-----------+
スプリット ブレインからの回復
スプリット ブレインが発生した場合:
ステップ 1:特定
# Check timeline patronictl listnode1: timeline=5
node2: timeline=6 ← DIVERGED!
ステップ 2: プライマリを選択_
- 重要なデータが含まれるノードをさらに選択
- またはそれ以上のデータを持つノードを選択しますtimeline_
ステップ 3: 分岐レプリカを再構築
# Option 1: pg_rewind (if safe) patronictl reinit postgres node2Option 2: Full rebuild
patronictl remove postgres node2
Then: reinitialize from scratch
ステップ 4: _
patronictl listAll nodes same timeline ✓
7 を確認します。概要
重要なポイント
✅ Patroni: HA テンプレートは PostgreSQL 管理を自動化しますクラスター_
✅ DCS (etcd): 分散調整、ストア構成、リーダーロック_
✅ Raft コンセンサス: 一貫性の確保etcd でのリーダー選挙
✅ リーダー選挙: 自動、高速 (~30 ~ 40 秒)、TTL に基づくロック
✅ フェイルオーバー: プライマリ障害時に最適なレプリカを自動的に昇格
✅ スプリットブレイン防止: DCS クォーラム+ TTL ロック + ウォッチドッグ
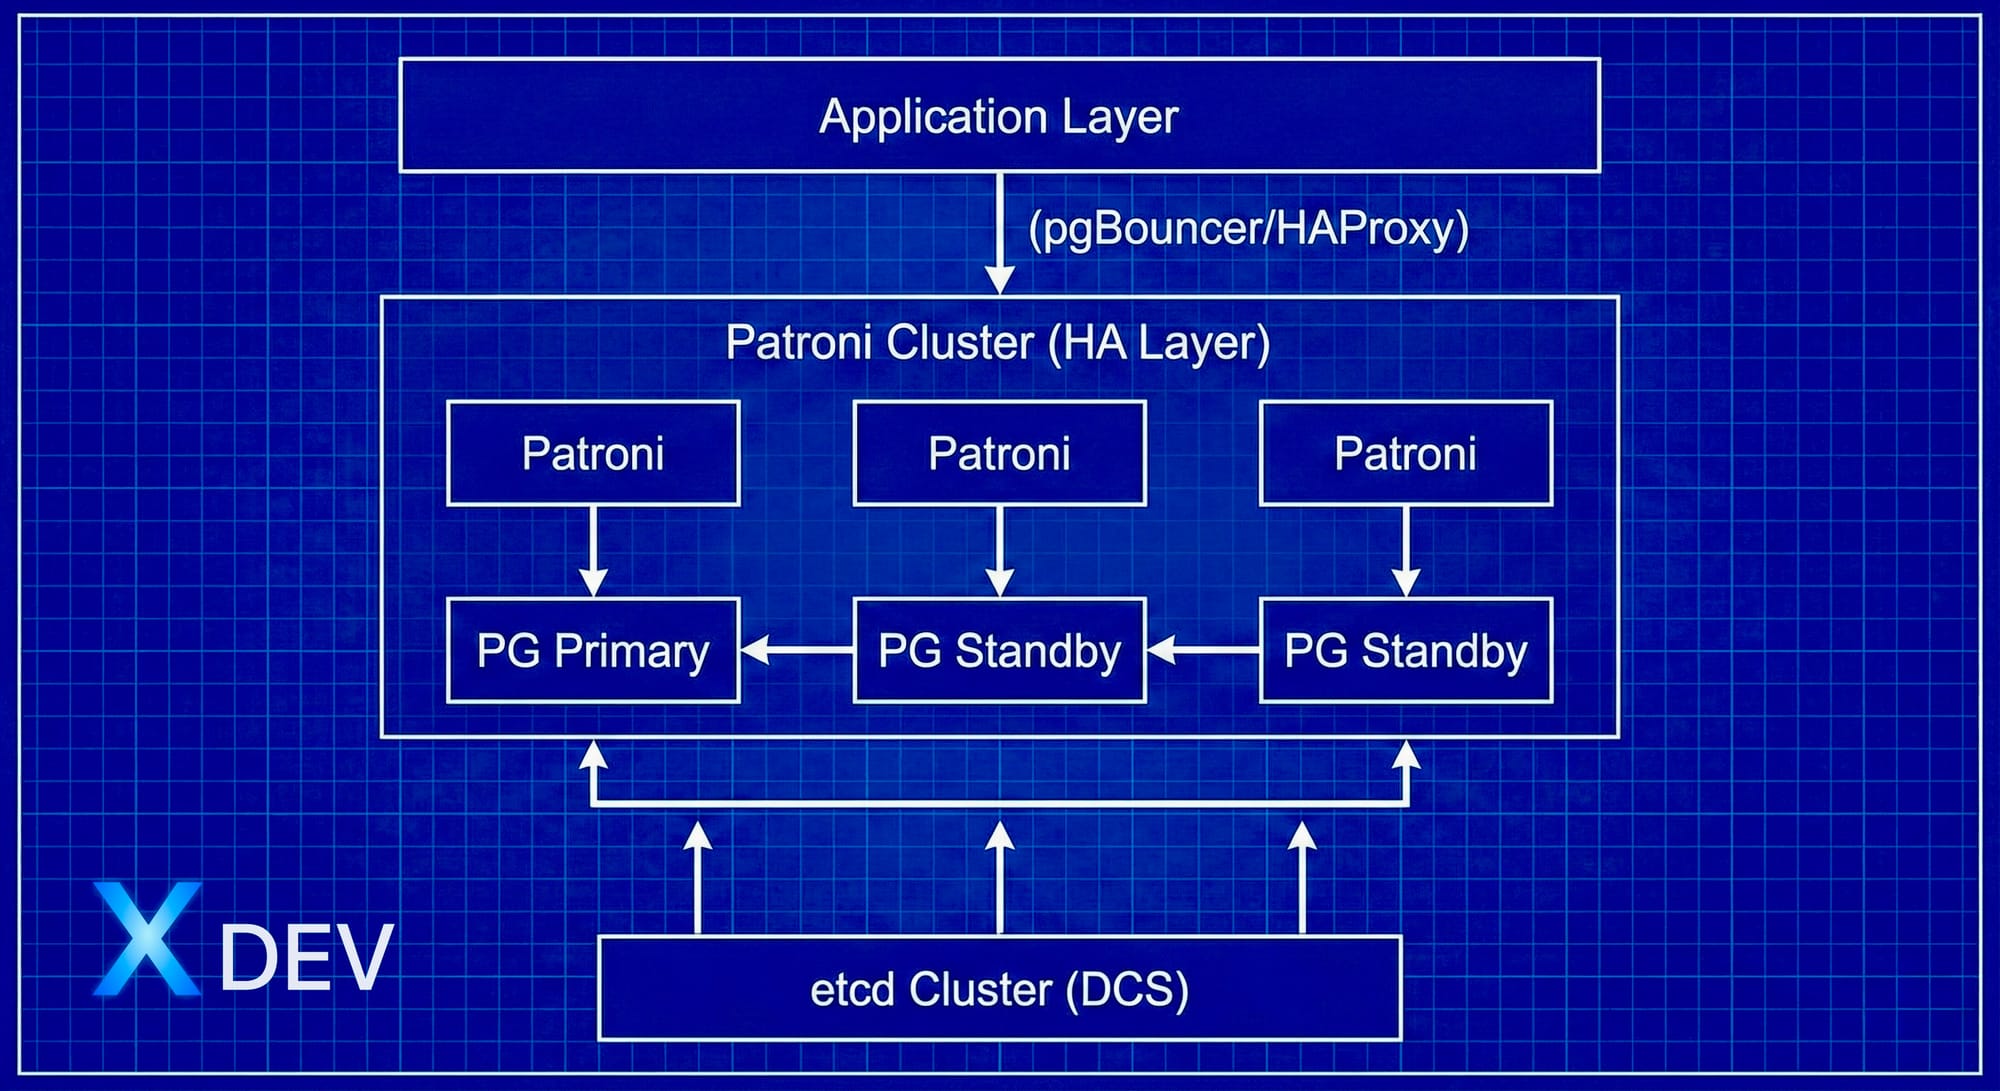
一般的なアーキテクチャ
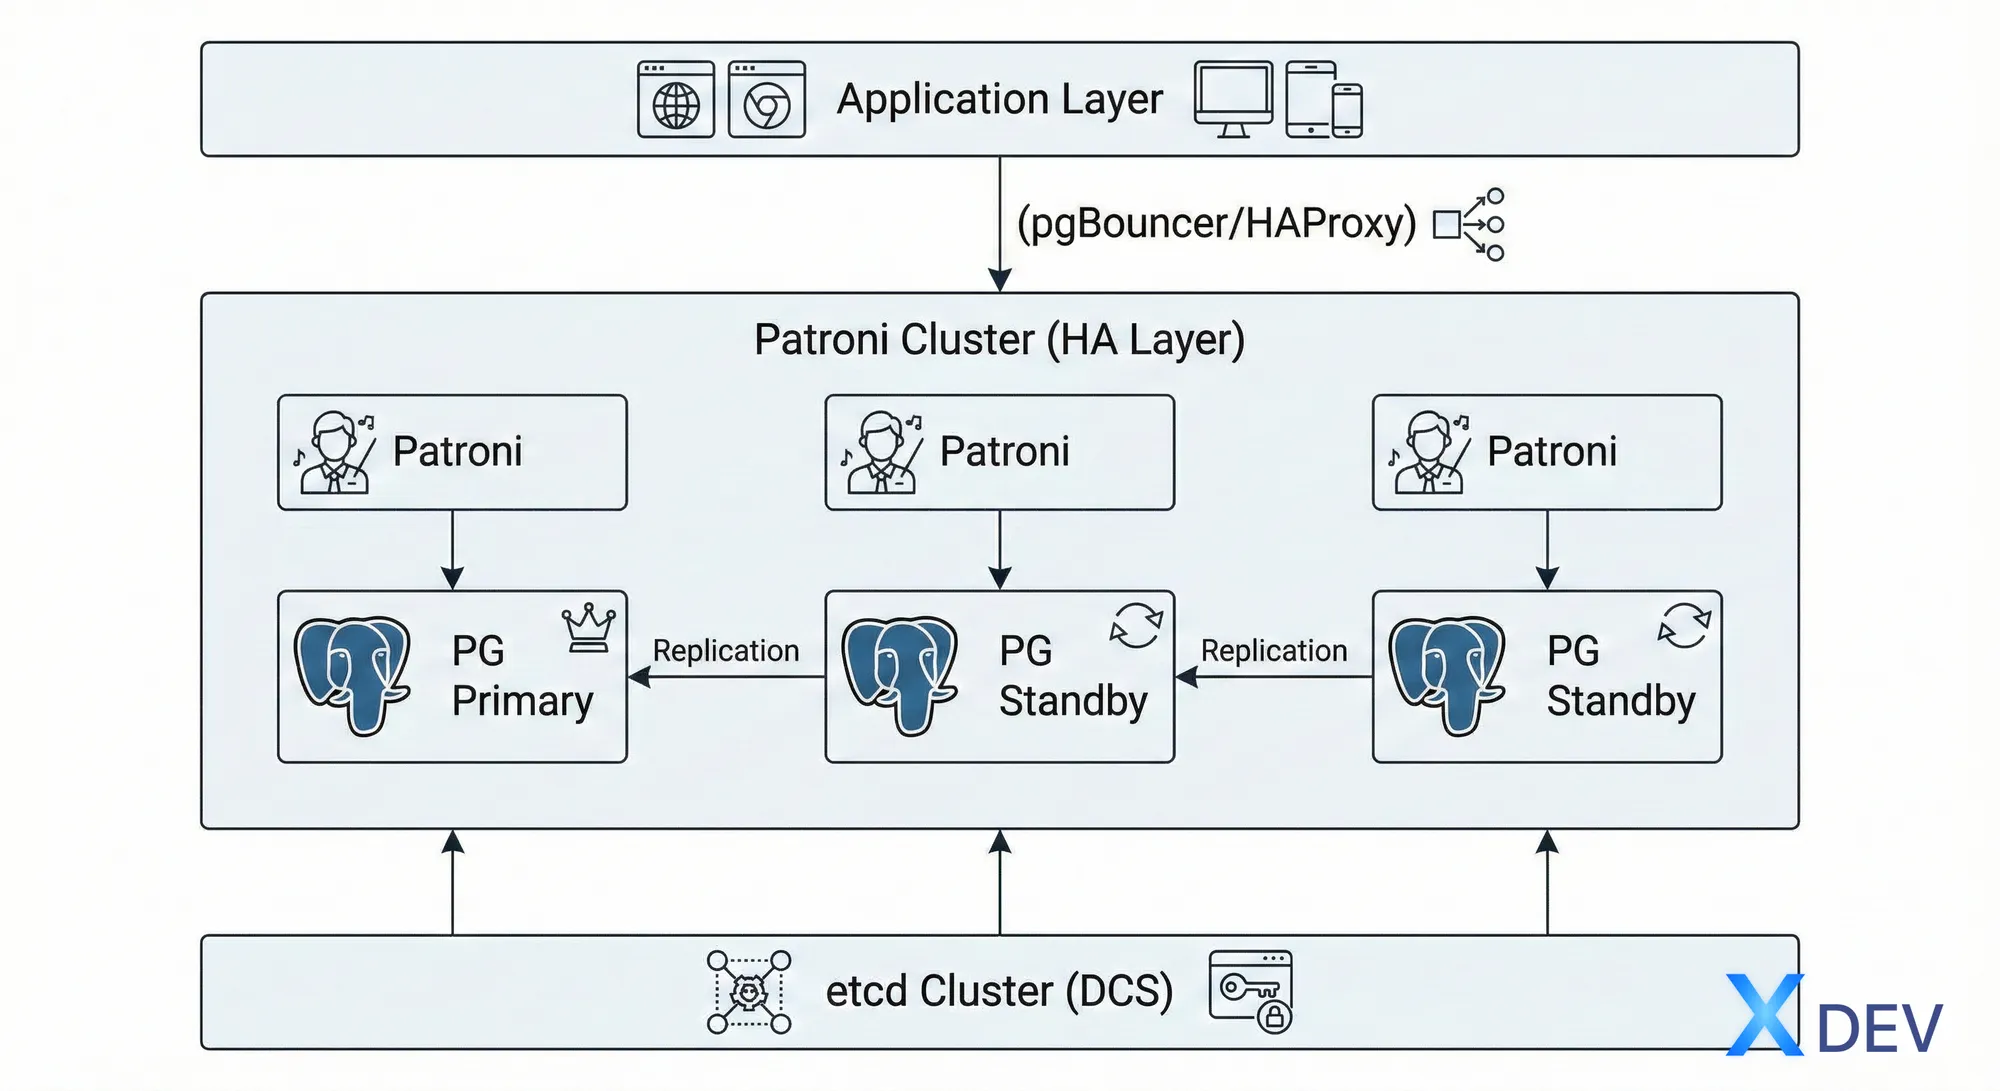
レビュー質問_
- Patroni は純粋なストリーミング レプリケーションとどのように異なりますか?
- DCS が必要な理由は何ですか?データベースを使用して状態を保存することはできませんか?
- 5 ノードのクラスターのクォーラムとは何ですか?
- Patroni はフェイルオーバー時に昇格するレプリカを選択しますか?
- スプリット ブレインが発生しますが、Patroni はどのようにそれを防止しますか? PostgreSQL の HTMLTAG_740
- タイムラインとは何ですか?
- TTL 30 秒とは何ですか? TTL = 5 秒に設定してみてはいかがでしょうか?
次のレッスンの準備_
レッスン 4 では、インフラストラクチャの準備について説明します。
- セットアップ 3 VM/サーバー
- ネットワーク構成、ファイアウォール
- SSH キー、時刻同期_
- 必要な依存関係__HTMLTAG_758___