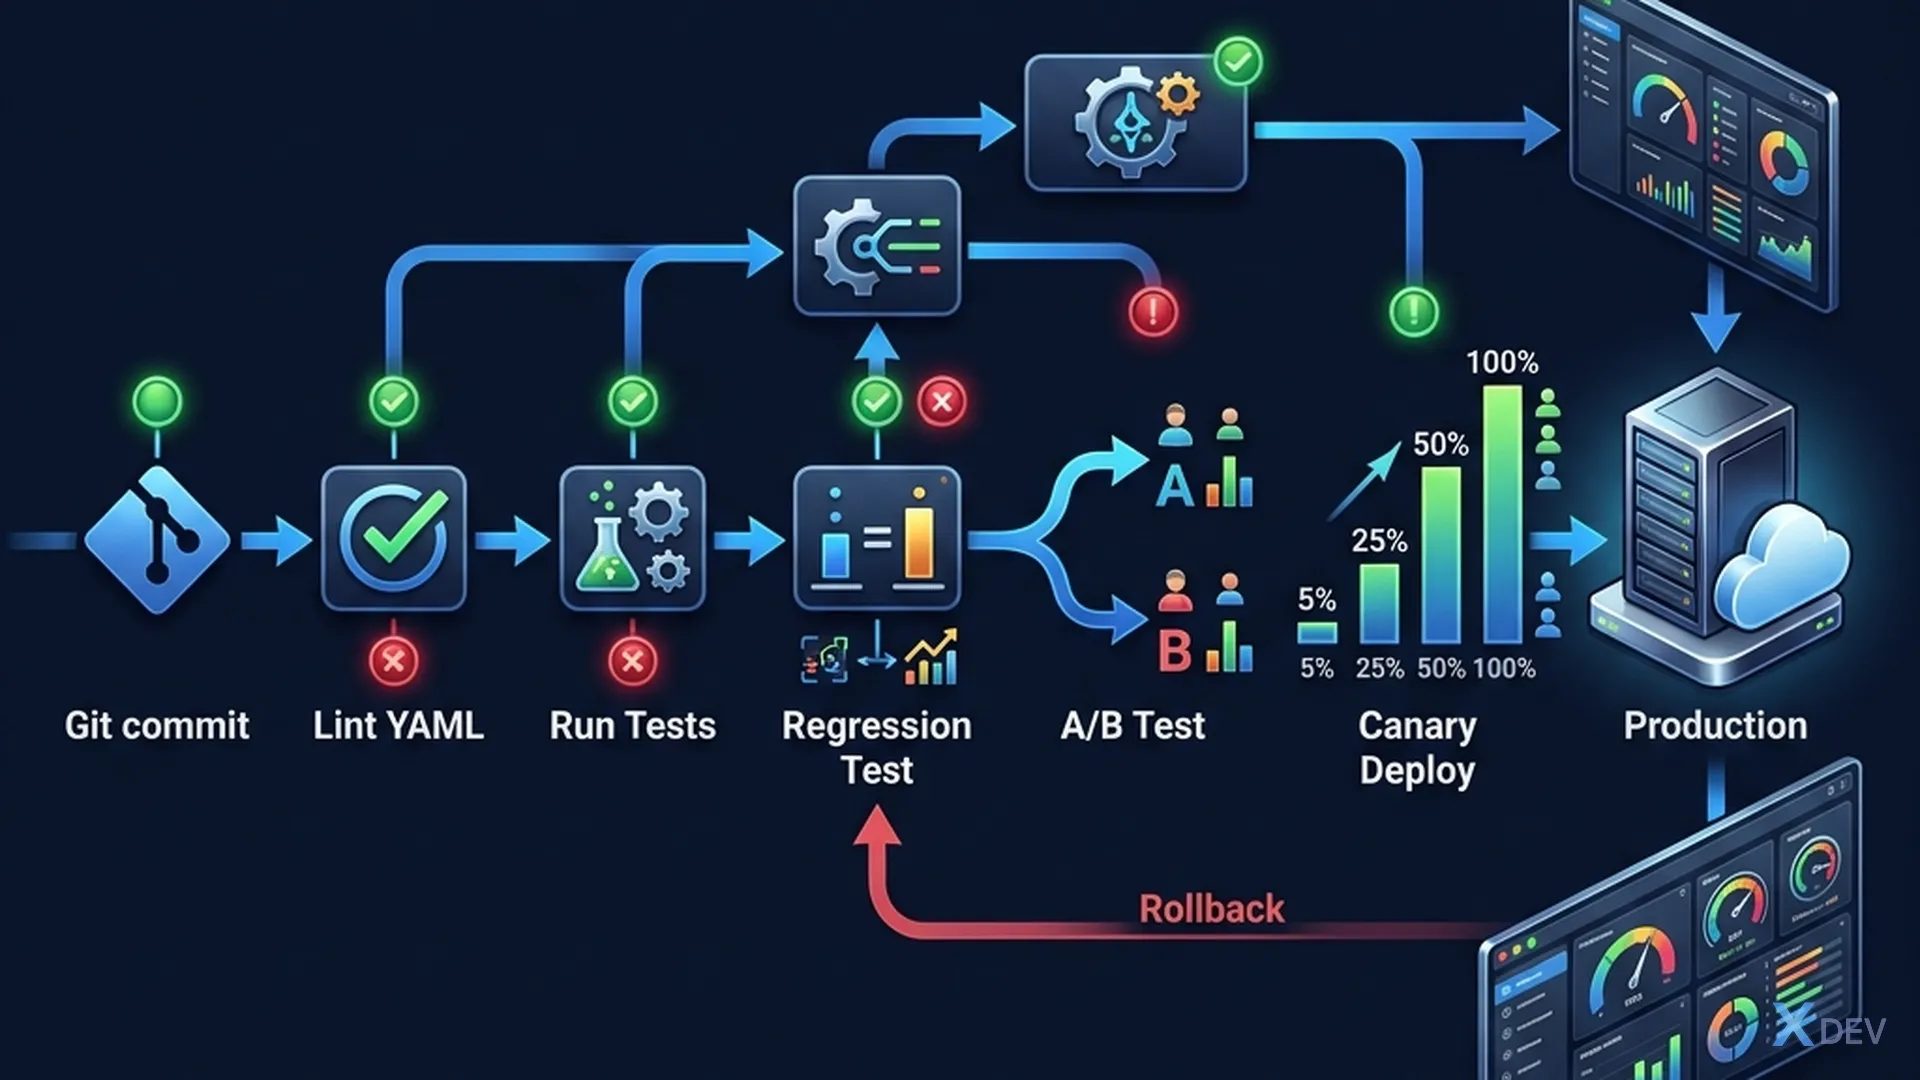
はじめに
運用プロンプトにはコードのようなバージョン管理が必要です。 Prompt v1 は正常に動作します → 1 行変更 → 出力に失敗します。バージョン管理がないとロールバックできません。 A/B テストを行わないと、どのバージョンが優れているかわかりません。
Prompt Lifecycle:

Draft → v1.0 (baseline) → v1.1 (improve) → A/B Test → Winner → v2.0
                                                ↓ loser
                                            Archive
1. プロンプトのバージョン管理
1.1 ファイルベースのバージョニング
prompts/
├── email-classifier/
│   ├── prompt.yaml          # Current version (symlink → v2.1)
│   ├── v1.0.yaml            # Initial version
│   ├── v1.1.yaml            # Minor fix
│   ├── v2.0.yaml            # Major rewrite
│   ├── v2.1.yaml            # Current production
│   ├── CHANGELOG.md         # Lịch sử thay đổi
│   └── tests/
│       ├── golden.json      # Test cases
│       └── results/         # Test results per version
└── summarizer/
    ├── prompt.yaml
    └── ...
1.2 プロンプト YAML 形式
# prompts/email-classifier/v2.1.yaml
metadata:
  name: email-classifier
  version: "2.1"
  author: duytd
  created_at: "2025-01-20"
  model: gpt-4o-mini
  temperature: 0
  max_tokens: 200
  description: "Phân loại email — thêm category 'urgent'"
  changelog: "Thêm category 'urgent', cải thiện edge case tiếng Việt"
  tags: ["classification", "email", "vietnamese"]

prompt:
  system: |
    Bạn là email classifier chuyên nghiệp.
    Phân loại email vào 1 trong 5 categories:
    spam, business, personal, newsletter, urgent.

    Rules:
    - urgent: chứa deadline, từ khóa "gấp", "ngay", "ASAP"
    - spam: quảng cáo, link lạ, "trúng thưởng"
    - business: công việc, báo cáo, meeting
    - personal: bạn bè, gia đình
    - newsletter: bản tin, subscription

  user: |
    Phân loại email sau. Output JSON:
    {"category": "...", "confidence": 0.0-1.0, "reasoning": "..."}

    Email: {{input}}

validation:
  output_format: json
  required_fields: ["category", "confidence", "reasoning"]
  category_values: ["spam", "business", "personal", "newsletter", "urgent"]
  confidence_range: [0, 1]
1.3 プロンプトレジストリ
"""Prompt Registry: load + manage prompt versions"""
import yaml
from pathlib import Path

class PromptRegistry:
    def __init__(self, prompts_dir: str = "prompts"):
        self.dir = Path(prompts_dir)
        self._cache = {}

    def get(self, name: str, version: str = "latest") -> dict:
        """Load prompt by name + version"""
        key = f"{name}:{version}"
        if key in self._cache:
            return self._cache[key]

        prompt_dir = self.dir / name
        if version == "latest":
            # Tìm version cao nhất
            versions = sorted(prompt_dir.glob("v*.yaml"))
            if not versions:
                raise FileNotFoundError(f"No versions for {name}")
            path = versions[-1]
        else:
            path = prompt_dir / f"v{version}.yaml"

        with open(path) as f:
            prompt = yaml.safe_load(f)

        self._cache[key] = prompt
        return prompt

    def render(self, name: str, version: str = "latest",
               **kwargs) -> list[dict]:
        """Render prompt thành messages cho API"""
        prompt = self.get(name, version)
        tmpl = prompt["prompt"]

        messages = []
        if "system" in tmpl:
            messages.append({"role": "system", "content": tmpl["system"]})

        user_content = tmpl["user"]
        for k, v in kwargs.items():
            user_content = user_content.replace(f"{{{{{k}}}}}", str(v))

        messages.append({"role": "user", "content": user_content})
        return messages

    def list_versions(self, name: str) -> list[str]:
        """Liệt kê tất cả versions"""
        prompt_dir = self.dir / name
        return sorted([
            f.stem.replace("v", "") for f in prompt_dir.glob("v*.yaml")
        ])

# Sử dụng
registry = PromptRegistry()
messages = registry.render("email-classifier", version="2.1",
                          input="Meeting lúc 3pm nhé")
2. A/B テストのプロンプト
2.1 アーキテクチャ
User Request
     │
     ▼
┌─────────────┐     ┌──────────────┐
│ Router      │────→│ Prompt A (50%)│──→ Response A
│ (feature    │     └──────────────┘       │
│  flag /     │     ┌──────────────┐       ▼
│  random)    │────→│ Prompt B (50%)│──→ Response B
└─────────────┘     └──────────────┘       │
                                           ▼
                                    ┌──────────┐
                                    │ Log both │
                                    │ + metrics│
                                    └──────────┘
2.2 A/B テストの実装
"""A/B Testing cho prompts"""
import random
import time
import json
from datetime import datetime

class PromptABTest:
    def __init__(self, name: str, variant_a: str, variant_b: str,
                 traffic_split: float = 0.5):
        self.name = name
        self.variant_a = variant_a
        self.variant_b = variant_b
        self.split = traffic_split
        self.results = {"A": [], "B": []}

    def get_variant(self, user_id: str = None) -> tuple[str, str]:
        """Chọn variant — deterministic nếu có user_id"""
        if user_id:
            # Deterministic: cùng user luôn nhận cùng variant
            variant = "A" if hash(user_id) % 100 < self.split * 100 else "B"
        else:
            variant = "A" if random.random() < self.split else "B"

        prompt = self.variant_a if variant == "A" else self.variant_b
        return variant, prompt

    def log_result(self, variant: str, input_text: str,
                   output: str, latency: float, score: float = None):
        """Ghi nhận kết quả"""
        self.results[variant].append({
            "input": input_text,
            "output": output,
            "latency": latency,
            "score": score,
            "timestamp": datetime.utcnow().isoformat(),
        })

    def run(self, input_text: str, user_id: str = None) -> dict:
        """Chạy A/B test"""
        variant, prompt = self.get_variant(user_id)

        start = time.time()
        response = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user",
                       "content": prompt.replace("{{input}}", input_text)}],
            temperature=0,
        )
        latency = time.time() - start
        output = response.choices[0].message.content

        self.log_result(variant, input_text, output, latency)
        return {"variant": variant, "output": output, "latency": latency}

    def get_stats(self) -> dict:
        """Thống kê A vs B"""
        stats = {}
        for v in ["A", "B"]:
            r = self.results[v]
            if not r:
                stats[v] = {"count": 0}
                continue
            latencies = [x["latency"] for x in r]
            scores = [x["score"] for x in r if x["score"] is not None]

            stats[v] = {
                "count": len(r),
                "avg_latency": sum(latencies) / len(latencies),
                "avg_score": sum(scores) / len(scores) if scores else None,
            }
        return stats
2.3 統計的有意性
"""Kiểm tra kết quả A/B có statistically significant không"""
from scipy import stats

def check_significance(scores_a: list[float], scores_b: list[float],
                       alpha: float = 0.05) -> dict:
    """t-test so sánh 2 prompt variants"""
    t_stat, p_value = stats.ttest_ind(scores_a, scores_b)

    return {
        "mean_a": sum(scores_a) / len(scores_a),
        "mean_b": sum(scores_b) / len(scores_b),
        "p_value": p_value,
        "significant": p_value < alpha,
        "winner": "A" if sum(scores_a)/len(scores_a) >
                        sum(scores_b)/len(scores_b) else "B",
        "recommendation": (
            f"Variant {'A' if t_stat > 0 else 'B'} tốt hơn "
            f"(p={p_value:.4f})" if p_value < alpha
            else "Chưa đủ data để kết luận"
        ),
    }
💡 演習 1: 1 つのプロンプトに対して A/B テストをセットアップします (例: 2 つの異なるシステム プロンプトによる要約)。バリアントごとに 20 のリクエストを実行し、平均スコアを比較します。
3. プロンプト用の CI/CD パイプライン
3.1 ワークフロー
                    ┌── Lint YAML syntax
PR: Edit prompt ──→ ├── Unit tests (5-10 cases)
                    ├── Regression tests (golden dataset)
                    └── Cost estimation
                         │
                    Pass all? ──→ Merge → Deploy
                         │ fail
                         └──→ Block PR + report failures
3.2 GitHub アクション パイプライン
# .github/workflows/prompt-cicd.yml
name: Prompt CI/CD

on:
  pull_request:
    paths: ['prompts/**']

jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Validate YAML
        run: |
          pip install pyyaml
          python -c "
          import yaml, glob, sys
          errors = []
          for f in glob.glob('prompts/**/*.yaml', recursive=True):
              try:
                  with open(f) as fh:
                      data = yaml.safe_load(fh)
                  assert 'metadata' in data
                  assert 'prompt' in data
              except Exception as e:
                  errors.append(f'{f}: {e}')
          if errors:
              print('\n'.join(errors))
              sys.exit(1)
          print('All prompts valid!')
          "

  test:
    needs: lint
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Detect changed prompts
        id: changes
        run: |
          changed=$(git diff --name-only origin/main -- prompts/)
          echo "changed=$changed" >> $GITHUB_OUTPUT

      - name: Run prompt tests
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
        run: |
          pip install openai pyyaml
          python tests/run_prompt_tests.py --changed "${{ steps.changes.outputs.changed }}"

      - name: Cost estimation
        run: |
          python scripts/estimate_cost.py --prompts "${{ steps.changes.outputs.changed }}"

  deploy:
    needs: test
    if: github.event.pull_request.merged == true
    runs-on: ubuntu-latest
    steps:
      - name: Deploy prompts
        run: |
          python scripts/deploy_prompts.py --env production
4. カナリアのデプロイメントとロールバック
4.1 カナリア戦略
"""Canary deployment: roll out prompt mới dần dần"""

class CanaryDeployer:
    def __init__(self, registry: PromptRegistry):
        self.registry = registry
        self.canary_config = {}

    def start_canary(self, name: str, old_version: str,
                     new_version: str, initial_traffic: float = 0.05):
        """Bắt đầu canary: 5% traffic → new version"""
        self.canary_config[name] = {
            "old": old_version,
            "new": new_version,
            "traffic": initial_traffic,  # % traffic cho new version
            "status": "canary",
        }

    def get_version(self, name: str, user_id: str = None) -> str:
        """Route traffic theo canary config"""
        if name not in self.canary_config:
            return "latest"

        config = self.canary_config[name]
        if random.random() < config["traffic"]:
            return config["new"]
        return config["old"]

    def promote(self, name: str, new_traffic: float):
        """Tăng traffic cho new version"""
        # 5% → 25% → 50% → 100%
        self.canary_config[name]["traffic"] = new_traffic
        if new_traffic >= 1.0:
            self.canary_config[name]["status"] = "promoted"

    def rollback(self, name: str):
        """Rollback về old version"""
        if name in self.canary_config:
            self.canary_config[name]["traffic"] = 0.0
            self.canary_config[name]["status"] = "rolled_back"
4.2 自動ロールバック
"""Tự động rollback nếu metrics xấu"""

def monitor_canary(deployer, name: str, threshold: float = 0.8):
    """Monitor canary → auto rollback nếu score < threshold"""
    config = deployer.canary_config.get(name)
    if not config:
        return

    # Lấy metrics của new version
    new_scores = get_recent_scores(name, config["new"], window_minutes=30)

    if not new_scores:
        return

    avg_score = sum(new_scores) / len(new_scores)

    if avg_score < threshold:
        deployer.rollback(name)
        send_alert(f"⚠️ Auto-rollback {name}: "
                  f"avg_score={avg_score:.2f} < {threshold}")
    elif avg_score >= 0.95 and len(new_scores) >= 100:
        # Promote nếu đủ tốt + đủ sample
        current = config["traffic"]
        deployer.promote(name, min(current * 2, 1.0))
💡 演習 2: 実際のプロンプトに対するカナリア展開計画を設計します。設定の書き込み: 初期 5% → 監視 1 時間 → 25% → 監視 → 50% → 100%。追跡するメトリクスをリストします。
概要
| コンセプト | ツール / 実践 | 重要なポイント |
|---|---|---|
| バージョン管理 | YAML + Git | 各プロンプト = ファイルのバージョン管理 |
| レジストリ | Python クラス | バージョンのロード、レンダリング、リスト表示 |
| A/B テスト | トラフィックを分割する | user_id による決定 |
| 重要性 | t検定、p値 | 結論としては、p < 0.05 |
| CI/CD | GitHub Actions | Lint → Test → Deploy |
| Canary | Gradual rollout | 5% → 25% → 50% → 100% |
| Rollback | Auto-rollback | Monitor score < threshold |
一般的な演習
- ✅ 2 つの小さな演習 (1、2) を完了します。
- プロンプト レジストリ: 完全なレジストリを構築します: YAML 形式、バージョン管理、レンダリング、キャッシュ。少なくとも 3 つのプロンプトをサポートし、各プロンプトには 2 つ以上のバージョンがあります。
- A/B テスト プラットフォーム: 完全な A/B を実装します: トラフィック分割、ロギング、重要性テスト。バリアントごとに 50 以上のリクエストを使用して実際の実験を実行します。
- CI/CD パイプライン: GitHub アクションのセットアップ: YAML のリント、テストの実行、コスト見積もり、デプロイ。新しい PR はパイプラインを自動的にトリガーします。
次の記事: Capstone — ビジネス向けプロンプト ライブラリの構築 — すべてのテクニックを完全な製品に統合します。