簡介
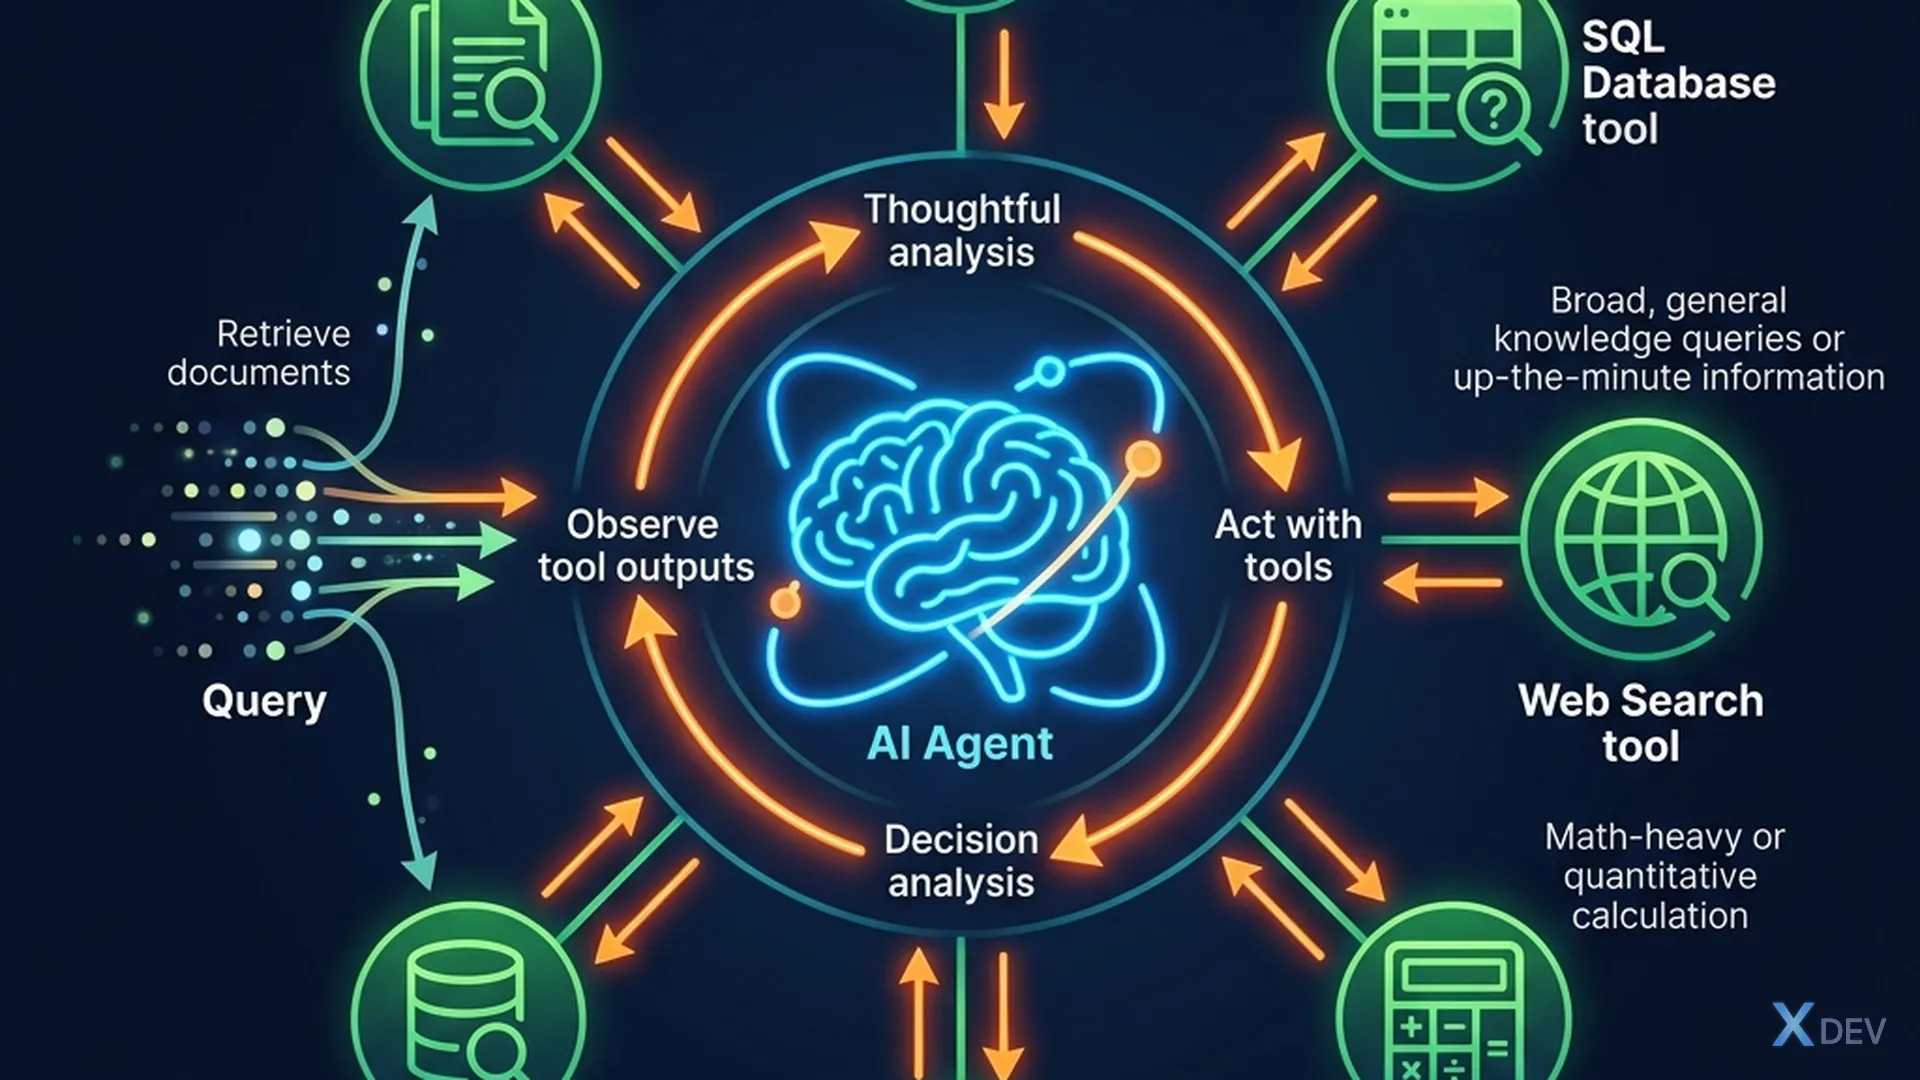
傳統的RAG是一個固定的管道:查詢→檢索→產生。但現實中,很多問題都需要多步驟推理,多方查找,或對結果進行自我評估,然後才能回答。
例如:“將貴公司的休假政策與越南勞動法進行比較。”
- 第1步:尋找內部策略(內部向量儲存)
- 第 2 步:尋找勞動法(網路搜尋或法律商店向量)
- 第 3 步:比較 2 個結果
- 修復 RAG 管道不行!代理是肯定的。
本文涵蓋:
- 工具呼叫 RAG — 代理呼叫工具:搜尋、計算機、網路...
- Adaptive RAG-根據問題選擇自己的策略
- 自我反思 RAG (CRAG) — 自我評估結果並重試
1. 從 Pipeline → Agent
1.1 比較
RAG Pipeline (cố định):
  Query → Retrieve → Generate → Answer
  ↑ luôn chạy 3 bước, không linh hoạt

Agentic RAG (linh hoạt):
  Query → Agent QUYẾT ĐỊNH:
           ├── Cần search không? → Search tool
           ├── Search ở đâu? → Internal docs / Web / SQL
           ├── Kết quả đủ chưa? → Search thêm / Dừng
           ├── Cần tính toán? → Calculator tool
           └── Cần đánh giá? → Self-reflect → Retry
1.2 什麼時候需要 Agentic RAG?
| 場景 | 管道 RAG | 特工 RAG |
|---|---|---|
| 簡單問答(1 來源) | ✅ | 矯枉過正 |
| 多源(內部+網路) | ❌ | ✅ |
| 多步驟推理 | ❌ | ✅ |
| 需要計算/SQL | ❌ | ✅ |
| 自我糾錯 | ❌ | ✅ |
2. 工具呼叫 RAG
2.1 建立RAG工具
"""Agent với RAG search tool"""
from langchain.tools.retriever import create_retriever_tool
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings, ChatOpenAI

# Tool 1: Search tài liệu nội bộ
internal_retriever = Chroma(
    collection_name="internal_docs",
    embedding_function=OpenAIEmbeddings(),
).as_retriever(search_kwargs={"k": 3})

search_internal = create_retriever_tool(
    retriever=internal_retriever,
    name="search_internal_docs",
    description="Tìm kiếm tài liệu nội bộ công ty: chính sách, quy trình, HR...",
)

# Tool 2: Web search
from langchain_community.tools import TavilySearchResults
web_search = TavilySearchResults(max_results=3)

# Tool 3: Calculator
from langchain_community.tools import LLMMathChain
# ...hoặc custom tool
2.2 建立代理
"""LangGraph Agent với RAG tools"""
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o", temperature=0)

tools = [search_internal, web_search]

agent = create_react_agent(
    model=llm,
    tools=tools,
    state_modifier="""Bạn là AI assistant của công ty XYZ.
    Sử dụng search_internal_docs cho câu hỏi về chính sách nội bộ.
    Sử dụng web_search cho thông tin bên ngoài (luật, thị trường...).
    Nếu kết quả không đủ, hãy search thêm với query khác.""",
)

# Agent tự quyết định dùng tool nào
result = agent.invoke({
    "messages": [{"role": "user", "content":
        "So sánh chính sách nghỉ phép công ty với Bộ Luật Lao động 2019"}]
})
2.3 多源路由
User: "So sánh nghỉ phép công ty vs luật"
   │
   └── Agent thinking:
       Step 1: Cần tìm chính sách nội bộ
               → search_internal_docs("chính sách nghỉ phép")
               → Kết quả: "15 ngày phép/năm cho full-time"

       Step 2: Cần tìm luật lao động
               → web_search("Bộ Luật Lao động 2019 nghỉ phép")
               → Kết quả: "Điều 113: tối thiểu 12 ngày/năm"

       Step 3: So sánh và trả lời
               → "Công ty cho 15 ngày, cao hơn luật quy định (12 ngày)"
💡 練習 1: 使用 2 個工具建立代理:(a) 內部搜索,(b) 網路搜尋。測試 5 個問題需要兩個來源。
3. 自適應 RAG — 選擇自己的策略
3.1 路由器代理
"""Router: phân loại câu hỏi → chọn strategy"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from typing import Literal
from pydantic import BaseModel, Field

class RouteQuery(BaseModel):
    """Routing decision"""
    datasource: Literal["vectorstore", "web_search", "sql_database"] = Field(
        description="Chọn nguồn dữ liệu phù hợp nhất"
    )

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
structured_llm = llm.with_structured_output(RouteQuery)

router_prompt = ChatPromptTemplate.from_messages([
    ("system", """Phân loại câu hỏi dựa trên nội dung:
- vectorstore: câu hỏi về chính sách, quy trình nội bộ công ty
- web_search: thông tin bên ngoài, tin tức, luật pháp
- sql_database: câu hỏi cần query dữ liệu số (doanh thu, nhân sự...)"""),
    ("human", "{question}"),
])

router = router_prompt | structured_llm

# Test
route = router.invoke({"question": "Doanh thu Q3 2024 bao nhiêu?"})
print(route.datasource)  # "sql_database"

route = router.invoke({"question": "Quy trình xin nghỉ phép?"})
print(route.datasource)  # "vectorstore"
3.2 自適應管道
"""Adaptive RAG: route → strategy → retrieve → generate"""
def adaptive_rag(question: str):
    # 1. Route
    route = router.invoke({"question": question})

    # 2. Retrieve theo route
    if route.datasource == "vectorstore":
        docs = vector_retriever.invoke(question)
        context = "\n".join([d.page_content for d in docs])
    elif route.datasource == "web_search":
        results = web_search.invoke(question)
        context = "\n".join([r["content"] for r in results])
    elif route.datasource == "sql_database":
        # Text-to-SQL
        context = sql_chain.invoke(question)

    # 3. Generate
    prompt = f"Context: {context}\n\nQuestion: {question}\nAnswer:"
    return llm.invoke(prompt).content
4.自我反思 RAG (CRAG)
4.1 想法
校正 RAG (CRAG):檢索後,評估結果。如果不夠好 → 用另一種策略重試。
Query → Retrieve → Grader: kết quả tốt không?
                      │
                ┌─────┴─────┐
                │            │
            Relevant     Not Relevant
                │            │
            Generate     Web Search
                │            │
                └─────┬──────┘
                      │
                 Final Answer
4.2 使用 LangGraph 實現
"""CRAG: Corrective RAG với LangGraph"""
from langgraph.graph import StateGraph, END
from typing import TypedDict, List
from langchain.schema import Document

class GraphState(TypedDict):
    question: str
    documents: List[Document]
    generation: str
    web_search_needed: bool

# Node 1: Retrieve
def retrieve(state):
    docs = vector_retriever.invoke(state["question"])
    return {"documents": docs}

# Node 2: Grade documents
def grade_documents(state):
    """LLM đánh giá: documents có liên quan đến question không?"""
    question = state["question"]
    docs = state["documents"]

    relevant_docs = []
    web_search_needed = False

    for doc in docs:
        grade_prompt = f"""Document: {doc.page_content[:300]}
Question: {question}
Document có liên quan đến question không? Trả lời: yes hoặc no"""

        grade = llm.invoke(grade_prompt).content.strip().lower()
        if "yes" in grade:
            relevant_docs.append(doc)

    if len(relevant_docs) < 2:  # Ít hơn 2 doc relevant → cần web search
        web_search_needed = True

    return {"documents": relevant_docs, "web_search_needed": web_search_needed}

# Node 3: Web search (fallback)
def web_search_node(state):
    results = web_search.invoke(state["question"])
    web_docs = [Document(page_content=r["content"]) for r in results]
    return {"documents": state["documents"] + web_docs}

# Node 4: Generate
def generate(state):
    context = "\n".join([d.page_content for d in state["documents"]])
    prompt = f"Context: {context}\n\nQuestion: {state['question']}\nAnswer:"
    answer = llm.invoke(prompt).content
    return {"generation": answer}

# Build graph
workflow = StateGraph(GraphState)
workflow.add_node("retrieve", retrieve)
workflow.add_node("grade", grade_documents)
workflow.add_node("web_search", web_search_node)
workflow.add_node("generate", generate)

workflow.set_entry_point("retrieve")
workflow.add_edge("retrieve", "grade")
workflow.add_conditional_edges("grade",
    lambda state: "web_search" if state["web_search_needed"] else "generate")
workflow.add_edge("web_search", "generate")
workflow.add_edge("generate", END)

app = workflow.compile()

result = app.invoke({"question": "Chính sách WFH mới nhất?"})
print(result["generation"])
💡練習 2: 實作 CRAG 管道。建立 10 個測試問題:5 個問題在向量儲存中有答案,5 個問題沒有答案(需要網路搜尋)。檢查 CRAG 是否自動正確回退網路搜尋。
5. 多步驟推理
5.1 分解複雜問題
"""Agent tự chia câu hỏi phức tạp thành nhiều bước"""
decompose_prompt = ChatPromptTemplate.from_messages([
    ("system", """Chia câu hỏi phức tạp thành các bước nhỏ.
Mỗi bước là 1 câu hỏi đơn giản có thể search được.
Trả lời dạng JSON: ["bước 1", "bước 2", ...]"""),
    ("human", "{question}"),
])

def multi_step_rag(question: str):
    # Decompose
    steps = decompose_prompt | llm
    sub_questions = eval(steps.invoke({"question": question}).content)

    all_context = []
    for sub_q in sub_questions:
        # Search mỗi sub-question
        docs = vector_retriever.invoke(sub_q)
        all_context.extend([d.page_content for d in docs])

    # Generate final answer
    context = "\n".join(all_context)
    final_prompt = f"""Dựa trên thông tin thu thập:
{context}

Câu hỏi gốc: {question}
Trả lời đầy đủ:"""

    return llm.invoke(final_prompt).content
總結
| 概念 | 記住 |
|---|---|
| 代理RAG | 特工自行決定搜尋地點和次數 |
| 工具呼叫 | 代理呼叫工具:RAG 搜尋、Web、SQL、計算器 |
| 自適應RAG | 路由器分類→選擇適當的策略 |
| 克拉 | 成績結果 → 若成績不佳則備用網路搜尋 |
| 多步驟 | 分割複雜問題→多個子問題 |
| LangGraph | 用於建立基於圖形的代理程式工作流程的框架 |
一般練習
- ✅ 完成 2 個小練習 (1, 2)
- 完整代理程式 RAG: 使用 3 種以上工具(內部文件、網路搜尋、SQL)建立代理程式。測試 15 個不同的問題。代理是否選擇了正確的工具?
- CRAG + 多步驟: 結合多步驟分解實現CRAG。複雜問題→逐步→搜尋每一步→評分→後備→答案。
- 評估: 比較答案品質:(a) 基本 RAG,(b) 自適應 RAG,(c) 代理 CRAG。使用 GPT-4 對 1-10 進行評分。
下一篇文章: RAG 評估 — RAGAS、忠實性和相關性 — 科學地衡量 RAG 系統的品質。