Chào anh em. Ba bài trước tôi đều chốt bằng đúng một câu: mở execution plan ra mà đọc. Rồi tôi nhận ra mình chưa hề chỉ cách đọc. Bài này trả nợ.
Và mình bắt đầu bằng chỗ tôi thấy nhiều người hiểu sai nhất — kể cả người đi làm lâu rồi.
Xem bản video
Estimated và actual không phải hai kế hoạch
Tài liệu của Microsoft viết thẳng: Query Optimizer chỉ sinh ra một execution plan. Cái mà anh em quen gọi là "hai loại plan" thật ra là một kế hoạch nhìn ở hai thời điểm, với hai lượng thông tin khác nhau.
| Estimated plan | Actual plan | |
|---|---|---|
| Là gì | kế hoạch đã biên dịch, dựng từ ước lượng | đúng kế hoạch đó + ngữ cảnh thực thi |
| Có khi nào | ngay khi biên dịch, không chạy câu truy vấn | chỉ sau khi câu chạy xong |
| Nằm ở đâu | chính nó là cái trong plan cache | không nằm trong cache |
| Thông tin lúc chạy | không có | có: cảnh báo lúc chạy, và ở bản engine mới có cả thời gian trôi và thời gian CPU |
Hệ quả thực dụng: khi gỡ lỗi thì luôn lấy actual plan. Không phải vì nó là "kế hoạch thật hơn", mà vì chỉ nó mang theo số dòng thật và cảnh báo lúc chạy — hai thứ anh em cần để so với ước lượng.
Còn một chế độ thứ ba ít người dùng: Live Query Statistics. Nó cho xem kế hoạch của câu đang chạy dở, cập nhật mỗi giây, kèm số dòng đang chảy qua từng toán tử và tiến độ ước lượng. Dùng khi có một câu chạy mười phút chưa xong mà không biết tắc ở đâu — chờ nó xong để xem actual plan thì mất thêm mười phút.
Plan từ đâu ra: optimizer nhìn thống kê, không nhìn dữ liệu
Trước khi đọc plan thì phải biết plan sinh ra thế nào. Theo tài liệu, Query Optimizer nhận vào đúng ba thứ:
- Câu truy vấn.
- Schema — định nghĩa bảng và định nghĩa index.
- Thống kê — mô tả tóm tắt về phân bố dữ liệu.
Số ba là thứ hay bị quên nhất, và gần như mọi kế hoạch tồi tôi từng gỡ đều truy về nó. Optimizer không nhìn dữ liệu thật; nó nhìn bản tóm tắt. Bản tóm tắt cũ hoặc lệch thì kế hoạch nó chọn cũng lệch theo — mà nó không hề biết mình đang sai.
Đây cũng là lý do pg_upgrade của PostgreSQL 18 mới bổ sung việc giữ lại thống kê khi nâng cấp; tôi có nói trong bài so sánh SQL Server 2025 với PostgreSQL 18.
Một plan trả lời ba câu hỏi
Bóc ra thì mọi execution plan chỉ là câu trả lời cho ba câu:
- Đọc các bảng theo thứ tự nào. Câu truy vấn ba bảng thì có sáu thứ tự khả dĩ, optimizer phải chọn một.
- Lấy dữ liệu từ mỗi bảng bằng cách nào — dùng index, hay quét cả bảng.
- Tính toán, lọc, gộp và sắp xếp bằng cách nào — cho
WHERE,GROUP BY,ORDER BY.
Mọi ký hiệu trên sơ đồ đều là một mảnh của một trong ba câu trả lời này.
Đọc theo chiều nào
Dữ liệu chảy từ phải sang trái. Mấy toán tử tận cùng bên phải là lá — chỗ đọc dữ liệu từ ổ đĩa; rồi dữ liệu chảy dần sang trái qua từng bước biến đổi, lọc, ghép. Câu SELECT nằm bên trái ngoài cùng là chỗ dữ liệu đi ra, không phải chỗ bắt đầu.
Nhưng tài liệu có một câu tôi thấy hay mà ít người để ý: cả hai chiều đọc đều có ích.
- Phải → trái: cho thấy dữ liệu nào đi vào mỗi toán tử.
- Trái → phải: cho thấy toán tử nào đang điều khiển công việc — ai gọi ai.
Khi gỡ một plan rối, tôi đi một lượt mỗi chiều.
Seek và Scan: khác biệt thật nằm ở đâu
Đây là cặp quan trọng nhất, và cũng là chỗ bị dạy sai nhiều nhất. Xin đừng học thuộc kiểu "seek tốt, scan xấu".
Theo tài liệu:
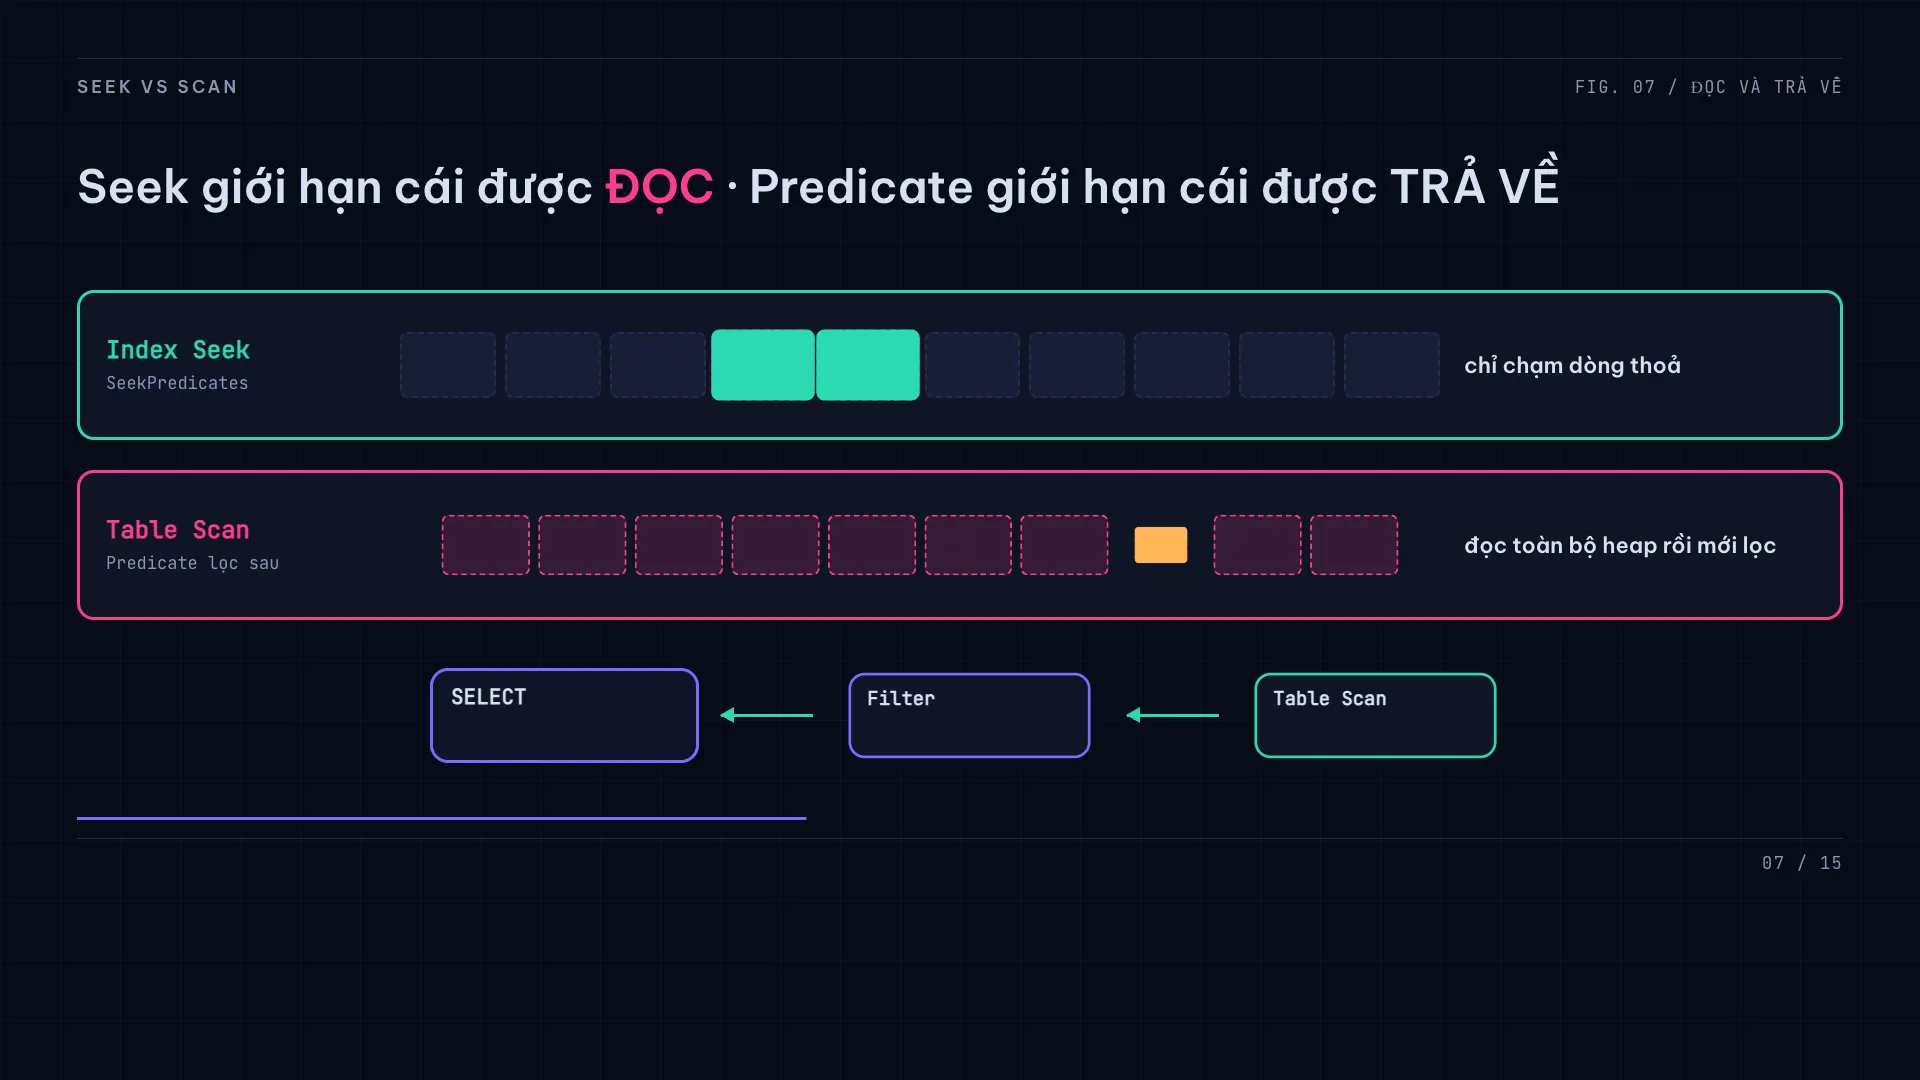
Index Seekdùng khả năng tìm kiếm của index để lấy dòng, và engine chỉ xử lý những dòng thoả thuộc tínhSeekPredicates. Chữ chỉ đó là toàn bộ câu chuyện.Table Scanlấy toàn bộ dòng từ bảng heap. Nó có thể có thêm thuộc tínhPredicateđể lọc — nhưng lọc là lọc sau khi đã đọc.
Nói gọn lại, và đây là câu tôi muốn anh em mang về:
SeekPredicatesgiới hạn cái được ĐỌC.Predicatechỉ giới hạn cái được TRẢ VỀ.
Hai câu truy vấn có thể trả về cùng ba dòng, nhưng một câu chạm ba dòng còn câu kia chạm hai triệu dòng rồi bỏ đi gần hết.
Nhưng scan không phải lúc nào cũng xấu
Nếu câu truy vấn cần gần hết số dòng trong bảng thì quét một lượt tuần tự rẻ hơn nhiều so với nhảy vào index vài trăm nghìn lần. Bảng nhỏ cũng vậy — quét luôn nhanh hơn tra cứu.
Tài liệu còn cho một ví dụ đẹp: một Clustered Index Scan nằm dưới toán tử Top thì không quét hết bảng — nó dừng ngay khi Top đã đủ số dòng cần.
Nên câu hỏi đúng không phải "seek hay scan", mà là: toán tử này đọc bao nhiêu dòng, và câu truy vấn của tôi thật sự cần bao nhiêu dòng.
Thứ nhìn đầu tiên: ước lượng so với thật
Trên actual plan, mỗi toán tử mang hai con số: số dòng ước lượng và số dòng thật. Đây là chỗ tôi nhìn trước cả seek với scan.
Vì sao? Optimizer chọn kế hoạch dựa trên ước lượng. Nên nếu nó ước lượng 100 dòng mà thực tế chảy qua 2.000.000 dòng, thì kế hoạch nó chọn được thiết kế cho một bài toán khác hẳn bài toán thật. Không phải optimizer dở — nó bị cho thông tin sai.
Cách làm: tìm toán tử có tỉ lệ lệch lớn nhất, rồi đi từ phải sang trái. Chỗ lệch đầu tiên gần như luôn là gốc; mọi thứ sau nó chỉ là hậu quả dây chuyền — một toán tử nhận sai số dòng thì mọi toán tử phía sau cũng sai theo.
Rồi hỏi tiếp: vì sao lệch? Ba nguyên nhân phổ biến nhất là thống kê cũ, tham số bị sniff, và biểu thức làm optimizer không ước lượng nổi.
Phần trăm chi phí: đừng để nó dẫn mũi
Mỗi toán tử hiện một con số phần trăm, và phản xạ tự nhiên là nhảy vào cái to nhất. Nhưng phải hiểu con số đó là gì.
Tài liệu nói các toán tử vật lý có chi phí gắn với chúng — đó là chi phí do mô hình của optimizer tính ra, không phải thời gian đo được. Và nó tính từ chính mấy con số ước lượng vừa nói ở trên.
Hệ quả: khi ước lượng đã sai thì phần trăm chi phí cũng sai theo, cùng một hướng. Toán tử ngốn thời gian thật nhất có thể đang hiện phần trăm bé tí.
Tôi không nói bỏ qua nó. Chỉ là: nhìn số dòng lệch trước, nhìn phần trăm sau.
Cảnh báo trên toán tử
Actual plan mang theo cảnh báo lúc chạy — một trong những thứ estimated plan không có, và là lý do lớn để luôn lấy actual. Trên sơ đồ nó hiện thành một dấu nhỏ gắn vào toán tử.
Tôi cố ý không liệt kê từng loại cảnh báo ở đây, vì mỗi bản engine một khác và tôi không muốn anh em học thuộc một danh sách rồi lỗi thời. Cách làm đúng đơn giản hơn: thấy dấu cảnh báo thì bấm vào toán tử, mở khung Properties ra đọc nguyên văn. Engine nói thẳng nó không hài lòng chuyện gì.
Key Lookup: gặp hoài mà ít người biết tên
Key Lookup là thao tác tra cứu ngược về bảng có clustered index. Vì sao xuất hiện? Vì anh em có một nonclustered index chứa đủ cột để tìm, nhưng thiếu cột để trả về. Engine seek vào index, lấy được khoá, rồi phải quay về bảng chính lấy nốt mấy cột còn thiếu — mỗi dòng một lần.
Tài liệu ghi một chi tiết nhận dạng rất tiện: Key Lookup luôn đi kèm một toán tử Nested Loops. Thấy cặp đó là biết ngay.
Vài chục dòng thì không sao. Vài trăm nghìn dòng thì đó chính là chỗ câu truy vấn đang chết, và cách chữa thường là đưa mấy cột thiếu vào index.
Không có SSMS thì làm sao
Nhiều khi anh em chỉ có một cửa sổ dòng lệnh trên máy chủ. Vẫn xem được:
SET SHOWPLAN_TEXT ON;
-- rồi chạy câu truy vấn
SET SHOWPLAN_TEXT và SET SHOWPLAN_ALL cho ra kế hoạch dưới dạng bảng chữ thay vì sơ đồ hình. Xấu hơn, nhưng đọc được — và quan trọng là dán được vào ticket hay chat cho người khác xem cùng. Muốn giữ lại để mở bằng SSMS sau thì lưu ra file XML.
Lấy plan của câu đã chạy rồi
Đây là thứ tôi nghĩ nhiều anh em chưa biết, có từ SQL Server 2019.
Bình thường muốn xem actual plan thì phải bật lên trước rồi chạy lại câu truy vấn. Nhưng sự cố thì không lặp lại theo yêu cầu — lúc anh em chạy lại thì mọi thứ đã bình thường.
Bản 2019 thêm hàm quản trị sys.dm_exec_query_plan_stats, trả về cái tương đương actual plan gần nhất đã biết cho mọi câu truy vấn. Bật bằng cấu hình phạm vi database LAST_QUERY_PLAN_STATS.
Nghĩa là xem được kế hoạch thật của câu vừa chạy, mà không phải bắt nó chạy lại.
Quy trình ba bước
Khi có một câu chạy chậm:
- Lấy actual plan, không phải estimated — chỉ actual mới có số dòng thật để đối chiếu.
- Đọc từ phải sang trái, tìm chỗ ước lượng lệch xa thực tế nhất. Chỗ lệch đầu tiên gần như luôn là gốc.
- Hỏi vì sao lệch — thống kê cũ, tham số bị sniff, hay biểu thức làm optimizer không ước lượng nổi.
Ba bước đó không cần công cụ đắt tiền nào. Chỉ cần chịu đọc.
Nguồn
- Execution Plan Overview — Microsoft Learn
- Display and save execution plans — Microsoft Learn
- Showplan Logical and Physical Operators Reference — Microsoft Learn
- What's New in SQL Server 2019 — Microsoft Learn
- Bài trước: SQL Server 2025 vs PostgreSQL 18 · SQL Server 2019 → 2025