Chào anh em. Trong sáu năm, SQL Server ra ba bản lớn: 2019 (15.x), 2022 (16.x) và 2025 (17.x). Ba bản này không phải ba bước trên cùng một con đường — mỗi bản đi một hướng khác hẳn, và có những thứ bản này giới thiệu rầm rộ thì bản sau gỡ bỏ.
Bài này điểm lại từng bản đổi cái gì, cái gì đã bị khai tử, và mốc hết hỗ trợ — thứ quyết định anh em có phải nâng cấp hay không.
Một câu rào trước cho tử tế: bài này bám tài liệu chính thức của Microsoft, link nguồn nằm ở cuối. Chỗ nào là nhận định của tôi thì tôi ghi rõ là nhận định.
Xem bản video
Bảng tóm tắt
| SQL Server 2019 | SQL Server 2022 | SQL Server 2025 | |
|---|---|---|---|
| Số hiệu | 15.x | 16.x | 17.x |
| Compatibility level | 150 | 160 | 170 |
| Chủ đề chính | Truy vấn thông minh + dữ liệu lớn | Kết nối đám mây | AI trong chính database |
| Mainstream support | đã hết 28/02/2025 | tới 11/01/2028 | đang trong vòng đời |
| Extended support | tới 08/01/2030 | — | — |
GA của bản 2025 là 18/11/2025, build 17.0.1000.7, chạy trên cả Windows, Linux và container.
SQL Server 2019 — truy vấn tự sửa mình, và canh bạc dữ liệu lớn
Intelligent Query Processing: engine tự sửa kế hoạch
Đây là phần có giá trị lâu dài nhất của bản 2019, và cái hay là nó không cần sửa một dòng code nào — chỉ cần đặt compatibility level 150.
- Row mode memory grant feedback — engine nhìn lần chạy trước để chỉnh lượng bộ nhớ cấp cho truy vấn. Cấp thừa thì phí và giảm số truy vấn chạy song song; cấp thiếu thì tràn ra đĩa.
- Batch mode on rowstore — trước 2019, muốn chạy batch mode phải có columnstore index. Từ 2019, truy vấn phân tích trên bảng rowstore thường cũng dùng được.
- Scalar UDF inlining — hàm vô hướng do anh em viết được engine biến thành biểu thức quan hệ và nhúng thẳng vào câu truy vấn gọi nó. Đây là chỗ nhiều hệ thống cũ tự dưng nhanh hẳn sau khi nâng cấp, mà chủ hệ thống không hiểu vì sao.
- Table variable deferred compilation — biến bảng không còn bị ước lượng cứng là 1 dòng nữa.
APPROX_COUNT_DISTINCT— đếm gần đúng, tốn ít tài nguyên hơnCOUNT(DISTINCT())nhiều. Dùng khi cần nhanh hơn là cần chính xác tuyệt đối.
Khởi động lại nhanh hơn hẳn
Accelerated Database Recovery (ADR) rút ngắn thời gian phục hồi sau khi khởi động lại, và rút ngắn thời gian rollback một giao dịch chạy dài. Ai từng ngồi nhìn ROLLBACK chạy hai tiếng thì hiểu giá trị của cái này.
Memory-optimized tempdb metadata — mấy bảng hệ thống quản lý metadata của bảng tạm được chuyển sang bảng memory-optimized không cần latch. Đây là thuốc đặc trị cho hệ thống nghẽn ở tempdb.
Cùng nhóm còn có concurrent PFS updates (cập nhật trang PFS dưới shared latch thay vì exclusive) và OPTIMIZE_FOR_SEQUENTIAL_KEY cho index bị tranh chấp trang cuối — kinh điển với khoá tự tăng.
UTF-8, và vì sao nó quan trọng với tiếng Việt
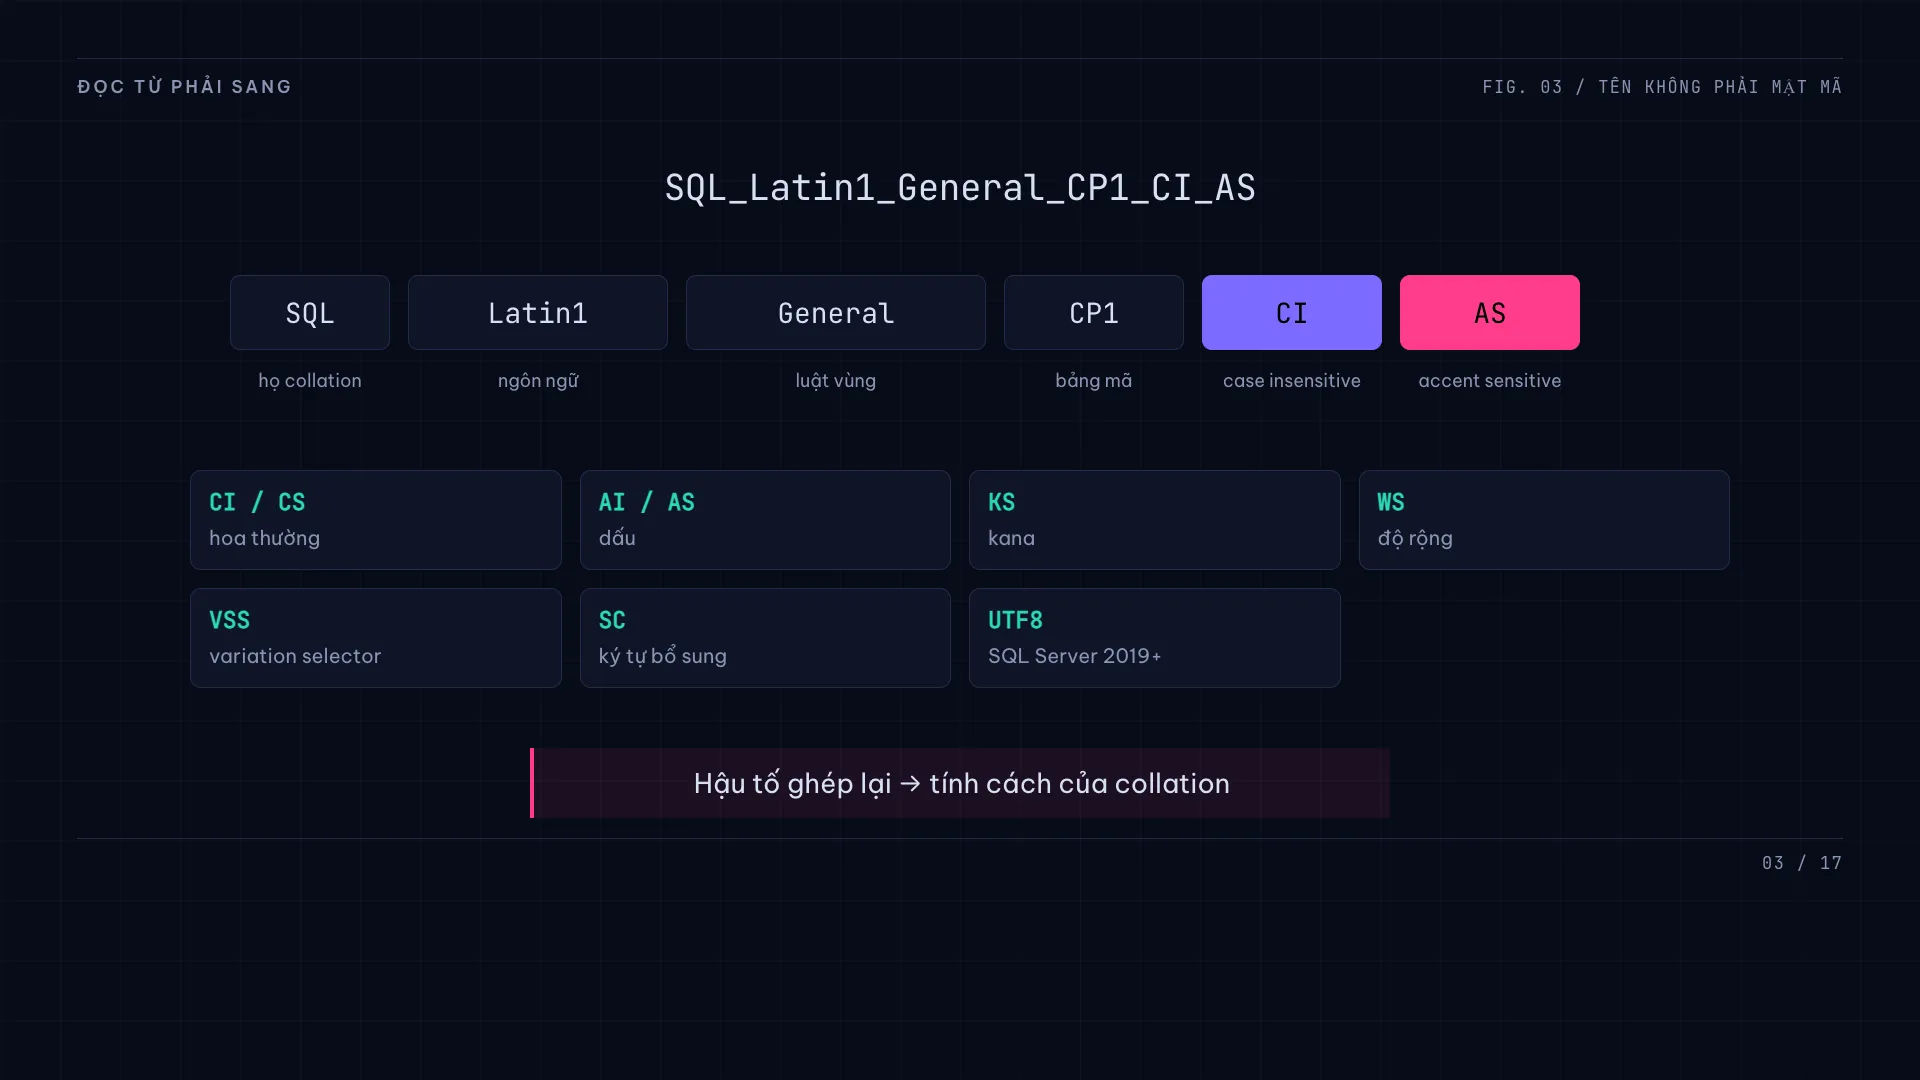
Bản 2019 hỗ trợ UTF-8 làm collation ở mức database hoặc mức cột. Trước đó muốn Unicode là phải NVARCHAR (2 byte mỗi ký tự). Với dữ liệu chủ yếu là ASCII kèm một ít tiếng Việt, UTF-8 tiết kiệm được kha khá dung lượng.
Nói thêm cho rõ: đây là chuyện lưu trữ, không phải chuyện so sánh chuỗi. Luật so sánh vẫn do collation quyết định, và đó là chỗ .NET với SQL Server hay bất đồng — tôi có nói kỹ trong bài về collation.
Vài thứ nhỏ mà dùng hàng ngày
- Verbose truncation warnings — lỗi cắt cụt dữ liệu giờ in ra tên bảng, tên cột và giá trị bị cắt. Trước đây chỉ báo "String or binary data would be truncated" rồi để anh em tự đi tìm trong bảng hai trăm cột.
- Always Encrypted with secure enclaves — tính toán trên dữ liệu đã giải mã bên trong vùng an toàn phía server, nên so khớp mẫu và so sánh dùng được với cột đã mã hoá.
- Data Discovery & Classification — gắn nhãn cột nhạy cảm, và nhãn đó đi vào bản ghi audit.
SHORTEST_PATHtrongMATCHcho graph database.- Resumable online index build cho rowstore, và build/rebuild online cho clustered columnstore index.
Big Data Clusters: bài học đắt nhất
Bản 2019 giới thiệu Big Data Clusters — cụm SQL Server + Spark + HDFS chạy trên Kubernetes. Nghe rất tương lai.
Rồi Microsoft thông báo khai tử ngày 25/02/2022, cho ba năm chuyển tiếp, và ngừng hẳn ngày 28/02/2025. Lý do họ đưa ra: phản hồi khách hàng cho thấy làm phân tích trên đám mây hợp hơn với kỹ năng của đội, đơn giản hơn khi triển khai và vận hành.
Để ý cái ngày: 28/02/2025 cũng đúng là ngày SQL Server 2019 hết mainstream support. Tính năng đinh của một bản và chính bản đó rời sân cùng một hôm.
[Nhận định của tôi] Đây là lý do tôi luôn dè chừng với tính năng "nền tảng mới" đi kèm một bản database: nó gắn số phận vào vòng đời của bản đó, mà vòng đời thì ngắn hơn tuổi thọ hệ thống của anh em nhiều.
SQL Server 2022 — bản của những sợi dây nối ra ngoài
Nếu 2019 đào vào bên trong engine, thì 2022 chủ yếu nối SQL Server ra ngoài.
Nối ra đám mây
- Link to Azure SQL Managed Instance — sao chép dữ liệu từ instance của anh em sang Managed Instance để dự phòng thảm hoạ hoặc để di trú.
- Azure Synapse Link for SQL — phân tích gần thời gian thực trên dữ liệu vận hành. (Cái này đã bị gỡ ở bản 2025, xem phần dưới.)
- Microsoft Defender for Cloud và Microsoft Purview — tích hợp bảo vệ và quản trị dữ liệu.
- Microsoft Entra authentication — đăng nhập SQL Server bằng danh tính Entra ID.
Nối ra kho object
Backup/restore tới object storage tương thích S3 qua cú pháp BACKUP/RESTORE TO/FROM URL. Và Data Lake Virtualization — PolyBase truy vấn được file parquet trên S3 bằng T-SQL. Với ai đang chạy MinIO hay Ceph tại chỗ thì đây là thay đổi lớn.
Ledger: sổ cái chống sửa
Ledger cho phép chứng minh bằng mật mã rằng dữ liệu chưa bị sửa lén — hợp với kiểm toán. Đây là tính năng hiếm hoi trong nhóm này mà tôi thấy có giá trị thật ngoài chuyện marketing, vì nó giải một bài toán niềm tin mà quyền hạn database không giải được: DBA có quyền sửa, nên chữ ký của DBA không chứng minh được gì.
Query Store và IQP: thêm ba tầng phản hồi
Nhóm này là phần tôi khuyên anh em để mắt nhất ở bản 2022:
- Parameter Sensitive Plan optimization (PSPO) — một câu lệnh tham số hoá giờ có nhiều kế hoạch cùng nằm trong cache, hợp với các khoảng dữ liệu khác nhau. Đây là câu trả lời cho căn bệnh parameter sniffing kinh điển: một plan tối ưu cho khách hàng có 10 đơn hàng thì thảm hoạ với khách hàng có 10 triệu đơn.
- Degree of parallelism (DOP) feedback — tự chỉnh mức song song cho truy vấn lặp lại.
- Cardinality estimation feedback — sửa giả định ước lượng sai cho truy vấn lặp lại.
- Memory grant feedback bản percentile + persistence — phản hồi được lưu vào Query Store, nên không mất khi plan bị đẩy khỏi cache.
- Query Store hints — nắn kế hoạch mà không sửa code ứng dụng. Cực kỳ hữu dụng với phần mềm đóng gói của bên thứ ba.
- Query Store bật sẵn cho database mới tạo, và chạy được trên secondary replica.
Cả nhóm này đều cần Query Store bật và ở chế độ đọc-ghi.
T-SQL: một nắm hàm lẽ ra phải có từ lâu
DATE_BUCKET, GENERATE_SERIES, DATETRUNC, GREATEST, LEAST, STRING_SPLIT, TRIM/LTRIM/RTRIM bản đầy đủ, APPROX_PERCENTILE_CONT/DISC, nhóm hàm thao tác bit (BIT_COUNT, GET_BIT, SET_BIT, LEFT_SHIFT, RIGHT_SHIFT), nhóm hàm JSON (ISJSON, JSON_PATH_EXISTS, JSON_OBJECT, JSON_ARRAY), mệnh đề SELECT ... WINDOW, và IS [NOT] DISTINCT FROM.
Cái cuối đáng nói riêng: nó so hai biểu thức mà luôn trả về true hoặc false, không bao giờ trả về NULL. Ai từng viết WHERE (a = b OR (a IS NULL AND b IS NULL)) thì biết mình vừa được cứu.
Một thay đổi âm thầm dễ làm sập build
SQL Server Native Client (SNAC) bị gỡ khỏi bản 2022. SQLNCLI/SQLNCLI11 và OLE DB provider cũ SQLOLEDB không còn được khuyến nghị cho dự án mới. Ứng dụng cũ còn dùng chuỗi kết nối trỏ vào SNAC sẽ chết khi lên máy chủ mới.
SQL Server 2025 — AI dọn vào ở trong database
Bản 2025 là bản đổi hướng rõ nhất: thay vì đẩy dữ liệu ra chỗ khác để làm AI, nó kéo AI vào trong engine.
Vector: kiểu dữ liệu bậc một
- Kiểu
vector— lưu embedding ở dạng nhị phân tối ưu nhưng đọc ra như mảng JSON. Mỗi phần tử lưu bằng số thực 4 byte hoặc 2 byte. - Hàm vector:
VECTOR_DISTANCE,VECTOR_NORM,VECTOR_NORMALIZE,VECTORPROPERTY. CREATE VECTOR INDEXvàVECTOR_SEARCHcho tìm kiếm xấp xỉ láng giềng gần nhất.CREATE EXTERNAL MODEL— khai báo endpoint mô hình AI ngay trong database, rồiAI_GENERATE_EMBEDDINGSsinh vector vàAI_GENERATE_CHUNKScắt văn bản thành đoạn.
Nghĩa là toàn bộ đường ống RAG — cắt đoạn, sinh embedding, tìm tương đồng — làm được bằng T-SQL, không cần kéo dữ liệu ra ngoài.
Lưu ý quan trọng: CREATE VECTOR INDEX, VECTOR_SEARCH và nhóm hàm so chuỗi mờ đều cần bật PREVIEW_FEATURES ở database scoped configuration. Tức là ở thời điểm GA, chúng chưa phải tính năng chính thức. Đừng đưa vào production mà không đọc kỹ chỗ này.
JSON thành kiểu dữ liệu thật
Trước đây JSON trong SQL Server là chữ nằm trong cột nvarchar. Bản 2025 có kiểu json nhị phân thật, cộng thêm JSON_OBJECTAGG và JSON_ARRAYAGG để gom kết quả thành object/mảng JSON.
Đây cũng là chỗ nối với EF Core 10: nếu anh em cấu hình UseAzureSql hoặc đặt compatibility level từ 170 trở lên, EF tự động dùng kiểu json mới, và migration kế tiếp sẽ đổi mọi cột nvarchar(max) đang chứa JSON sang json. Nếu chưa muốn đổi thì phải chủ động hạ compatibility level hoặc ép kiểu cột — tôi có nói kỹ trong bài về EF Core dịch LINQ sang SQL.
Regex, cuối cùng cũng có
REGEXP_LIKE, REGEXP_REPLACE, REGEXP_SUBSTR, REGEXP_INSTR, REGEXP_COUNT, REGEXP_MATCHES, REGEXP_SPLIT_TO_TABLE.
Sau bao nhiêu năm phải viết CLR function hoặc lôi dữ liệu ra tầng ứng dụng chỉ để khớp một cái mẫu, giờ nó nằm ngay trong T-SQL.
Optimized locking: bớt khoá, bớt nghẽn
Optimized locking giảm chặn nhau, giảm bộ nhớ dành cho khoá, và tránh leo thang khoá. [Nhận định] Với hệ thống OLTP nhiều ghi, tôi nghĩ đây là tính năng đáng giá nhất của cả bản 2025 — hơn hẳn phần AI, dù phần AI được nói nhiều hơn.
Cùng nhóm còn có:
- Tempdb space resource governance — chặn một workload chạy loạn ngốn sạch
tempdb. - ADR trong
tempdb. - Persisted statistics cho readable secondary.
sp_executesqltối ưu — cho phép các lời gọisp_executesqlxếp hàng khi biên dịch, giảm hiện tượng compilation storm (hàng loạt truy vấn biên dịch cùng lúc).- ZSTD làm thuật toán nén bản sao lưu, nhanh và hiệu quả hơn.
- Ordered nonclustered columnstore index, build online cho ordered columnstore.
IQP thêm hai tầng nữa
- Optional parameter plan optimization (OPPO) — sinh nhiều kế hoạch từ một câu lệnh, giả định khác nhau tuỳ giá trị tham số. Đây là bước tiếp theo của PSPO ở bản 2022, nhắm vào kiểu thủ tục có
WHERE (@p IS NULL OR col = @p). - Cardinality estimation feedback cho biểu thức.
- DOP feedback và Query Store cho secondary replica giờ bật mặc định.
ABORT_QUERY_EXECUTION— chặn hẳn không cho một truy vấn có vấn đề chạy nữa.
Sao lưu và HA
- Full và differential backup trên secondary replica — trước chỉ làm được copy-only.
- Sao lưu tới immutable blob storage.
- TLS 1.3 với TDS 8.0 trải khắp: SQL Agent,
sqlcmd,bcp, linked server, replication, log shipping, availability group, FCI. - PBKDF2 làm mặc định cho băm mật khẩu.
Đổi về ấn bản, đọc kỹ trước khi mua
- Standard edition nới trần: tối đa 4 socket hoặc 32 nhân, buffer pool 256 GB. Và Resource Governor giờ có trong Standard — trước đây là tính năng riêng của Enterprise.
- Express edition nới trần database lên 50 GB.
- Web edition bị khai tử.
- Có thêm Standard Developer edition và Enterprise Developer edition, đều miễn phí cho mục đích phát triển.
Cái gì đã biến mất
Đây là phần tôi nghĩ đáng đọc nhất, vì nó quyết định anh em có nâng cấp được hay không:
| Thứ bị gỡ | Gỡ ở bản | Thay bằng |
|---|---|---|
| SQL Server Native Client (SNAC) | 2022 | ODBC Driver hoặc OLE DB Driver mới |
| Big Data Clusters | ngừng 28/02/2025 | phân tích trên đám mây |
| Data Quality Services (DQS) | 2025 | — (còn hỗ trợ ở 2022 trở về trước) |
| Master Data Services (MDS) | 2025 | — (còn hỗ trợ ở 2022 trở về trước) |
| Azure Synapse Link for SQL | 2025 | Mirroring in Fabric |
| Purview access policies | 2025 | fixed server roles |
| Web edition | 2025 | — |
| Reporting Services đứng riêng | 2025 | gộp vào Power BI Report Server |
| Runtime R/Python/Java cài kèm | 2022 | tự cài runtime riêng |
Và hai thứ đã bị đánh dấu deprecated ở bản 2025, dự kiến gỡ ở bản sau: hot add CPU và lightweight pooling (chế độ fiber).
Nên nâng cấp không?
Không có câu trả lời chung, nhưng có mấy mốc rõ ràng để anh em tự quyết:
Nếu đang chạy 2019 hoặc cũ hơn — mainstream support đã hết từ 28/02/2025. Nghĩa là chỉ còn vá bảo mật, không còn sửa lỗi thường. Extended support kéo tới 08/01/2030, nên chưa cháy nhà, nhưng đồng hồ đã chạy.
Nếu đang chạy 2022 — mainstream tới 11/01/2028. Không vội. Lý do đáng để nhảy lên 2025 là: cần optimized locking, cần kiểu json thật, cần regex trong T-SQL, hoặc cần vector search ngay trong database.
Nếu định lên 2025, kiểm ba thứ trước:
- Có đang dùng DQS, MDS hay Synapse Link không — cả ba đều bị gỡ.
- Tính năng anh em nhắm tới có nằm sau
PREVIEW_FEATURESkhông. Vector index,VECTOR_SEARCH, so chuỗi mờ, change event streaming đều nằm sau cái cờ đó. - Nếu ứng dụng chạy EF Core 10 và dùng JSON, tính trước chuyện compatibility level 170 tự động chuyển cột sang kiểu
json.
[Nhận định của tôi] Nhìn ba bản cạnh nhau, tôi thấy một quy luật: thứ đáng tiền nhất trong mỗi bản đều là thứ ít được quảng cáo nhất. Bản 2019 người ta nói Big Data Clusters, nhưng thứ còn sống là scalar UDF inlining và ADR. Bản 2022 người ta nói tích hợp đám mây, nhưng thứ cứu hệ thống của anh em là PSPO và Query Store hints. Bản 2025 người ta nói AI, còn tôi thì đặt cược vào optimized locking.
Cách kiểm thì vẫn chỉ có một: dựng một bản sao, chạy đúng workload của mình, mở execution plan ra mà đối chiếu. Đoán thì không tính.
Nguồn
- What's New in SQL Server 2019 — Microsoft Learn
- What's New in SQL Server 2022 — Microsoft Learn
- What's New in SQL Server 2025 — Microsoft Learn
- SQL Server 2025 Release Notes — Microsoft Learn
- SQL Server 2025 is Now Generally Available — Microsoft Community Hub
- Retirement of SQL Server 2019 Big Data Clusters — Microsoft Lifecycle
- SQL Server 2019 lifecycle — Microsoft Lifecycle
- Collation and Unicode Support — Microsoft Learn