Chào anh em. Tình huống này chắc ai cũng gặp: có index hẳn hoi trên đúng cái cột đang lọc, mà mở execution plan ra thì vẫn thấy Scan. Rồi ngồi nghi optimizer.
Ba lý do phổ biến nhất — và tôi nói trước cho anh em đỡ mất thời gian nghi oan: cả ba đều là do phía mình.
Xem bản video
Trước hết: SARGable
Cần một chữ, và may là tài liệu Microsoft dùng đúng chữ này chứ không phải tôi mượn từ dân gian:
The term SARGable in relational databases refers to a Search ARGumentable predicate that can use an index to speed up the execution of the query.
Hết. Ngắn thế thôi, nhưng nó là toàn bộ khung để suy nghĩ. Câu hỏi mỗi khi anh em viết một mệnh đề WHERE là: mệnh đề này có SARGable không — engine có thể dùng index để đi thẳng tới chỗ cần, hay nó buộc phải đọc hết rồi mới lọc.
Nói luôn một chuyện để anh em biết đường tự tra: tôi có vào trang Predicates của tài liệu, tưởng sẽ có bảng kiểu "mấy dạng này SARGable, mấy dạng kia không". Không có. Trang đó chỉ định nghĩa predicate là biểu thức trả về TRUE/FALSE/UNKNOWN, rồi liệt kê bốn predicate đặc biệt: CONTAINS, FREETEXT, IS [NOT] DISTINCT FROM, IS NULL. Nên đừng đi tìm bảng tra cứu — nó không tồn tại. Thứ thay thế được nó là hiểu cơ chế.
Lý do 1 — thứ tự cột trong index
Đây là lý do tôi nghĩ phổ biến nhất. Tài liệu có quy tắc rất rõ:
Consider the order of the index key columns if the key contains multiple columns. The column that is used in the query predicate in an equality (
=), inequality (>,>=,<,<=), orBETWEENexpression, or participates in a join, should be placed first. Additional columns should be ordered based on their level of distinctness, that is, from the most distinct to the least distinct.
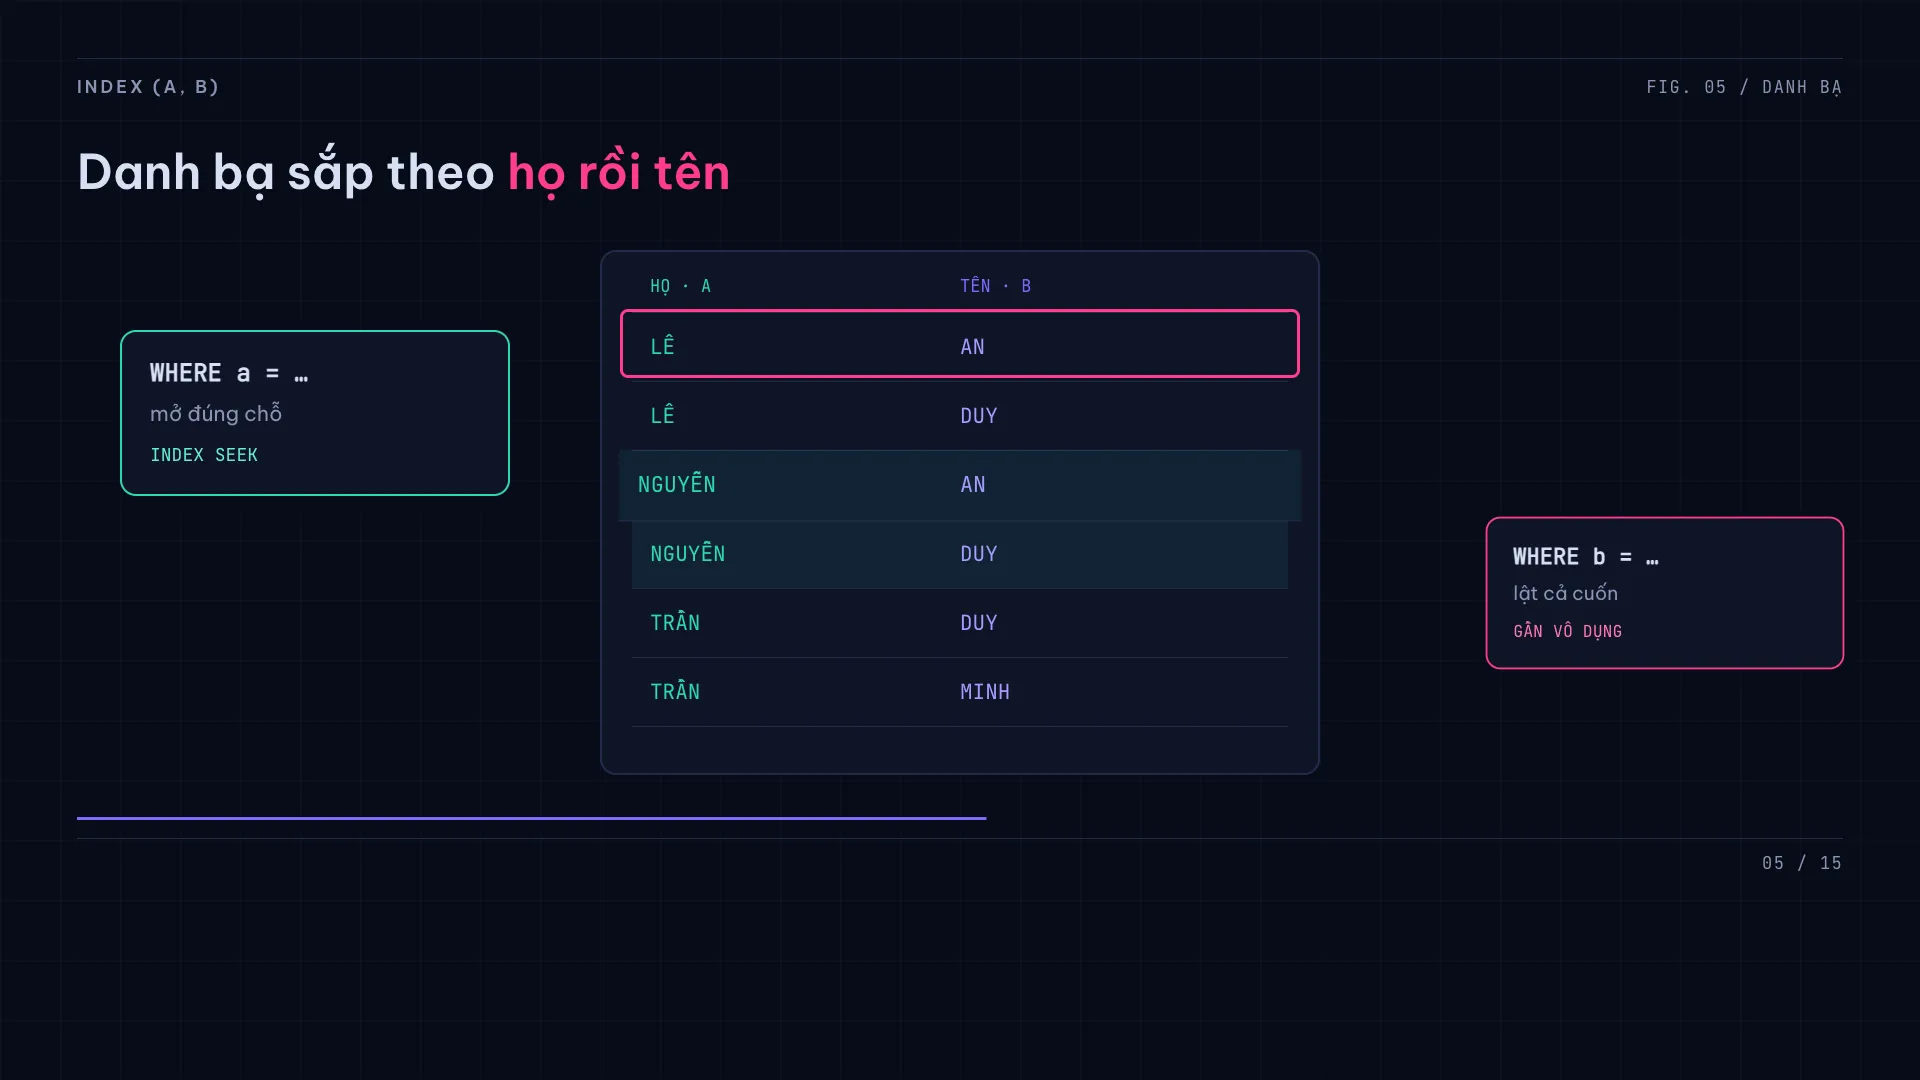
Cụ thể hoá cho dễ nhớ. Anh em có index trên (a, b):
| Truy vấn | Kết quả |
|---|---|
WHERE a = … | index dùng được, Index Seek |
WHERE b = … | index gần như vô dụng |
Vì sao? Nghĩ về cuốn danh bạ sắp theo họ rồi tên. Tìm người họ Nguyễn thì mở đúng chỗ. Tìm tất cả người tên là Duy, bất kể họ gì, thì phải lật cả cuốn — vì tên chỉ được sắp trong phạm vi từng họ, còn toàn cuốn thì tên nằm rải rác.
Index nhiều cột hoạt động đúng như vậy. Không phải optimizer dở; nó không có đường nào khác.
Đối chiếu: PostgreSQL 18 vừa vá chỗ này
PostgreSQL 18 (ra 25/09/2025) thêm skip scan cho B-tree nhiều cột: index dùng được cả khi truy vấn không ràng buộc cột đầu. Nghĩa là đúng cái tình huống "tìm người tên Duy bất kể họ", PostgreSQL 18 xử lý được ở mức index.
Trong tài liệu thiết kế index của SQL Server mà tôi tra, không có tương đương được ghi. Nên với SQL Server, quy tắc thứ tự cột vẫn là quy tắc anh em phải tự tuân.
Lý do 2 — bọc hàm quanh cột
Cái này gặp trong code nhiều hơn trong thiết kế. Khi anh em bọc một hàm quanh cột trong WHERE, index trên cột đó thường mất tác dụng.
Ví dụ kinh điển nhất là gọi ToLower để so chuỗi không phân biệt hoa thường. Tài liệu EF Core nói rõ: dùng string.ToLower để ép so sánh không phân biệt hoa thường nghe có vẻ tiện, nhưng làm vậy có thể khiến ứng dụng không dùng được index. Tài liệu còn có cảnh báo riêng: ghi đè case-sensitivity bằng EF.Functions.Collate hoặc string.ToLower có thể ảnh hưởng rất lớn tới hiệu năng.
Vì sao bọc hàm là mất index
Vì index được sắp theo giá trị gốc của cột, không phải theo giá trị sau khi biến đổi.
Index lưu Duy, DUY, duy ở ba chỗ khác nhau theo đúng thứ tự sắp của nó. Anh em yêu cầu engine so ToLower(cột) với một chuỗi, thì engine phải tính ToLower cho từng dòng trước — mà muốn tính từng dòng thì phải đọc từng dòng. Cái thứ tự sẵn có trong index không giúp gì được nữa.
Với COLLATE thì cùng một lý: index thừa hưởng collation của cột, nên nhét một collation khác vào câu truy vấn là luật so sánh không còn khớp với luật mà index đã dựng theo. Tôi có nói kỹ trong bài về collation.
Nói gọn: mọi phép biến đổi đặt lên cột đều phá cái thứ tự mà index bán cho anh em.
Lý do 3 — index thiếu cột để trả về
Anh em đã gặp nó ở bài về execution plan mà có thể chưa nối lại: Key Lookup.
Nó xuất hiện khi index có đủ cột để TÌM nhưng thiếu cột để TRẢ VỀ. Engine seek vào index, lấy được khoá, rồi phải quay về bảng chính lấy nốt mấy cột còn thiếu — mỗi dòng một lần. Tài liệu có chi tiết nhận dạng rất tiện: Key Lookup luôn đi kèm một toán tử Nested Loops.
Trường hợp này index có được dùng, nhưng dùng nửa vời — và cái nửa còn lại đắt kinh khủng khi số dòng lớn.
Cách chữa: covering index
Tài liệu định nghĩa rõ:
A covering index is a nonclustered index that satisfies all data access by a query directly without accessing the base table.
Cơ chế lợi cũng nói thẳng: engine tìm được hết giá trị trong chính index, bảng gốc không bị truy cập, nên ít I/O đĩa hơn. Ví dụ tài liệu: truy vấn lấy cột A và B trên bảng có composite index (A, B, C) lấy được dữ liệu từ index mà không cần vào bảng.
Quy tắc thiết kế quan trọng nhất
Such indexes have all the necessary SARGable columns in the index key, and non-SARGable columns as included columns.
Dịch sang tiếng Việt hàng ngày:
- Cột dùng để LỌC hoặc JOIN → cho vào khoá index (và nhớ quy tắc thứ tự ở lý do 1).
- Cột chỉ để LẤY RA hiển thị → nhét vào
INCLUDE.
Đừng nhồi hết vào khoá. Cột INCLUDE nằm ở tầng lá, không tham gia sắp xếp, nên nó không làm khoá index phình ra và không làm chậm việc duy trì thứ tự.
Hai chi tiết ít người nghĩ tới
Unique index không chỉ là ràng buộc
Tài liệu nói: một unique index, so với nonunique index trên cùng bộ cột khoá, cho optimizer thêm thông tin và làm index đó hữu dụng hơn; optimizer sinh được kế hoạch hiệu quả hơn khi index là unique.
Nghĩa là tính duy nhất không chỉ để chặn dữ liệu trùng — nó là thông tin cho bộ lập kế hoạch.
Hệ quả nữa: nếu clustered index không unique, engine tự thêm vào khoá một cột ẩn 4 byte gọi là uniqueifier. Bốn byte đó xuất hiện trong mọi index của bảng. Đưa sẵn một cột unique vào khoá clustered thì tiết kiệm được dung lượng, I/O và bộ nhớ trên toàn bộ bảng.
Index không phải càng nhiều càng tốt
Nhiều người thấy chậm là thêm index. Tài liệu cảnh báo hai chuyện:
- Index trên cột nhiều dòng nhưng ít giá trị phân biệt có thể không cải thiện gì. Cột trạng thái chỉ có 3 giá trị thì index trên nó gần như vô nghĩa cho việc lọc.
- Cột khoá nhiều giá trị trùng làm
INSERT/UPDATE/DELETEtệ đi. Vì mỗi lần ghi vào bảng là phải cập nhật mọi index của bảng đó.
Anh em thêm index để đọc nhanh hơn, và trả giá bằng ghi chậm hơn — mà cái giá đó thu đều đặn mỗi ngày, còn lợi ích thì chỉ thu ở mấy câu truy vấn cụ thể.
Filtered index — ít người dùng dù rất hợp
Index có điều kiện, chỉ đánh chỉ mục cho một phần số dòng. Tài liệu chỉ ra hai chỗ nó hợp: cột có rất nhiều NULL, và cột có tập con dữ liệu xác định rõ mà nhiều truy vấn cùng quan tâm.
Ba lợi ích tài liệu nêu: truy vấn nhanh hơn, giảm chi phí cập nhật index, và giảm dung lượng — vì chỉ lưu một phần nhỏ số dòng.
Nghĩ tới bảng đơn hàng mười năm mà phần lớn truy vấn chỉ hỏi đơn chưa xử lý — đây đúng là chỗ dùng.
Ba bước kiểm khi thấy index không được dùng
- Cột anh em đang lọc có nằm ở vị trí đầu của khoá index không?
- Câu truy vấn có bọc hàm nào quanh cột đó không —
ToLower,COLLATE, cắt chuỗi, đổi kiểu? - Index có đủ cột để trả về, hay đang phải quay về bảng bằng
Key Lookup?
Và một lời khuyên của chính tài liệu, vì nó chống lại thói quen của nhiều người:
Always make sure that the indexes you create are actually used by the query workload. Drop unused indexes.
Index không dùng vẫn thu phí ghi mỗi ngày. Muốn xem mình đang có những index nào thì tra sys.indexes và sys.index_columns.
Nguồn
- Index Architecture and Design Guide — Microsoft Learn
- Predicates — Microsoft Learn
- Collations and case sensitivity — EF Core, Microsoft Learn
- PostgreSQL 18 Release Notes — PostgreSQL Global Development Group
- Bài trước: Chặn nhau và parameter sniffing · Đọc execution plan