CDM が完成しただけではスタート地点に過ぎません。価値を引き出すにはツール群が必要です:ATLAS(コホート + characterization UI)、DQD(データ品質)、ACHILLES(プロファイリング)。本記事ではインストールと運用を解説します。
1. OHDSI analytics スタック
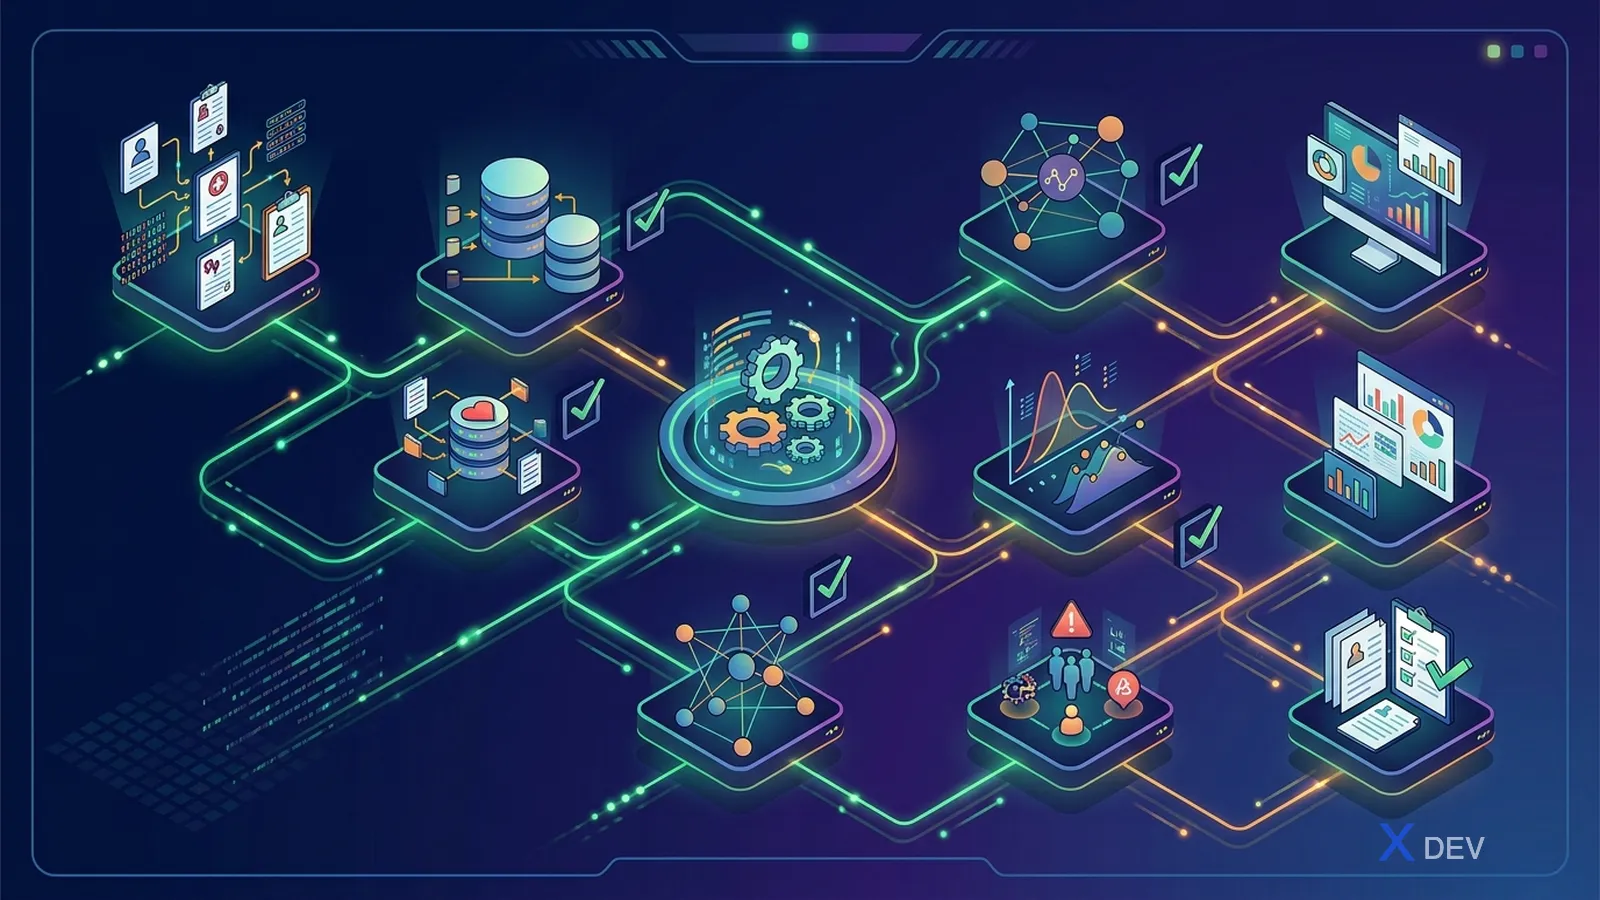
すべて Broadsea の Docker compose で動かせます。
2. Broadsea — 1 コマンドでデプロイ
git clone https://github.com/OHDSI/Broadsea
cd Broadsea
cp .env.example .env
# .env を編集:Postgres 接続、ATLAS ポート、セキュリティ
docker compose --profile default up -d

# アクセス:
# - ATLAS: http://localhost/atlas
# - WebAPI: http://localhost/WebAPI
# - HADES R Studio: http://localhost:8787
Broadsea のサービス:
broadsea-webtools— ATLAS + WebAPIbroadsea-hades— HADES プリインストール済みの RStudio Serverbroadsea-content— Atlas content portalohdsi-postgresql— WebAPI 用 DB
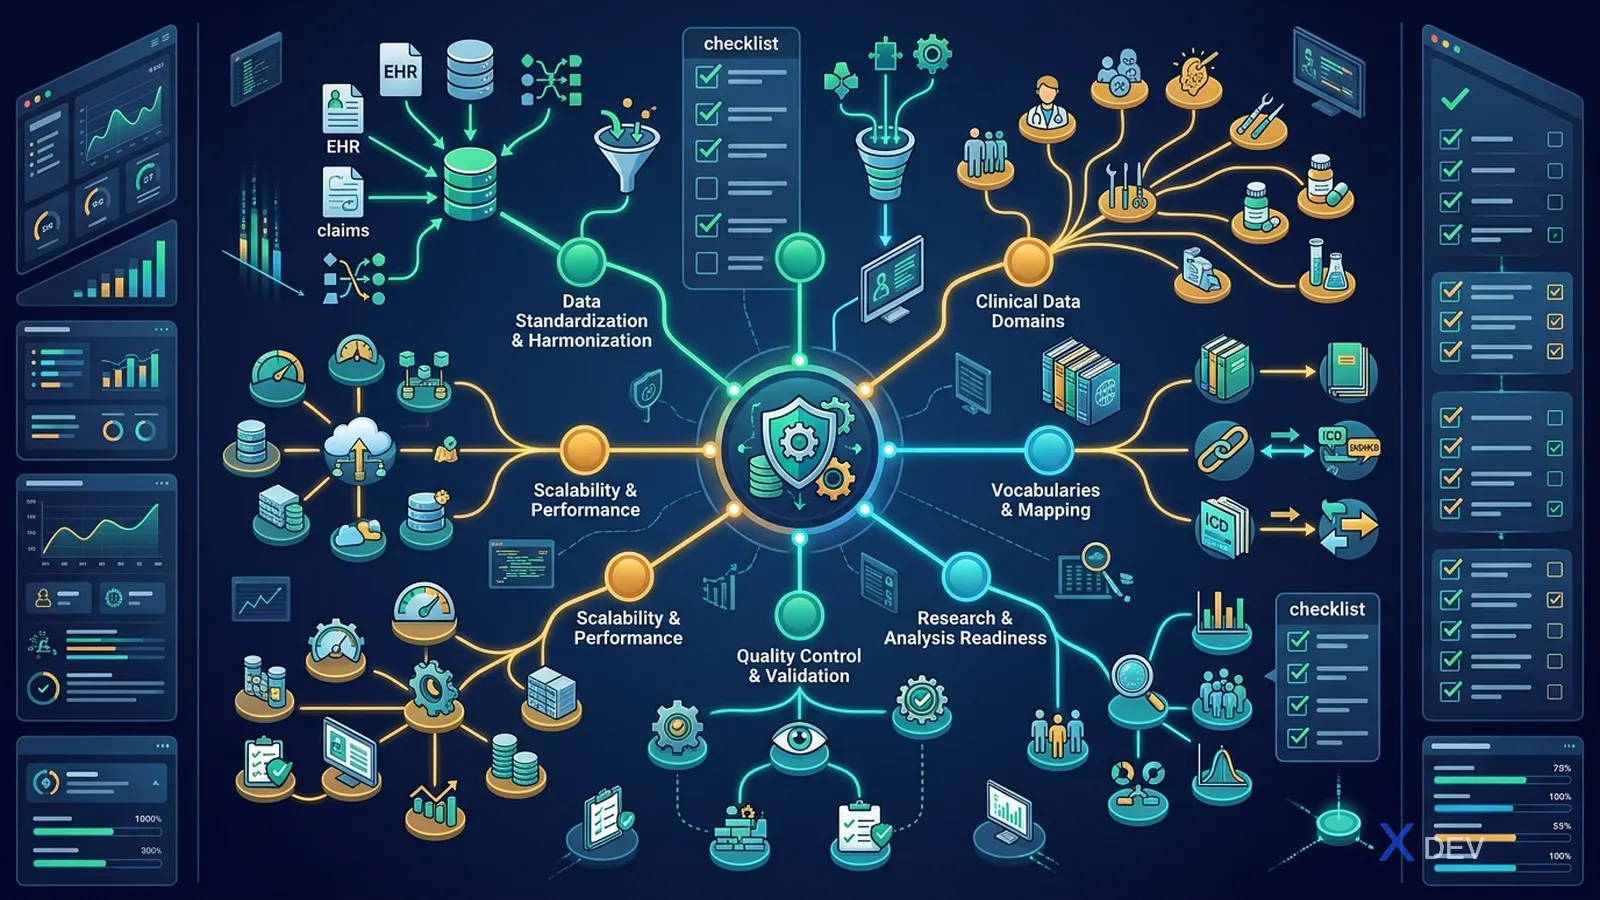
3. ATLAS
3.1 主な機能
3.2 コホート作成のワークフロー
例:「2026 年に新規診断され Metformin を開始した 2 型糖尿病患者」
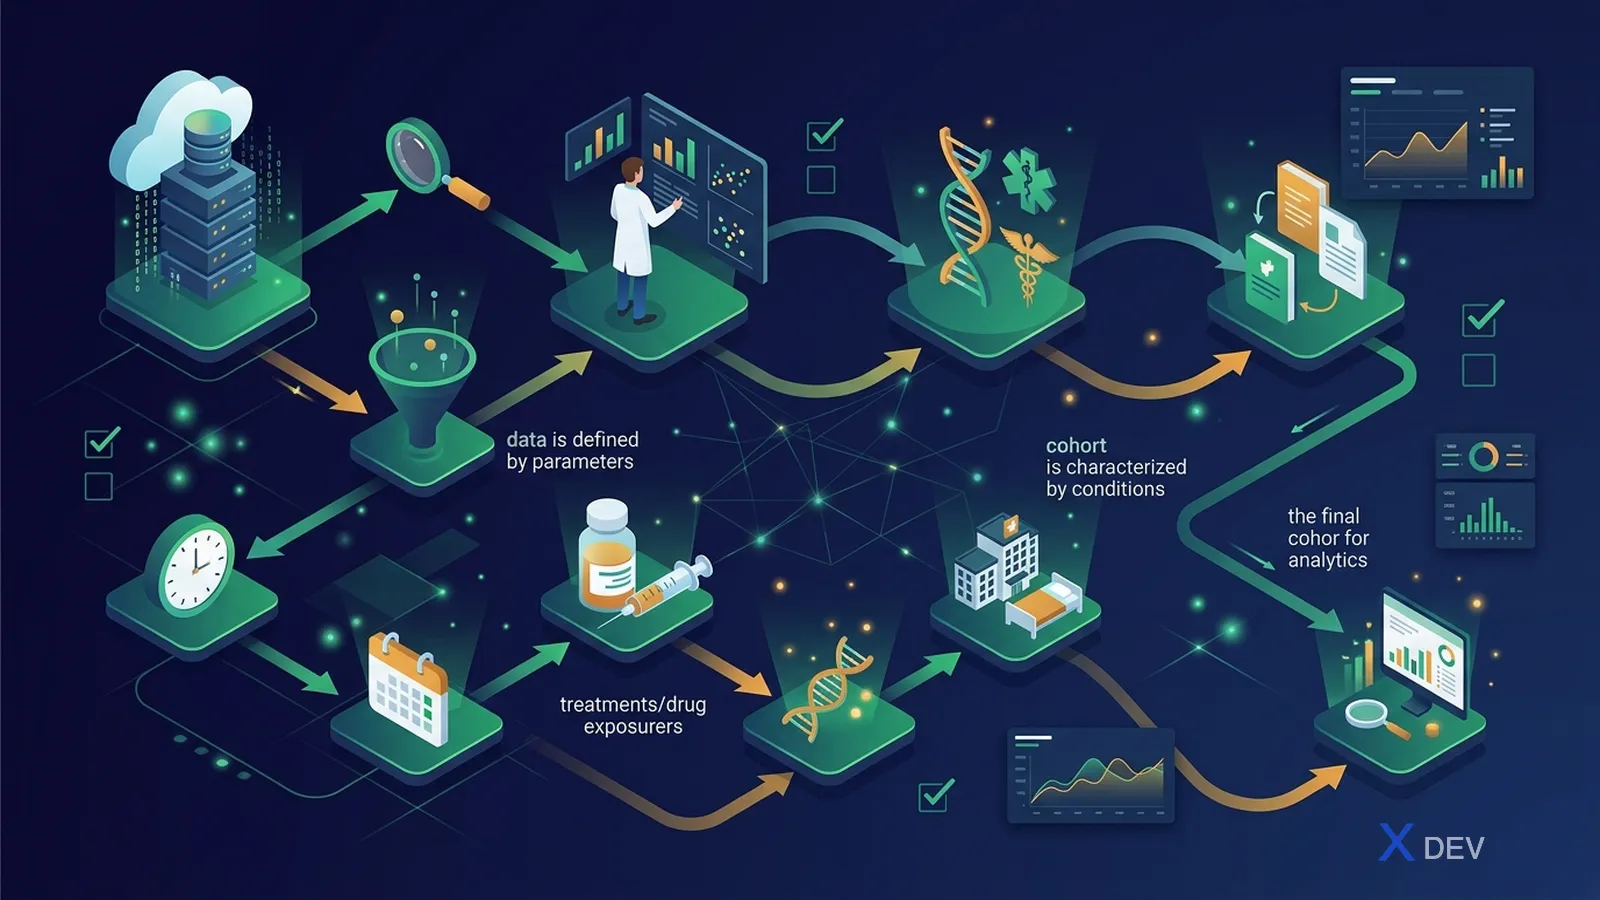
ATLAS の UI なら SQL なしのクリック&ドラッグで OK → 出力は OMOP 標準の cohort テーブル。
3.3 Cohort SQL のエクスポート
ATLAS は OHDSI Circe 標準の SQL を自動生成します:
-- Generated by Atlas
INSERT INTO cohort (cohort_definition_id, subject_id, cohort_start_date, cohort_end_date)
SELECT 1, person_id, condition_start_date, ...
FROM condition_occurrence co
JOIN concept_ancestor ca ON co.condition_concept_id = ca.descendant_concept_id
WHERE ca.ancestor_concept_id = 201826
  AND condition_start_date >= '2026-01-01'
  ...
→ バージョン管理可能、ATLAS 外で CLI 実行も可能。
3.4 Characterization
コホート作成後、Characterization を実行して以下を記述します:
- 性別 %、年齢層別
- 上位併存疾患(index 前 365 日内の上位 100 condition)
- 上位薬剤
- 上位処置
- 検査値
→ 表 + Forest plot を出力。2 つのコホートを比較するときに特に強力(例:Metformin vs SGLT2 first-line)。
4. ACHILLES
ACHILLES = R パッケージ、CDM の各カラムをプロファイリングし、約 170 の analysis ID を出力:
- Person 数、性別、人種、出生年分布
- タイプ別 visit 数
- 上位 condition、drug、procedure、measurement
- 時系列:月次カウント
- Heel:外れ値フラグ(例:「year_of_birth = 1850 detected」)
library(Achilles)
achilles(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = "cdm",
  resultsDatabaseSchema = "results",
  vocabDatabaseSchema = "cdm",
  numThreads = 4
)
実行後 → achilles_results、achilles_results_dist、achilles_heel_results テーブルが生成されます。
ATLAS には ACHILLES 結果を可視的に表示する「Data Sources」タブがあります — これは researcher にデータパートナーを紹介する案内ページになります。
5. Data Quality Dashboard (DQD)
3000+ ルールを Kahn の 3 グループに分類:
| 種類 | 説明 | 例 |
|---|---|---|
| Conformance | データの型、フォーマット、value set が正しい | gender_concept_id ∈ {0, 8507, 8532} |
| Completeness | 許容できる NULL 率 | < 5% person.year_of_birth NULL |
| Plausibility | 臨床的に妥当な値 | HbA1c が 20% を超えない |
5.1 DQD を実行
library(DataQualityDashboard)
executeDqChecks(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = "cdm",
  resultsDatabaseSchema = "results",
  cdmSourceName = "BV ABC OMOP CDM",
  outputFolder = "dqd_results",
  cdmVersion = "5.4"
)

# Viewer を生成
viewDqDashboard("dqd_results/results.json")
出力:
- インタラクティブ HTML ダッシュボード
- 各チェック + pass/fail/threshold の JSON
5.2 DQD の読み方
各チェックには次が含まれます:
category:conformance / completeness / plausibilitysubcategory:例 "valueLow"、"valueHigh"level:TABLE / FIELD / CONCEPTseverity:error / warning / notificationpct_records_violating:違反率threshold:許容しきい値pass/fail
5.3 対応パターン
DQD が fail したとき:
- チェックの説明を読む
- 根本原因を特定(ソースデータ不良 vs ETL 不良 vs しきい値が厳しすぎ)
- ETL を修正、または合理的な理由があればしきい値を上げる
- DQD を再実行
- ETL 仕様書に判断を記録
5.4 カスタムチェック
DQD は独自ルールの追加が可能です:
# custom_checks.csv
checkName: VN_BHYT_coverage
checkDescription: 90% 超の person が少なくとも 1 つの PAYER_PLAN_PERIOD = BHYT を持つ
queryText: |
  SELECT (1.0 - SUM(CASE WHEN p.person_id IS NOT NULL THEN 1 ELSE 0 END) / COUNT(*)) AS pct_violation
  FROM person ps
  LEFT JOIN payer_plan_period p ON ps.person_id = p.person_id
    AND p.payer_concept_id = 2000010001  -- ベトナム custom BHYT
threshold: 0.10
severity: warning
6. CI/CD への DQD 統合
# .github/workflows/dqd.yml
name: OMOP DQ Weekly
on:
  schedule:
    - cron: '0 3 * * 1'  # 月曜 3AM
jobs:
  dqd:
    runs-on: self-hosted
    steps:
      - uses: actions/checkout@v4
      - run: Rscript scripts/run_dqd.R
      - name: Upload result
        uses: actions/upload-artifact@v4
        with:
          name: dqd-${{ github.run_id }}
          path: dqd_results/
      - name: Fail on critical errors
        run: |
          jq '.Overview | select(.numFailed > 0)' dqd_results/results.json && exit 1 || exit 0
7. 実プロダクションスタック
| コンポーネント | 推奨スペック |
|---|---|
| Postgres CDM | 16 vCPU、64 GB RAM、2 TB SSD、年でパーティション |
| WebAPI | 4 vCPU、8 GB RAM、JVM heap 4GB |
| ATLAS Web | 2 vCPU、4 GB RAM(静的のみ) |
| ACHILLES | 8 vCPU、16 GB RAM、1000 万 person で 4〜12 時間 |
| DQD | 8 vCPU、16 GB RAM、ルールスコープにより 2〜6 時間 |
| HADES R Studio | PLP 学習用に 16 vCPU、32 GB RAM |
バックアップ:CDM は毎晩スナップショット、ACHILLES 結果は週次。
8. ATLAS のセキュリティ
ATLAS は標準では認証なし → カバーなしで公開しないこと。設定:
- WebAPI 経由で LDAP / AD 統合
- HTTPS をリバースプロキシ(NGINX)で
- すべてのコホート生成を監査ログ
- 機微データパートナー向けに row-level security
9. マルチテナントパターン
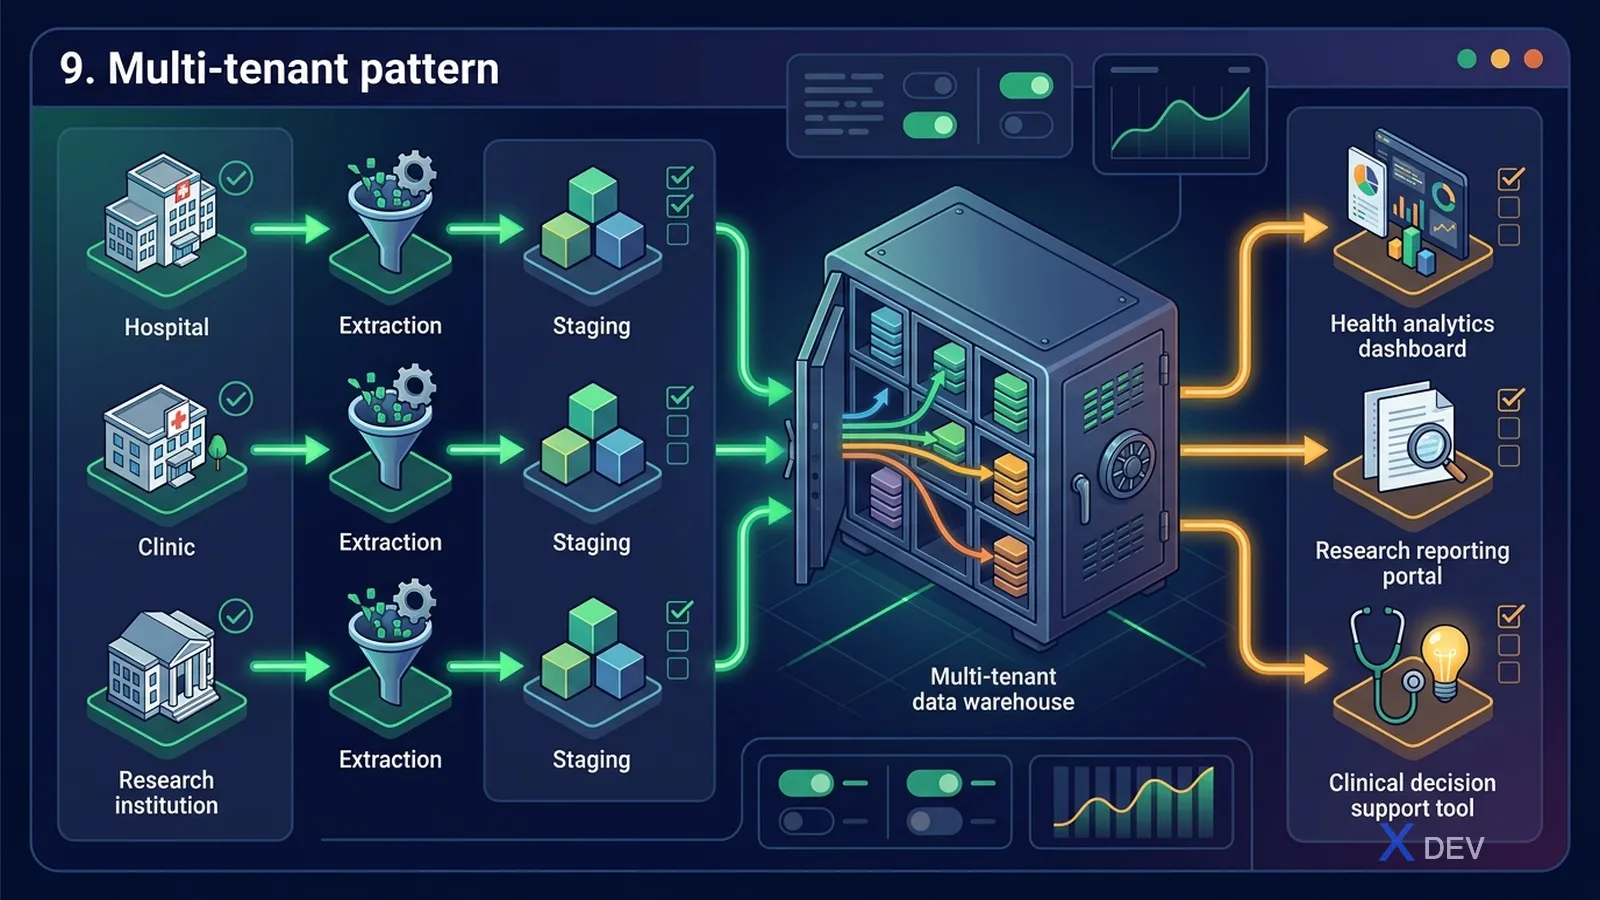
WebAPI はマルチソースをサポート — researcher はドロップダウンでソースを選択。ユーザー/ソースごとに権限。
10. ベトナム向けネットワーク展開
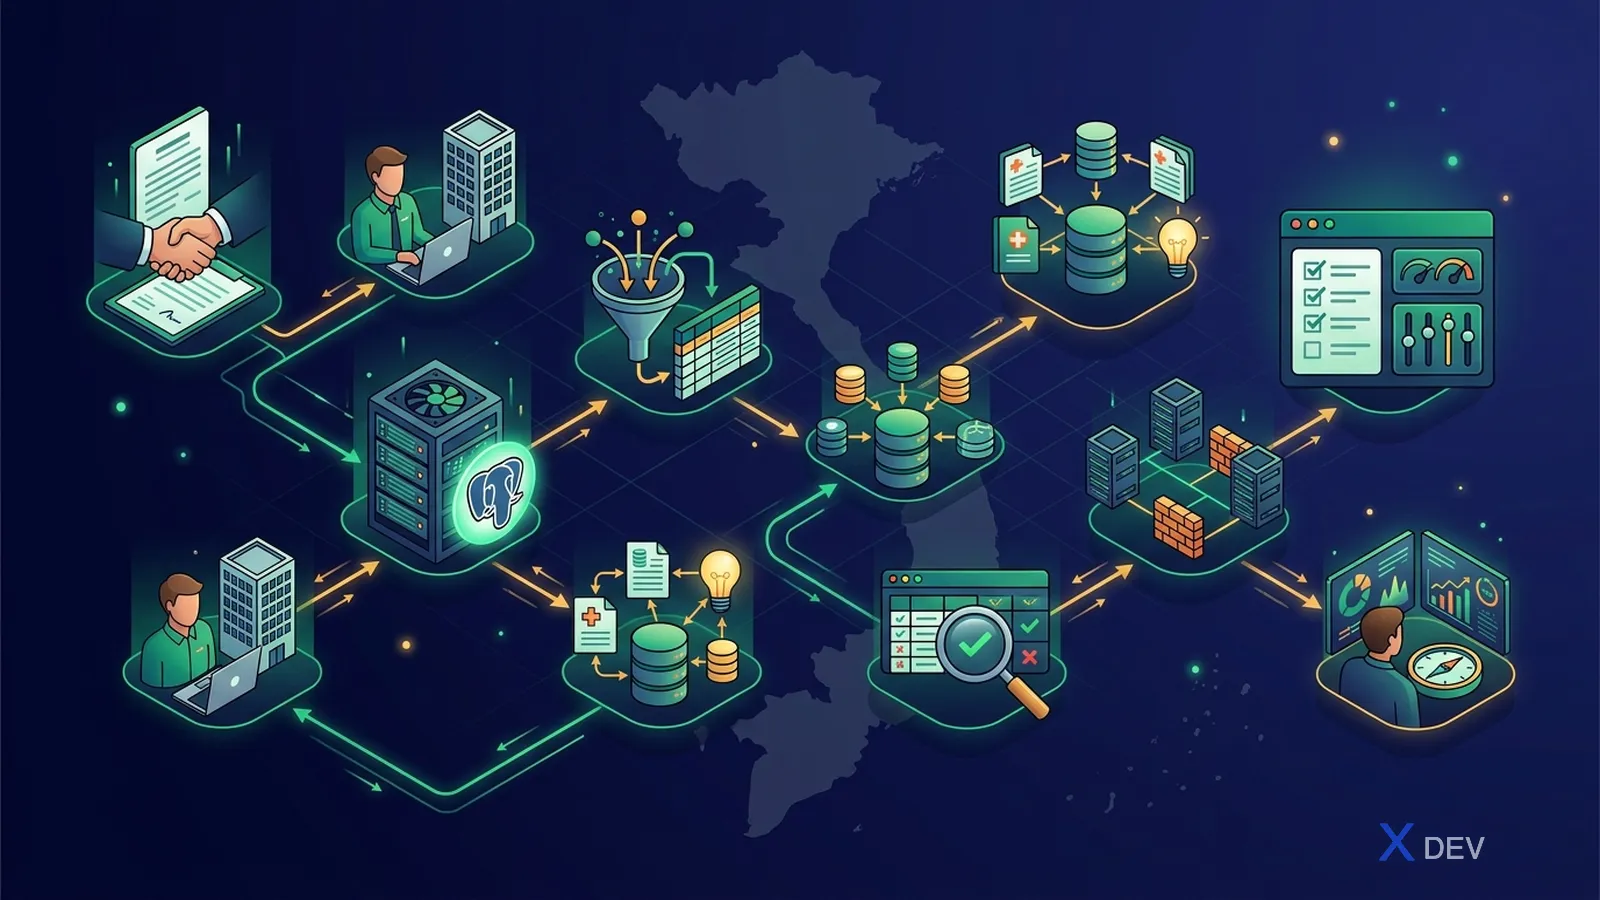
Federated パターン:データは病院に残し、集約結果のみ上に送る。
11. 落とし穴
- ❌ コホートで
concept_ancestorを使わない → 病態の亜型が漏れる - ❌ 包含ルールの重複をチェックせずコホート生成 → 二重カウント
- ❌ DQD 警告を無視 → 公開時にレビュアーから差し戻し
- ❌ ETL リフレッシュ後 ACHILLES を再実行しない → ATLAS が古い数値を表示
- ❌ ATLAS を認証なしで公開 → 患者メタデータ漏洩
- ❌
webapi.cohort_definitionをバックアップ忘れ → コホート定義の労力が消失
まとめ
ATLAS + DQD + ACHILLES は OMOP 運用の 3 本柱。Broadsea で 1 コマンドデプロイ可能。最初から CI/CD に DQ ゲートを組み込めば、研究公開時に大きく労力を節約できます。