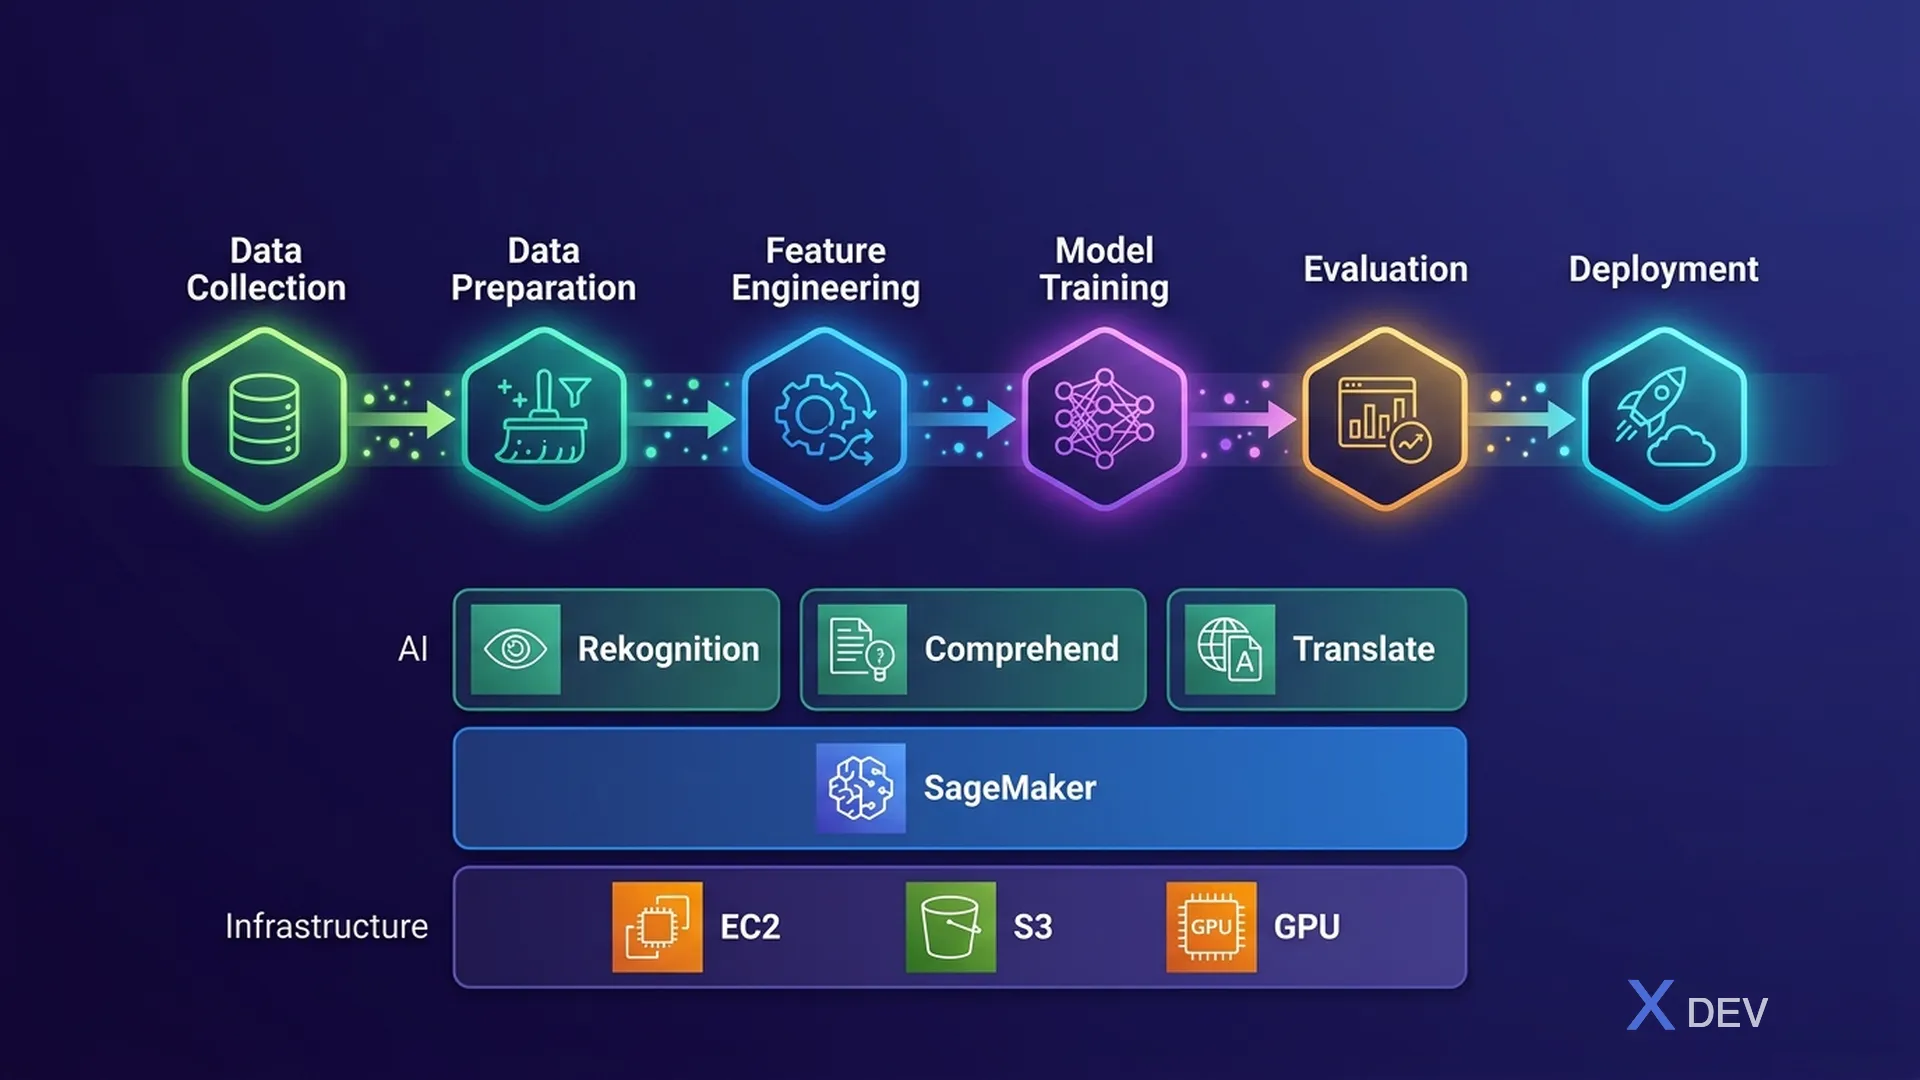
ML開発ライフサイクルパイプラインとAWS AI/MLサービススタック
1. ML開発ライフサイクル
AIF-C01試験では、問題定義からデプロイ・監視までのML開発ライフサイクル全体を理解する必要があります。
┌─────────────┐    ┌──────────────┐    ┌──────────────┐
│ 1. ビジネス  │───→│ 2. データ     │───→│ 3. 特徴量    │
│ 課題の定義   │    │ 収集と準備    │    │ エンジニア   │
│             │    │              │    │ リング       │
└─────────────┘    └──────────────┘    └──────────────┘
                                              │
┌─────────────┐    ┌──────────────┐    ┌──────┴───────┐
│ 6. 監視と    │←───│ 5. デプロイ   │←───│ 4. モデル    │
│ 再訓練       │    │ と推論       │    │ 訓練と評価   │
│             │    │              │    │              │
└─────────────┘    └──────────────┘    └──────────────┘
ステップ1:ビジネス課題の定義
- その問題が本当にMLを必要とするか判断(ルールベースのアプローチで十分な場合もある)
- 成功指標(KPI)を定義
- データの入手可能性を確認
試験のコツ:「すべての問題にMLが必要なわけではない」。問題文が単純な問題を説明している場合、ルールベースのアプローチやルックアップテーブルで十分かもしれません。
ステップ2:データ収集と準備
- データ収集:データベース、API、IoT、ログから収集
- データクレンジング:欠損値の処理、重複の除去、エラーの修正
- データラベリング:教師あり学習のためにデータにラベル付け → Amazon SageMaker Ground Truth
- 探索的データ分析(EDA):分布や相関関係の可視化と理解
ステップ3:特徴量エンジニアリング
- 特徴量選択:重要な特徴量を選択し、ノイズを除去
- 特徴量変換:正規化、スケーリング、エンコーディング
- 特徴量作成:生データから新しい特徴量を作成
- AWS:SageMaker Data Wrangler、SageMaker Feature Store
ステップ4:モデル訓練と評価
- 問題に適したアルゴリズムを選択
- データを訓練/検証/テストセットに分割
- モデルを訓練し、ハイパーパラメータを調整
- 適切な指標で評価(正解率、F1、RMSEなど)
- AWS:Amazon SageMaker(完全なMLワークフロー向け)
ステップ5:デプロイと推論
- リアルタイム推論:即時予測のためのエンドポイント
- バッチ推論:大量データをオフラインで処理
- エッジデプロイ:エッジデバイスでモデルを実行
- AWS:SageMaker Endpoints、Lambda、IoT Greengrass
ステップ6:監視と再訓練
- モデルドリフト:データの変化に伴い時間とともにパフォーマンスが低下
- データドリフト:入力データの分布が変化
- コンセプトドリフト:入力と出力の関係が変化
- 対策:監視 → ドリフトの検出 → 新しいデータで再訓練
- AWS:SageMaker Model Monitor
2. AWS AI/MLサービススタック
AWSは3層のAI/MLサービスを提供しています。高レベル(ML知識不要)から低レベル(フルコントロール)まで:
┌─────────────────────────────────────────────────────┐
│  レイヤー3:AIサービス(事前訓練済み、APIベース)        │
│  → Rekognition、Comprehend、Polly、Transcribe、      │
│    Translate、Textract、Lex、Personalize、Forecast    │
│  → ML専門知識不要                                    │
├─────────────────────────────────────────────────────┤
│  レイヤー2:MLサービス(マネージドプラットフォーム)      │
│  → Amazon SageMaker、SageMaker JumpStart             │
│  → Amazon Bedrock(GenAI)                           │
│  → ある程度のML専門知識が必要                          │
├─────────────────────────────────────────────────────┤
│  レイヤー1:MLフレームワークとインフラ                   │
│  → GPU/Inferentia搭載EC2、Deep Learning AMI、         │
│    Deep Learning Containers                          │
│  → 十分なML専門知識が必要                              │
└─────────────────────────────────────────────────────┘
3. AWS AIサービス — サマリーテーブル
このセクションは試験で非常に重要です。各サービスの機能と使用タイミングを知る必要があります。
3.1. コンピュータービジョン
| サービス | 機能 | ユースケース |
|---|---|---|
| Amazon Rekognition | 画像・動画の分析 | 顔検出、物体検出、コンテンツモデレーション、有名人認識、画像内テキスト(OCR) |
| Amazon Textract | 文書からテキストとデータを抽出 | 請求書処理、ID書類の抽出、フォームデータ、表の抽出 |
| Amazon Lookout for Vision | 製造向け外観検査 | 組立ラインでの製品欠陥検出 |
3.2. 自然言語処理(NLP)
| サービス | 機能 | ユースケース |
|---|---|---|
| Amazon Comprehend | NLP分析 | 感情分析、エンティティ抽出、キーフレーズ、言語検出、PII検出 |
| Amazon Translate | ニューラル機械翻訳 | リアルタイム翻訳、バッチ文書翻訳 |
| Amazon Kendra | インテリジェントエンタープライズ検索 | 社内ナレッジ検索、FAQ、NLPによる文書検索 |
3.3. 音声
| サービス | 機能 | 方向 |
|---|---|---|
| Amazon Polly | テキスト読み上げ(TTS) | テキスト → 音声 |
| Amazon Transcribe | 音声認識(STT) | 音声 → テキスト |
| Amazon Lex | 対話型AI(チャットボット) | 音声とテキストでチャットボットを構築(Alexaの基盤技術) |
試験のコツ:Polly = テキストから音声へ(Pollyが「話す」)。Transcribe = 音声からテキストへ(Transcribeが「書き起こす」)。
3.4. 予測とレコメンデーション
| サービス | 機能 | ユースケース |
|---|---|---|
| Amazon Personalize | リアルタイムのパーソナライゼーションとレコメンデーション | 商品レコメンデーション、パーソナライズコンテンツ |
| Amazon Forecast | 時系列予測 | 需要計画、財務予測、リソースプランニング |
| Amazon Fraud Detector | オンライン不正検出 | 決済不正、偽アカウント、アカウント乗っ取り |
4. Amazon SageMaker概要
SageMakerはフルマネージドMLプラットフォームです。MLライフサイクル全体に必要なすべてを提供します。
主要コンポーネント:
| コンポーネント | 目的 |
|---|---|
| SageMaker Studio | ML開発用IDE(Jupyterベース) |
| SageMaker Ground Truth | データラベリングサービス(人間 + ML支援) |
| SageMaker Data Wrangler | データ準備と変換(ノーコード) |
| SageMaker Feature Store | ML特徴量の保存と共有 |
| SageMaker Training | ビルトインアルゴリズムによるマネージド訓練ジョブ |
| SageMaker Autopilot | AutoML — 自動モデル構築 |
| SageMaker JumpStart | 事前訓練済みモデルとソリューション(モデルハブ) |
| SageMaker Endpoints | リアルタイム推論のためのモデルデプロイ |
| SageMaker Model Monitor | デプロイ済みモデルのドリフト監視 |
| SageMaker Clarify | バイアス検出とモデルの説明可能性 |
| SageMaker Canvas | ビジネスユーザー向けノーコードML |
SageMaker vs AIサービスの使い分け
カスタムMLモデルが必要? → SageMaker
事前訓練済みの機能が必要? → AIサービス(Rekognition、Comprehendなど)
GenAI/基盤モデルが必要? → Amazon Bedrock
ビジネスユーザー、ノーコード? → SageMaker Canvas
5. ユースケース → AWSサービスマッピング
これは試験で非常によく出題されるタイプの問題です:
| ユースケース | AWSサービス |
|---|---|
| 写真の顔を検出 | Amazon Rekognition |
| 請求書からデータを抽出 | Amazon Textract |
| カスタマーレビューの感情を分析 | Amazon Comprehend |
| コンテンツを複数言語に翻訳 | Amazon Translate |
| カスタマーサービスのチャットボットを構築 | Amazon Lex |
| ブログ記事を音声に変換 | Amazon Polly |
| 会議の録音を書き起こし | Amazon Transcribe |
| 商品レコメンデーション | Amazon Personalize |
| 需要予測 | Amazon Forecast |
| 社内文書を検索 | Amazon Kendra |
| 不正取引を検出 | Amazon Fraud Detector |
| 訓練データにラベルを付ける | SageMaker Ground Truth |
| カスタムMLモデルを構築 | Amazon SageMaker |
| ビジネスアナリスト向けノーコードML | SageMaker Canvas |
| LLMでテキストを生成 | Amazon Bedrock |
6. 練習問題
Q1:ある企業が、スキャンした請求書からテキストと構造化データを自動的に抽出したいと考えています。どのAWSサービスを使用すべきですか?
- A) Amazon Comprehend
- B) Amazon Rekognition
- C) Amazon Textract ✓
- D) Amazon Translate
解説:Textractはスキャンした文書からテキスト、フォーム、テーブルを抽出するために特別に設計されています。Comprehendはテキストの意味を分析するもので、文書の抽出ではありません。Rekognitionは画像/動画の分析用です。
Q2:データサイエンティストが、デプロイ済みモデルの予測精度がここ1ヶ月で低下していることに気づきました。入力データのパターンが変化しています。これは何と呼ばれますか?
- A) 過学習
- B) 未学習
- C) データドリフト ✓
- D) 特徴量エンジニアリング
解説:モデルの入力データの統計的特性が時間とともに変化し、パフォーマンスの低下を引き起こす場合、これをデータドリフトと呼びます。
Q3:ML経験のないビジネスアナリストが、ビジュアルインターフェースを使ってMLモデルを構築できるAWSサービスはどれですか?
- A) SageMaker Studio
- B) SageMaker Autopilot
- C) SageMaker Canvas ✓
- D) SageMaker JumpStart
解説:SageMaker Canvasはビジネスアナリスト向けのノーコード、ビジュアルポイント&クリックインターフェースを提供します。Autopilotはモデル構築を自動化しますが、ある程度のML知識が必要です。JumpStartは事前訓練済みモデルを提供します。Studioは完全なML IDEです。