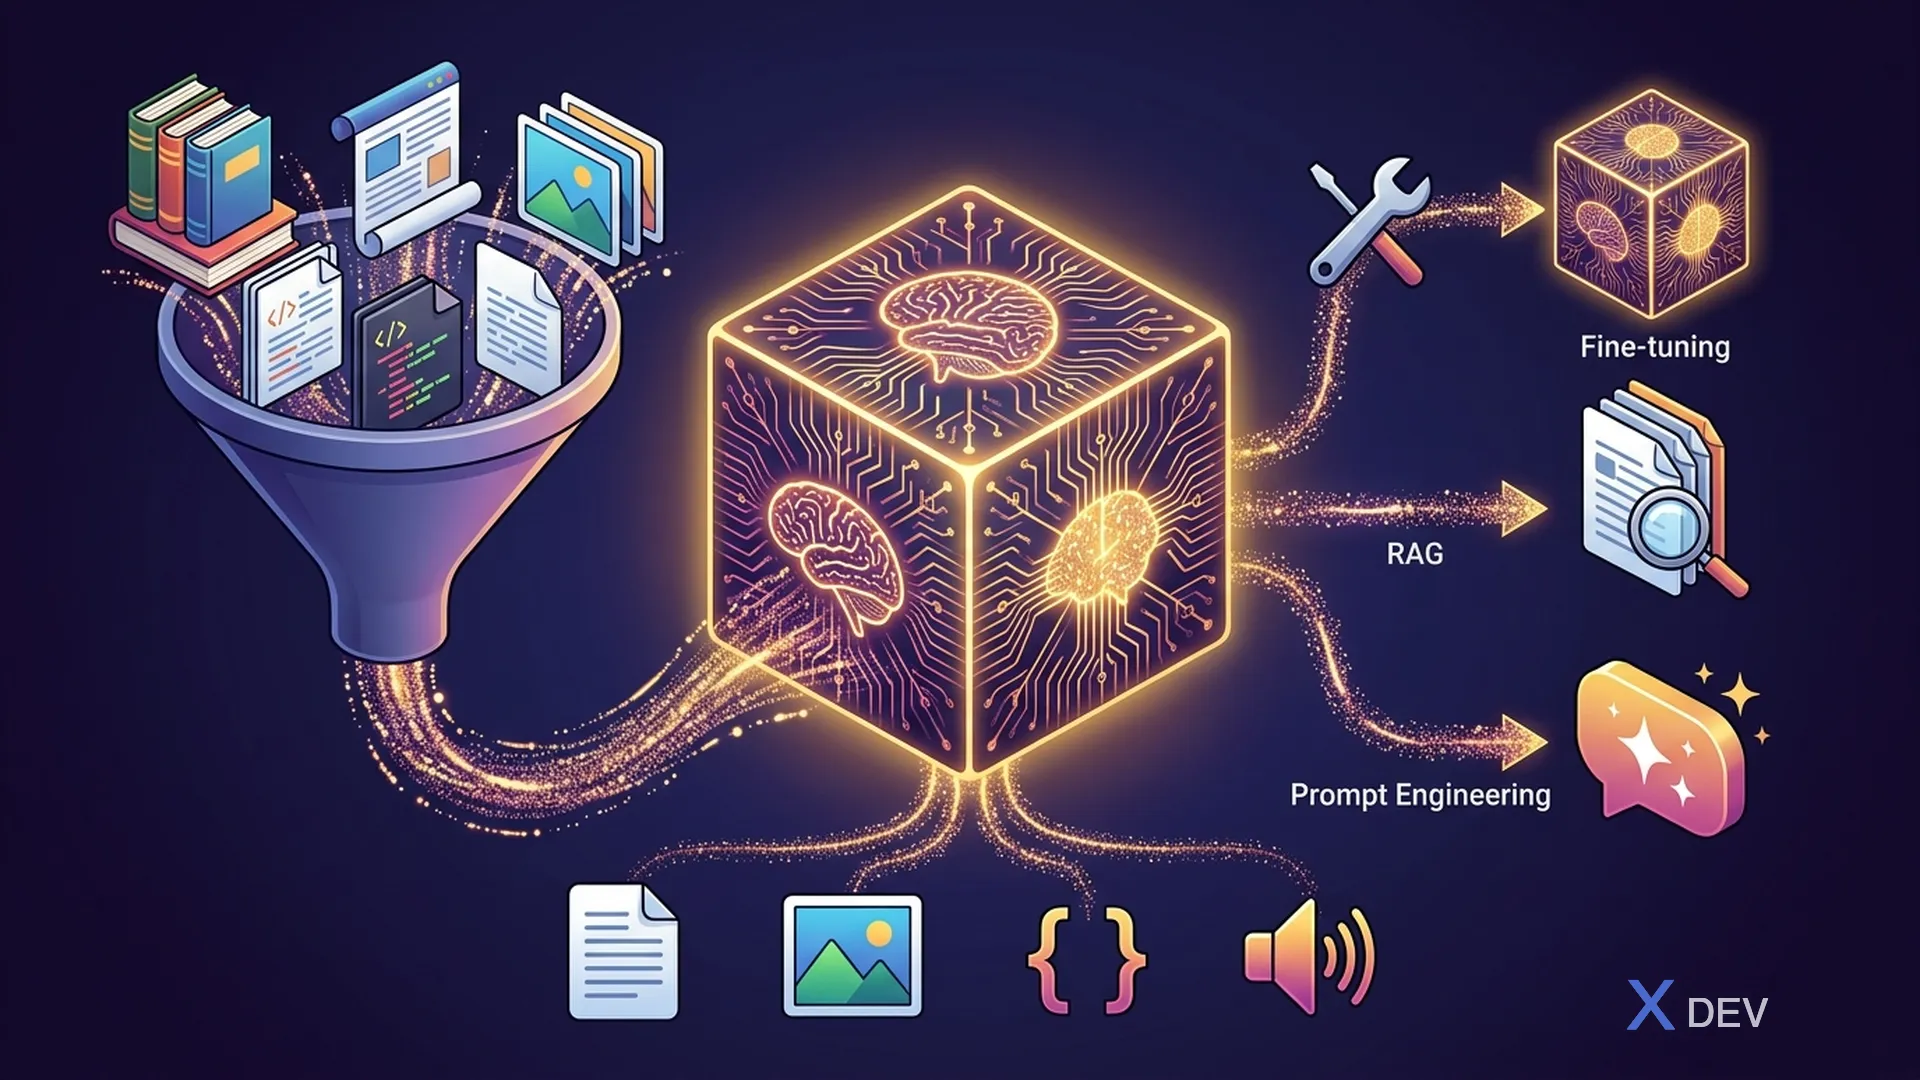
基盤モデルのライフサイクル — 事前学習、ファインチューニング、RAG、プロンプトエンジニアリング
ドメイン2の概要
ドメイン2は試験の24%を占め、2番目に大きなドメインです。生成AI、基盤モデル、そして従来のMLとの違いをしっかり理解する必要があります。
1. 生成AIとは?
生成AIとは、訓練データから学んだパターンに基づいて新しいコンテンツ(テキスト、画像、コード、音声、動画)を作成することに焦点を当てたAIの一分野です。
識別AIと生成AI
| 側面 | 識別AI | 生成AI |
|---|---|---|
| 機能 | 分類 / 予測 | 作成 / 生成 |
| 出力 | ラベル、カテゴリ、数値 | 新しいコンテンツ(テキスト、画像、コード) |
| 例 | 「このメールはスパムか?」→ はい/いいえ | 「~についてのメールを書いて」→ 新しいメール |
| モデル | ロジスティック回帰、SVM、CNN分類器 | GPT、Claude、Stable Diffusion、DALL-E |
生成AIのモダリティ
| 入力 → 出力 | 例 | モデル |
|---|---|---|
| テキスト → テキスト | チャットボット、要約、翻訳 | GPT-4、Claude、Llama |
| テキスト → 画像 | 説明文からの画像生成 | DALL-E、Stable Diffusion、Titan Image Generator |
| テキスト → コード | コード生成、デバッグ | CodeWhisperer、Copilot |
| テキスト → 音声 | 音声合成、音楽生成 | Amazon Polly(TTS) |
| 画像 → テキスト | 画像キャプション、ビジュアルQ&A | Claude(マルチモーダル)、GPT-4V |
| 音声 → テキスト | 書き起こし | Amazon Transcribe、Whisper |
2. 基盤モデル
基盤モデル(FM)とは、大規模なデータセットで事前訓練され、多くの異なる下流タスクに適応できる非常に大きなAIモデルです。
主な特徴
- 大規模な事前学習:数十億のデータポイント(インターネット上のテキスト、書籍、コード)で訓練
- 汎用性:タスク固有の訓練なしに複数のタスクを処理可能
- 適応性:特定のユースケースに対してファインチューニングやプロンプトで適応可能
- 訓練コストが高い:大量のコンピュート(GPU/TPUクラスター)が必要
- APIでアクセス:ユーザーは訓練不要 — API経由で利用(Amazon Bedrock)
基盤モデルのライフサイクル
┌─────────────────┐     ┌──────────────┐     ┌──────────────┐
│ 1. 事前学習      │────→│ 2. ファイン   │────→│ 3. 推論      │
│ (大量データ、    │     │ チューニング  │     │ (APIまたは   │
│  数十億パラメータ、│     │ (特定の      │     │  エンドポイント│
│  非常に高コスト) │     │  ドメインに   │     │  経由で利用)  │
│                 │     │  適応)       │     │              │
└─────────────────┘     └──────────────┘     └──────────────┘
   モデルプロバイダー        あなた/組織           ユーザー
 (Anthropic、Meta、                        (アプリケーション)
  Amazon など)
3. トークン化
トークン化とは、テキストをモデルが理解できる小さな単位(トークン)に分割するプロセスです。
Input:  "Machine learning is amazing!"
Tokens: ["Machine", " learning", " is", " amazing", "!"]
         token_1    token_2      token_3  token_4    token_5

または(サブワードトークン化):
Tokens: ["Mach", "ine", " learn", "ing", " is", " amaz", "ing", "!"]
試験の重要ポイント:
- トークン ≠ 単語:トークンは単語の一部、単語全体、または句読点になりうる
- コンテキストウィンドウ:モデルが一度に処理できる最大トークン数(入力 + 出力)
- トークン制限:モデルが「見る」ことができるテキスト量と生成可能な量を決定
- 料金:API呼び出しは通常トークン単位で課金(入力トークン + 出力トークン)
試験のコツ:コンテキストウィンドウのサイズは重要です。大きなコンテキスト = より長い文書を処理可能。ただし、コストが高くなり、速度が遅くなる可能性があります。
4. モデルパラメータと推論設定
4.1. モデルパラメータ(訓練中に学習)
- パラメータ = ニューラルネットワークの重みとバイアス
- GPT-4:約1.7兆パラメータ、Claude:非公開、Llama 3:8B/70B/405B
- パラメータが多い → 一般的により高性能だが、コストも高い
4.2. 推論パラメータ(ユーザーが設定)
モデルを呼び出す際に推論パラメータを調整できます:
| パラメータ | 範囲 | 制御する内容 |
|---|---|---|
| Temperature | 0.0 → 1.0+ | ランダム性/創造性。低 = 決定論的、集中。高 = 創造的、多様。 |
| Top-p(Nucleus) | 0.0 → 1.0 | 累積確率閾値。低い → より集中した語彙。 |
| Top-k | 1 → ∞ | 考慮する上位トークン数。低い → より予測可能。 |
| Max tokens | 1 → 上限 | 生成される出力の最大長。 |
| Stop sequences | 文字列 | モデルに生成を停止させるテキスト。 |
試験向けTemperatureガイド
Temperature = 0  →  最も決定論的(事実ベースのQ&A、コード、データ抽出)
Temperature = 0.3 → やや創造的(ビジネス文書、要約)
Temperature = 0.7 → 創造的(物語、ブレインストーミング、マーケティングコピー)
Temperature = 1.0+ → 非常にランダム(詩、創作 — ハルシネーションが増える可能性)
試験のコツ:「企業がカスタマーFAQに一貫した正確な回答を求めている」→ 低いTemperatureを使用。「企業が創造的なマーケティングスローガンを求めている」→ 高いTemperatureを使用。
5. ハルシネーション
ハルシネーションとは、モデルが自信に満ちているが不正確な出力を生成すること — 存在しない事実、引用、情報を捏造します。
原因:
- 訓練データの欠落や古い情報
- モデルは本当に事実を「知っている」わけではない — 可能性の高い次のトークンを予測
- 曖昧な、または自由度の高すぎるプロンプト
- 高いTemperature設定
対策:
| 戦略 | 効果 |
|---|---|
| RAG(検索拡張生成) | ナレッジベースの実際のデータで回答を根拠づける |
| 低いTemperature | 生成のランダム性を削減 |
| Guardrails | 出力のフィルタリング/検証(Amazon Bedrock Guardrails) |
| より良いプロンプト | 「提供されたコンテキストに基づいてのみ回答」/「不明な場合は分からないと回答」 |
| ファインチューニング | ドメイン固有の正確なデータでモデルを訓練 |
| 人間によるレビュー | Human-in-the-loopによる検証 |
6. AWS上の基盤モデル(Amazon Bedrock)
Amazon Bedrockは様々なプロバイダーの基盤モデルへのアクセスを提供します:
| プロバイダー | モデル | 強み |
|---|---|---|
| Anthropic | Claude 3(Haiku、Sonnet、Opus) | 推論力、安全性、長いコンテキスト |
| Meta | Llama 3 | オープンソース、多目的 |
| Amazon | Titan(Text、Embeddings、Image) | AWSネイティブ、RAG用エンベディング |
| Mistral AI | Mistral、Mixtral | 効率的、高速推論 |
| Stability AI | Stable Diffusion | 画像生成 |
| Cohere | Command、Embed | エンタープライズNLP、エンベディング |
| AI21 Labs | Jurassic | テキスト生成 |
7. 練習問題
Q1:従来のMLモデルと比較した場合、基盤モデルの主な利点は何ですか?
- A) より小さくて高速
- B) タスク固有の訓練なしに複数の下流タスクに適応できる ✓
- C) 不正確な出力を決して生成しない
- D) コンピュートリソースを必要としない
解説:基盤モデルは大規模なデータセットで事前訓練されており、プロンプトやファインチューニングを通じて多くの異なるタスクに適応できます。サイズは大きく、ハルシネーションの可能性があり、コンピュートは依然として必要です。
Q2:ある企業が生成AIモデルを使用しており、もっともらしいが事実と異なる情報を時々生成することに気づきました。この現象は何と呼ばれますか?
- A) 過学習
- B) データドリフト
- C) ハルシネーション ✓
- D) バイアス
解説:ハルシネーションとは、生成AIモデルが自信に満ちているが事実と異なる出力を生成する現象です。
Q3:開発者が、生成AIチャットボットに最小限の創造性で一貫した事実に基づく回答を提供させたいと考えています。どの推論パラメータを調整すべきですか?
- A) Max tokensを非常に高い値に設定
- B) Temperatureを0に近い値に設定 ✓
- C) Temperatureを1に近い値に設定
- D) Top-kの値を増やす
解説:低いTemperatureはモデルをより決定論的で集中的にし、応答のランダム性と創造性を削減します。