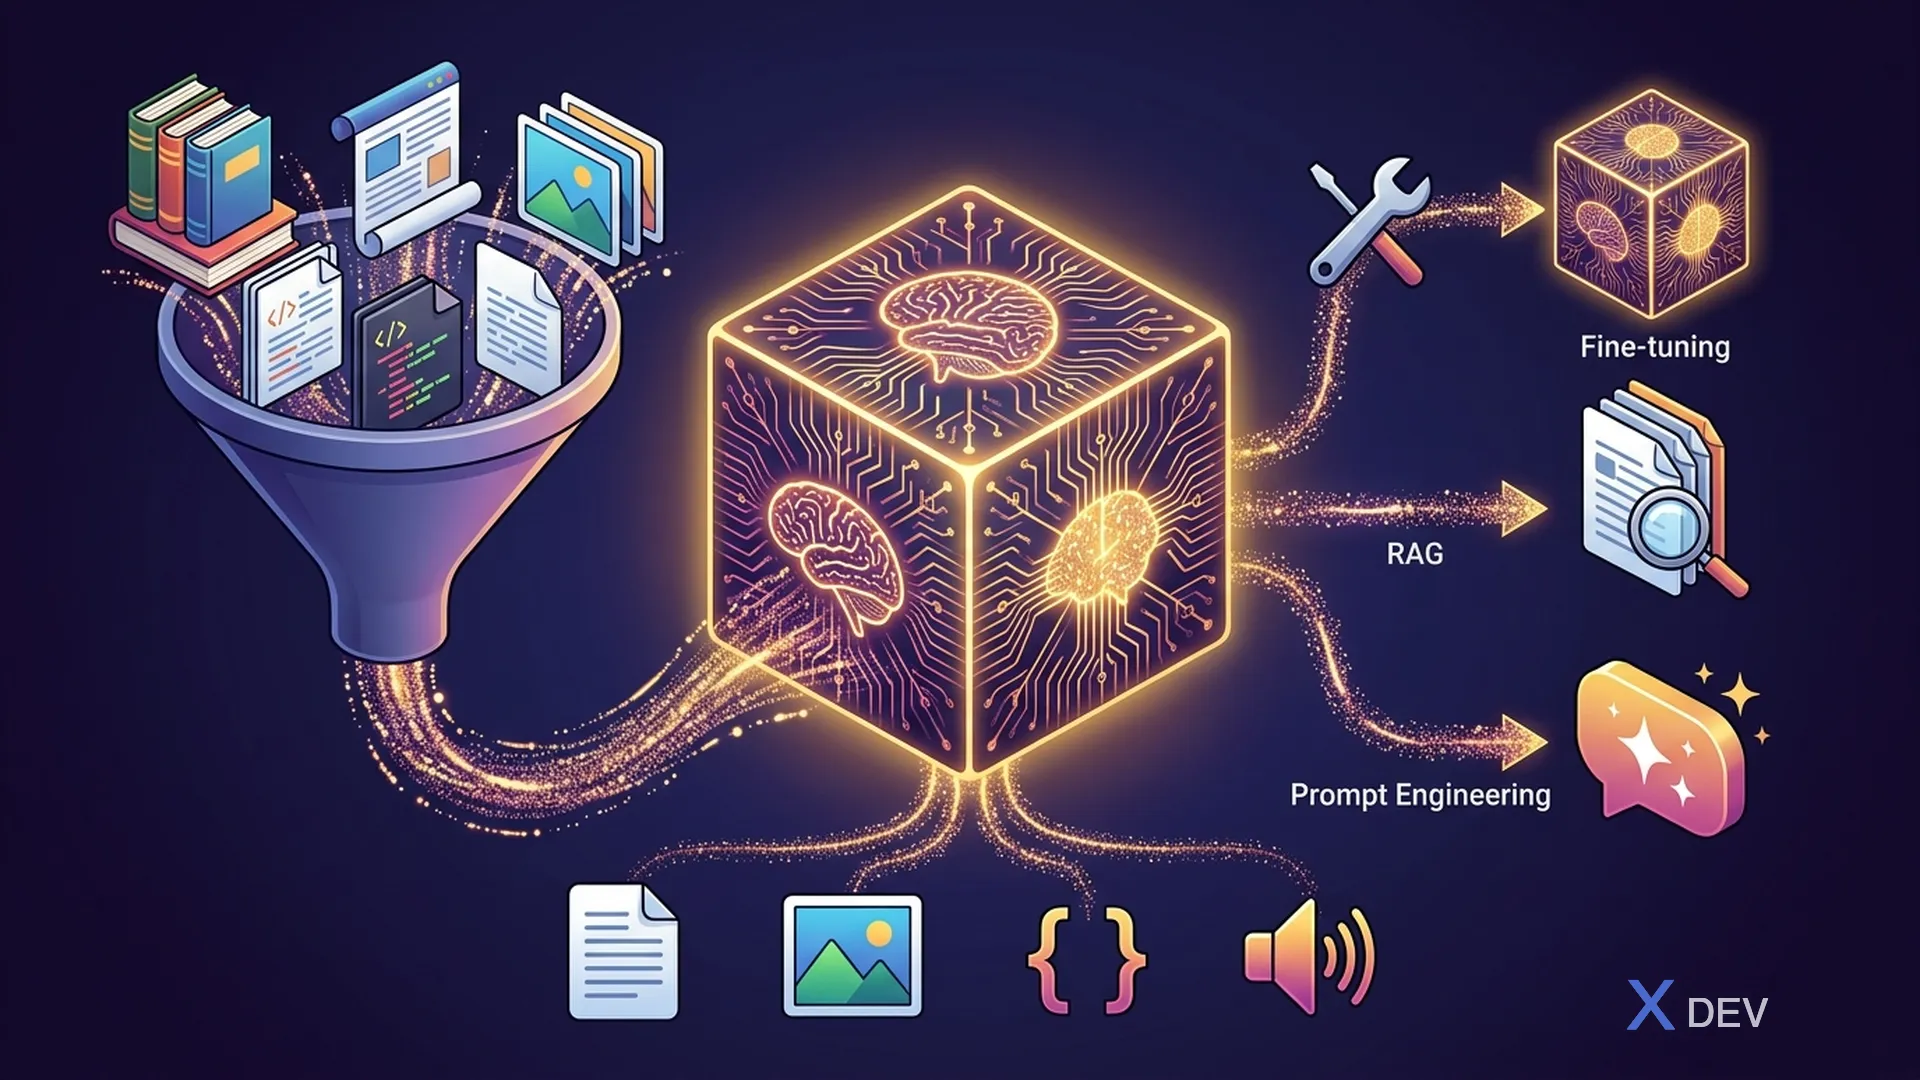
基礎模型生命週期 — 預訓練、微調、RAG和提示工程
領域2概覽
領域2佔考試的24% — 這是第二大領域。您需要對生成式AI、基礎模型以及它們與傳統ML的區別有扎實的理解。
1. 什麼是生成式AI?
生成式AI是AI的一個分支,專注於基於從訓練資料中學習的模式創建新內容(文字、圖像、程式碼、音訊、影片)。
判別式AI vs 生成式AI
| 面向 | 判別式AI | 生成式AI |
|---|---|---|
| 功能 | 分類/預測 | 創建/生成 |
| 輸出 | 標籤、類別、數值 | 新內容(文字、圖像、程式碼) |
| 範例 | 「這封郵件是垃圾郵件嗎?」→ 是/否 | 「寫一封關於...的郵件」→ 新郵件 |
| 模型 | 邏輯迴歸、SVM、CNN分類器 | GPT、Claude、Stable Diffusion、DALL-E |
生成式AI模態
| 輸入 → 輸出 | 範例 | 模型 |
|---|---|---|
| 文字 → 文字 | 聊天機器人、摘要、翻譯 | GPT-4、Claude、Llama |
| 文字 → 圖像 | 從描述生成圖像 | DALL-E、Stable Diffusion、Titan Image Generator |
| 文字 → 程式碼 | 程式碼生成、除錯 | CodeWhisperer、Copilot |
| 文字 → 音訊 | 語音合成、音樂生成 | Amazon Polly(TTS) |
| 圖像 → 文字 | 圖像描述、視覺問答 | Claude(多模態)、GPT-4V |
| 音訊 → 文字 | 轉錄 | Amazon Transcribe、Whisper |
2. 基礎模型
基礎模型(FM)是一種非常大的AI模型,已在大規模資料集上預訓練,可以適應許多不同的下游任務。
關鍵特性
- 大規模預訓練:在數十億資料點上訓練(互聯網文字、書籍、程式碼)
- 通用型:無需特定任務訓練即可處理多種任務
- 可適應:可通過微調或提示適應特定用例
- 訓練成本高:需要大規模運算(GPU/TPU集群)
- 通過API存取:用戶不需要訓練 — 通過API使用(Amazon Bedrock)
基礎模型生命週期
┌─────────────────┐     ┌──────────────┐     ┌──────────────┐
│ 1. 預訓練        │────→│ 2. 微調       │────→│ 3. 推論       │
│ (大規模資料、    │     │ (適應特定    │     │ (通過API或   │
│  數十億參數、     │     │  領域)       │     │  端點使用     │
│  非常昂貴)       │     │              │     │  模型)       │
└─────────────────┘     └──────────────┘     └──────────────┘
     模型提供者              您/組織              用戶
   (Anthropic、Meta、                      (應用程式)
    Amazon等)
3. 分詞
分詞是將文字分成模型可以理解的小單位(token)的過程。
輸入:  "Machine learning is amazing!"
Token:["Machine", " learning", " is", " amazing", "!"]
         token_1    token_2      token_3  token_4    token_5

或(子詞分詞):
Token:["Mach", "ine", " learn", "ing", " is", " amaz", "ing", "!"]
考試關鍵概念:
- Token ≠ 詞:一個token可以是詞的一部分、整個詞或標點符號
- 上下文視窗:模型一次可以處理的最大token數(輸入 + 輸出)
- Token限制:決定模型可以「看到」和生成多少文字
- 定價:API呼叫通常按token計價(輸入token + 輸出token)
考試提示:上下文視窗大小很重要。較大的上下文 = 可以處理更長的文件。但成本更高,可能更慢。
4. 模型參數與推論設定
4.1. 模型參數(訓練期間學習)
- 參數 = 神經網路中的權重和偏差
- GPT-4:約1.7兆參數,Claude:未公開,Llama 3:8B/70B/405B
- 更多參數 → 通常更強大,但成本更高
4.2. 推論參數(由用戶設定)
呼叫模型時,您可以調整推論參數:
| 參數 | 範圍 | 控制內容 |
|---|---|---|
| Temperature | 0.0 → 1.0+ | 隨機性/創造性。低 = 確定性、集中。高 = 創造性、多樣。 |
| Top-p(核採樣) | 0.0 → 1.0 | 累積機率閾值。較低 = 更集中的詞彙。 |
| Top-k | 1 → ∞ | 要考慮的前k個token。較低 = 更可預測。 |
| 最大token數 | 1 → 限制 | 生成輸出的最大長度。 |
| 停止序列 | 字串 | 告訴模型停止生成的文字。 |
考試Temperature指南
Temperature = 0  →  最確定性(事實問答、程式碼、資料擷取)
Temperature = 0.3 → 略有創造性(商業寫作、摘要)
Temperature = 0.7 → 有創造性(故事、腦力激盪、行銷文案)
Temperature = 1.0+ → 非常隨機(詩歌、創意寫作 — 可能更多幻覺)
考試提示:「一家公司需要一致、準確的客戶FAQ回答」→ 使用低temperature。「一家公司需要創意行銷口號」→ 使用高temperature。
5. 幻覺
幻覺是模型生成自信但不正確的輸出 — 捏造事實、引用或不存在的資訊。
原因:
- 訓練資料的缺口或過時資訊
- 模型並非真正「知道」事實 — 它預測可能的下一個token
- 模糊或太開放的提示
- 高temperature設定
緩解策略:
| 策略 | 如何幫助 |
|---|---|
| RAG(檢索增強生成) | 基於知識庫中的實際資料來回答 |
| 降低temperature | 減少生成的隨機性 |
| 護欄 | 過濾/驗證輸出(Amazon Bedrock Guardrails) |
| 更好的提示 | 「只根據提供的上下文回答」/「不確定就說不知道」 |
| 微調 | 用特定領域的準確資料訓練模型 |
| 人工審查 | 人機協作驗證 |
6. AWS上的基礎模型(Amazon Bedrock)
Amazon Bedrock提供來自多個供應商的多種基礎模型:
| 供應商 | 模型 | 優勢 |
|---|---|---|
| Anthropic | Claude 3(Haiku、Sonnet、Opus) | 推理、安全性、長上下文 |
| Meta | Llama 3 | 開源、多用途 |
| Amazon | Titan(Text、Embeddings、Image) | AWS原生、RAG用嵌入向量 |
| Mistral AI | Mistral、Mixtral | 高效、快速推論 |
| Stability AI | Stable Diffusion | 圖像生成 |
| Cohere | Command、Embed | 企業NLP、嵌入向量 |
| AI21 Labs | Jurassic | 文字生成 |
7. 練習題
Q1:與傳統ML模型相比,基礎模型的主要優勢是什麼?
- A) 它們更小更快
- B) 它們可以無需特定任務訓練即可適應多種下游任務 ✓
- C) 它們從不產生錯誤的輸出
- D) 它們不需要任何運算資源
解說:基礎模型在大規模資料集上預訓練,可以通過提示或微調適應多種不同任務。它們很大,可能會產生幻覺,仍然需要運算資源。
Q2:一家公司使用生成式AI模型,注意到它有時會生成看似合理但事實不正確的資訊。這種現象叫什麼?
- A) 過擬合
- B) 資料漂移
- C) 幻覺 ✓
- D) 偏差
解說:幻覺是指生成式AI模型產生自信但事實不正確的輸出。
Q3:一位開發人員想確保其生成式AI聊天機器人提供一致、事實性的回答,並盡量減少創造性。他們應該調整哪個推論參數?
- A) 將最大token數設得很高
- B) 將temperature設為接近0 ✓
- C) 將temperature設為接近1
- D) 增加top-k值
解說:低temperature使模型更確定性和集中,減少回答的創造性和隨機性。