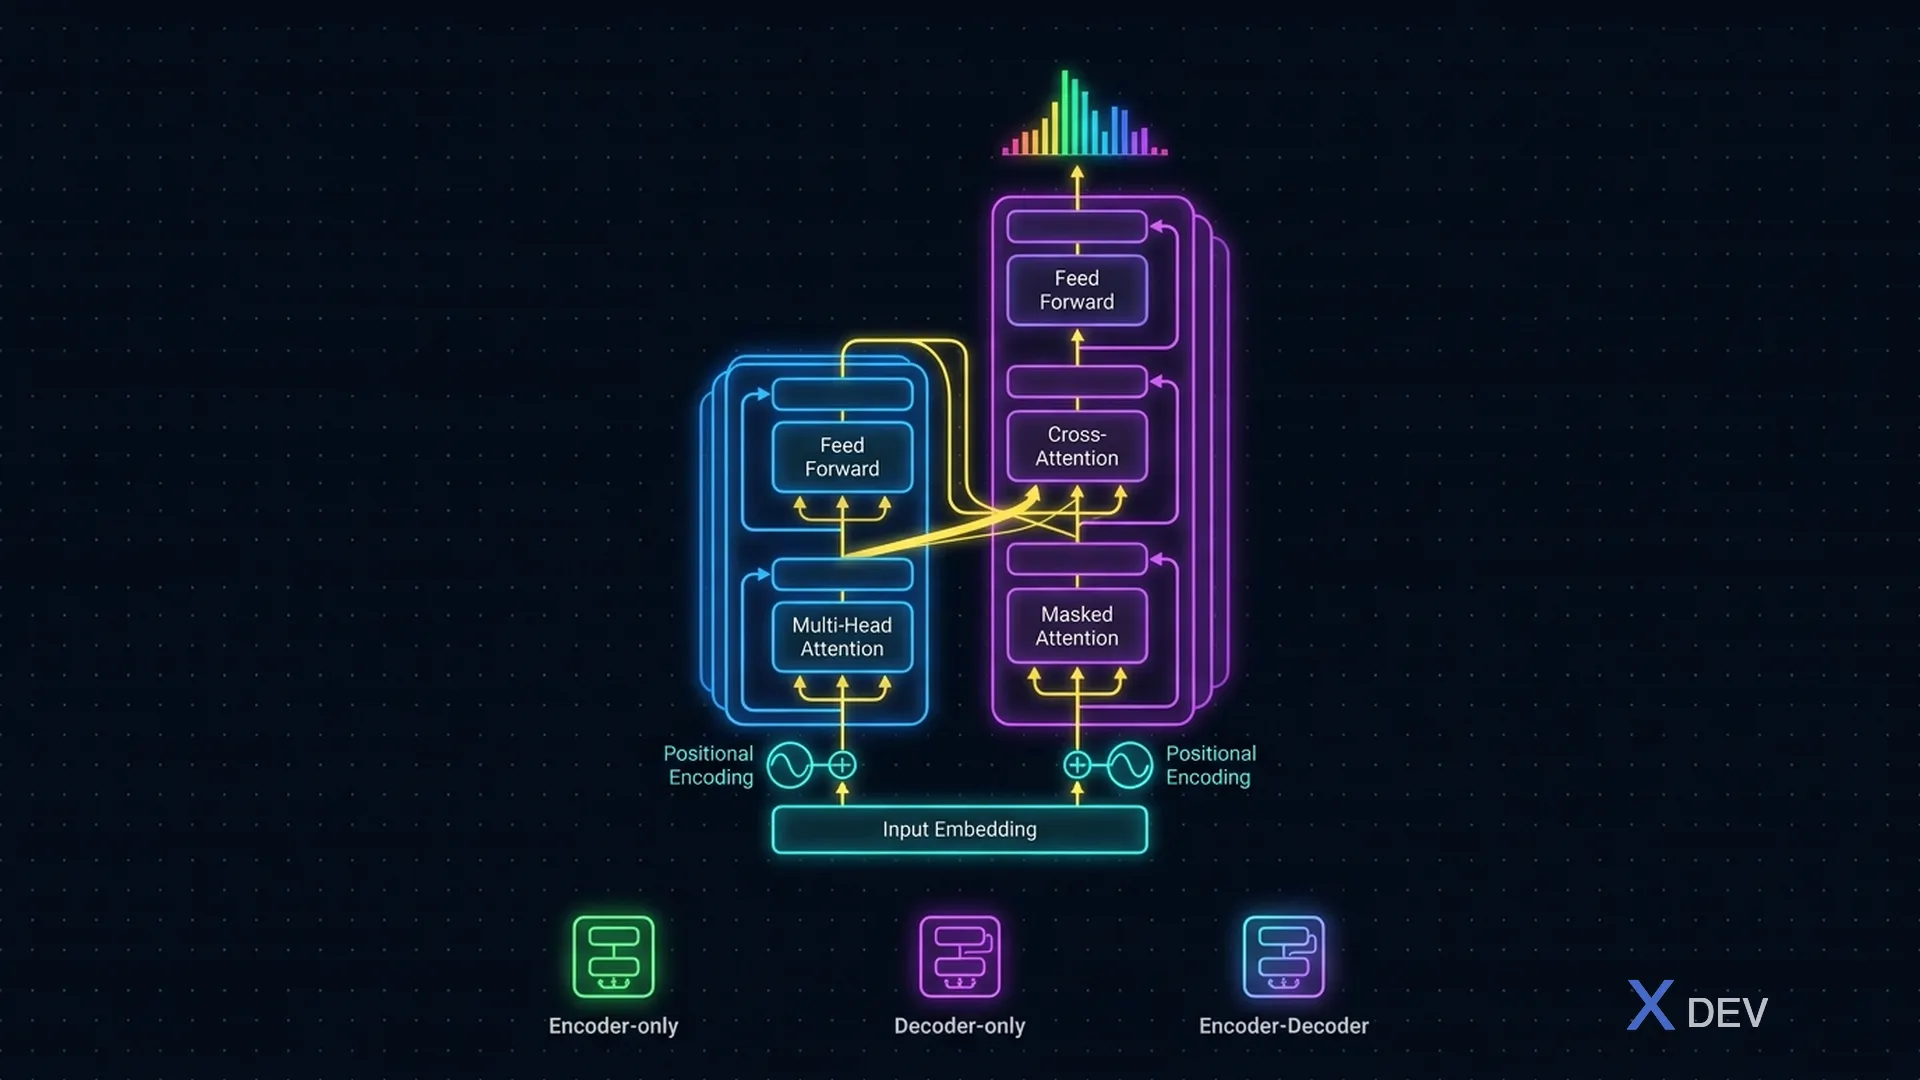
Transformerアーキテクチャ — エンコーダスタック、デコーダスタック、BERT/GPT/T5のバリアント
1. Transformerアーキテクチャ
TransformerはNLPに革命をもたらしたニューラルネットワークアーキテクチャで、2017年の論文「Attention Is All You Need」で発表されました。現在のほぼすべてのLLMはTransformerに基づいています。
1.1. Self-Attention機構
Self-Attentionにより、モデルは距離に関係なく、入力内のすべての単語間の関係を考慮できます。
Input: "The cat sat on the mat because it was tired"

Self-Attentionが答える:「it」は何を指すか?
→ 「cat」に注目(高いAttentionスコア)
→ 「mat」ではない(低いAttentionスコア)

従来のRNNではこのような長距離依存関係の処理が困難でした。
1.2. エンコーダ-デコーダアーキテクチャ
オリジナルのTransformer:
┌──────────────────────────┐
│        エンコーダ          │  ← 入力を理解
│  (Self-Attention +       │
│   Feed-Forward層)        │
├──────────────────────────┤
│        デコーダ            │  ← 出力を生成
│  (Masked Self-Attention +│
│   Cross-Attention +      │
│   Feed-Forward層)        │
└──────────────────────────┘
1.3. 3種類のTransformer
| 種類 | アーキテクチャ | 最適な用途 | モデル |
|---|---|---|---|
| エンコーダのみ | エンコーダ | テキスト理解(分類、NER、感情分析) | BERT、RoBERTa、DistilBERT |
| デコーダのみ | デコーダ | テキスト生成(チャットボット、コンテンツ作成) | GPT-4、Claude、Llama |
| エンコーダ-デコーダ | 両方 | 系列変換(翻訳、要約) | T5、BART |
試験のコツ:「テキスト生成に最適なアーキテクチャは?」→ デコーダのみ(GPT、Claude)。「テキスト分類に最適なアーキテクチャは?」→ エンコーダのみ(BERT)。
2. 大規模言語モデル(LLM)
LLMはテキスト専用の基盤モデルで、大規模なテキストコーパスで訓練され、人間の言語を理解し生成します。
2.1. LLMの能力
| 能力 | 説明 | 例 |
|---|---|---|
| テキスト生成 | 新しいテキストコンテンツを作成 | 記事、メール、物語 |
| 要約 | 長いテキストを凝縮 | 文書の要約 |
| 翻訳 | 言語間の変換 | 英語 → 日本語 |
| Q&A | 質問に回答 | カスタマーサポート、FAQ |
| コード生成 | コードの作成と説明 | Amazon Q Developer |
| テキスト分類 | テキストのカテゴリ分け | 感情分析 |
| 推論 | 論理的分析 | 数学問題、ステップバイステップの推論 |
2.2. LLMの制限
- 知識のカットオフ:訓練データのカットオフ日以降のイベントは知らない
- ハルシネーション:自信を持って誤った情報を生成する可能性
- コンテキストウィンドウの制限:無制限のテキストは処理できない
- リアルタイムデータなし:インターネットやライブデータにアクセス不可(拡張しない限り)
- 高コスト:大規模モデルは推論に大量のコンピュートが必要
- バイアス:訓練データのバイアスを反映する可能性
3. エンベディングとベクトル表現
エンベディングはテキスト(または画像、音声)を機械が理解できる数値ベクトルに変換します。意味が似たテキストは多次元空間で互いに近いベクトルを持ちます。
Text: "King"     → [0.23, 0.87, -0.12, 0.45, ...]
Text: "Queen"    → [0.21, 0.89, -0.15, 0.43, ...]  ← 近いベクトル!
Text: "Banana"   → [0.91, -0.32, 0.67, -0.88, ...] ← 遠い

関係: King - Man + Woman ≈ Queen
試験でエンベディングが重要な理由:
- セマンティック検索:意味に基づいて類似文書を検索(キーワードだけではなく)
- RAG:文書をエンベディングに変換、ベクトルDBに保存、関連コンテキストを取得
- クラスタリング:類似の文書/文をグループ化
- Amazon Titan Embeddings:テキストエンベディング作成専用のAWSモデル
ベクトルデータベース
エンベディングを効率的に保存・検索:
| ベクトルDB | 備考 |
|---|---|
| Amazon OpenSearch Serverless | AWSマネージドのベクトル検索 |
| Amazon Aurora(pgvector) | ベクトル拡張付きPostgreSQL |
| Pinecone | 人気のサードパーティベクトルDB |
| Amazon Bedrock Knowledge Bases | マネージドRAG — 内部でベクトルストレージを管理 |
4. マルチモーダルモデル
マルチモーダルモデルは複数のデータタイプ(テキスト + 画像 + 音声 + 動画)のコンテンツを処理・生成できます。
AWSでの例:
| モデル | モダリティ | できること |
|---|---|---|
| Claude 3(Anthropic) | テキスト + 画像入力 → テキスト出力 | 画像の説明、チャートの分析、ビジュアルQ&A |
| Amazon Titan Image Generator | テキスト → 画像 | テキストの説明から画像を生成 |
| Amazon Titan Multimodal Embeddings | テキスト + 画像 → ベクトル | テキストと画像の横断検索 |
| Stable Diffusion(Stability AI) | テキスト → 画像 | 画像の生成と編集 |
試験向けマルチモーダルのユースケース:
- 「商品画像を分析して説明文を生成」→ マルチモーダルモデル(Claude 3 Vision)
- 「テキストの説明から商品画像を生成」→ テキスト→画像(Titan Image Generator、Stable Diffusion)
- 「テキスト文書と画像の両方を横断的に検索」→ マルチモーダルエンベディング
5. 拡散モデル
拡散モデル(Stable Diffusionなど)の動作原理:
- 順方向プロセス:画像に徐々にノイズを追加し、純粋なノイズになるまで
- 逆方向プロセス:ステップごとにノイズを除去し、新しい画像を生成
訓練(順方向):
クリーンな画像 → ノイズ追加 → さらにノイズ追加 → ... → 純粋なノイズ

生成(逆方向):
純粋なノイズ → ノイズ除去 → さらにノイズ除去 → ... → 新しい画像
                           (テキストプロンプトによるガイド)
試験のコツ:詳細な数学は知る必要ありません。概念を理解してください:拡散モデルはテキストプロンプトに導かれて徐々にノイズを除去することで画像を生成します。
6. 事前学習 vs ファインチューニング vs プロンプティング
| 手法 | 内容 | 必要なデータ | コスト | 使用タイミング |
|---|---|---|---|---|
| 事前学習 | ゼロから訓練 | 数十億の例 | $$$$ | 新しいFMの作成(プロバイダーが実施) |
| ファインチューニング | 既存FMの追加訓練 | 数千の例 | $$ | ドメイン固有の知識 |
| プロンプトエンジニアリング | より良い入力の作成 | なし(少数の例) | $ | 迅速な適応、訓練不要 |
| RAG | 外部データで拡張 | ナレッジベース | $ | 最新/独自データへのアクセス |
試験向け決定木:
モデルに特定のドメイン知識が必要?
├── 知識は提供可能な文書にある?
│   └── はい → RAG(Bedrock Knowledge Bases)
│   └── いいえ、モデルがパターンを学習する必要がある →
│       ├── 数千の訓練例がある? → ファインチューニング
│       └── 少数の例のみ? → Few-shotプロンプティング
├── 一般知識で十分? → プロンプトエンジニアリング(Zero-shot/Few-shot)
7. 練習問題
Q1:ある企業が、商品画像とテキストの説明の両方にわたって関連情報を検索したいと考えています。最も適切なモデルの種類はどれですか?
- A) テキストのみのLLM
- B) マルチモーダルエンベディングモデル ✓
- C) 拡散モデル
- D) RNNモデル
解説:マルチモーダルエンベディングモデルは、テキストと画像の両方を同じベクトル空間でベクトル表現に変換し、クロスモーダル検索を可能にします。
Q2:チャットボットやコンテンツ作成などのテキスト生成タスクに最も適したTransformerアーキテクチャはどれですか?
- A) エンコーダのみ(BERT)
- B) デコーダのみ(GPT、Claude) ✓
- C) エンコーダ-デコーダ(T5)
- D) 畳み込みニューラルネットワーク(CNN)
解説:デコーダのみのアーキテクチャはトークンを1つずつ生成(自己回帰)し、現代のほとんどのチャットボットやテキストジェネレーターの基盤となっています。
Q3:生成AIアプリケーションにおけるテキストエンベディングの目的は何ですか?
- A) ストレージ用にファイルを圧縮する
- B) テキストを意味を捉えた数値ベクトルに変換する ✓
- C) セキュリティのためにテキストを暗号化する
- D) 言語間でテキストを翻訳する
解説:エンベディングは意味を捉えたテキストの数値ベクトル表現です。類似したテキストは類似したベクトルを持ち、セマンティック検索、RAG、クラスタリングを可能にします。