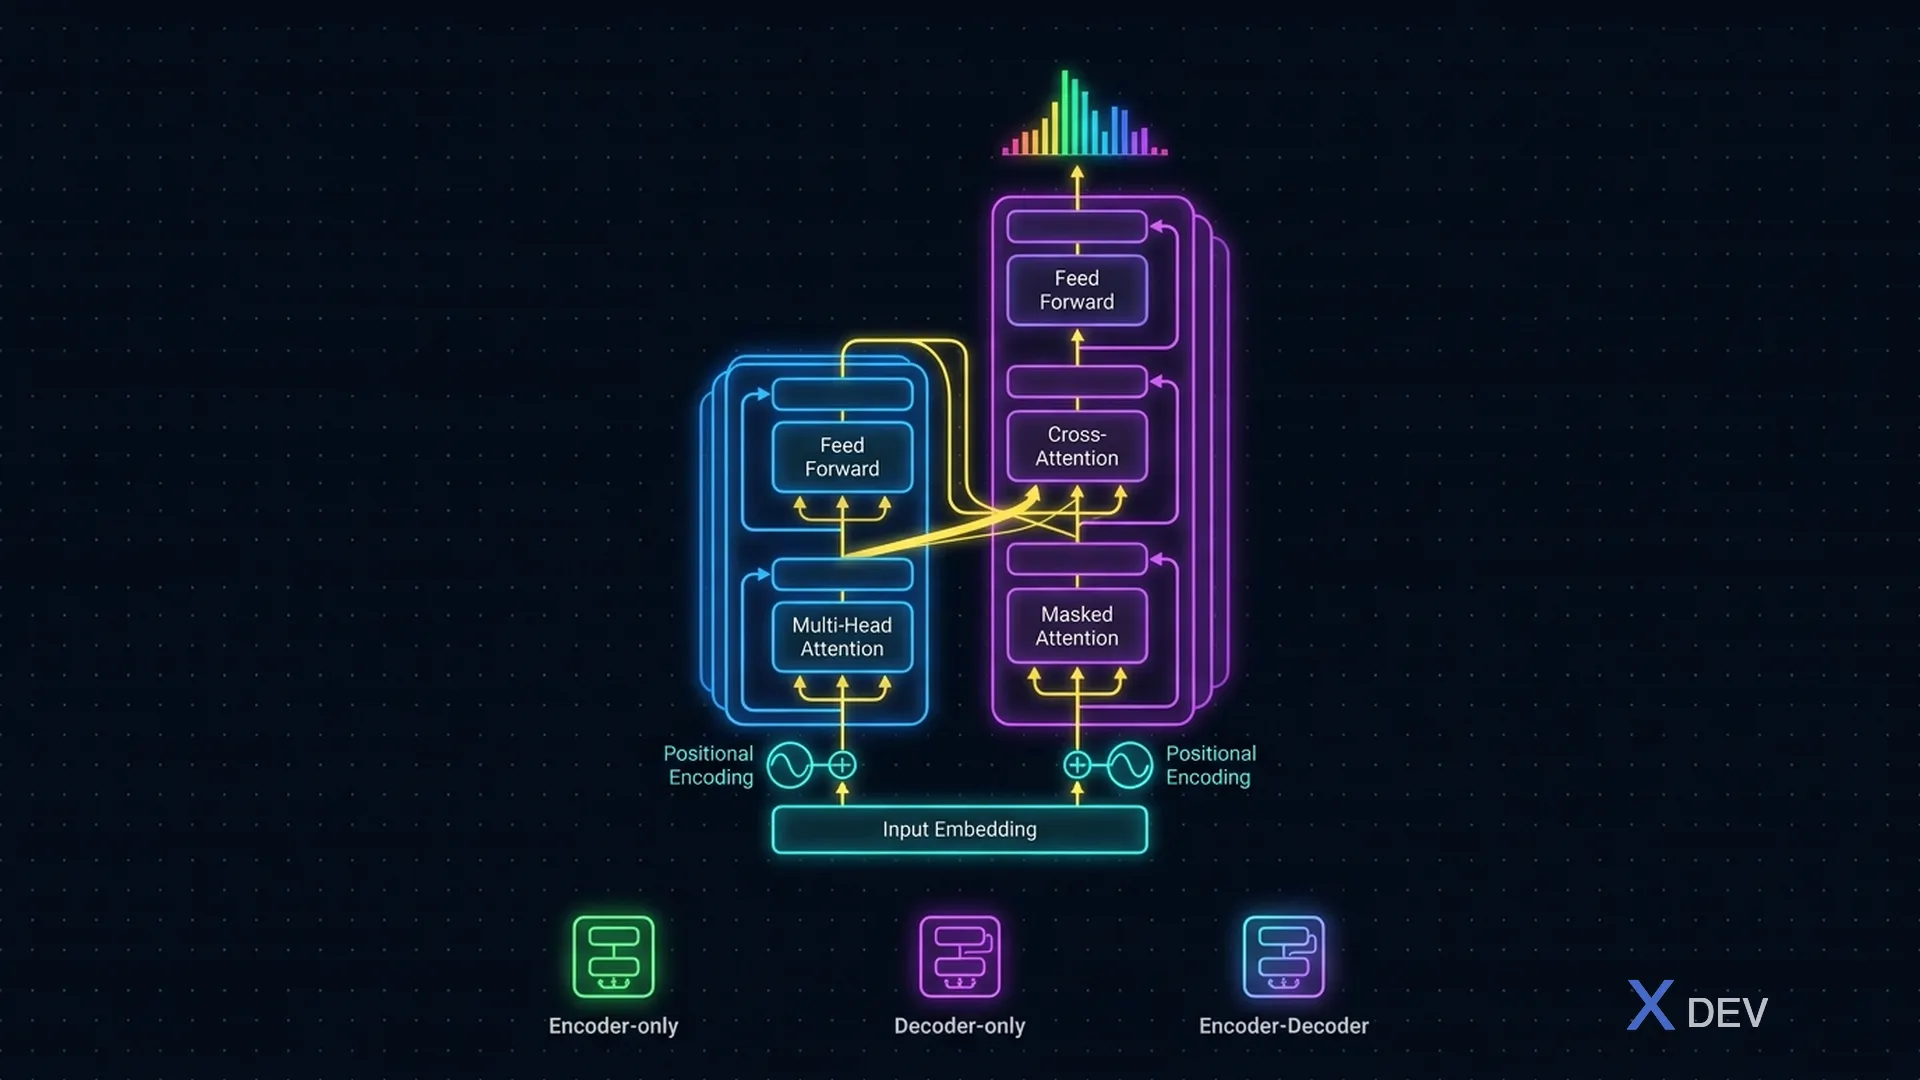
Transformer架構 — 編碼器堆疊、解碼器堆疊,以及BERT/GPT/T5變體
1. Transformer架構
Transformer是一種革新了NLP的神經網路架構,在2017年的論文「Attention Is All You Need」中提出。幾乎所有當前的LLM都基於Transformer。
1.1. 自注意力機制
自注意力允許模型考慮輸入中所有詞之間的關係,無論距離遠近。
輸入:"The cat sat on the mat because it was tired"

自注意力回答:"it"指的是什麼?
→ 注意力集中在"cat"(高注意力分數)
→ 不是"mat"(低注意力分數)

傳統RNN在這種長距離依賴關係上會遇到困難。
1.2. 編碼器-解碼器架構
原始Transformer:
┌──────────────────────────┐
│        編碼器             │  ← 理解輸入
│  (自注意力 +             │
│   前饋層)                │
├──────────────────────────┤
│        解碼器             │  ← 生成輸出
│  (遮罩自注意力 +         │
│   交叉注意力 +            │
│   前饋層)                │
└──────────────────────────┘
1.3. 三種Transformer類型
| 類型 | 架構 | 最適用於 | 模型 |
|---|---|---|---|
| 僅編碼器 | 編碼器 | 理解文字(分類、NER、情緒分析) | BERT、RoBERTa、DistilBERT |
| 僅解碼器 | 解碼器 | 生成文字(聊天機器人、內容創建) | GPT-4、Claude、Llama |
| 編碼器-解碼器 | 兩者 | 序列到序列(翻譯、摘要) | T5、BART |
考試提示:「哪種架構最適合文字生成?」→ 僅解碼器(GPT、Claude)。「哪種架構最適合文字分類?」→ 僅編碼器(BERT)。
2. 大型語言模型(LLM)
LLM是專門用於文字的基礎模型 — 在大規模文字語料庫上訓練,以理解和生成人類語言。
2.1. LLM能力
| 能力 | 描述 | 範例 |
|---|---|---|
| 文字生成 | 創建新的文字內容 | 文章、郵件、故事 |
| 摘要 | 濃縮長篇文字 | 文件摘要 |
| 翻譯 | 在語言之間轉換 | 英文 → 中文 |
| 問答 | 回答問題 | 客戶支援、FAQ |
| 程式碼生成 | 編寫和解釋程式碼 | Amazon Q Developer |
| 文字分類 | 分類文字 | 情緒分析 |
| 推理 | 邏輯分析 | 數學問題、逐步推理 |
2.2. LLM限制
- 知識截止日期:不知道訓練資料截止日期後的事件
- 幻覺:可以自信地生成虛假資訊
- 上下文視窗限制:無法處理無限文字
- 無即時資料:無法存取網路或即時資料(除非增強)
- 成本高:大型模型推論需要大量運算
- 偏差:可能反映訓練資料中的偏差
3. 嵌入向量與向量表示
嵌入向量將文字(或圖像、音訊)轉換為機器可以理解的數值向量。含義相似的文字在多維空間中會有接近的向量。
文字:"King"     → [0.23, 0.87, -0.12, 0.45, ...]
文字:"Queen"    → [0.21, 0.89, -0.15, 0.43, ...]  ← 接近的向量!
文字:"Banana"   → [0.91, -0.32, 0.67, -0.88, ...] ← 距離很遠

關係:King - Man + Woman ≈ Queen
考試中嵌入向量的重要性:
- 語意搜尋:基於含義(而非僅關鍵字)找到相似的文件
- RAG:將文件轉為嵌入向量,存入向量資料庫,檢索相關上下文
- 聚類:將相似的文件/句子分組
- Amazon Titan Embeddings:專門用於創建文字嵌入向量的AWS模型
向量資料庫
高效儲存和搜尋嵌入向量:
| 向量資料庫 | 備註 |
|---|---|
| Amazon OpenSearch Serverless | AWS受管向量搜尋 |
| Amazon Aurora(pgvector) | 帶向量擴展的PostgreSQL |
| Pinecone | 流行的第三方向量資料庫 |
| Amazon Bedrock Knowledge Bases | 受管RAG — 內部處理向量儲存 |
4. 多模態模型
多模態模型可以處理和生成多種資料類型(文字 + 圖像 + 音訊 + 影片)的內容。
AWS上的範例:
| 模型 | 模態 | 功能 |
|---|---|---|
| Claude 3(Anthropic) | 文字 + 圖像輸入 → 文字輸出 | 描述圖像、分析圖表、視覺問答 |
| Amazon Titan Image Generator | 文字 → 圖像 | 從文字描述創建圖像 |
| Amazon Titan Multimodal Embeddings | 文字 + 圖像 → 向量 | 跨文字和圖像搜尋 |
| Stable Diffusion(Stability AI) | 文字 → 圖像 | 生成和編輯圖像 |
考試中的多模態使用案例:
- 「分析產品圖像並生成描述」→ 多模態模型(Claude 3 Vision)
- 「從文字描述生成產品圖像」→ 文字轉圖像(Titan Image Generator、Stable Diffusion)
- 「跨文字文件和圖像搜尋」→ 多模態嵌入向量
5. 擴散模型
擴散模型(如Stable Diffusion)的工作原理:
- 正向過程:逐步向圖像添加雜訊直到變成純雜訊
- 反向過程:學習逐步去除雜訊,生成新圖像
訓練(正向):
乾淨圖像 → 添加雜訊 → 添加更多雜訊 → ... → 純雜訊

生成(反向):
純雜訊 → 去除雜訊 → 去除更多雜訊 → ... → 新圖像
                    (由文字提示引導)
考試提示:您不需要知道詳細的數學 — 只需理解概念:擴散模型通過在文字提示引導下逐步去除雜訊來創建圖像。
6. 預訓練 vs 微調 vs 提示
| 方法 | 內容 | 所需資料 | 成本 | 使用時機 |
|---|---|---|---|---|
| 預訓練 | 從頭開始訓練 | 數十億範例 | $$$$ | 創建新FM(由供應商完成) |
| 微調 | 進一步訓練現有FM | 數千範例 | $$ | 特定領域知識 |
| 提示工程 | 精心設計輸入 | 無(少量範例) | $ | 快速適應,無需訓練 |
| RAG | 用外部資料增強 | 知識庫 | $ | 存取當前/專有資料 |
考試決策樹:
需要模型了解特定領域知識?
├── 知識在您可以提供的文件中?
│   └── 是 → RAG(Bedrock Knowledge Bases)
│   └── 否,模型需要學習模式 →
│       ├── 有數千個訓練範例?→ 微調
│       └── 只有少量範例?→ 少樣本提示
├── 通用知識就夠了?→ 提示工程(零樣本/少樣本)
7. 練習題
Q1:一家公司想要跨產品圖像和文字描述搜尋相關資訊。哪種類型的模型最合適?
- A) 純文字LLM
- B) 多模態嵌入向量模型 ✓
- C) 擴散模型
- D) RNN模型
解說:多模態嵌入向量模型可以在同一向量空間中創建文字和圖像的向量表示,實現跨模態搜尋。
Q2:哪種Transformer架構最適合聊天機器人和內容創建等文字生成任務?
- A) 僅編碼器(BERT)
- B) 僅解碼器(GPT、Claude) ✓
- C) 編碼器-解碼器(T5)
- D) 卷積神經網路(CNN)
解說:僅解碼器架構一次生成一個token(自回歸),是大多數現代聊天機器人和文字生成器的基礎。
Q3:在生成式AI應用中,文字嵌入向量的用途是什麼?
- A) 壓縮檔案以進行儲存
- B) 將文字轉換為捕捉語意含義的數值向量 ✓
- C) 加密文字以確保安全
- D) 在語言之間翻譯文字
解說:嵌入向量是捕捉語意含義的文字數值向量表示。相似的文字具有相似的向量,可用於語意搜尋、RAG和聚類。