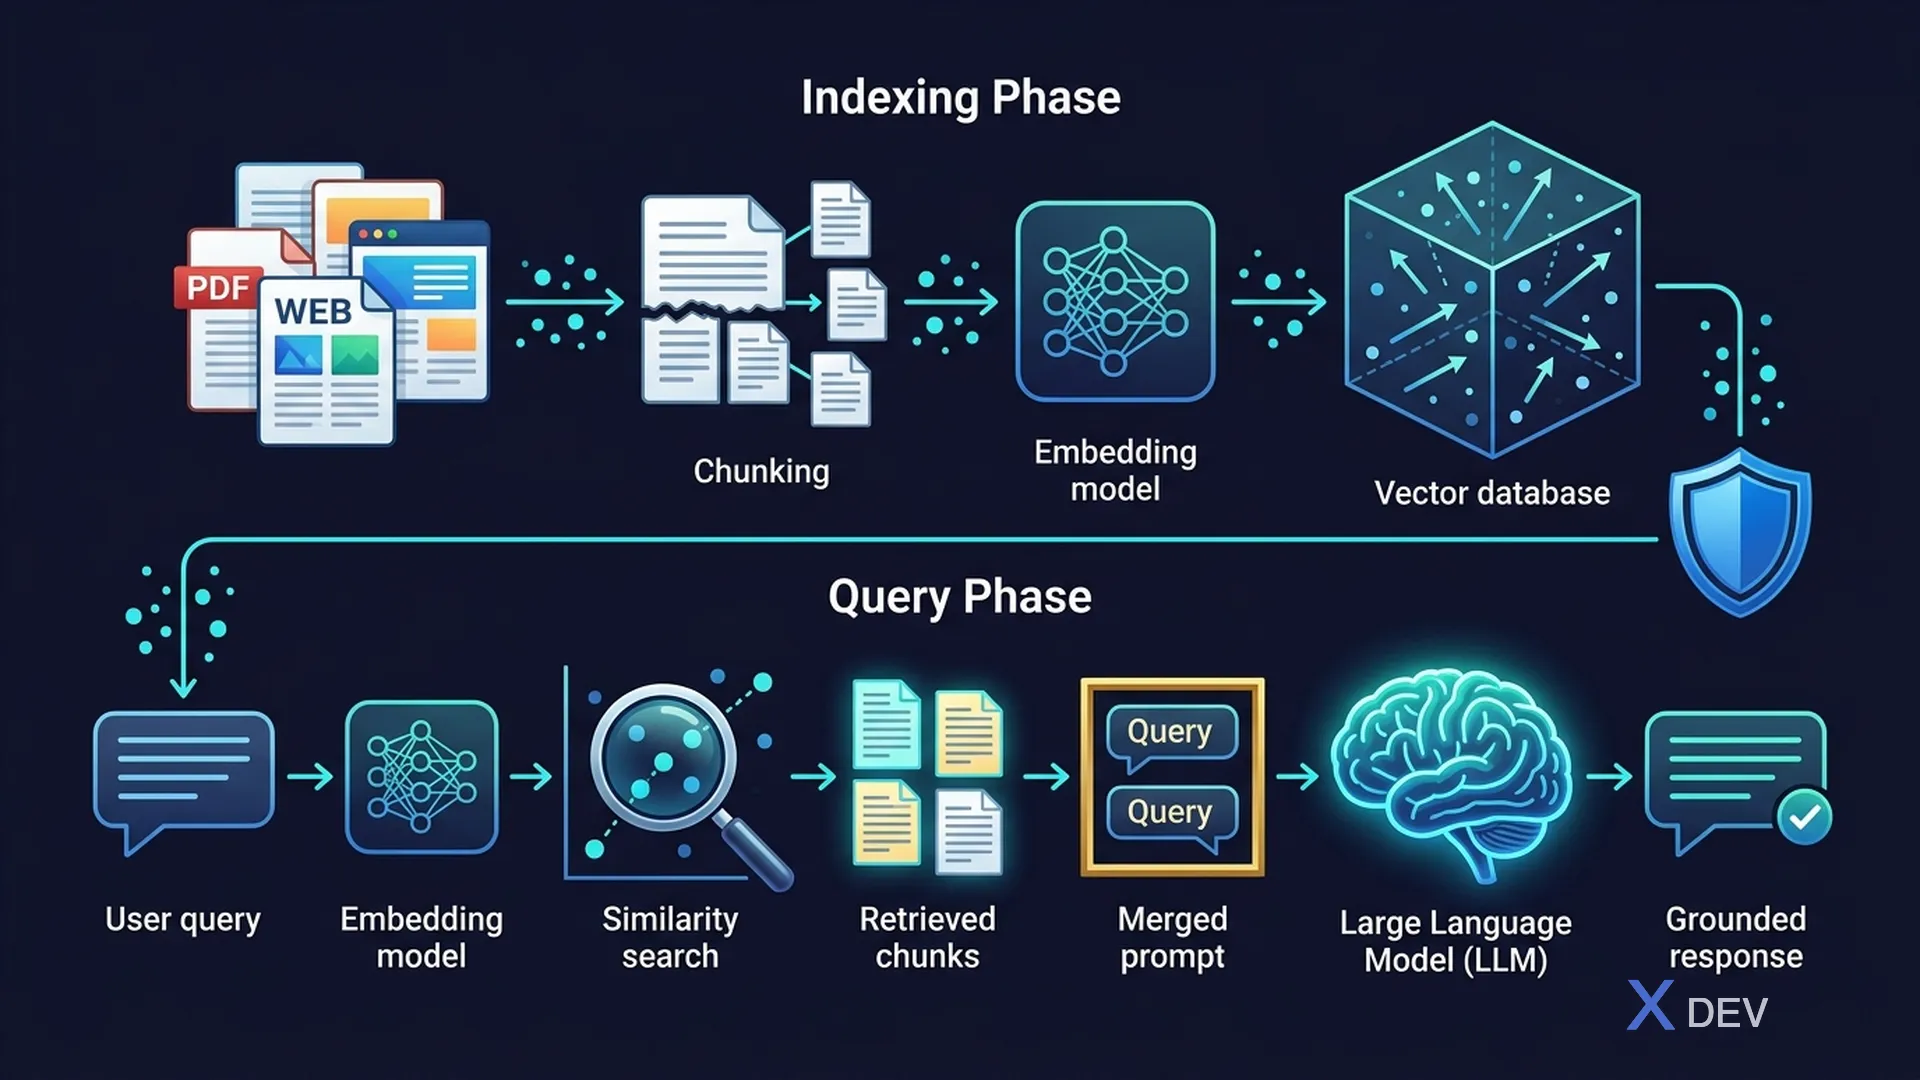
RAGアーキテクチャ — Amazon Bedrock Knowledge Basesを使用したインデックスフェーズとクエリフェーズ
1. RAGとは?
Retrieval-Augmented Generation(RAG)は、FMと外部知識ソースを組み合わせて、より正確な回答を提供し、ハルシネーションを削減し、モデルが知らない情報を取り込む技術です。
1.1. なぜRAGが必要?
| 課題 | RAGによる解決策 |
|---|---|
| 知識のカットオフ日 | 最新のドキュメントを検索 |
| ハルシネーション | 実際のデータに基づいて回答 |
| ドメイン知識がない | 企業固有のドキュメントを追加 |
| 一般的な回答 | 特定のソースを引用 |
| プライバシー — FMトレーニングにデータを送れない | データを自社のベクトルDBに保持 |
1.2. RAGアーキテクチャ
RAGパイプライン:

┌─────────────────────────────────────────────────────────────┐
│  インデックス作成(一度/定期的に実行)                          │
│                                                             │
│  ドキュメント → チャンキング → エンベディングモデル → ベクトルDB  │
│  (PDF, web,    (テキスト    (Amazon Titan       (OpenSearch, │
│   S3等)        分割)        Embeddings)         Aurora       │
│                                                 pgvector)   │
└─────────────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────────────┐
│  検索と生成(クエリごと)                                     │
│                                                             │
│  ユーザークエリ → クエリ埋め込み → ベクトルDB検索 → Top-K文書   │
│                                                             │
│  拡張プロンプト = システムプロンプト + 検索文書 + クエリ         │
│                                                             │
│  拡張プロンプト → 基盤モデル → ソース付き回答                   │
└─────────────────────────────────────────────────────────────┘
2. チャンキング戦略
エンベディングを作成する前に、ドキュメントを適切なサイズのセグメントに分割(チャンキング)する必要があります。
| 戦略 | 説明 | 最適な用途 |
|---|---|---|
| 固定サイズ | N文字/トークンごとに分割 | シンプルで均一なドキュメント |
| 文ベース | 文の境界で分割 | ナラティブテキスト |
| 段落ベース | 段落の区切りで分割 | 構造化されたドキュメント |
| セマンティック | トピックの変化に基づいて分割 | 複雑なドキュメント |
| 階層的 | 親子チャンクの関係 | セクションのある長文ドキュメント |
チャンクサイズのトレードオフ:
小さなチャンク(100-200トークン):
  ✓ より精密な検索
  ✗ コンテキストを失う可能性
  ✗ 検索するチャンクが増える

大きなチャンク(500-1000トークン):
  ✓ より多くのコンテキストを保持
  ✗ 無関係な情報を含む可能性
  ✗ チャンクが少なく、粒度が低い

オーバーラップ(例:チャンク間で20%):
  ✓ 境界での情報損失を防止
  ✗ ストレージと計算量が増加
試験のポイント:「RAG検索の精度を向上させるには?」→ チャンクサイズの調整、オーバーラップの追加、セマンティックチャンキングの使用、エンベディングモデルの改善。
3. RAG用エンベディング
3.1. AWSエンベディングモデル
| モデル | モダリティ | 次元数 | ユースケース |
|---|---|---|---|
| Amazon Titan Text Embeddings V2 | テキスト | 256/512/1024 | セマンティック検索、RAG |
| Amazon Titan Multimodal Embeddings | テキスト + 画像 | 256/384/1024 | クロスモーダル検索 |
| Cohere Embed | テキスト | 1024 | 多言語検索 |
3.2. AWS上のベクトルデータベース
| サービス | タイプ | 主な特徴 |
|---|---|---|
| Amazon OpenSearch Serverless | マネージド | ベクトル検索コレクションタイプ、サーバーレス |
| Amazon Aurora PostgreSQL | RDB + ベクトル | pgvector拡張 |
| Amazon Neptune | グラフ + ベクトル | ベクトル検索付きナレッジグラフ |
| Amazon DocumentDB | ドキュメント + ベクトル | MongoDB互換、ベクトル検索付き |
| Amazon MemoryDB | インメモリ + ベクトル | Redis互換、超低レイテンシー |
| Pinecone(サードパーティ) | 専用ベクトルDB | 人気、Bedrockと統合 |
4. Amazon Bedrock Knowledge Bases
Bedrock Knowledge BasesはフルマネージドのRAGソリューションです。AWSがチャンキング、エンベディング、インデックス作成、検索を処理します — データソースを指定するだけです。
4.1. 仕組み
セットアップ:
┌───────────┐     ┌───────────────┐     ┌─────────────────┐
│ S3バケット │────→│ Bedrock       │────→│ ベクトルストア    │
│ (文書)     │     │ Knowledge Base│     │ (OpenSearch/     │
│           │     │ (自動チャンク, │     │  Aurora/Pinecone) │
│           │     │  自動埋め込み) │     │                  │
└───────────┘     └───────────────┘     └─────────────────┘

クエリ:
┌───────────┐     ┌───────────────┐     ┌─────────────────┐
│ ユーザー   │────→│ Knowledge Base│────→│ FM (Claude,      │
│ "...とは   │     │ 関連文書を     │     │  Titan等)        │
│  何?"     │     │ 検索          │     │ 回答を生成       │
└───────────┘     └───────────────┘     └─────────────────┘
4.2. サポートされるデータソース
- Amazon S3:PDF、TXT、MD、HTML、DOC、CSV
- Webクローラー:ウェブサイトを自動クロール
- Confluence:Atlassian Confluenceページ
- SharePoint:Microsoft SharePointドキュメント
- Salesforce:Salesforceナレッジ記事
4.3. 主な機能
| 機能 | メリット |
|---|---|
| マネージドチャンキング | ドキュメントを自動分割(固定、セマンティック、階層的) |
| 自動同期 | データ変更時に定期的に再インデックス |
| ソース帰属 | 回答とともにソースドキュメントを返す |
| メタデータフィルタリング | カスタムメタデータフィールドでチャンクをフィルタ |
| ハイブリッド検索 | セマンティック + キーワード検索を組み合わせ |
| ガードレール統合 | RAG回答に安全フィルタを適用 |
試験のポイント:「S3に保存された社内ドキュメントから質問に回答するチャットボットを、最小限のカスタムコードで構築したい」→ Amazon Bedrock Knowledge Bases。
5. RAG vs ファインチューニング
| 要素 | RAG | ファインチューニング |
|---|---|---|
| 目的 | 外部/最新データへのアクセス | 新しいスキル/ドメインパターンの習得 |
| データの鮮度 | 常に最新 | トレーニング時点で固定 |
| トレーニング必要? | モデルトレーニング不要 | はい、ラベル付きデータ + 計算リソースが必要 |
| コスト | ベクトルDB + 検索コスト | トレーニング計算 + ストレージ |
| ハルシネーション | 削減(データに基づく) | まだハルシネーションの可能性あり |
| レイテンシー | やや高い(検索ステップ) | ベースモデルと同じ |
| 最適な用途 | Q&A、検索、ナレッジベース | スタイル、トーン、ドメイン固有パターン |
| データプライバシー | データは自社ベクトルDBに保持 | データはトレーニングプロセスで使用 |
判断マトリクス:
「社内文書から回答が必要?」              → RAG
「リアルタイム/最新情報が必要?」          → RAG
「モデルの文体を変えたい?」              → ファインチューニング
「特定のフォーマットに従わせたい?」       → まずプロンプティング → 次にファインチューニング
「ドメイン固有の用語が必要?」            → RAG(文書内)またはファインチューニング(パターン)
「最小限の労力/コスト?」                → RAG > プロンプトエンジニアリング > ファインチューニング
6. RAG品質の評価
| 指標 | 測定内容 |
|---|---|
| 忠実性(Faithfulness) | 回答が検索文書に基づいているか?(ハルシネーションなし) |
| 関連性(Relevance) | 検索されたドキュメントはクエリに関連しているか? |
| 回答の正確性 | 最終的な回答は事実として正しいか? |
| コンテキスト精度 | 検索されたチャンクのうち実際に関連するものの割合は? |
| コンテキスト再現率 | 関連するチャンクをすべて検索できたか? |
7. 練習問題
Q1:ヘルスケア企業がAmazon S3に保存された最新の医学研究論文から質問に回答するAIアシスタントを求めています。情報は毎週更新されます。最も適切なアプローチはどれですか?
- A) 論文で基盤モデルをファインチューニングする
- B) Amazon Bedrock Knowledge BasesでRAGを使用する ✓
- C) 大きなコンテキストウィンドウでZero-shotプロンプティングを使用する
- D) 医療データでカスタムモデルを事前トレーニングする
解説:Bedrock Knowledge BasesによるRAGが理想的です。S3ドキュメントを自動的にインデックスし、クエリごとに関連情報を検索し、再トレーニングなしで回答を最新に保ちます。毎週の更新は自動同期で処理されます。
Q2:RAGパイプラインでドキュメントをチャンキングする主な目的は何ですか?
- A) ストレージコストを削減するため
- B) ドキュメントをエンベディングと検索のために管理可能な断片に分割するため ✓
- C) 機密データを暗号化するため
- D) ドキュメントを別のファイル形式に変換するため
解説:チャンキングは大きなドキュメントを、個別に埋め込みと検索が可能な、意味的に意味のある小さな断片に分割します。これにより、ドキュメント全体を処理するのではなく、関連情報の精密な検索が可能になります。
Q3:企業がRAGアプリケーションを構築しましたが、検索されたドキュメントに裏付けられていない回答を返すことがあります。改善に注力すべき指標はどれですか?
- A) コンテキスト再現率
- B) 回答の長さ
- C) 忠実性(Faithfulness) ✓
- D) 応答レイテンシー
解説:忠実性は、生成された回答が検索されたドキュメントに基づいているかどうかを測定します。忠実性が低い場合、モデルは検索されたコンテキストが裏付ける以上の情報を生成していることを意味します(RAGコンテキストでのハルシネーション)。