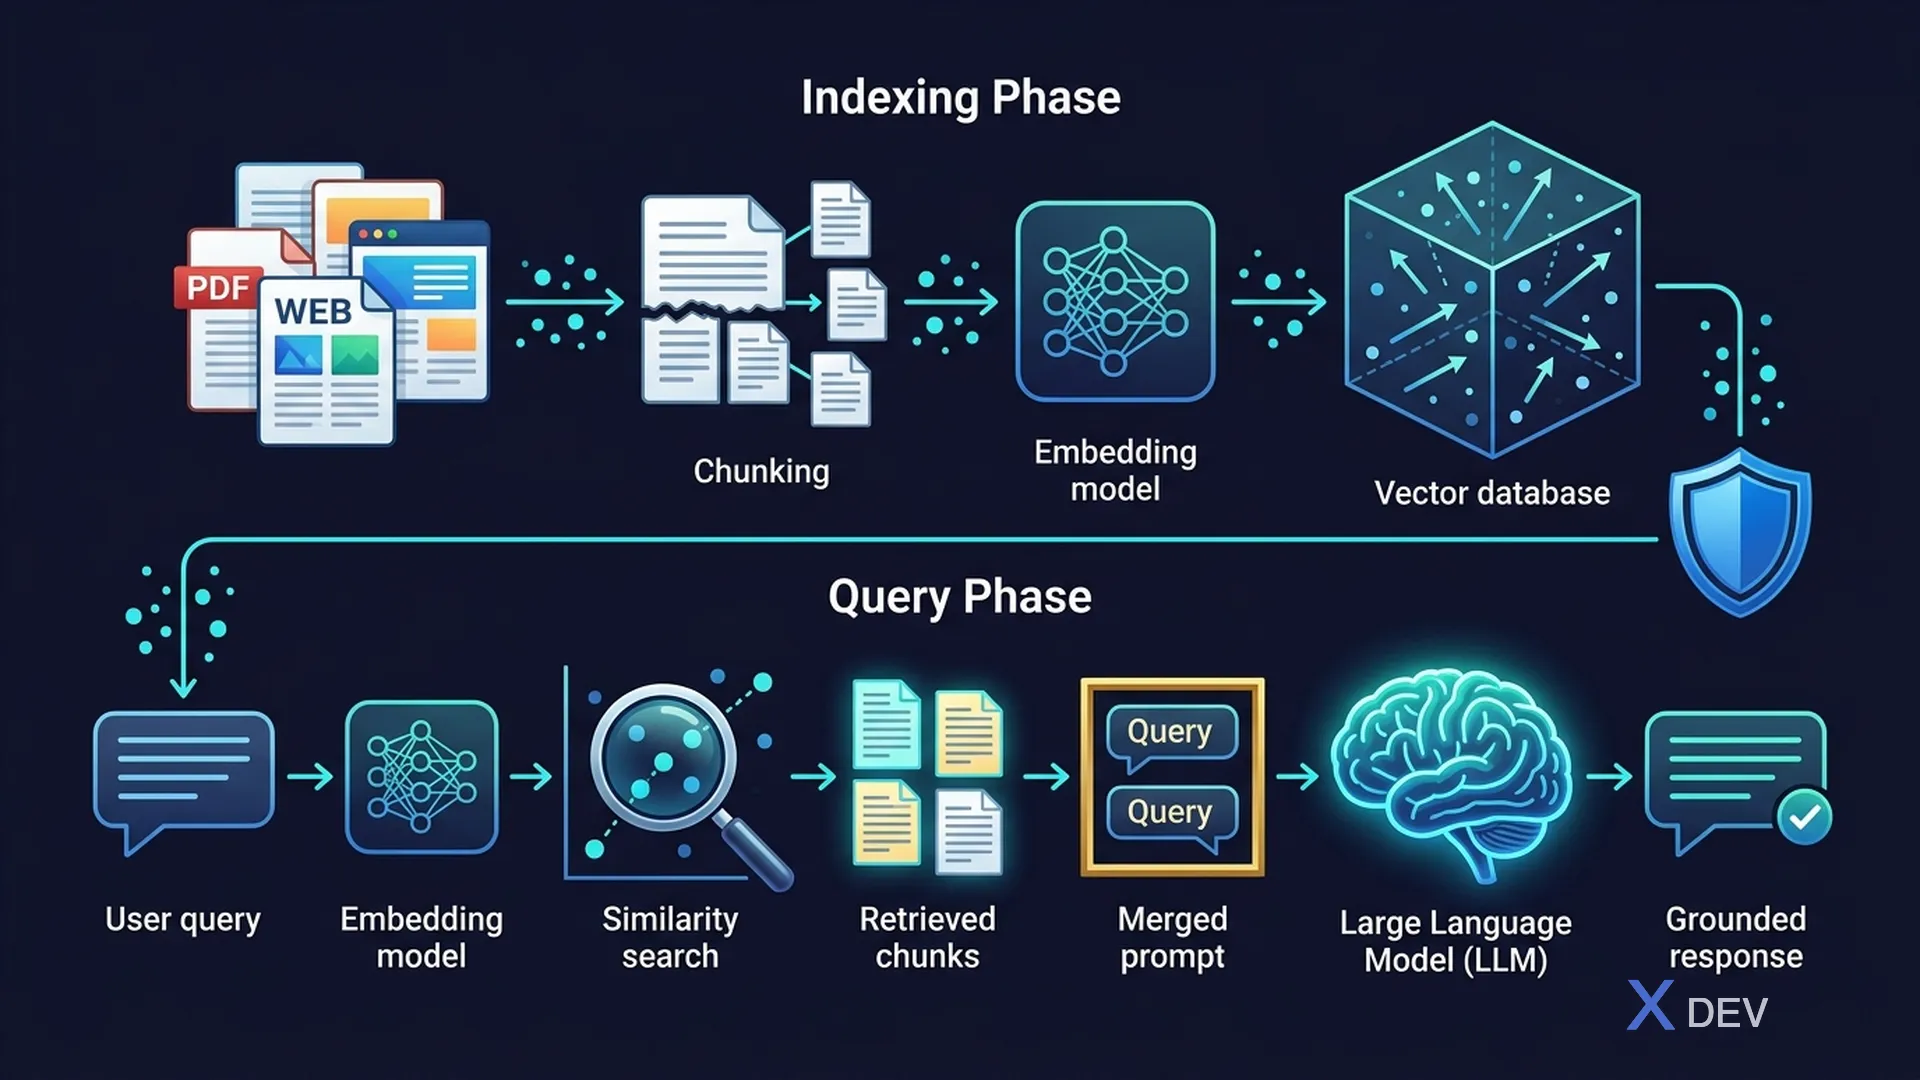
RAG 架構——使用 Amazon Bedrock Knowledge Bases 的索引階段與查詢階段
1. 什麼是 RAG?
檢索增強生成(Retrieval-Augmented Generation,RAG)是一種將 FM 與外部知識來源結合的技術,以提供更準確的答案、減少幻覺,並納入模型不知道的資訊。
1.1. 為什麼需要 RAG?
| 問題 | RAG 解決方案 |
|---|---|
| 知識截止日期 | 檢索最新文件 |
| 幻覺 | 基於真實資料生成回應 |
| 缺乏領域知識 | 添加公司專屬文件 |
| 通用回答 | 引用特定來源 |
| 隱私——無法將資料發送到 FM 訓練 | 將資料保存在自己的向量資料庫中 |
1.2. RAG 架構
RAG 管線:

┌─────────────────────────────────────────────────────────────┐
│  索引(執行一次 / 定期更新)                                  │
│                                                             │
│  文件 → 分塊 → 嵌入模型 → 向量資料庫                          │
│  (PDF, web,    (分割     (Amazon Titan     (OpenSearch,     │
│   S3 等)       文字)      Embeddings)       Aurora pgvector) │
└─────────────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────────────┐
│  檢索與生成(每次查詢)                                       │
│                                                             │
│  使用者查詢 → 嵌入查詢 → 搜尋向量資料庫 → Top-K 文件          │
│                                                             │
│  增強提示 = 系統提示 + 檢索到的文件 + 查詢                     │
│                                                             │
│  增強提示 → 基礎模型 → 附帶來源的回答                         │
└─────────────────────────────────────────────────────────────┘
2. 分塊策略
在建立嵌入之前,文件必須被分割成更小的片段(分塊),切成適當大小的區段。
| 策略 | 描述 | 最適用於 |
|---|---|---|
| 固定大小 | 每 N 個字元/token 分割 | 簡單、統一的文件 |
| 基於句子 | 在句子邊界分割 | 敘述性文字 |
| 基於段落 | 在段落分隔處分割 | 結構良好的文件 |
| 語義分塊 | 基於主題變化分割 | 複雜文件 |
| 階層式 | 父子分塊關係 | 具有章節的長文件 |
分塊大小的權衡:
小分塊(100-200 tokens):
  ✓ 更精確的檢索
  ✗ 可能丟失上下文
  ✗ 需要搜尋更多分塊

大分塊(500-1000 tokens):
  ✓ 保留更多上下文
  ✗ 可能包含無關資訊
  ✗ 分塊較少,粒度較低

重疊(例如分塊之間 20%):
  ✓ 防止邊界處的資訊丟失
  ✗ 增加儲存和運算成本
考試提示:「如何提高 RAG 檢索準確性?」→ 調整分塊大小、添加重疊、使用語義分塊、改善嵌入模型。
3. RAG 的嵌入
3.1. AWS 嵌入模型
| 模型 | 模態 | 維度 | 用途 |
|---|---|---|---|
| Amazon Titan Text Embeddings V2 | 文字 | 256/512/1024 | 語義搜尋、RAG |
| Amazon Titan Multimodal Embeddings | 文字 + 圖像 | 256/384/1024 | 跨模態搜尋 |
| Cohere Embed | 文字 | 1024 | 多語言搜尋 |
3.2. AWS 上的向量資料庫
| 服務 | 類型 | 主要特點 |
|---|---|---|
| Amazon OpenSearch Serverless | 託管式 | 向量搜尋集合類型,無伺服器 |
| Amazon Aurora PostgreSQL | 關聯式 + 向量 | pgvector 擴充 |
| Amazon Neptune | 圖 + 向量 | 知識圖譜搭配向量搜尋 |
| Amazon DocumentDB | 文件 + 向量 | MongoDB 相容,支援向量搜尋 |
| Amazon MemoryDB | 記憶體 + 向量 | Redis 相容,超低延遲 |
| Pinecone(第三方) | 專用向量資料庫 | 廣受歡迎,與 Bedrock 整合 |
4. Amazon Bedrock Knowledge Bases
Bedrock Knowledge Bases 是完全託管的 RAG 解決方案。AWS 處理分塊、嵌入、索引和檢索——你只需要指向你的資料來源。
4.1. 運作方式
設定:
┌───────────┐     ┌───────────────┐     ┌─────────────────┐
│ S3 Bucket │────→│ Bedrock       │────→│ 向量儲存區       │
│ (文件)     │     │ Knowledge Base│     │ (OpenSearch/     │
│           │     │ (自動分塊,    │     │  Aurora/Pinecone) │
│           │     │  自動嵌入)    │     │                  │
└───────────┘     └───────────────┘     └─────────────────┘

查詢:
┌───────────┐     ┌───────────────┐     ┌─────────────────┐
│ 使用者     │────→│ Knowledge Base│────→│ FM (Claude,      │
│ 「什麼     │     │ 檢索          │     │  Titan 等)       │
│  是...」   │     │ 相關文件      │     │ 生成回答         │
└───────────┘     └───────────────┘     └─────────────────┘
4.2. 支援的資料來源
- Amazon S3:PDF、TXT、MD、HTML、DOC、CSV
- Web Crawler:自動抓取網站
- Confluence:Atlassian Confluence 頁面
- SharePoint:Microsoft SharePoint 文件
- Salesforce:Salesforce 知識文章
4.3. 主要功能
| 功能 | 優勢 |
|---|---|
| 託管分塊 | 自動分割文件(固定、語義、階層式) |
| 自動同步 | 資料變更時定期重新索引 |
| 來源標註 | 回答時附帶來源文件 |
| 中繼資料過濾 | 按自訂中繼資料欄位過濾分塊 |
| 混合搜尋 | 結合語義搜尋 + 關鍵字搜尋 |
| Guardrails 整合 | 對 RAG 回應套用安全過濾器 |
考試提示:「一家公司想建立一個聊天機器人,從存儲在 S3 中的內部文件回答問題,且自訂程式碼最少」→ Amazon Bedrock Knowledge Bases。
5. RAG 與微調的比較
| 因素 | RAG | 微調 |
|---|---|---|
| 目的 | 存取外部/最新資料 | 教授新技能/領域模式 |
| 資料新鮮度 | 始終保持最新 | 固定在訓練時間 |
| 需要訓練嗎? | 不需要模型訓練 | 是的,需要標記資料 + 運算 |
| 成本 | 向量資料庫 + 檢索成本 | 訓練運算 + 儲存 |
| 幻覺 | 減少(基於資料) | 仍可能產生幻覺 |
| 延遲 | 略高(檢索步驟) | 與基礎模型相同 |
| 最適用於 | 問答、搜尋、知識庫 | 風格、語氣、領域特定模式 |
| 資料隱私 | 資料保留在你的向量資料庫中 | 資料用於訓練過程 |
決策矩陣:
「需要從公司文件回答問題?」         → RAG
「需要即時/最新資訊?」             → RAG
「需要改變模型的寫作風格?」         → 微調
「需要模型遵循特定格式?」           → 先嘗試提示 → 然後微調
「需要領域特定術語?」               → RAG(如果在文件中)或微調(如果是模式)
「最少努力/成本?」                  → RAG > 提示工程 > 微調
6. 評估 RAG 品質
| 指標 | 衡量內容 |
|---|---|
| 忠實度 | 回答是否基於檢索到的文件?(無幻覺) |
| 相關性 | 檢索到的文件是否與查詢相關? |
| 答案正確性 | 最終答案是否事實正確? |
| 上下文精確度 | 檢索到的分塊中有多少百分比實際相關? |
| 上下文召回率 | 是否檢索到所有相關的分塊? |
7. 練習題
Q1:一家醫療公司想要一個 AI 助手,從存儲在 Amazon S3 中的最新醫學研究論文回答問題。資訊每週更新。哪種方法最合適?
- A) 在論文上微調基礎模型
- B) 使用 RAG 搭配 Amazon Bedrock Knowledge Bases ✓
- C) 使用 zero-shot 提示搭配大上下文視窗
- D) 在醫學資料上預訓練自訂模型
解說:RAG 搭配 Bedrock Knowledge Bases 是理想選擇——它自動索引 S3 文件,每次查詢檢索相關資訊,並透過自動同步保持回應為最新,無需重新訓練。
Q2:在 RAG 管線中,分塊文件的主要目的是什麼?
- A) 降低儲存成本
- B) 將文件分割成可管理的片段以進行嵌入和檢索 ✓
- C) 加密敏感資料
- D) 將文件轉換為不同的檔案格式
解說:分塊將大型文件分割成較小的、語義上有意義的片段,可以單獨進行嵌入和檢索。這使得能夠精確檢索相關資訊,而不是處理整個文件。
Q3:一家公司建立了 RAG 應用程式,但有時會回傳檢索到的文件不支援的答案。他們應該專注於改善哪個指標?
- A) 上下文召回率
- B) 答案長度
- C) 忠實度 ✓
- D) 回應延遲
解說:忠實度衡量生成的答案是否基於檢索到的文件。低忠實度表示模型生成了超出檢索到的上下文所支援的資訊(RAG 情境中的幻覺)。