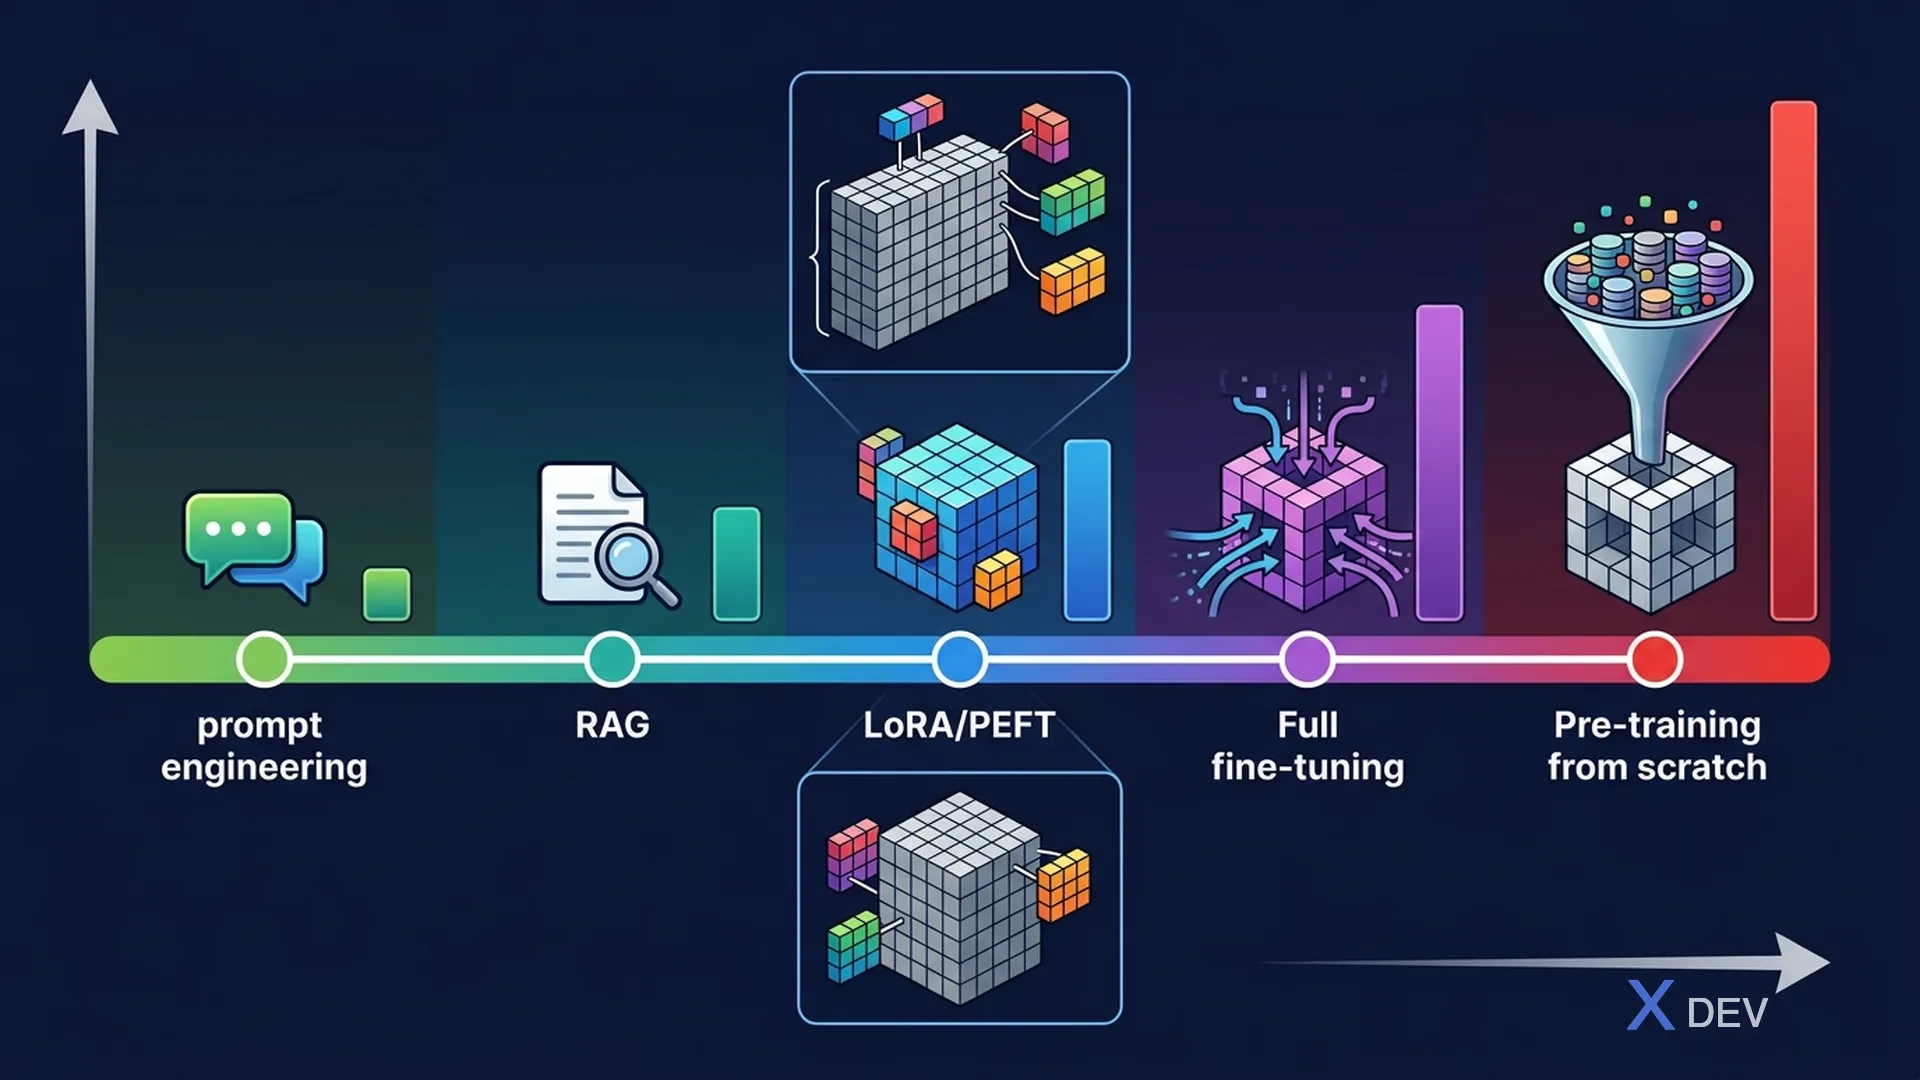
モデルカスタマイズの範囲:プロンプトエンジニアリングからスクラッチでの事前トレーニングまで
1. モデルカスタマイズの範囲
FMの動作をカスタマイズする方法は、シンプルなものから複雑なものまで多数あります:
最小の労力                                      最大の労力
──────────────────────────────────────────────────────────
プロンプト    Few-shot      RAG      ファイン    継続的       事前
エンジニア    プロンプ              チューニ    事前         トレー
リング        ティング              ング        トレーニング  ニング
──────────────────────────────────────────────────────────
トレーニング不要              ←                 →    フルトレーニング
$ 最安                       ←                 →    $$$$ 最高額
数分                         ←                 →    数週間/数ヶ月
2. ファインチューニング
ファインチューニング = 既存のFMを特定のデータセットでさらにトレーニングし、ドメイン/タスクでのパフォーマンスを向上させること。
2.1. いつファインチューニングするか?
| ファインチューニングすべき場合 | ファインチューニング不要な場合 |
|---|---|
| 特定のスタイル、トーン、フォーマットが必要 | 事実に基づくQ&Aのみ必要(RAGを使用) |
| ドメイン固有の言語パターン | プロンプティングでタスクがうまくいく |
| 特定タスクの精度を向上させたい | ラベル付きトレーニングデータがない |
| プロンプトサイズを削減(指示を内在化) | データが頻繁に変更される(RAGを使用) |
| 一貫した出力フォーマットが必要 | 予算が限られている |
2.2. ファインチューニングの種類
| 種類 | 内容 | データ形式 | ユースケース |
|---|---|---|---|
| 指示ファインチューニング | プロンプト-レスポンスペアでトレーニング | {"prompt": "...", "completion": "..."} | 指示への追従を改善 |
| ドメイン適応 | ドメインテキストでトレーニング | ドメインドキュメント(医療、法律) | ドメイン用語の学習 |
| タスク固有 | 特定のタスク例でトレーニング | タスクの入出力ペア | 分類、抽出 |
3. PEFTとLoRA
3.1. パラメータ効率的ファインチューニング(PEFT)
フルファインチューニングはすべてのモデルパラメータを更新します — 高コストで大量のGPUメモリが必要です。PEFT手法はパラメータの小さなサブセットのみを更新します。
フルファインチューニング:
  モデル: 70億パラメータ
  更新: 70億パラメータ (100%)
  GPUメモリ: 非常に大きい
  コスト: $$$$

PEFT (LoRA):
  モデル: 70億パラメータ
  更新: ~1000万パラメータ (0.1%)
  GPUメモリ: はるかに少ない
  コスト: $$
3.2. LoRA(Low-Rank Adaptation)
LoRAは、すべての重みを更新する代わりに、モデルレイヤーに小さな学習可能な行列を追加します:
- 元のモデルの重みを凍結
- 小さな「アダプター」行列(ランク分解)を追加
- これらの小さなアダプターのみをトレーニング
- 推論時:アダプターを元の重みとマージ
試験のポイント:「品質を維持しながらファインチューニングのコストを削減するテクニックはどれ?」→ LoRA / PEFT。重要コンセプト:全パラメータではなく、小さな割合のパラメータをトレーニングする。
4. 継続的事前トレーニング
継続的事前トレーニングは、大量のラベルなしドメインデータでFMをトレーニングし、タスク固有のデータでファインチューニングする前にモデルに新しい語彙と概念を教えます。
ワークフロー:
ベースFM → 継続的事前トレーニング → ファインチューニング → 評価
           (ドメインコーパス、          (ラベル付き      (ホールドアウト
            ラベルなし)                タスクデータ)     セットでテスト)

例:
ベースClaude → 10万件の医学論文でトレーニング → 医療Q&Aペアで
              (継続的事前トレーニング)          ファインチューニング
              学習:医学用語、                 学習:臨床的な質問に
              薬名、処置                       回答する方法
継続的事前トレーニング vs ファインチューニング:
| 側面 | 継続的事前トレーニング | ファインチューニング |
|---|---|---|
| データ | 大量のラベルなしドメインテキスト | 少量のラベル付きタスクデータ |
| 目的 | ドメイン知識の学習 | タスク固有の動作の学習 |
| コスト | より高コスト(データが大きい) | より低コスト |
| タイミング | モデルがドメイン語彙を欠いている場合 | モデルに特定のタスクを実行させたい場合 |
5. RLHF(人間のフィードバックからの強化学習)
RLHFは、モデルの出力を人間の好みに整合させるために使用されます — 出力をより有用で、真実で、無害にします。
RLHFパイプライン:
1. 人間のフィードバック収集  2. 報酬モデルのトレーニング 3. RLで最適化
   「どちらの回答が              学習:人間が何を          FMが生成 →
    良い?AかB?」               好むか                   報酬モデルがスコア →
                                                         FMの重みを更新
RLHFは主にFMプロバイダー(Anthropic、Meta、Amazon)が行います — 通常エンドユーザーは実施しません。ただし、試験のために概念を理解しておく必要があります。
6. Amazon Bedrockカスタムモデル
Bedrockは2つのカスタマイズアプローチを提供します:
6.1. Bedrockでのファインチューニング
| 機能 | 詳細 |
|---|---|
| サポートモデル | Amazon Titan、Meta Llama、Cohere |
| データ形式 | プロンプト-完了ペアのJSONL |
| データの場所 | Amazon S3 |
| 出力 | Bedrock内のカスタムモデルバージョン |
| プロビジョンドスループット | ファインチューニング済みモデルの使用に必要 |
6.2. Bedrockでの継続的事前トレーニング
| 機能 | 詳細 |
|---|---|
| サポートモデル | Amazon Titan、Meta Llama、Cohere |
| データ形式 | プレーンテキストファイル(ラベルなし) |
| ユースケース | ファインチューニング前のドメイン適応 |
6.3. トレーニングデータの準備
// ファインチューニングデータ形式 (JSONL):
{"prompt": "Drug Xの推奨用量は?", "completion": "Drug Xの成人向け推奨用量は1日2回500mgです。"}
{"prompt": "Drug Xの副作用を列挙してください。", "completion": "一般的な副作用には頭痛、吐き気、めまいがあります。"}
6.4. Bedrockでのモデル評価
Amazon Bedrockモデル評価ではモデルを比較できます:
- 自動評価:組み込み指標(精度、堅牢性、毒性)
- 人間評価:人間のレビューアーがモデル出力を評価
- モデル比較:異なるFMの並列比較
試験のポイント:「特定のユースケースで2つの基盤モデルの品質を比較する方法は?」→ Amazon Bedrockモデル評価。自動指標と人間評価の両方をサポート。
7. トレーニングデータのベストプラクティス
| プラクティス | 理由 |
|---|---|
| 高品質データ | ゴミを入れればゴミが出る |
| 多様な例 | 狭いパターンへの過学習を防止 |
| バランスの取れたクラス | 多数クラスへの偏りを回避 |
| クリーンなデータ | 重複、エラー、PIIを除去 |
| 十分な量 | ファインチューニングには通常1000+ |
| トレーニング/検証分割 | 未見のデータで評価 |
| フォーマットの一貫性 | すべての例で同じ構造 |
8. まとめ:いつ何を使うか
| シナリオ | 最適なアプローチ |
|---|---|
| シンプルなタスク、モデルがすでに得意 | プロンプトエンジニアリング |
| 特定のパターンに従わせたい | Few-shotプロンプティング |
| 社内ドキュメントからの回答が必要 | RAG |
| 特定のスタイル/トーン/フォーマットが必要 | ファインチューニング |
| モデルがドメイン語彙を知らない | 継続的事前トレーニング + ファインチューニング |
| 人間の好みに整合 | RLHF(FMプロバイダーが実施) |
9. 練習問題
Q1:法律事務所がAIアシスタントに事務所承認の特定の文体で法的文書を生成させたいと考えています。承認済みの文書が5,000件あります。最も適切なカスタマイズアプローチはどれですか?
- A) ナレッジベースによるRAG
- B) Zero-shotプロンプティング
- C) 承認済み文書例でのファインチューニング ✓
- D) 法律教科書での継続的事前トレーニング
解説:ファインチューニングは、ラベル付きの例でモデルに特定の文体を教えるのに理想的です。RAGは情報検索用であり、スタイルの学習ではありません。継続的事前トレーニングは法的概念を教えますが、事務所固有のスタイルは教えません。
Q2:大規模言語モデルのパラメータの小さな割合のみを更新してファインチューニングできるテクニックはどれですか?
- A) フルファインチューニング
- B) LoRA(Low-Rank Adaptation) ✓
- C) 継続的事前トレーニング
- D) RLHF
解説:LoRAはPEFT(パラメータ効率的ファインチューニング)手法で、元のモデルの重みを凍結したまま小さな学習可能なアダプター行列を追加します。通常、全パラメータの1%未満を更新します。
Q3:企業が基盤モデルをファインチューニングしましたが、トレーニングデータではうまく機能し、新しいデータでは性能が低いです。この問題は何と呼ばれますか?
- A) 過少適合(Underfitting)
- B) 過学習(Overfitting) ✓
- C) 高バイアス
- D) データドリフト
解説:過学習は、モデルが一般的なパターンを学習する代わりにトレーニングデータを暗記した場合に発生します。解決策:より多くのトレーニングデータ、正則化、低い学習率、早期停止、データ拡張。