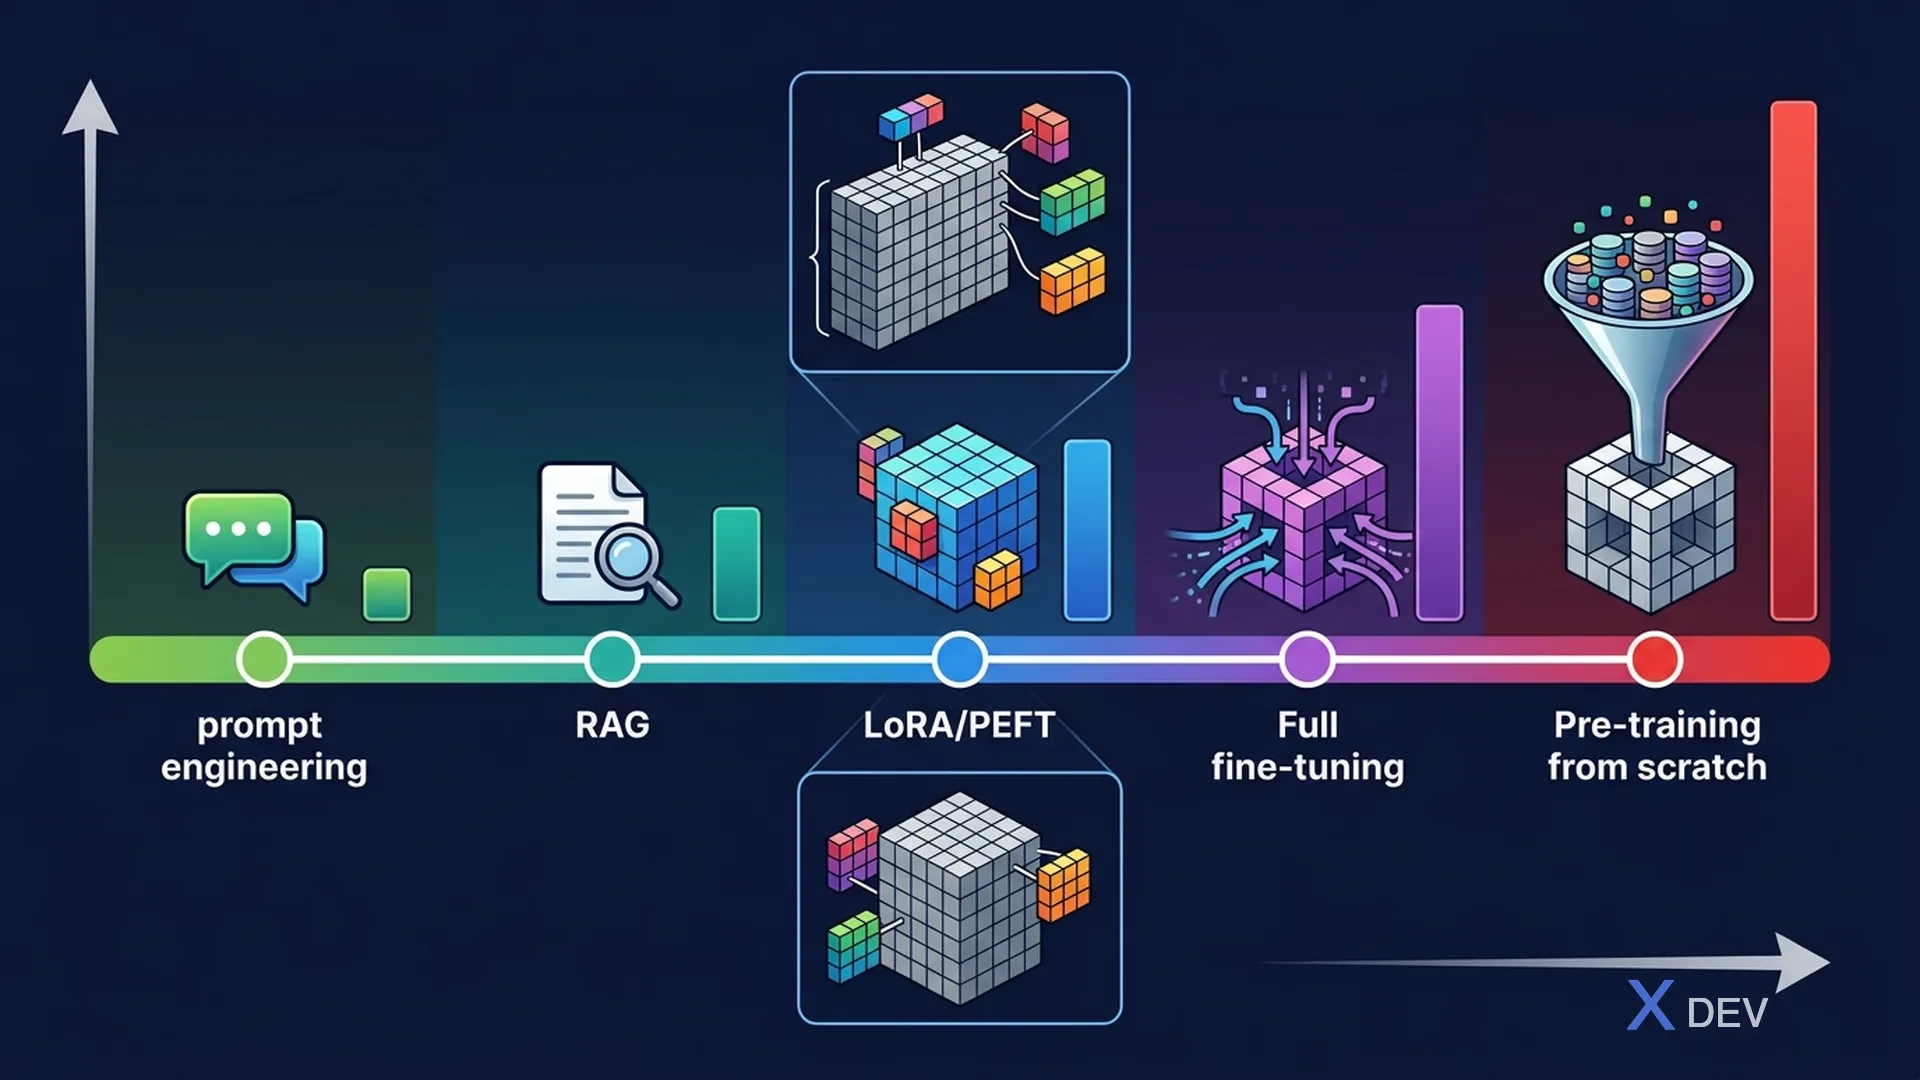
模型自訂範圍:從提示工程到從零開始預訓練
1. 模型自訂範圍
自訂 FM 行為有多種方式,從簡單到複雜:
最少工作量                                    最多工作量
──────────────────────────────────────────────────────────
提示       Few-shot      RAG       微調       持續         預訓練
工程       提示                               預訓練
──────────────────────────────────────────────────────────
無需訓練                   ←                 →    完整訓練
$ 最便宜                   ←                 →    $$$$ 最昂貴
幾分鐘                     ←                 →    數週/數月
2. 微調
微調(Fine-tuning)= 在你的特定資料集上進一步訓練現有的 FM,以提高在你的領域/任務上的表現。
2.1. 何時需要微調?
| 需要微調的情況... | 不需要微調的情況... |
|---|---|
| 需要特定的風格、語氣或格式 | 只需要事實問答(使用 RAG) |
| 領域特定的語言模式 | 任務用提示就能運作良好 |
| 提高特定任務的準確性 | 沒有標記的訓練資料 |
| 縮小提示大小(內化指令) | 資料頻繁變更(使用 RAG) |
| 需要一致的輸出格式 | 預算有限 |
2.2. 微調的類型
| 類型 | 內容 | 資料格式 | 用途 |
|---|---|---|---|
| 指令微調 | 在提示-回應配對上訓練 | {"prompt": "...", "completion": "..."} | 更好地遵循指令 |
| 領域適應 | 在領域文字上訓練 | 領域文件(醫學、法律) | 學習領域術語 |
| 任務特定 | 在特定任務範例上訓練 | 任務輸入-輸出配對 | 分類、擷取 |
3. PEFT 與 LoRA
3.1. 參數高效微調(PEFT)
完整微調會更新所有模型參數——昂貴且需要大量 GPU 記憶體。PEFT 方法只更新一小部分參數。
完整微調:
  模型:70 億個參數
  更新:70 億個參數(100%)
  GPU 記憶體:非常高
  成本:$$$$

PEFT (LoRA):
  模型:70 億個參數
  更新:約 1000 萬個參數(0.1%)
  GPU 記憶體:低得多
  成本:$$
3.2. LoRA(低秩適應)
LoRA 在模型層中添加小型可訓練矩陣,而不是更新所有權重:
- 凍結原始模型權重
- 添加小型「適配器」矩陣(秩分解)
- 只訓練這些小型適配器
- 推理時:將適配器與原始權重合併
考試提示:「哪種技術可以在保持品質的同時降低微調成本?」→ LoRA / PEFT。關鍵概念:只訓練一小部分參數而非全部。
4. 持續預訓練
持續預訓練(Continued Pre-training)在大量無標記的領域資料上訓練 FM——在針對任務特定資料進行微調之前,教導模型新的詞彙和概念。
工作流程:
基礎 FM → 持續預訓練 → 微調 → 評估
           (領域語料庫,     (標記的        (在保留
            無標記)           任務資料)      資料上測試)

範例:
基礎 Claude → 在 10 萬篇醫學論文上訓練 → 在醫學問答
              (持續預訓練)                配對上微調
              學習:醫學術語、              學習:如何回答
              藥物名稱、手術程序            臨床問題
持續預訓練 vs 微調:
| 面向 | 持續預訓練 | 微調 |
|---|---|---|
| 資料 | 大量、無標記的領域文字 | 較小、有標記的任務資料 |
| 目標 | 學習領域知識 | 學習任務特定行為 |
| 成本 | 更昂貴(更大的資料量) | 較不昂貴 |
| 時機 | 模型缺乏領域詞彙 | 模型需要執行特定任務 |
5. RLHF(人類反饋強化學習)
RLHF 用於對齊模型輸出與人類偏好——使輸出更有幫助、更真實、更無害。
RLHF 管線:
1. 收集人類反饋        2. 訓練獎勵模型       3. 使用 RL 最佳化
   「哪個回應比較         學習:人類              FM 生成 →
    好?A 還是 B?」      偏好什麼                獎勵模型評分 →
                                                 更新 FM 權重
RLHF 主要由 FM 供應商(Anthropic、Meta、Amazon)執行——通常不由終端使用者操作。但你應該為考試了解這個概念。
6. Amazon Bedrock Custom Models
Bedrock 提供兩種自訂方法:
6.1. Bedrock 中的微調
| 功能 | 詳情 |
|---|---|
| 支援的模型 | Amazon Titan、Meta Llama、Cohere |
| 資料格式 | JSONL,包含 prompt-completion 配對 |
| 資料位置 | Amazon S3 |
| 輸出 | Bedrock 中的自訂模型版本 |
| 佈建輸送量 | 使用微調模型時必須 |
6.2. Bedrock 中的持續預訓練
| 功能 | 詳情 |
|---|---|
| 支援的模型 | Amazon Titan、Meta Llama、Cohere |
| 資料格式 | 純文字檔案(無標記) |
| 用途 | 微調前的領域適應 |
6.3. 訓練資料準備
// 微調資料格式(JSONL):
{"prompt": "Drug X 的建議劑量是多少?", "completion": "Drug X 的建議劑量為成人每日兩次 500mg。"}
{"prompt": "列出 Drug X 的副作用。", "completion": "常見副作用包括頭痛、噁心和暈眩。"}
6.4. Bedrock 中的模型評估
Amazon Bedrock Model Evaluation 允許你比較模型:
- 自動評估:內建指標(準確性、穩健性、毒性)
- 人工評估:人類審查員評分模型輸出
- 比較模型:不同 FM 的並排比較
考試提示:「如何比較兩個基礎模型在特定用途上的品質?」→ Amazon Bedrock Model Evaluation。支援自動指標和人工評估。
7. 訓練資料最佳實踐
| 實踐 | 原因 |
|---|---|
| 高品質資料 | 垃圾進 = 垃圾出 |
| 多樣化範例 | 防止過擬合到狹窄的模式 |
| 平衡的類別 | 避免偏向多數類別 |
| 乾淨的資料 | 移除重複、錯誤、PII |
| 足夠的數量 | 微調通常需要 1000+ 筆 |
| 訓練/驗證分割 | 在未見過的資料上評估 |
| 格式一致性 | 所有範例使用相同結構 |
8. 總結:何時使用什麼
| 場景 | 最佳方法 |
|---|---|
| 簡單任務,模型已經很擅長 | 提示工程 |
| 需要模型遵循特定模式 | Few-shot 提示 |
| 需要從公司文件回答問題 | RAG |
| 需要特定風格/語氣/格式 | 微調 |
| 模型不認識領域詞彙 | 持續預訓練 + 微調 |
| 與人類偏好對齊 | RLHF(由 FM 供應商執行) |
9. 練習題
Q1:一家律師事務所希望他們的 AI 助手以事務所批准的特定寫作風格生成法律文件。他們有 5,000 份已批准文件的範例。哪種自訂方法最合適?
- A) RAG 搭配知識庫
- B) Zero-shot 提示
- C) 在已批准的文件範例上微調 ✓
- D) 在法律教科書上持續預訓練
解說:微調是用有標記的範例教導模型特定寫作風格的理想方法。RAG 是用於檢索資訊,而非學習風格。持續預訓練會教導法律概念,但不會教導事務所的特定風格。
Q2:哪種技術允許在只更新模型一小部分參數的情況下微調大型語言模型?
- A) 完整微調
- B) LoRA(低秩適應) ✓
- C) 持續預訓練
- D) RLHF
解說:LoRA 是一種 PEFT(參數高效微調)方法,它添加小型可訓練適配器矩陣,同時凍結原始模型權重——通常更新不到總參數的 1%。
Q3:一家公司微調了一個基礎模型,但模型在訓練資料上表現良好,在新資料上表現不佳。這個問題叫什麼?
- A) 欠擬合
- B) 過擬合 ✓
- C) 高偏差
- D) 資料漂移
解說:過擬合發生在模型記住訓練資料而非學習通用模式時。解決方案包括:更多訓練資料、正則化、降低學習率、早停或資料增強。