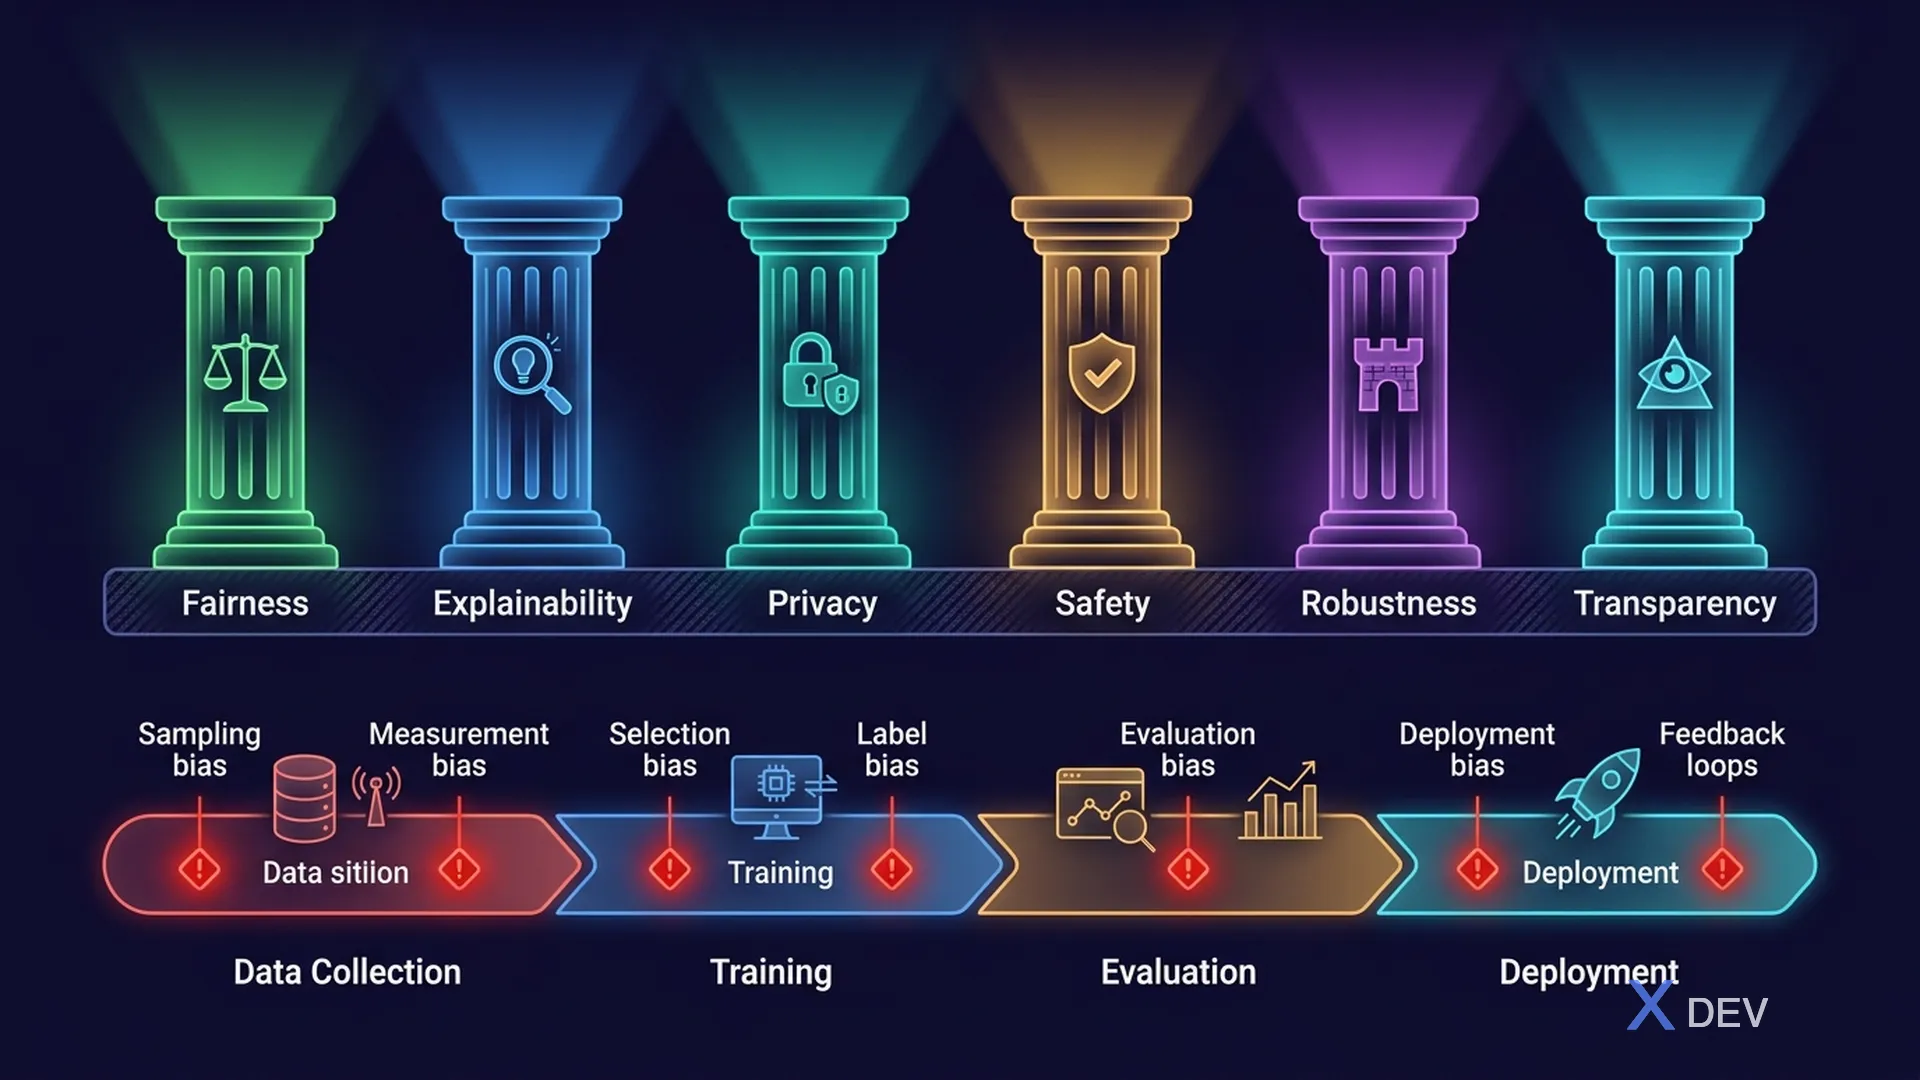
責任あるAIの柱とMLパイプラインにおけるバイアスの混入ポイント
1. 責任あるAIとは?
責任あるAIとは、AIシステムが倫理的、公平、透明、説明責任のある方法で開発・使用されることを保証するフレームワークです。
1.1. 責任あるAIの柱
| 柱 | 定義 | 例 |
|---|---|---|
| 公平性 | すべてのグループを公平に扱う | ローン審査モデルが人種で差別しない |
| 説明可能性 | モデルがなぜその判断をしたか理解できる | 「負債比率 > 0.5のためローンが否認されました」 |
| 透明性 | AI機能と限界を明確にする | コンテンツがAI生成であることを開示 |
| プライバシー | 個人データを保護する | 同意なしにPIIでトレーニングしない |
| 安全性 | 有害な出力を防ぐ | コンテンツフィルタ、ガードレール |
| 堅牢性 | 敵対的条件下でも信頼性を維持 | プロンプトインジェクション攻撃への耐性 |
| ガバナンス | 監視と説明責任 | 重要な判断への人間のレビュー |
2. AIにおけるバイアスの理解
2.1. バイアスの種類
| バイアスの種類 | 内容 | 例 |
|---|---|---|
| 選択バイアス | トレーニングデータが母集団を代表していない | IT企業のデータのみで訓練した採用モデル |
| 測定バイアス | 一貫性のないデータ収集 | 人口統計グループ間で異なる画像品質 |
| 確証バイアス | モデルが既存パターンを強化 | レコメンダーがユーザーの既知の好みのみ表示 |
| ラベルバイアス | 人間のラベラーがバイアスを導入 | アノテーター間で一貫性のない感情ラベル |
| アルゴリズムバイアス | モデルアーキテクチャがバイアスを増幅 | 精度の最適化が多数グループを優遇 |
| 想起バイアス | 過去のパターンの過剰表現 | 特定地域の逮捕データが多い→そこでの犯罪をより予測 |
| サンプリングバイアス | 非ランダムなデータ収集 | オンライン調査が高齢者を見逃す |
2.2. MLライフサイクルにおけるバイアスの混入箇所
データ収集     データ処理     モデルトレーニング  評価        デプロイ
     ↓              ↓              ↓           ↓          ↓
選択バイアス   特徴量設計    アルゴリズム     評価指標の   フィードバック
サンプリング   欠損値処理    バイアス         バイアス     ループバイアス
バイアス       エンコーディング 最適化目標                ユーザーバイアス
測定バイアス   選択
試験のポイント:「MLパイプラインのどこでバイアスが導入される可能性がある?」→ すべての段階で — データ収集、前処理、モデルトレーニング、評価、デプロイ。ライフサイクル全体を通じた監視が重要です。
3. 公平性指標
3.1. 主要な公平性の概念
| 概念 | 定義 |
|---|---|
| 人口統計的均等性 | グループ間で同じ割合の好ましい結果 |
| 機会均等 | グループ間で同じ真陽性率 |
| 均等オッズ | グループ間で同じTPRとFPR |
| 個人の公平性 | 類似した個人が類似した結果を得る |
| 不均衡影響 | グループ間の好ましい結果の比率(80%ルール) |
3.2. バイアスの検出
- トレーニング前:人口統計グループ間のトレーニングデータ分布を分析
- トレーニング後:グループ間のモデル予測を比較
- ランタイム:公平性指標のドリフトをライブ予測で監視
4. モデルの説明可能性
説明可能性 = モデルが特定の予測をなぜ行ったかを理解する能力。
4.1. 説明可能性のテクニック
| テクニック | タイプ | 機能 |
|---|---|---|
| SHAP(SHapley Additive exPlanations) | モデル非依存 | 各特徴量の予測への寄与を表示 |
| LIME(Local Interpretable Model-agnostic Explanations) | モデル非依存 | 局所的に近似して個別予測を説明 |
| 特徴量重要度 | モデル固有 | モデル出力への影響で特徴量をランキング |
| 注意可視化 | Transformer固有 | モデルがどのトークンに注目したかを表示 |
| 部分依存プロット | モデル非依存 | 特徴量が予測にどう影響するかを表示 |
SHAPの例:
ローン申請:否認

特徴量の寄与:
  負債比率:              +0.42(否認方向に影響)
  クレジットスコア:       +0.28(否認方向に影響)
  勤続年数:              -0.15(承認方向に影響)
  ローン金額:             +0.08(否認方向に影響)
  年齢:                  -0.03(中立)
                         ─────────────
  ベース(平均予測):      0.45
  最終予測:              0.45 + 0.42 + 0.28 - 0.15 + 0.08 - 0.03 = 1.05 → 否認
試験のポイント:「MLモデルがローン申請を否認した理由を説明するには?」→ SHAP値 — 個別予測への各特徴量の寄与を示します。AWSではSageMaker Clarifyがこれを提供します。
5. AIにおける透明性
5.1. AWS AIサービスカード
AIサービスカードはAWSが公開するドキュメントで、AWS AIサービスについての透明性を提供します:
- 想定されるユースケース:サービスが設計された用途
- 制限事項:既知の限界と障害モード
- 設計の選択:モデルの構築方法
- ベストプラクティス:推奨される使用パターン
- 公平性に関する考慮事項:既知の人口統計グループ間のパフォーマンス差異
対象サービス:Amazon Rekognition、Textract、Comprehend、Transcribe等。
5.2. モデルカード
モデルカード(SageMaker)は自社モデル用に作成する内部ドキュメントです:
- モデルの説明と想定される使用方法
- トレーニングデータの詳細
- サブグループ間のパフォーマンス指標
- 倫理的考慮事項
- 制限事項とリスク
5.3. 透明性のベストプラクティス
| プラクティス | 方法 |
|---|---|
| AIの使用を開示 | ユーザーがAIと対話していることを伝える |
| ソースの帰属 | RAGアプリケーションでソースを引用 |
| 信頼度スコア | モデルの信頼度をユーザーに表示 |
| 制限事項の開示 | モデルができないことを文書化 |
| ウォーターマーク | AI生成コンテンツにマークを付ける(画像、テキスト) |
6. 毒性と有害コンテンツ
有害コンテンツの種類:
- ヘイトスピーチ:保護対象グループを標的としたコンテンツ
- 暴力:暴力的または暴力を助長するコンテンツ
- 性的コンテンツ:露骨または不適切なコンテンツ
- 自傷行為:自傷行為や自殺を助長するコンテンツ
- 偽情報:事実として提示される誤った情報
- プロンプトインジェクション:システム指示を上書きする悪意あるプロンプト
緩和策:
- コンテンツフィルタ:自動検出とブロック(Bedrock Guardrails)
- 人間のレビュー:高リスクコンテンツに対するヒューマンインザループ
- 入力のサニタイズ:ユーザー入力の検証とサニタイズ
- 出力のフィルタリング:ユーザーに表示する前にモデル出力をチェック
- レッドチーミング:デプロイ前の敵対的テスト
7. 練習問題
Q1:採用AIシステムが、同等の資格を持つ女性候補者よりも男性候補者を一貫して高く評価しています。最も可能性の高いバイアスの種類はどれですか?
- A) 測定バイアス
- B) トレーニングデータの選択バイアス ✓
- C) 確証バイアス
- D) 想起バイアス
解説:トレーニングデータに男性候補者を優遇する過去の採用決定が含まれていた場合、モデルはその選択バイアスを学習し再現します。トレーニングデータが有資格者の母集団を公平に代表していませんでした。
Q2:銀行が規制当局から、各ローン申請が承認または否認された理由の説明を求められています。予測ごとの説明を提供できるAWSサービス機能はどれですか?
- A) Amazon Bedrock Guardrails
- B) SHAP値を使用したAmazon SageMaker Clarify ✓
- C) Amazon Comprehendの感情分析
- D) AWS AIサービスカード
解説:SageMaker Clarifyは、個別予測への各特徴量の寄与を示すSHAP値を計算し、規制当局が要求する説明可能性を提供します。
Q3:AWS AIサービスの想定されるユースケース、制限事項、公平性に関する考慮事項についての公開ドキュメントを提供するAWSリソースはどれですか?
- A) SageMakerモデルカード
- B) AWS AIサービスカード ✓
- C) Amazon Bedrockモデル評価
- D) AWS Trusted Advisor
解説:AWS AIサービスカードは、Rekognition、Textract、ComprehendなどのAWS AIサービスの設計、制限事項、ベストプラクティスについての透明性を提供する公開ドキュメントです。モデルカードは自社のカスタムモデル用です。