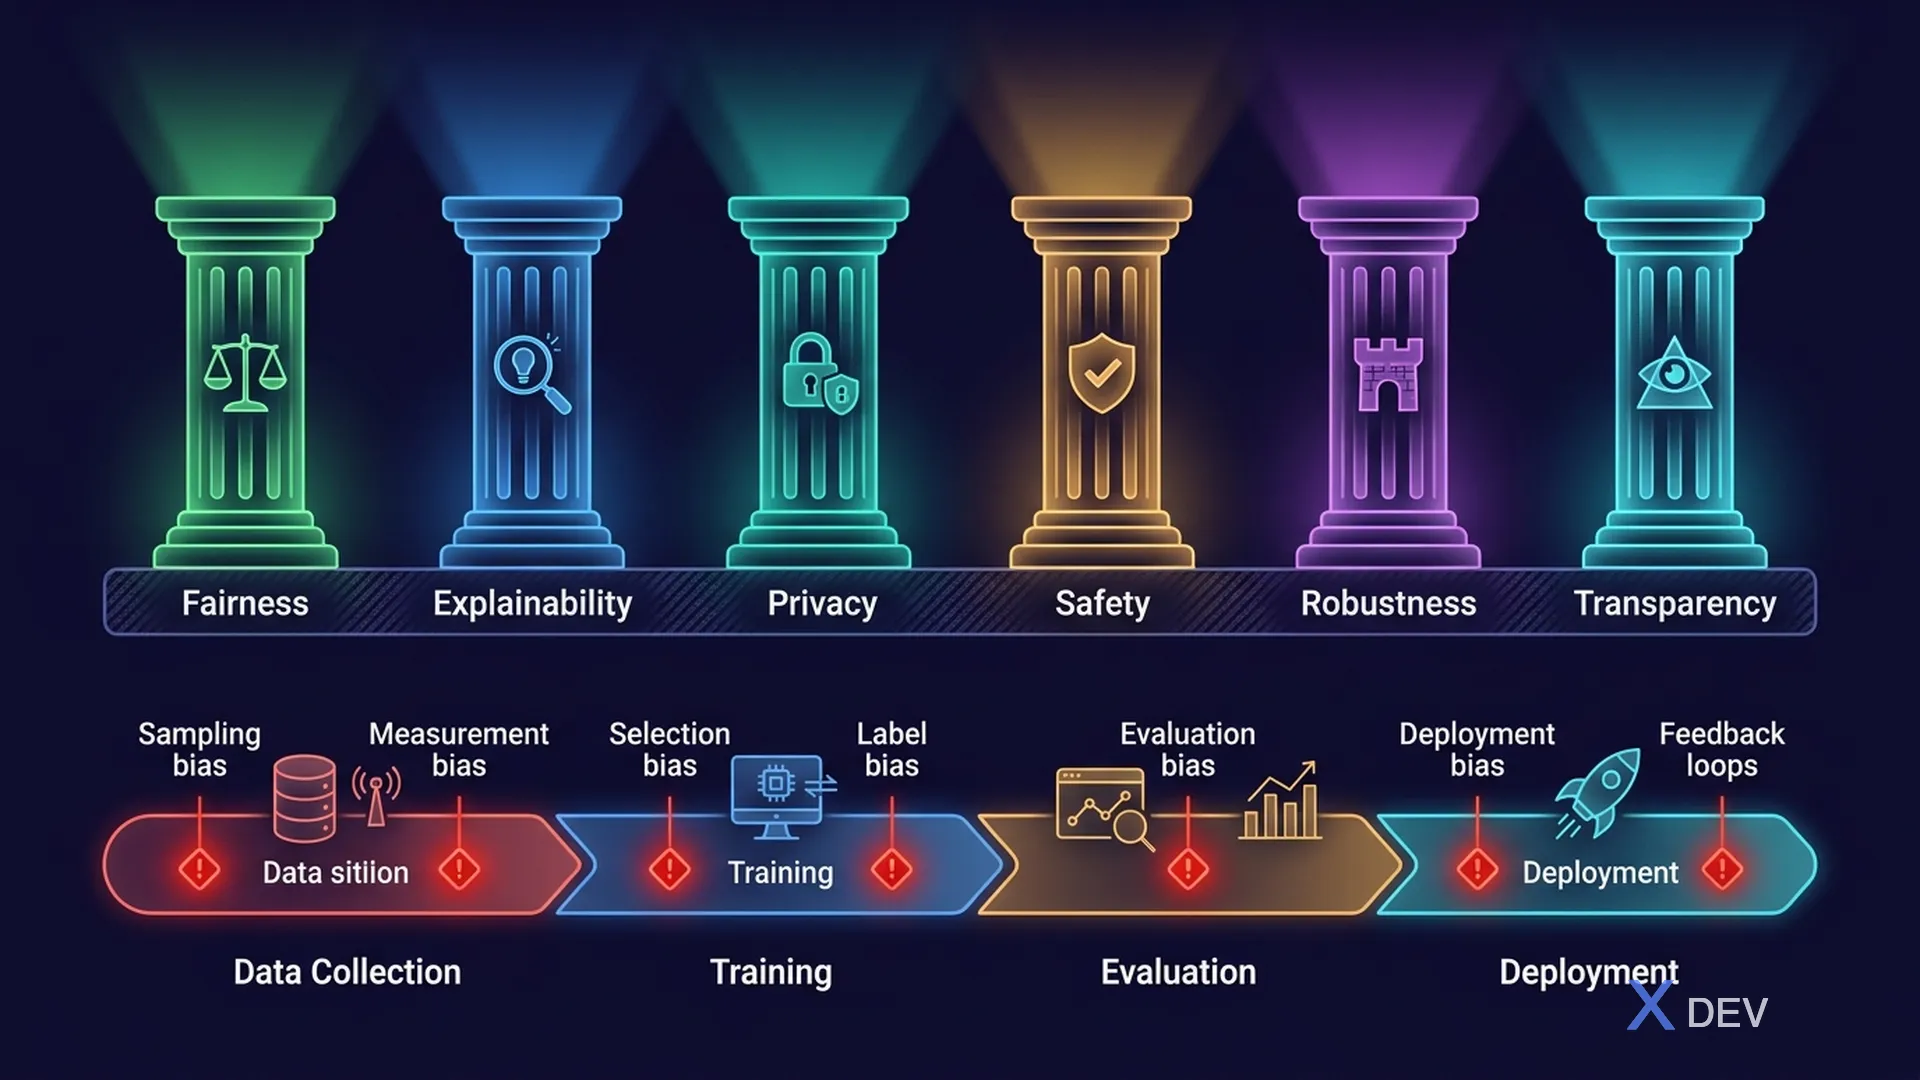
負責任AI支柱與ML管線中的偏差進入點
1. 什麼是負責任AI?
負責任AI是一個確保AI系統以道德、公平、透明和負責的方式開發和使用的框架。
1.1. 負責任AI的支柱
| 支柱 | 定義 | 範例 |
|---|---|---|
| 公平性 | 公平對待所有群體 | 貸款審核模型不因種族而歧視 |
| 可解釋性 | 理解模型為何做出該決策 | 「您的貸款被拒是因為負債收入比 > 0.5」 |
| 透明度 | 清楚說明AI的能力與限制 | 當內容是AI生成時予以揭露 |
| 隱私 | 保護個人資料 | 未經同意不在PII上訓練 |
| 安全性 | 防止有害輸出 | 內容過濾器、防護機制 |
| 穩健性 | 在對抗條件下仍可靠 | 抵禦提示注入攻擊 |
| 治理 | 監督和問責 | 對高風險決策進行人工審查 |
2. 理解AI中的偏差
2.1. 偏差的類型
| 偏差類型 | 內容 | 範例 |
|---|---|---|
| 選擇偏差 | 訓練資料無法代表總體 | 招聘模型僅用科技公司資料訓練 |
| 衡量偏差 | 資料收集不一致 | 不同人口群體的影像品質不同 |
| 確認偏差 | 模型強化現有模式 | 推薦系統只展示使用者已喜歡的內容 |
| 標記偏差 | 人工標記員引入偏差 | 不同標註者之間情感標記不一致 |
| 演算法偏差 | 模型架構放大偏差 | 最佳化準確率偏向多數群體 |
| 回憶偏差 | 過度代表的歷史模式 | 某些地區有更多逮捕資料→預測該地區犯罪更多 |
| 抽樣偏差 | 非隨機資料收集 | 線上調查遺漏年長族群 |
2.2. 偏差在ML生命週期中的進入點
資料收集        資料處理        模型訓練        評估          部署
  ↓                ↓               ↓             ↓            ↓
選擇偏差        特徵工程       演算法偏差       評估          回饋
抽樣偏差        缺失值         最佳化           指標偏差      迴路偏差
衡量偏差        編碼選擇       目標函數                       使用者偏差
考試提示:「偏差可以在ML管線的哪個階段被引入?」→ 每個階段——資料收集、預處理、模型訓練、評估和部署。這就是為什麼在整個生命週期中進行監控至關重要。
3. 公平性指標
3.1. 關鍵公平性概念
| 概念 | 定義 |
|---|---|
| 人口統計均等 | 各群體以相同比率獲得正面結果 |
| 機會均等 | 各群體之間真陽性率相等 |
| 均等化勝算 | 各群體之間TPR和FPR相等 |
| 個體公平性 | 相似的個體獲得相似的結果 |
| 差異性影響 | 群體間正面結果的比率(80%規則) |
3.2. 偵測偏差
- 訓練前:分析訓練資料在各人口群體中的分佈
- 訓練後:比較模型在各群體中的預測
- 執行時:監控即時預測中公平性指標的漂移
4. 模型可解釋性
可解釋性 = 理解模型為什麼做出特定預測的能力。
4.1. 可解釋性技術
| 技術 | 類型 | 功能 |
|---|---|---|
| SHAP(SHapley Additive exPlanations) | 模型無關 | 顯示每個特徵對預測的貢獻 |
| LIME(Local Interpretable Model-agnostic Explanations) | 模型無關 | 透過局部近似來解釋個別預測 |
| 特徵重要性 | 模型特定 | 按影響力排名特徵 |
| 注意力視覺化 | Transformer特定 | 顯示模型關注了哪些token |
| 部分依賴圖 | 模型無關 | 顯示特徵如何影響預測 |
SHAP 範例:
貸款申請:拒絕

特徵貢獻:
  負債收入比:           +0.42(推向拒絕)
  信用評分:             +0.28(推向拒絕)
  工作年資:             -0.15(推向核准)
  貸款金額:             +0.08(推向拒絕)
  年齡:                 -0.03(中性)
                        ─────────────
  基準(平均預測):      0.45
  最終預測:             0.45 + 0.42 + 0.28 - 0.15 + 0.08 - 0.03 = 1.05 → 拒絕
考試提示:「如何解釋ML模型為何拒絕貸款申請?」→ SHAP值——顯示每個特徵對個別預測的貢獻。AWS上的SageMaker Clarify提供此功能。
5. AI中的透明度
5.1. AWS AI Service Cards
AI Service Cards是AWS提供的公開文件,為AWS AI服務提供透明度:
- 預期用途:服務設計的用途
- 限制:已知的限制和故障模式
- 設計選擇:模型如何建構
- 最佳實踐:建議的使用模式
- 公平性考量:已知的人口群體效能差異
適用於:Amazon Rekognition、Textract、Comprehend、Transcribe等。
5.2. 模型卡片
模型卡片(來自SageMaker)是你為自己的模型建立的內部文件:
- 模型描述和預期用途
- 訓練資料詳情
- 各子群體的效能指標
- 倫理考量
- 限制和風險
5.3. 透明度最佳實踐
| 實踐 | 方式 |
|---|---|
| 揭露AI使用 | 告知使用者他們正在與AI互動 |
| 來源標註 | 在RAG應用程式中引用來源 |
| 信心分數 | 向使用者展示模型的信心程度 |
| 限制揭露 | 記錄模型不能做的事情 |
| 浮水印 | 標記AI生成的內容(圖像、文字) |
6. 毒性與有害內容
有害內容的類型:
- 仇恨言論:針對受保護群體的內容
- 暴力:血腥或宣揚暴力
- 色情內容:露骨或不當
- 自我傷害:宣揚自殘或自殺
- 錯誤資訊:以事實方式呈現的不正確內容
- 提示注入:覆蓋系統指令的惡意提示
緩解策略:
- 內容過濾器:自動偵測和封鎖(Bedrock Guardrails)
- 人工審查:高風險內容採用人在迴路
- 輸入清理:驗證和清理使用者輸入
- 輸出過濾:在向使用者展示之前檢查模型輸出
- 紅隊測試:部署前的對抗性測試
7. 練習題
Q1:一個招聘AI系統持續將男性候選人排名高於同等資格的女性候選人。最可能存在哪種類型的偏差?
- A) 衡量偏差
- B) 訓練資料中的選擇偏差 ✓
- C) 確認偏差
- D) 回憶偏差
解說:如果訓練資料包含偏向男性候選人的歷史招聘決策,模型就會學習並複製該選擇偏差。訓練資料未能公平地代表合格人口。
Q2:一家銀行被監管機構要求解釋每筆貸款申請被核准或拒絕的原因。哪個AWS服務功能可以提供每次預測的解釋?
- A) Amazon Bedrock Guardrails
- B) 帶有SHAP值的Amazon SageMaker Clarify ✓
- C) Amazon Comprehend情感分析
- D) AWS AI Service Cards
解說:SageMaker Clarify計算SHAP值,顯示每個特徵對個別預測的貢獻,提供監管機構所需的可解釋性。
Q3:哪個AWS資源提供關於AWS AI服務預期用途、限制和公平性考量的公開文件?
- A) SageMaker模型卡片
- B) AWS AI Service Cards ✓
- C) Amazon Bedrock Model Evaluation
- D) AWS Trusted Advisor
解說:AWS AI Service Cards是公開文件,提供AWS AI服務(如Rekognition、Textract和Comprehend)的設計、限制和最佳實踐的透明度。模型卡片是用於你自己的自訂模型。