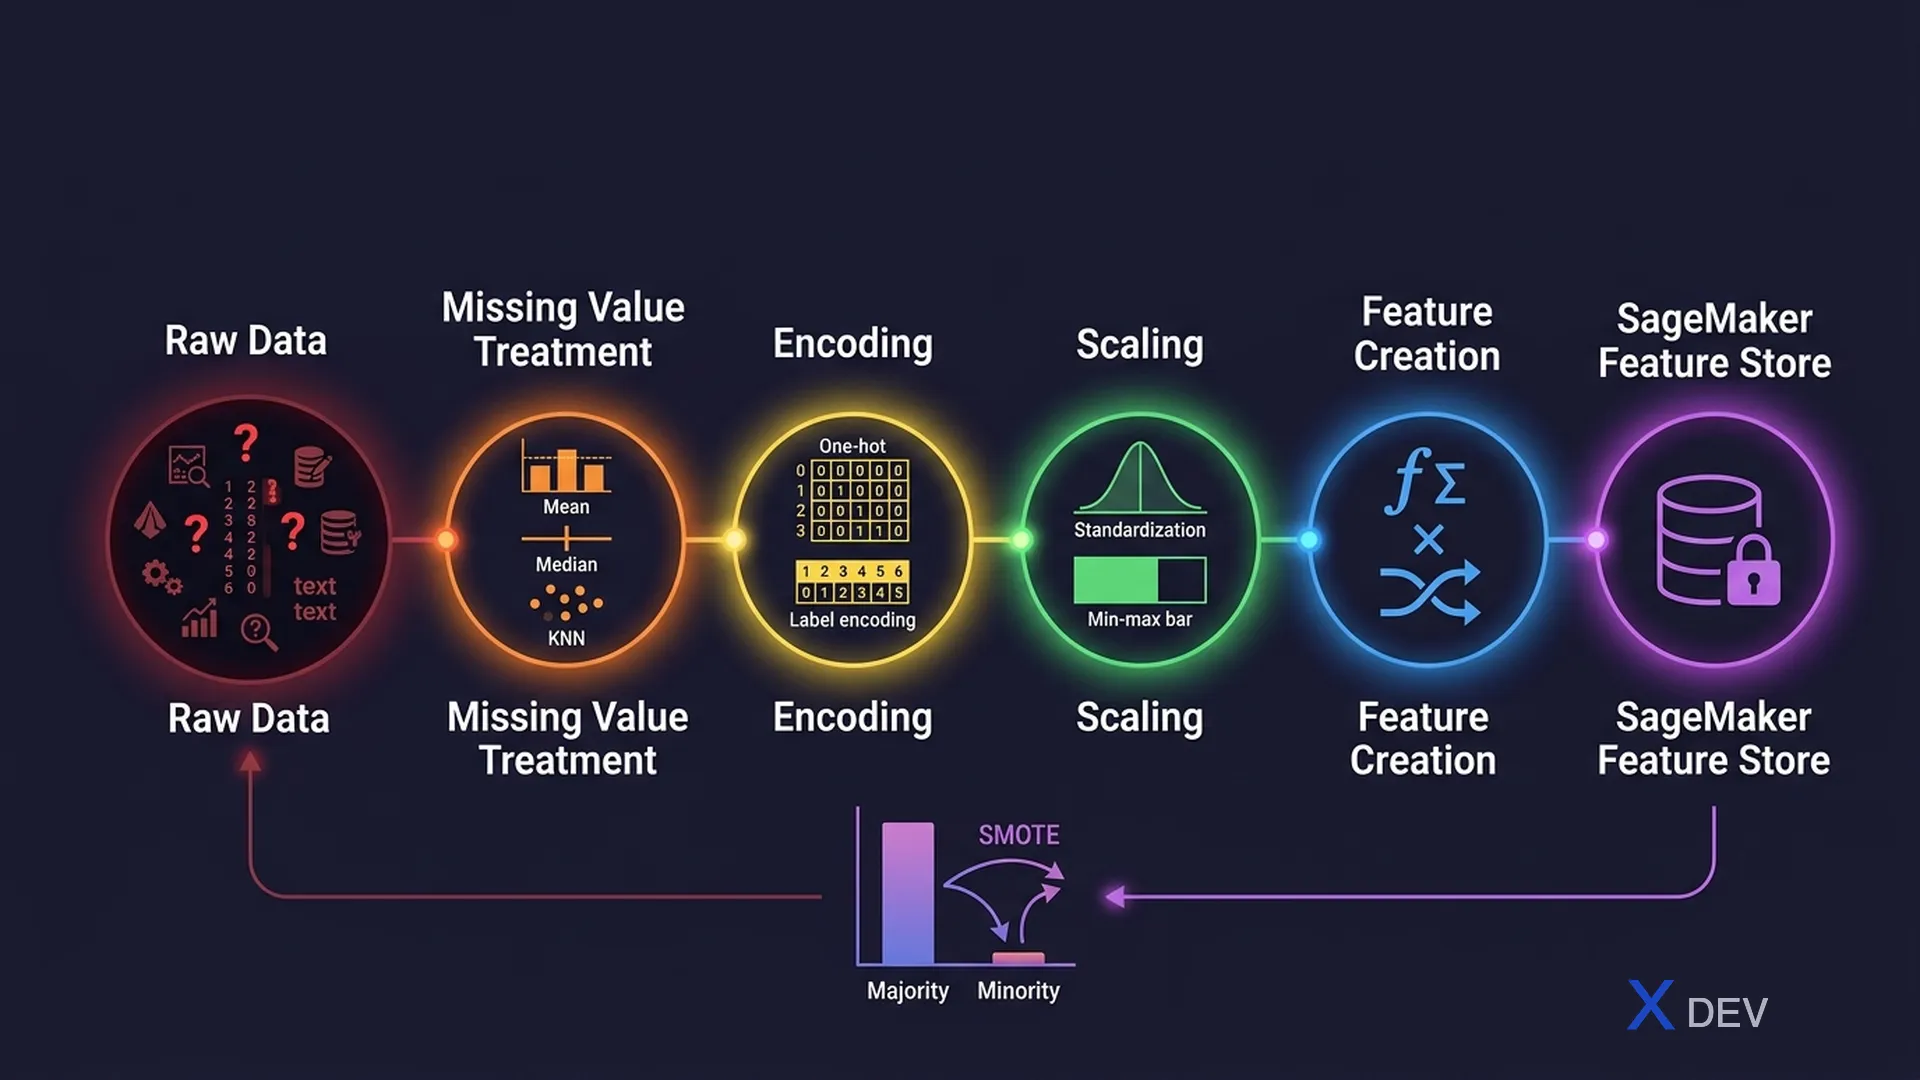
特徴量エンジニアリングとデータ変換:Glue、SageMaker Data Wrangler、欠損値処理
1. MLパイプラインにおけるデータ変換
モデル訓練の前に、生データは多くの変換ステップを経る必要があります。有名な格言「Garbage in, garbage out」の所以です。MLS-C01試験ではデータ処理技術と適切なツールについて頻繁に出題されます。
2. SageMaker Processing Jobs
SageMaker Processing Jobsは、エフェメラルなコンピュートクラスター上でデータ処理スクリプト(Python、Spark)を実行するマネージドサービスです。
| プロセッサータイプ | フレームワーク | ユースケース |
|---|---|---|
| ScriptProcessor | カスタムDockerコンテナ | 任意のカスタムスクリプト |
| SKLearnProcessor | scikit-learn | 従来のML前処理 |
| PySparkProcessor | Apache Spark | 大規模分散処理 |
| FrameworkProcessor | TensorFlow/PyTorch | ディープラーニングデータ準備 |
SageMaker Processing Job Flow:

S3 (input data)
      ↓
┌─────────────────────┐
│  Processing Job     │
│  (compute cluster)  │
│                     │
│  - Preprocess data  │
│  - Feature engineer │
│  - Split train/test │
└─────────────────────┘
      ↓
S3 (output: train/, validation/, test/)
3. 欠損値の処理
| 戦略 | 方法 | 使用場面 |
|---|---|---|
| 削除 | 行/列の削除 | MCAR、欠損が少ない(<5%) |
| 平均/中央値補完 | 平均値で補完 | 数値、MCAR/MAR |
| 最頻値補完 | 最も頻繁な値で補完 | カテゴリカル |
| KNN補完 | 最近傍K個を使用 | データにパターンがあり、大きすぎない場合 |
| モデルベース(MICE) | 多重代入法 | 複雑な欠損パターン |
| インジケーター特徴量 | is_missing列を追加 | 欠損自体に情報がある場合 |
試験のヒント: 欠損データの3タイプ:MCAR(完全にランダムな欠損)— 削除が安全;MAR(ランダムな欠損)— 補完が適切;MNAR(非ランダムな欠損)— インジケーター特徴量またはドメイン知識が必要。
4. カテゴリカルエンコーディング
| エンコーディング | 方法 | 使用場面 | 問題点 |
|---|---|---|---|
| One-Hot Encoding | カテゴリごとにバイナリ列 | 名義尺度(順序なし)、カテゴリ数が少ない | 高カーディナリティ → 次元の呪い |
| Label Encoding | 0, 1, 2, 3... | 順序尺度(順序あり) | 名義尺度に偽の順序を暗示 |
| Target Encoding | カテゴリごとのターゲット平均 | 高カーディナリティの名義尺度 | 注意しないとデータリーケージのリスク |
| Embeddings | 密なベクトル表現 | テキスト、高カーディナリティ | 学習に十分なデータが必要 |
5. 正規化とスケーリング
| テクニック | 式 | 出力範囲 | 最適な用途 |
|---|---|---|---|
| Min-Max正規化 | (x - min) / (max - min) | [0, 1] | ニューラルネットワーク、距離ベース |
| 標準化(Z-score) | (x - mean) / std | Mean=0, SD=1 | 線形モデル、SVM、PCA |
| Robust Scaler | (x - median) / IQR | 中心化 | 外れ値がある場合 |
| 対数変換 | log(x) | 圧縮 | 歪んだ分布 |
6. 不均衡データの処理
クラス不均衡(例:不正検知で99%が正常、1%が不正)はモデルを多数クラスに偏らせます。
| テクニック | 方法 | 方向 |
|---|---|---|
| オーバーサンプリング | 少数クラスのサンプルを複製 | ↑ 少数クラス |
| SMOTE | 合成少数オーバーサンプリング — 合成サンプル生成 | ↑ 少数クラス |
| アンダーサンプリング | 多数クラスのサンプルを削除 | ↓ 多数クラス |
| クラス重み付け | 少数クラスの誤分類をより重くペナルティ | データ変更なし |
| アンサンブル手法 | BalancedBagging、EasyEnsemble | アルゴリズムレベル |
試験のヒント: 不均衡データに適した指標:F1スコア、AUC-ROC、Precision-Recall — Accuracyは使用しない(誤解を招く)。AWS SageMaker Clarifyでクラス不均衡を検出できます。
7. SageMaker Feature Store
SageMaker Feature StoreはML特徴量を保存、共有、再利用するための一元的なリポジトリです。
Feature Store Architecture:

          Feature Groups
         ┌──────────────────────────────┐
         │  user_features               │
         │  ┌──────┬────────┬────────┐  │
         │  │ id   │ age    │ recency│  │
         │  └──────┴────────┴────────┘  │
         └──────────────────────────────┘
               ↓ writes              ↑ reads
    ┌──────────────────┐   ┌──────────────────┐
    │  Offline Store   │   │  Online Store    │
    │  (S3 - training) │   │  (DynamoDB -     │
    │  batch reads     │   │  low-latency     │
    │                  │   │  inference)      │
    └──────────────────┘   └──────────────────┘
8. チートシート — 特徴量エンジニアリング
| 問題 | 解決策 |
|---|---|
| 高カーディナリティのカテゴリカル | Target EncodingまたはEmbeddings |
| 欠損値(数値) | 中央値補完 + インジケーター特徴量 |
| 歪んだ分布 | 対数変換またはBox-Cox |
| 外れ値 | Robust Scalerまたはクリッピング/ウィンソライズ |
| 不均衡クラス | SMOTE + クラス重み付け + AUC指標 |
| チーム間での特徴量再利用 | SageMaker Feature Store |
9. 練習問題
Q1: 不正検知用データセットは98%が陰性(非不正)、2%が陽性(不正)です。モデル評価に最も適切な指標はどれですか?
- A) Accuracy
- B) R-squared
- C) AUC-ROC ✓
- D) Mean Absolute Error
解説:Accuracyは不均衡データでは誤解を招きます(すべて陰性と予測しても98%のAccuracyになる)。AUC-ROCはすべての閾値においてモデルのクラス識別能力を測定するため、不均衡な分類に理想的です。
Q2: クラス不均衡に対処するために合成サンプルを生成するテクニックはどれですか?
- A) ランダムアンダーサンプリング
- B) SMOTE(Synthetic Minority Oversampling Technique) ✓
- C) クラス重み付け
- D) 特徴量スケーリング
解説:SMOTEは既存の少数クラスサンプル間を補間して新しい合成サンプルを作成します。単純な複製ではありません。
Q3: ある企業が訓練パイプラインとリアルタイム推論サービス間でエンジニアリングされた特徴量を共有したいと考えています。これに対応するSageMaker機能はどれですか?
- A) SageMaker Processing Jobs
- B) SageMaker Experiments
- C) SageMaker Feature Store ✓
- D) SageMaker Data Wrangler
解説:SageMaker Feature Storeはオフラインストア(S3、バッチ訓練用)とオンラインストア(DynamoDBバックエンド、低レイテンシリアルタイム推論用)の両方を提供し、訓練とサービング間の特徴量の一貫性を確保します。