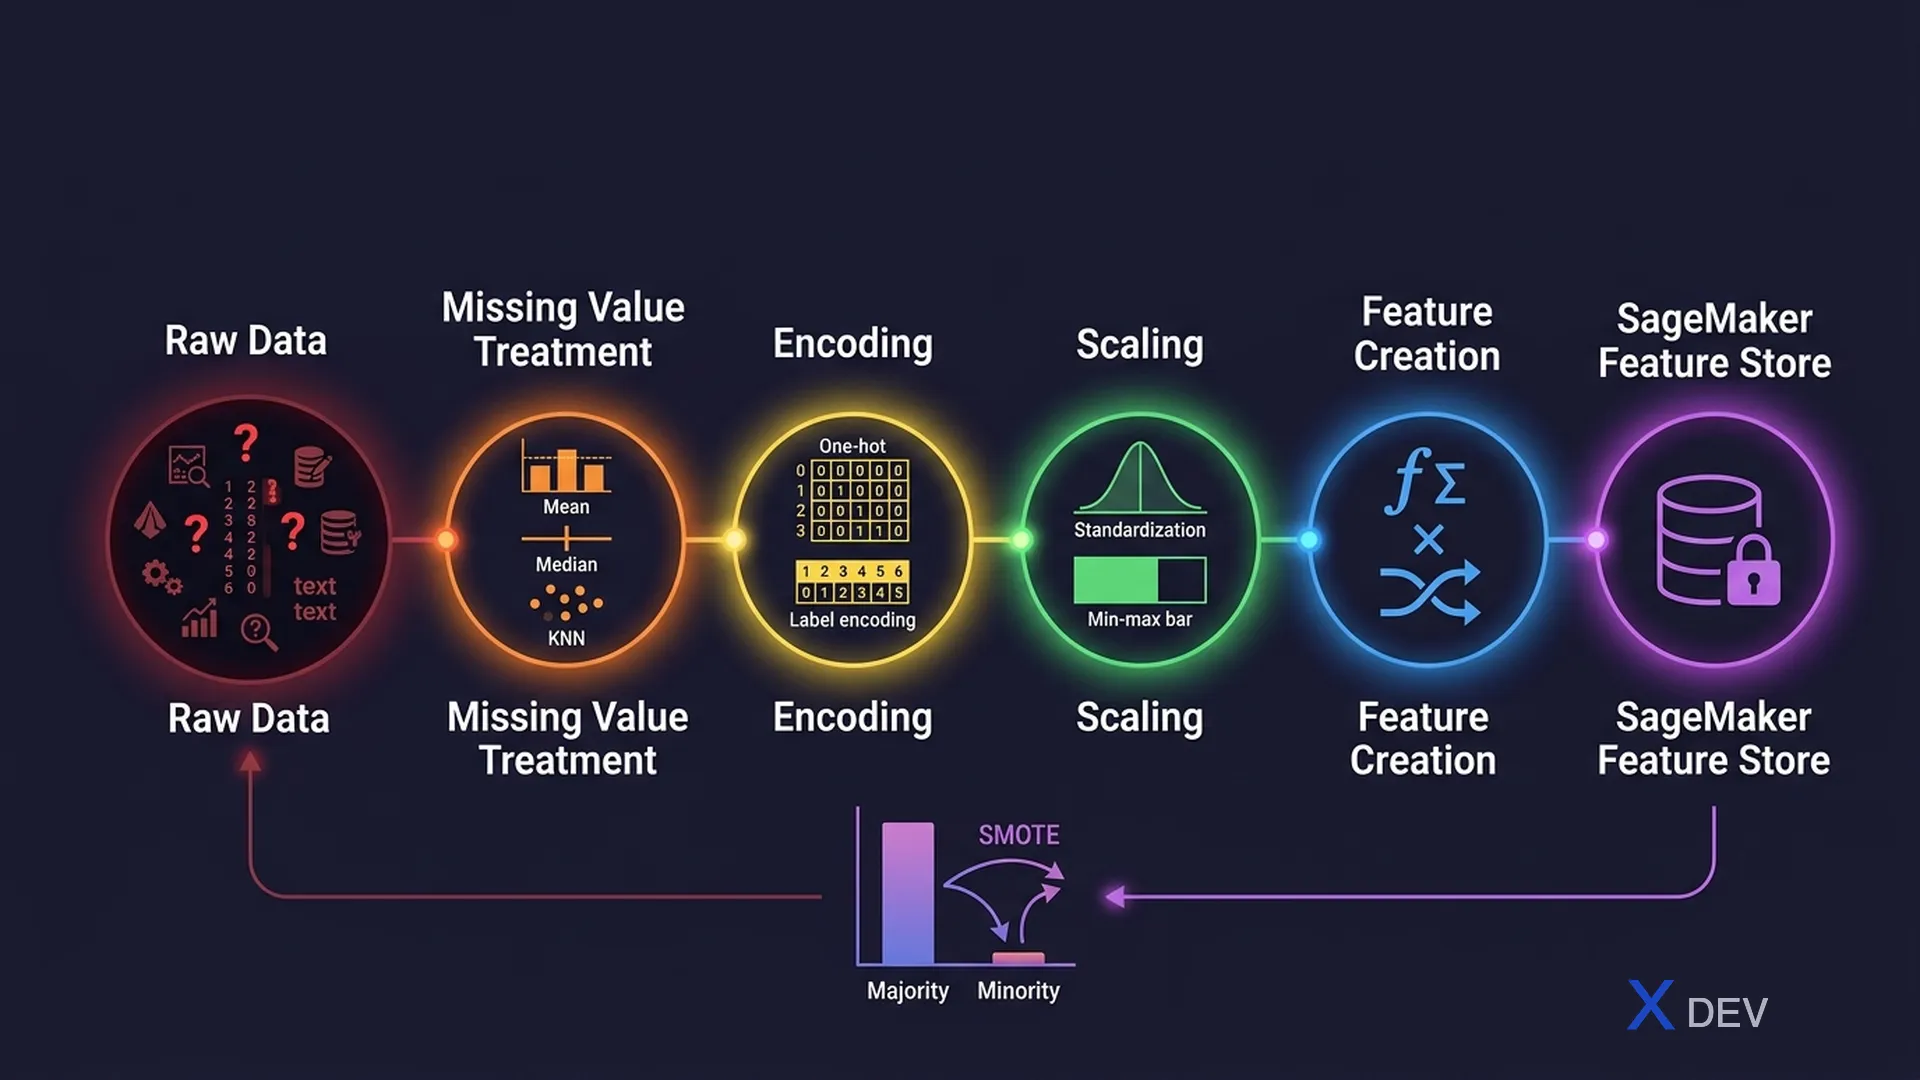
特徵工程與數據轉換:Glue、SageMaker Data Wrangler、缺失值處理
1. ML管線中的數據轉換
在模型訓練之前,原始數據需要經過許多轉換步驟。這就是著名格言「Garbage in, garbage out」的由來。MLS-C01考試經常考察數據處理技術和適當的工具。
2. SageMaker Processing Jobs
SageMaker Processing Jobs是在臨時運算叢集上執行數據處理腳本(Python、Spark)的託管服務。
| 處理器類型 | 框架 | 使用情境 |
|---|---|---|
| ScriptProcessor | 自訂Docker容器 | 任何自訂腳本 |
| SKLearnProcessor | scikit-learn | 傳統ML預處理 |
| PySparkProcessor | Apache Spark | 大規模分散式處理 |
| FrameworkProcessor | TensorFlow/PyTorch | 深度學習數據準備 |
SageMaker Processing Job Flow:

S3 (input data)
      ↓
┌─────────────────────┐
│  Processing Job     │
│  (compute cluster)  │
│                     │
│  - Preprocess data  │
│  - Feature engineer │
│  - Split train/test │
└─────────────────────┘
      ↓
S3 (output: train/, validation/, test/)
3. 缺失值處理
| 策略 | 方法 | 使用時機 |
|---|---|---|
| 刪除 | 刪除行/列 | MCAR、缺失較少(<5%) |
| 均值/中位數填補 | 用均值填補 | 數值型、MCAR/MAR |
| 眾數填補 | 用最頻繁的值填補 | 分類型 |
| KNN填補 | 使用最近的K個鄰居 | 數據有模式且不太大時 |
| 基於模型(MICE) | 多重插補法 | 複雜的缺失模式 |
| 指標特徵 | 新增is_missing列 | 缺失本身包含資訊時 |
考試提示: 缺失數據的3種類型:MCAR(完全隨機缺失)— 刪除安全;MAR(隨機缺失)— 填補合適;MNAR(非隨機缺失)— 需要指標特徵或領域知識。
4. 分類變數編碼
| 編碼 | 方法 | 使用時機 | 問題 |
|---|---|---|---|
| One-Hot Encoding | 每個類別一個二元列 | 名義尺度(無順序)、類別數少 | 高基數 → 維度災難 |
| Label Encoding | 0, 1, 2, 3... | 序數尺度(有順序) | 對名義尺度暗示虛假順序 |
| Target Encoding | 每個類別的目標均值 | 高基數名義尺度 | 不小心會造成數據洩漏風險 |
| Embeddings | 密集向量表示 | 文本、高基數 | 需要足夠的數據來學習 |
5. 正規化與縮放
| 技術 | 公式 | 輸出範圍 | 最適用途 |
|---|---|---|---|
| Min-Max正規化 | (x - min) / (max - min) | [0, 1] | 神經網路、距離為基礎 |
| 標準化(Z-score) | (x - mean) / std | Mean=0, SD=1 | 線性模型、SVM、PCA |
| Robust Scaler | (x - median) / IQR | 中心化 | 有離群值時 |
| 對數轉換 | log(x) | 壓縮 | 偏斜分佈 |
6. 不平衡數據處理
類別不平衡(例如:欺詐檢測中99%正常、1%欺詐)會使模型偏向多數類別。
| 技術 | 方法 | 方向 |
|---|---|---|
| 過採樣 | 複製少數類別樣本 | ↑ 少數類別 |
| SMOTE | 合成少數過採樣 — 產生合成樣本 | ↑ 少數類別 |
| 欠採樣 | 刪除多數類別樣本 | ↓ 多數類別 |
| 類別權重 | 對少數類別的誤分類施加更重的懲罰 | 不改變數據 |
| 集成方法 | BalancedBagging、EasyEnsemble | 演算法層級 |
考試提示: 不平衡數據適用的指標:F1分數、AUC-ROC、Precision-Recall — 不要使用Accuracy(會誤導)。AWS SageMaker Clarify可檢測類別不平衡。
7. SageMaker Feature Store
SageMaker Feature Store是儲存、共享和重複使用ML特徵的集中式儲存庫。
Feature Store Architecture:

          Feature Groups
         ┌──────────────────────────────┐
         │  user_features               │
         │  ┌──────┬────────┬────────┐  │
         │  │ id   │ age    │ recency│  │
         │  └──────┴────────┴────────┘  │
         └──────────────────────────────┘
               ↓ writes              ↑ reads
    ┌──────────────────┐   ┌──────────────────┐
    │  Offline Store   │   │  Online Store    │
    │  (S3 - training) │   │  (DynamoDB -     │
    │  batch reads     │   │  low-latency     │
    │                  │   │  inference)      │
    └──────────────────┘   └──────────────────┘
8. 速查表 — 特徵工程
| 問題 | 解決方案 |
|---|---|
| 高基數的分類變數 | Target Encoding或Embeddings |
| 缺失值(數值) | 中位數填補 + 指標特徵 |
| 偏斜分佈 | 對數轉換或Box-Cox |
| 離群值 | Robust Scaler或裁剪/Winsorize |
| 不平衡類別 | SMOTE + 類別權重 + AUC指標 |
| 團隊間特徵重複使用 | SageMaker Feature Store |
9. 練習題
Q1: 欺詐檢測數據集中98%為陰性(非欺詐)、2%為陽性(欺詐)。最適合用於模型評估的指標是哪個?
- A) Accuracy
- B) R-squared
- C) AUC-ROC ✓
- D) Mean Absolute Error
解析:Accuracy對不平衡數據會產生誤導(全部預測為陰性也能達到98% Accuracy)。AUC-ROC在所有閾值下衡量模型區分類別的能力,是不平衡分類的理想指標。
Q2: 哪種技術通過產生合成樣本來解決類別不平衡?
- A) 隨機欠採樣
- B) SMOTE(Synthetic Minority Oversampling Technique) ✓
- C) 類別權重
- D) 特徵縮放
解析:SMOTE通過在現有少數類別樣本之間進行插值來建立新的合成樣本,而非簡單複製。
Q3: 一家公司希望在訓練管線和即時推論服務之間共享工程特徵。哪個SageMaker功能可以實現?
- A) SageMaker Processing Jobs
- B) SageMaker Experiments
- C) SageMaker Feature Store ✓
- D) SageMaker Data Wrangler
解析:SageMaker Feature Store提供離線儲存(S3、用於批次訓練)和線上儲存(DynamoDB後端、用於低延遲即時推論),確保訓練和服務之間特徵的一致性。