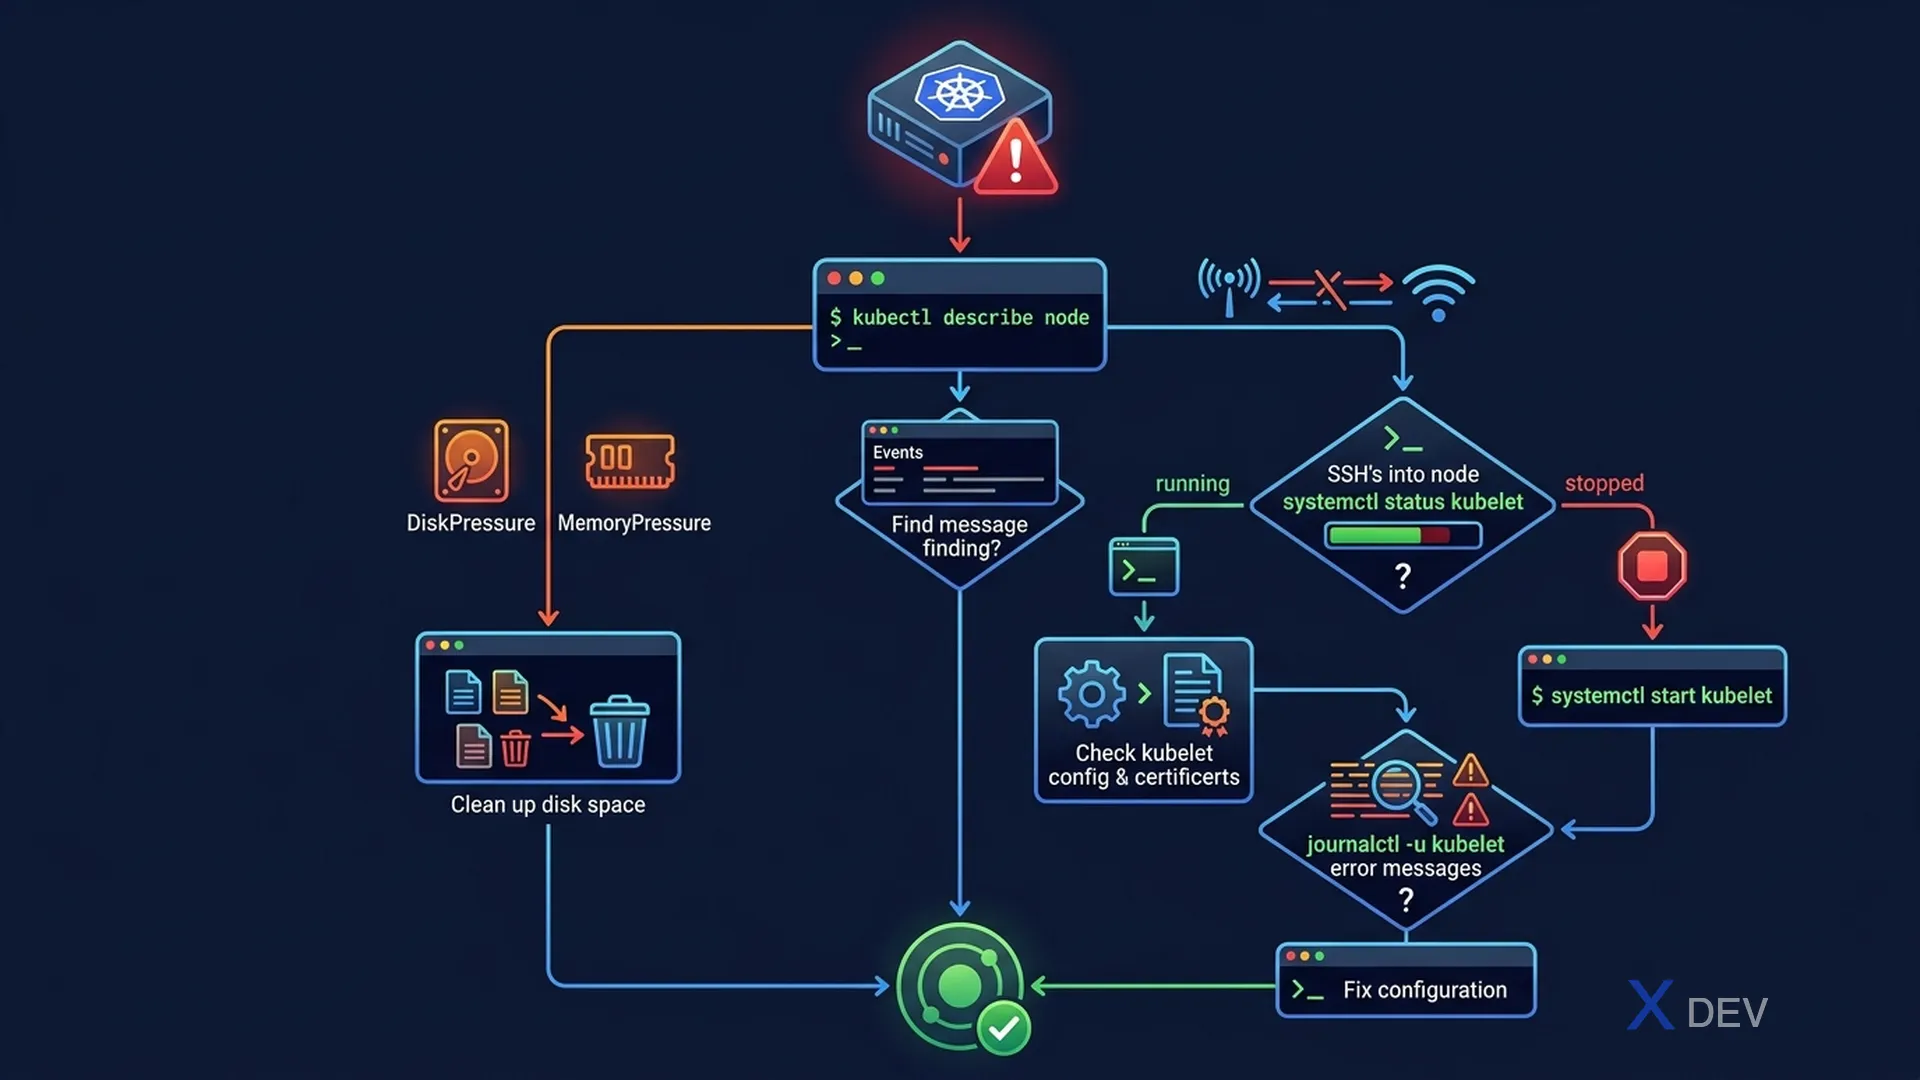
1. ノード条件
kubectl describe node node1 | grep -A20 Conditions

正常状態:
  Type              Status
  ----              ------
  MemoryPressure    False   ← 正常(True = メモリ不足)
  DiskPressure      False   ← 正常(True = ディスク不足)
  PIDPressure       False   ← 正常(True = プロセス過多)
  Ready             True    ← ノードは正常

異常状態:
  Ready             False   → kubeletが動作していない
  Ready             Unknown → ノードに到達できない(ネットワーク問題)
2. NotReadyノードのトラブルシューティング
体系的なアプローチ — 順番に実行:

1. ノード状態の確認
   kubectl get nodes
   kubectl describe node NODE_NAME | tail -40

2. ノードにSSH
   ssh node1

3. kubeletサービスの確認
   systemctl status kubelet
   journalctl -u kubelet -n 50 --no-pager

4. コンテナランタイムの確認
   systemctl status containerd
   crictl ps           # 実行中のコンテナ一覧
   crictl pods         # Podサンドボックス一覧

5. 証明書の確認(クラスタ経過時間による一般的な問題)
   ls /var/lib/kubelet/pki/
   openssl x509 -in /var/lib/kubelet/pki/kubelet.crt -noout -dates

6. 必要に応じてサービスを再起動
   systemctl restart kubelet
systemctl restart containerd試験のポイント:NotReadyデバッグ手順:
kubectl describe node→ SSH →systemctl status kubelet→journalctl -u kubelet。最も一般的な問題:kubelet停止、APIサーバーアドレスの誤り、証明書の期限切れ。
3. 一般的なノード問題
| 症状 | 原因 | 対処法 |
|---|---|---|
| Node NotReady | kubeletクラッシュ | systemctl restart kubelet |
| Node Unknown | ネットワーク分断 | ノードネットワーク、ファイアウォールを確認 |
| MemoryPressure: True | メモリ不足 | Podの退避、ノードのスケール |
| DiskPressure: True | ディスク満杯 | /var/log、/tmp、未使用イメージのクリーンアップ |
| Pods stuck Terminating | ノード到達不可 | kubectl delete pod --force --grace-period=0 |
4. kubelet設定
# kubelet設定ファイルの場所
/var/lib/kubelet/config.yaml     # メイン設定
/etc/kubernetes/kubelet.conf     # kubeconfig(kubeletのAPIサーバー接続方法)
/var/lib/kubelet/kubeconfig      # 代替パス

# 一般的なkubelet設定問題:
# APIサーバーアドレスの誤り
cat /etc/kubernetes/kubelet.conf | grep server

# クラスタDNSの誤り
cat /var/lib/kubelet/config.yaml | grep clusterDNS

# kubeletの証明書確認
cat /var/lib/kubelet/config.yaml | grep client-certificate
5. ノードイメージ & ディスククリーンアップ
# ディスク使用量の確認
df -h
du -sh /var/log/*
du -sh /var/lib/containerd

# 未使用コンテナイメージの削除
crictl rmi --prune

# 古いログの削除
find /var/log/pods -mtime +7 -delete

# PIDプレッシャーの確認
ps aux | wc -l
6. チートシート
| タスク | コマンド |
|---|---|
| ノード健全性サマリー | kubectl describe node NAME |
| kubelet状態 | systemctl status kubelet |
| kubeletログ | journalctl -u kubelet -n 100 |
| ノード上の実行コンテナ | crictl ps |
| スタックしたPodの強制削除 | kubectl delete pod NAME --force --grace-period=0 |
7. 練習問題
Q1:ノードが「Ready: Unknown」ステータスを表示しています。最も可能性の高い原因は?
- A) ノード上のkubeletプロセスがクラッシュした
- B) コントロールプレーンからノードに到達できない(ネットワーク問題) ✓
- C) ノード上の全PodがOOM-killされた
- D) ノードのCPUリソースが不足している
解説:Ready: UnknownはAPIサーバーがkubeletからのハートビートを最近受信していないことを意味します。通常、ノードが到達不能(ネットワーク分断、ノードの電源OFF)であることを示します。Ready: Falseはkubeletに到達可能だが問題を報告している状態です。
Q2:NotReadyノードにSSH後、「systemctl status kubelet」で「Active: failed」と表示されます。次に確認すべきは?
- A) kubectl get pods -n kube-system
- B) journalctl -u kubelet -n 50 でエラーログを確認 ✓
- C) ノードを削除して再作成
- D) ノードでkubeadm resetを実行
解説:kubeletが失敗した場合、journalctlは詳細なエラーを表示します:証明書問題、APIサーバーURLの誤り、/var/lib/kubelet/config.yamlの不在など。kubeletのダウンを確認した後の最初の診断ステップは常にこれです。
Q3:ノードがDiskPressure: Trueを報告しています。ワークロードへの即座の影響は?
- A) 全Podが即座に削除される
- B) ノードがスケジュール不可になり、BestEffort/BurstableのPodが退避される ✓
- C) 新しいPodのスケジューリングのみが阻止される
- D) kubeletサービスが停止する
解説:ディスクプレッシャー下ではKubernetesがPod退避をトリガーします。BestEffort(リクエスト/リミットなし)から開始し、次にBurstable。GuaranteedのPodは最後に退避されます。ノードには新しいスケジューリングを防ぐTaintも付与されます。