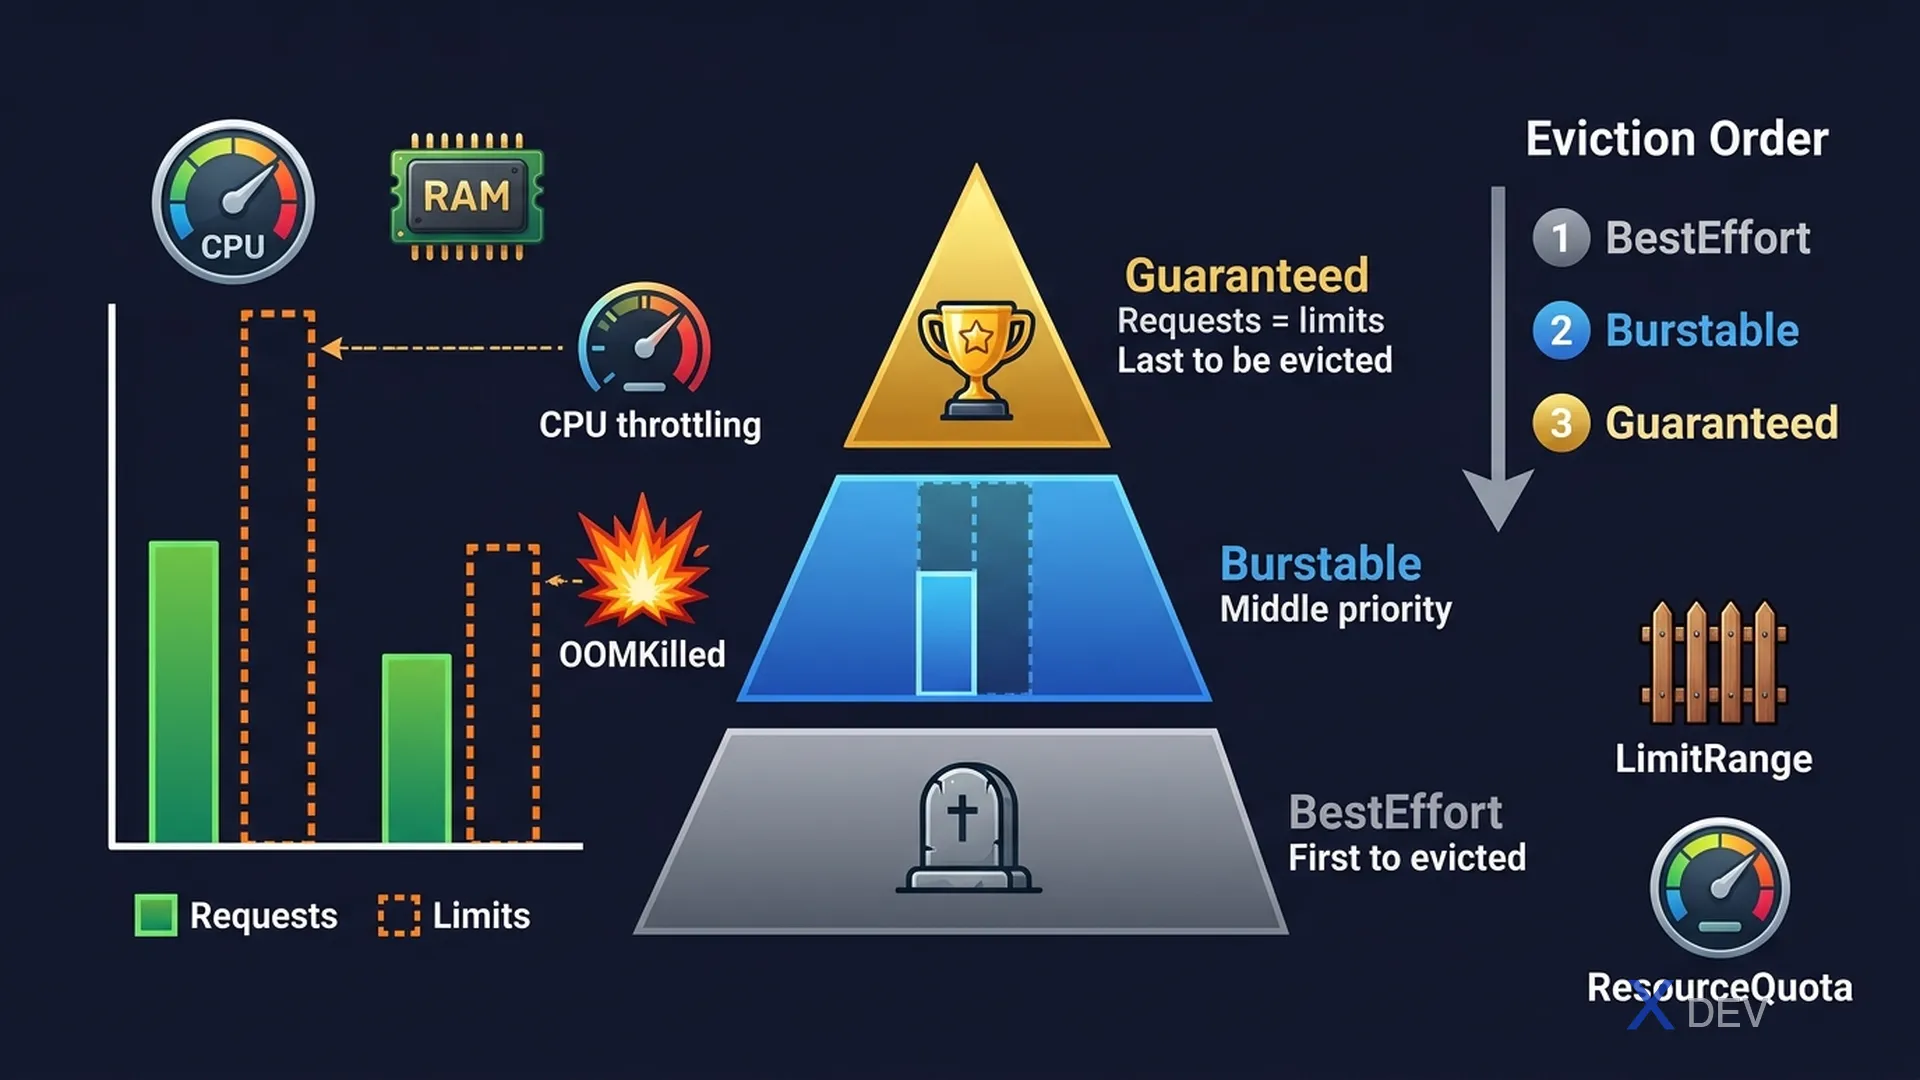
1. Requests vs Limits
resources:
  requests:
    cpu: "250m"      # 250ミリコア = 0.25 CPU(スケジューリング用)
    memory: "128Mi"  # 最小保証メモリ
  limits:
    cpu: "500m"      # 最大CPU(超過するとスロットリング、killされない)
memory: "256Mi" # 最大メモリ(超過するとOOMKilled)| リソース | Requests超過時 | Limits超過時 |
|---|---|---|
| CPU | 正常に動作(バースト) | スロットリング(速度低下、killされない) |
| メモリ | 正常に動作 | コンテナがkillされる → OOMKilled |
CPU単位:
  1 CPU = 1000m(ミリコア)
  0.5 CPU = 500m
  100m = 0.1 CPU

メモリ単位:
  Ki(キビバイト)= 1024 bytes
  Mi(メビバイト)= 1024 Ki
  Gi(ギビバイト)= 1024 Mi
  (KB/MB/GBは10進数なので異なる)
2. QoSクラス
QoS = Quality of Service(退避優先度を制御)

┌─────────────────────────────────────────────────────────┐
│  GUARANTEED — 最後に退避                                │
│  ✓ CPU requests == CPU limits                           │
│  ✓ Memory requests == Memory limits                     │
│  ✓ Pod内の全コンテナが条件を満たす必要あり              │
├─────────────────────────────────────────────────────────┤
│  BURSTABLE — 中間の優先度                               │
│  ✓ 少なくとも1つのコンテナにrequest/limitあり           │
│  ✗ Guaranteedの条件を満たさない                         │
├─────────────────────────────────────────────────────────┤
│  BESTEFFORT — 最初に退避                                │
│  ✗ request/limitが一切なし                              │
└─────────────────────────────────────────────────────────┘| QoSクラス | 条件 | 退避優先度 |
|---|---|---|
| Guaranteed | CPUとメモリ両方でrequests == limits(全コンテナ) | 最低(最後に退避) |
| Burstable | 少なくとも1つのコンテナにrequest/limitあり、Guaranteedの条件を満たさない | 中間 |
| BestEffort | request/limitが一切なし | 最高(最初に退避) |
試験のポイント: PodのQoSクラスを確認するコマンド:
kubectl describe pod <name> | grep -i qosまたはkubectl get pod <name> -o jsonpath='{.status.qosClass}'。Guaranteedを実現するには: CPUとメモリ両方でrequests = limitsを設定し、全コンテナ(initコンテナを含む)で満たす必要があります。
3. LimitRange
LimitRangeはNamespace内のPodにデフォルトのrequests/limitsを設定します — Podが自身で設定していない場合に適用されます。
apiVersion: v1
kind: LimitRange
metadata:
  name: mem-limit-range
  namespace: development
spec:
  limits:
  - type: Container
    default:          # デフォルトlimits(コンテナがlimitsを設定していない場合)
      memory: 512Mi
      cpu: 500m
    defaultRequest:   # デフォルトrequests(コンテナがrequestsを設定していない場合)
      memory: 256Mi
      cpu: 250m
    max:              # 許可される最大limits
      memory: 1Gi
      cpu: "1"
    min:              # 必要な最小requests
      memory: 64Mi
      cpu: 50m
4. ResourceQuota
apiVersion: v1
kind: ResourceQuota
metadata:
  name: production-quota
  namespace: production
spec:
  hard:
    # コンピュートリソース
    requests.cpu: "10"
    requests.memory: 20Gi
    limits.cpu: "20"
    limits.memory: 40Gi
    # オブジェクト数
    pods: "50"
    services: "20"
    persistentvolumeclaims: "10"
    secrets: "30"
    configmaps: "30"
試験のポイント: ResourceQuotaでリソースlimitsが要求されているNamespaceでは、全Podがresource requestsとlimitsを設定する必要があります。設定されていない場合、LimitRangeがデフォルトを提供する必要があります。いずれもない場合、APIサーバーがPod作成を拒否します。
5. チートシート
| シナリオ | 対処法 |
|---|---|
| コンテナがOOMKilled | limits.memoryを増加 |
| コンテナがスロットリング(遅い) | limits.cpuを増加 |
| Podがスケジュールできない | requestsを削減またはクラスターをスケール |
| QoSをGuaranteedにする | CPUとメモリでrequests == limits |
| Namespaceのデフォルトlimitsを設定 | LimitRange |
| Namespace全体のリソースを制限 | ResourceQuota |
6. 練習問題
Q1: コンテナにcpu requests=200m、cpu limits=500m、memory requests=256Mi、memory limits=256Miが設定されています。このPodのQoSクラスは何ですか(唯一のコンテナの場合)?
- A) Guaranteed
- B) Burstable ✓
- C) BestEffort
- D) Critical
解説: Guaranteedの条件は全requestsがlimitsと等しいことです。ここではcpu requests(200m) ≠ cpu limits(500m)です。Memory requestsはlimitsと等しい(256Mi)ですが、Guaranteedの条件を完全に満たしていないため、クラスはBurstableになります。
Q2: コンテナのメモリ使用量がメモリlimitsを超えました。何が起こりますか?
- A) コンテナがスロットリング(速度低下)される
- B) コンテナが終了して再起動される(OOMKilled) ✓
- C) コンテナがノードから退避される
- D) Podが別のノードにリスケジュールされる
解説: CPU(圧縮可能 — スロットリングされるがkillされない)とは異なり、メモリは非圧縮リソースです。コンテナがメモリlimitsを超過すると、OOMKilled終了コードで終了し、コンテナランタイムによって再起動されます。OOMKillが繰り返されるとCrashLoopBackOffになります。
Q3: limits.memoryの設定が必要なResourceQuotaがあるNamespaceで、リソースlimitsなしの新しいPodを作成します。何が起こりますか?
- A) Podはlimitsなしで起動する(ResourceQuotaは実行中のPodにのみ適用)
- B) LimitRangeがデフォルトを提供しない限り、APIサーバーがPodを拒否する ✓
- C) Podはデフォルトlimits 512Miで起動する
- D) ResourceQuotaがこのPodを除外するよう自動更新される
解説: ResourceQuotaでメモリlimitsをカバーしているNamespaceでは、全PodがメモリlimitsをSpecに指定する必要があります。LimitRangeがデフォルトを提供しない場合、APIサーバーがPodを拒否します。解決策: Podにlimitsを設定するか、Namespaceにdefault/defaultRequestを持つLimitRangeを作成します。