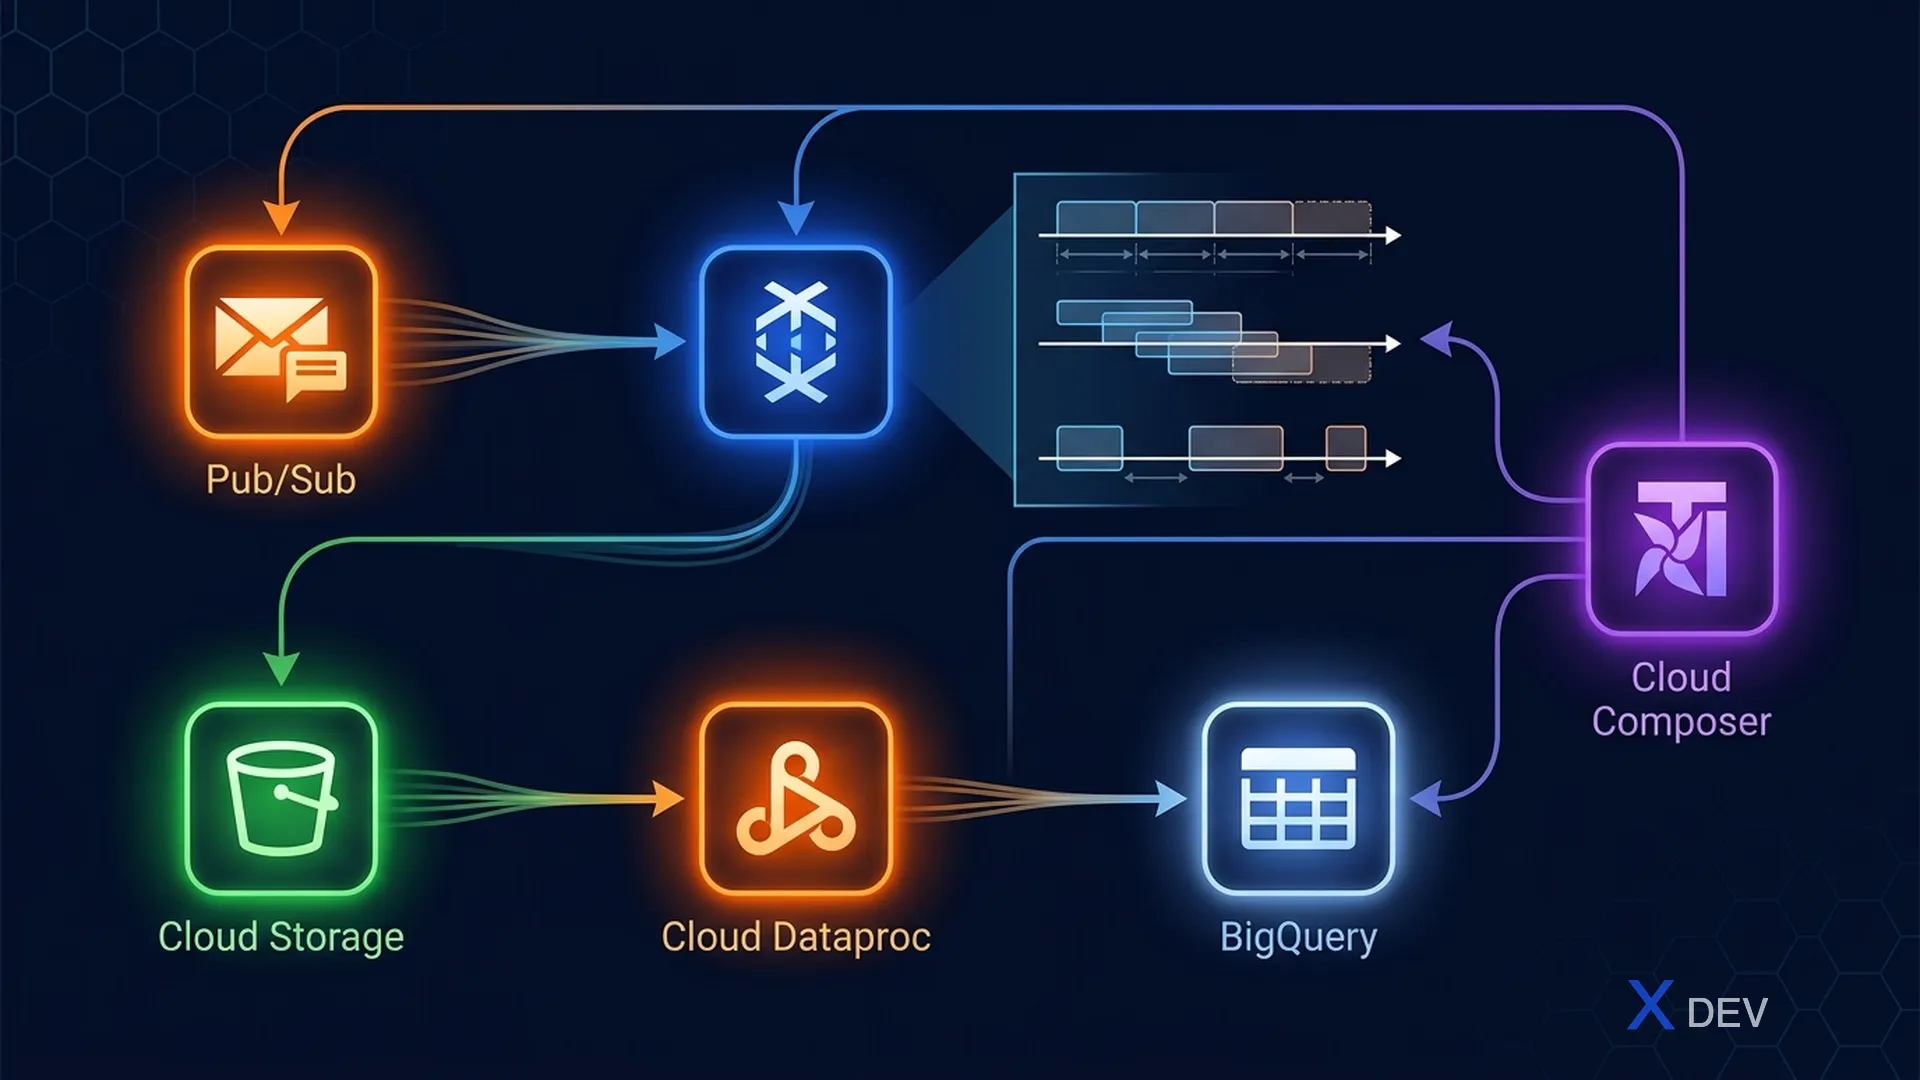
GCPデータパイプライン:Pub/Sub、Dataflow、Dataproc、Cloud ComposerとML向けデータフロー
1. GCPデータパイプラインサービス
| サービス | タイプ | 使用場面 |
|---|---|---|
| Pub/Sub | マネージドメッセージキュー | イベントストリーミング、プロデューサー/コンシューマーの分離 |
| Dataflow | マネージドApache Beamランナー | 統合バッチ + ストリーミングETL |
| Dataproc | マネージドSpark / Hadoop | 既存のSpark/Hadoopワークロード、大規模ML |
| Cloud Composer | マネージドApache Airflow | マルチステップMLワークフローのオーケストレーション |
| Cloud Storage | オブジェクトストア | 生データのランディングゾーン、モデルアーティファクト |
| BigQuery | データウェアハウス | 構造化分析、BigQuery ML |
2. Pub/Sub — イベントストリーミング
Pub/Sub Architecture:

Data Source → Publisher → [Topic] → Subscription → Subscriber
(IoT devices,                         (Pull or            (Dataflow,
web clicks,                            Push)              Cloud Functions,
logs)                                                     BigQuery)

Key concepts:
- Topic: named resource where messages are sent
- Subscription: named resource attached to topic
- Publisher: sends messages to topic
- Subscriber: receives messages from subscription
- At-least-once delivery (not exactly-once by default)
| 機能 | 詳細 |
|---|---|
| メッセージ保持期間 | デフォルト7日(設定可能) |
| At-least-once配信 | 冪等なサブスクライバーが必要 |
| Exactly-once | Pub/Sub Liteで利用可能(同一リージョン) |
| 順序付け | オーダリングキーでメッセージの順序付けを有効化 |
試験のヒント: Pub/Sub → Dataflow → BigQueryは試験で非常に頻出するパイプラインパターンです。Pub/Subで取り込み、Dataflowで変換、BigQueryで保存・分析。
3. Cloud Dataflow — Apache Beam
DataflowはApache Beamのマネージドランナーです。統合バッチ・ストリーミング処理のフレームワークで、サーバー管理は不要です。
| 概念 | 説明 |
|---|---|
| Pipeline | 一連の変換操作 |
| PCollection | 分散データコレクション(有界または無界) |
| Transform | ParDo、GroupByKey、Combine、Flatten、Partition |
| Windowing | ストリーミング用のFixed、Sliding、Sessionウィンドウ |
| Watermarks | ストリーミングでの遅延データの処理 |
Dataflow Windowing for Streaming ML:

Event stream: ──●──●──●──────●──●──●──────●──●──

Fixed Window (1 min):
├─── [W1] ──┤├─── [W2] ──┤├─── [W3] ──┤

Sliding Window (1 min, slide 30s):
├── [W1] ────┤
       ├── [W2] ────┤
              ├── [W3] ────┤

Session Window (2 min gap):
├── [S1] ──────────┤          ├── [S2] ──┤
     (user session)            (new session)
4. Cloud Dataproc — マネージドSpark/Hadoop
| Dataprocの機能 | 詳細 |
|---|---|
| クラスタライフサイクル | 90秒で作成、ジョブ後に削除 — コスト効率的 |
| エフェメラルクラスタ | 起動 → ジョブ実行 → シャットダウン(ジョブごとの課金) |
| プリエンプティブルVM | ワーカーノードに使用してコストを60-80%削減 |
| コンポーネントゲートウェイ | ブラウザからJupyter、Zeppelin、Spark UIにアクセス |
| MLライブラリ | Spark MLlib、TensorFlow on Spark(TFoS) |
5. Cloud Composer — ワークフローオーケストレーション
Cloud ComposerはマネージドApache Airflowです。データ取り込み、前処理、トレーニング、デプロイメントを含むマルチステップMLパイプラインのオーケストレーションに使用します。
Cloud Composer ML Workflow:

[DAG: daily_ml_pipeline]
   Task 1: Extract data from BigQuery
       ↓
   Task 2: Run Dataflow preprocessing job
       ↓
   Task 3: Submit Vertex AI Training Job
       ↓
   Task 4: Evaluate model metrics
       ↓ (if metrics pass threshold)
   Task 5: Deploy to Vertex AI Endpoint
6. データパイプラインサービスの選択
| シナリオ | 推奨サービス |
|---|---|
| リアルタイムイベントストリーミングの取り込み | Pub/Sub |
| 統合バッチ + ストリーミングETL(インフラ管理不要) | Dataflow(Apache Beam) |
| 既存のSparkジョブをGCPに移行 | Dataproc |
| 複雑なML DAGオーケストレーション | Cloud Composer |
| データをBigQueryにストリーミング | Pub/Sub → Dataflow → BigQuery |
| サーバーレスデータ処理(SQL) | BigQuery(SQLによるETL) |
7. 練習問題
Q1: ある企業が工場の設備から毎秒数百万のIoTセンサーイベントを受信しています。これらのイベントをリアルタイムで処理し、異常を検知し、結果をBigQueryに保存する必要があります。最も適切なパイプラインアーキテクチャはどれでしょうか?
- A) Dataproc → Spark Streaming → BigQuery
- B) Pub/Sub → Dataflow → BigQuery ✓
- C) Cloud Functions → Cloud SQL
- D) Cloud Storageへのバッチアップロード → BigQueryインポート
解説:Pub/Subは大量のストリーミングイベントを確実に取り込みます。Dataflowは Apache Beamを使用してストリームをリアルタイムで処理します(ウィンドウ処理、変換、異常検知)。BigQueryは分析用に結果を保存します。これはGCPの標準的なストリーミング分析パターンです。
Q2: データエンジニアリングチームが、MLモデルのトレーニングデータを処理する既存のApache Sparkジョブを持っています。最小限のコード変更でGCPに移行したいと考えています。どのサービスを使用すべきでしょうか?
- A) Cloud Dataflow
- B) Cloud Dataproc ✓
- C) BigQuery ETL
- D) Cloud Composer
解説:Cloud DataprocはApache Sparkをネイティブにサポートしており、既存のSparkジョブを最小限の変更でGCP上で実行できます。DataflowはApache Beam(異なるプログラミングモデル)を使用します。DataprocはSparkワークロードのリフト&シフトオプションです。
Q3: チームが、BigQueryからのデータ抽出、前処理、Vertex AIトレーニング、精度が90%を超えた場合のデプロイメントを含む日次MLパイプラインをオーケストレーションする必要があります。このワークフローオーケストレーションを処理するサービスはどれでしょうか?
- A) Vertex AI Pipelines
- B) Cloud Dataflow
- C) Cloud Composer ✓
- D) Pub/Subトリガー
解説:Cloud Composer(マネージドApache Airflow)は、複数のサービスにまたがる複雑なDAGオーケストレーション向けに設計されています。スケジューリング、条件分岐(精度が90%を超えた場合のみデプロイ)、リトライロジック、BigQuery、Dataflow、Vertex AIなどの異種サービス間のモニタリングを処理します。