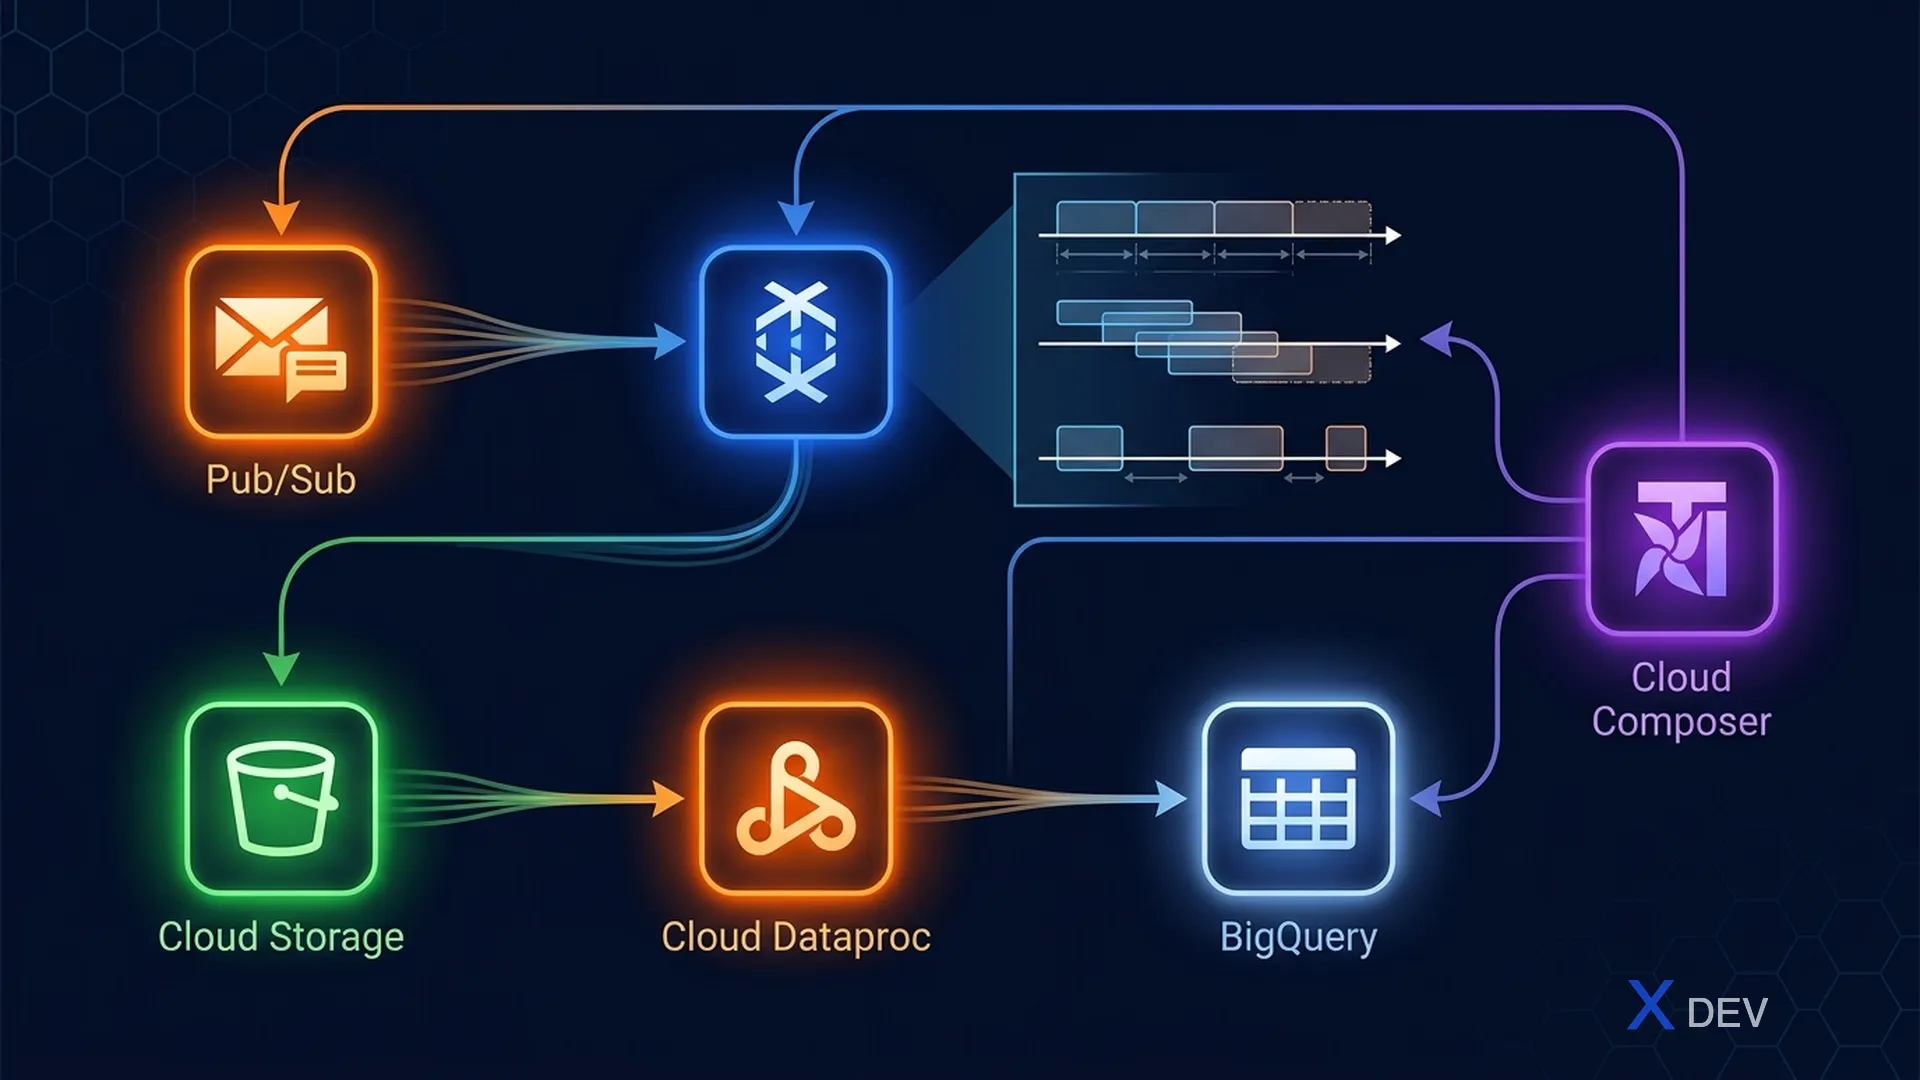
GCP資料管線:Pub/Sub、Dataflow、Dataproc、Cloud Composer與ML資料流
1. GCP資料管線服務
| 服務 | 類型 | 使用時機 |
|---|---|---|
| Pub/Sub | 託管訊息佇列 | 事件串流、解耦生產者/消費者 |
| Dataflow | 託管Apache Beam執行器 | 統一批次 + 串流ETL |
| Dataproc | 託管Spark / Hadoop | 現有Spark/Hadoop工作負載、大規模ML |
| Cloud Composer | 託管Apache Airflow | 多步驟ML工作流程的協調排程 |
| Cloud Storage | 物件儲存 | 原始資料落地區、模型成品 |
| BigQuery | 資料倉儲 | 結構化分析、BigQuery ML |
2. Pub/Sub — 事件串流
Pub/Sub Architecture:

Data Source → Publisher → [Topic] → Subscription → Subscriber
(IoT devices,                         (Pull or            (Dataflow,
web clicks,                            Push)              Cloud Functions,
logs)                                                     BigQuery)

Key concepts:
- Topic: named resource where messages are sent
- Subscription: named resource attached to topic
- Publisher: sends messages to topic
- Subscriber: receives messages from subscription
- At-least-once delivery (not exactly-once by default)
| 功能 | 詳細 |
|---|---|
| 訊息保留期間 | 預設7天(可設定) |
| At-least-once傳遞 | 需要冪等的訂閱者 |
| Exactly-once | 在Pub/Sub Lite中可用(同一區域) |
| 排序 | 使用排序金鑰啟用訊息排序 |
考試提示: Pub/Sub → Dataflow → BigQuery是考試中非常常見的管線模式。Pub/Sub負責擷取、Dataflow負責轉換、BigQuery負責儲存和分析。
3. Cloud Dataflow — Apache Beam
Dataflow是Apache Beam的託管執行器——用於統一批次和串流處理的框架,無需管理伺服器。
| 概念 | 說明 |
|---|---|
| Pipeline | 一系列轉換操作 |
| PCollection | 分散式資料集合(有界或無界) |
| Transform | ParDo、GroupByKey、Combine、Flatten、Partition |
| Windowing | 串流用的Fixed、Sliding、Session視窗 |
| Watermarks | 處理串流中遲到的資料 |
Dataflow Windowing for Streaming ML:

Event stream: ──●──●──●──────●──●──●──────●──●──

Fixed Window (1 min):
├─── [W1] ──┤├─── [W2] ──┤├─── [W3] ──┤

Sliding Window (1 min, slide 30s):
├── [W1] ────┤
       ├── [W2] ────┤
              ├── [W3] ────┤

Session Window (2 min gap):
├── [S1] ──────────┤          ├── [S2] ──┤
     (user session)            (new session)
4. Cloud Dataproc — 託管Spark/Hadoop
| Dataproc功能 | 詳細 |
|---|---|
| 叢集生命週期 | 90秒建立,工作後刪除 — 節省成本 |
| 臨時叢集 | 啟動 → 執行工作 → 關閉(按工作計費) |
| 可搶佔式VM | 用於工作節點以減少60-80%成本 |
| 元件閘道 | 透過瀏覽器存取Jupyter、Zeppelin、Spark UI |
| ML函式庫 | Spark MLlib、TensorFlow on Spark(TFoS) |
5. Cloud Composer — 工作流程協調
Cloud Composer是託管的Apache Airflow。用於協調包含資料擷取、前處理、訓練和部署的多步驟ML管線。
Cloud Composer ML Workflow:

[DAG: daily_ml_pipeline]
   Task 1: Extract data from BigQuery
       ↓
   Task 2: Run Dataflow preprocessing job
       ↓
   Task 3: Submit Vertex AI Training Job
       ↓
   Task 4: Evaluate model metrics
       ↓ (if metrics pass threshold)
   Task 5: Deploy to Vertex AI Endpoint
6. 資料管線服務選擇
| 場景 | 推薦服務 |
|---|---|
| 即時事件串流擷取 | Pub/Sub |
| 統一批次 + 串流ETL(無需基礎設施管理) | Dataflow(Apache Beam) |
| 將現有Spark工作遷移到GCP | Dataproc |
| 複雜的ML DAG協調 | Cloud Composer |
| 將資料串流至BigQuery | Pub/Sub → Dataflow → BigQuery |
| 無伺服器資料處理(SQL) | BigQuery(SQL ETL) |
7. 練習題
Q1: 一家公司每秒從工廠設備接收數百萬個IoT感測器事件。他們需要即時處理這些事件、偵測異常並將結果儲存到BigQuery。最合適的管線架構是什麼?
- A) Dataproc → Spark Streaming → BigQuery
- B) Pub/Sub → Dataflow → BigQuery ✓
- C) Cloud Functions → Cloud SQL
- D) 批次上傳至Cloud Storage → BigQuery匯入
解說:Pub/Sub可靠地擷取大量串流事件。Dataflow使用Apache Beam即時處理串流(視窗化、轉換、異常偵測)。BigQuery儲存結果以供分析。這是GCP標準的串流分析模式。
Q2: 資料工程團隊有一個現有的Apache Spark工作用來處理ML模型的訓練資料。他們想以最小的程式碼變更遷移到GCP。應使用哪個服務?
- A) Cloud Dataflow
- B) Cloud Dataproc ✓
- C) BigQuery ETL
- D) Cloud Composer
解說:Cloud Dataproc原生支援Apache Spark,允許團隊以最小的變更在GCP上執行現有的Spark工作。Dataflow使用Apache Beam(不同的程式設計模型)。Dataproc是Spark工作負載的直接遷移選項。
Q3: 團隊需要協調一個日常ML管線,包含從BigQuery擷取資料、前處理、Vertex AI訓練,以及準確率超過90%時的部署。哪個服務處理此工作流程協調?
- A) Vertex AI Pipelines
- B) Cloud Dataflow
- C) Cloud Composer ✓
- D) Pub/Sub觸發器
解說:Cloud Composer(託管Apache Airflow)專為跨多個服務的複雜DAG協調而設計。它處理排程、條件分支(僅在準確率 > 90%時部署)、重試邏輯,以及BigQuery、Dataflow和Vertex AI等異質服務間的監控。