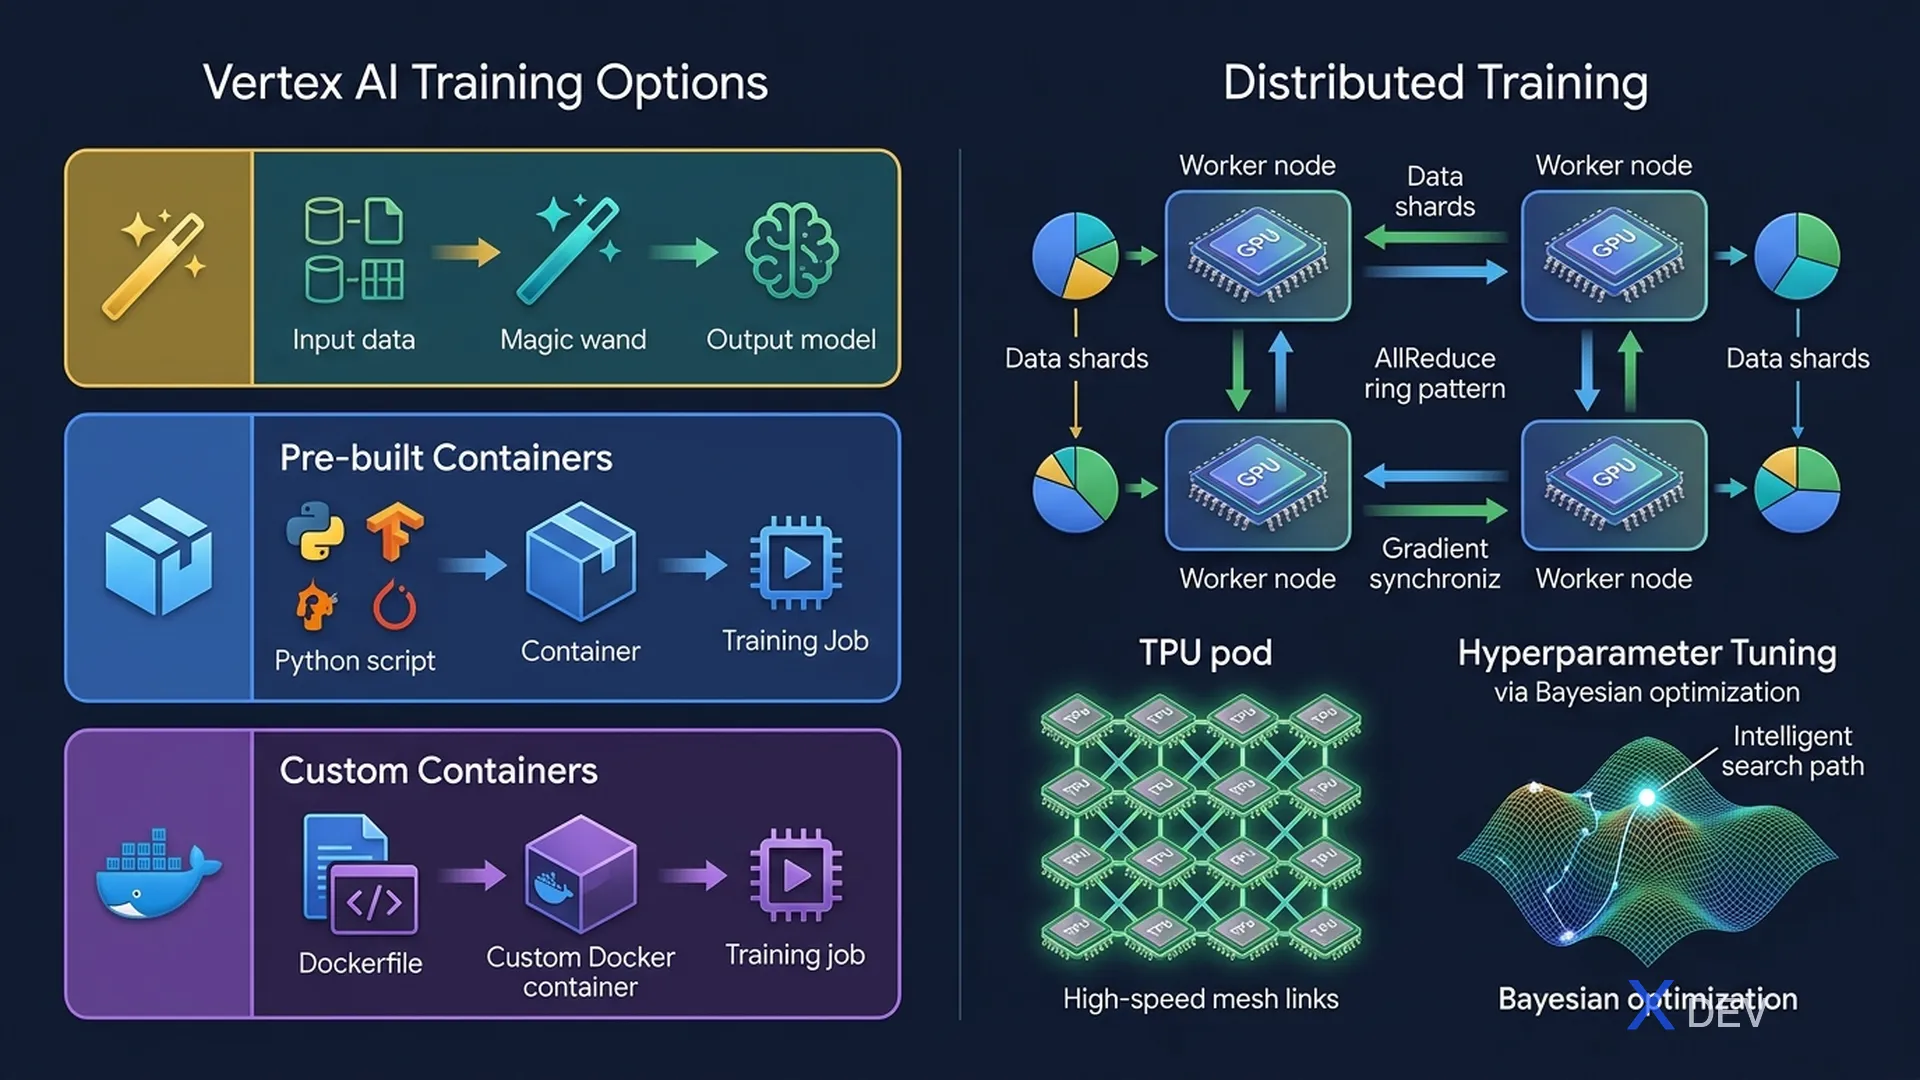
Vertex AIカスタムトレーニング:Training Jobs、AutoML、分散トレーニングと最適化
1. Vertex AIカスタムトレーニング
カスタムトレーニングでは、Google Cloudインフラ上で独自のトレーニングコードを実行できます。コードのパッケージング方法は2つあります:
| 方法 | 説明 | 使用場面 |
|---|---|---|
| ビルド済みコンテナ | GCP提供のコンテナ:TF、PyTorch、Scikit-learn、XGBoost | 標準的なMLフレームワーク、迅速なセットアップ |
| カスタムコンテナ | 独自のDockerイメージを構築 | カスタム依存関係、特殊な環境 |
Custom Training Job Structure:

training_package/ (Python package or Docker image)
│
├── trainer/
│   ├── __init__.py
│   ├── task.py        ← entry point (main training script)
│   └── model.py       ← model definition
│
└── setup.py

Arguments passed via:
  TRAINING_DATA_URI: gs://bucket/data/
  TRAINING_OUTPUT_URI: gs://bucket/model/
  Hyperparameters: --learning-rate=0.001
2. コンピュートオプション
| ハードウェア | 最適な用途 | 備考 |
|---|---|---|
| CPU | Scikit-learn、小規模テーブルデータ | 最安価、GPU並列化なし |
| GPU(T4、A100、V100) | ディープラーニング、NLP、CV | DLではCPUの10-100倍高速 |
| TPU v3、v4 | TensorFlow大規模トレーニング | Google専用ハードウェア;TF/JAXで非常に高速 |
試験のヒント: TPUはTensorFlowとJAX向けに最適化されたGoogle専用ハードウェアです。GPUはすべてのフレームワークで動作します。TPUは非常に大規模なTFモデルで最もコスト効率的で、GPUはより汎用性があります。「TensorFlowの大規模トレーニングで最もコスト効率的」→ TPU。
3. Vertex AI上の分散トレーニング
| 戦略 | 説明 | ユースケース |
|---|---|---|
| Data Parallelism | データをワーカー間で分割、同じモデル | ほとんどのDLトレーニングシナリオ |
| Model Parallelism | モデルのレイヤーをワーカー間で分割 | モデルが1つのGPUに収まらない場合 |
| MirroredStrategy(TF) | マルチGPU、単一マシン | 単一ノード、複数GPU |
| MultiWorkerMirroredStrategy | マルチGPU、マルチマシン | クラスタートレーニング |
| ParameterServerStrategy | パラメータサーバーによる非同期更新 | 非常に大規模なモデル(レガシー) |
4. Vertex AI AutoML
| AutoMLの種類 | 入力データ | サポートされるタスク |
|---|---|---|
| AutoML Tabular | CSV、BigQueryテーブル | 分類、回帰、予測 |
| AutoML Image | JPEG、PNG、BMP | 分類(単一/マルチ)、オブジェクト検出、セグメンテーション |
| AutoML Text | テキストドキュメント | 分類、エンティティ抽出、感情分析 |
| AutoML Video | MP4、AVI、MOV | 分類、オブジェクト検出、アクション認識 |
5. Vertex AIハイパーパラメータチューニング
Vertex AIハイパーパラメータチューニングは、最適なハイパーパラメータの組み合わせを自動的に探索します。
| 探索アルゴリズム | 説明 |
|---|---|
| Grid Search | 網羅的、高コスト;小さな探索空間向け |
| Random Search | ランダムサンプリング;グリッドより効果的なことが多い |
| Bayesian Optimization | ガウス過程を使用したスマートな探索;最も効率的 |
HPT Job Setup:

hyperparameters:
  - parameter_id: learning_rate
    type: DOUBLE
    min_value: 0.0001
    max_value: 0.1
    scale: LOG  ← log scale for LR

  - parameter_id: batch_size
    type: INTEGER
    values: [32, 64, 128, 256]

metric:
  metric_id: val_accuracy
  goal: MAXIMIZE

max_trial_count: 50
parallel_trial_count: 5
6. 練習問題
Q1: チームが、各8 GPUを搭載した複数のマシンでカスタムTensorFlowモデルをトレーニングしたいと考えています。パラメータサーバーなしで、すべてのワーカー間で勾配を同期したいです。どのTensorFlow分散戦略を使用すべきでしょうか?
- A) MirroredStrategy
- B) MultiWorkerMirroredStrategy ✓
- C) ParameterServerStrategy
- D) TPUStrategy
解説:MultiWorkerMirroredStrategyは、それぞれ複数のGPUを持つ複数のマシン間で同期データ並列トレーニングを可能にします。MirroredStrategyは単一マシンのマルチGPU専用です。ParameterServerStrategyは非同期更新を使用します。TPUStrategyはTPUポッド用です。
Q2: ある企業が画像分類モデルをトレーニングする必要がありますが、チームにはディープラーニングの専門知識がありません。5,000枚のラベル付き商品画像があります。最もML専門知識が少なくて済むVertex AIオプションはどれでしょうか?
- A) TensorFlow CNNによるVertex AIカスタムトレーニング
- B) Vertex AI AutoML Image Classification ✓
- C) Dataproc Spark ML
- D) BigQuery ML
解説:AutoML Image Classificationは、アーキテクチャ選択、ハイパーパラメータチューニング、トレーニングを自動的に処理します。チームはラベル付き画像をアップロードしてタスクを指定するだけです。コードやディープラーニングの専門知識は不要です。
Q3: 大規模な探索空間を持つ、トレーニングコストの高いディープラーニングモデルを評価する場合、最も効率的なハイパーパラメータ探索戦略はどれでしょうか?
- A) Grid Search — すべての組み合わせをテスト
- B) Random Search — 均一にサンプリング
- C) Bayesian Optimization — 過去の試行結果を使用して探索をガイド ✓
- D) 手動チューニング — エキスパートがパラメータを選択
解説:Bayesian Optimizationは、ガウス過程を使用して目的関数の確率モデルを構築し、過去の試行結果に基づいて次に評価するハイパーパラメータ設定をインテリジェントに選択します。グリッドやランダム探索よりもはるかに少ない試行で良好な設定を見つけます。