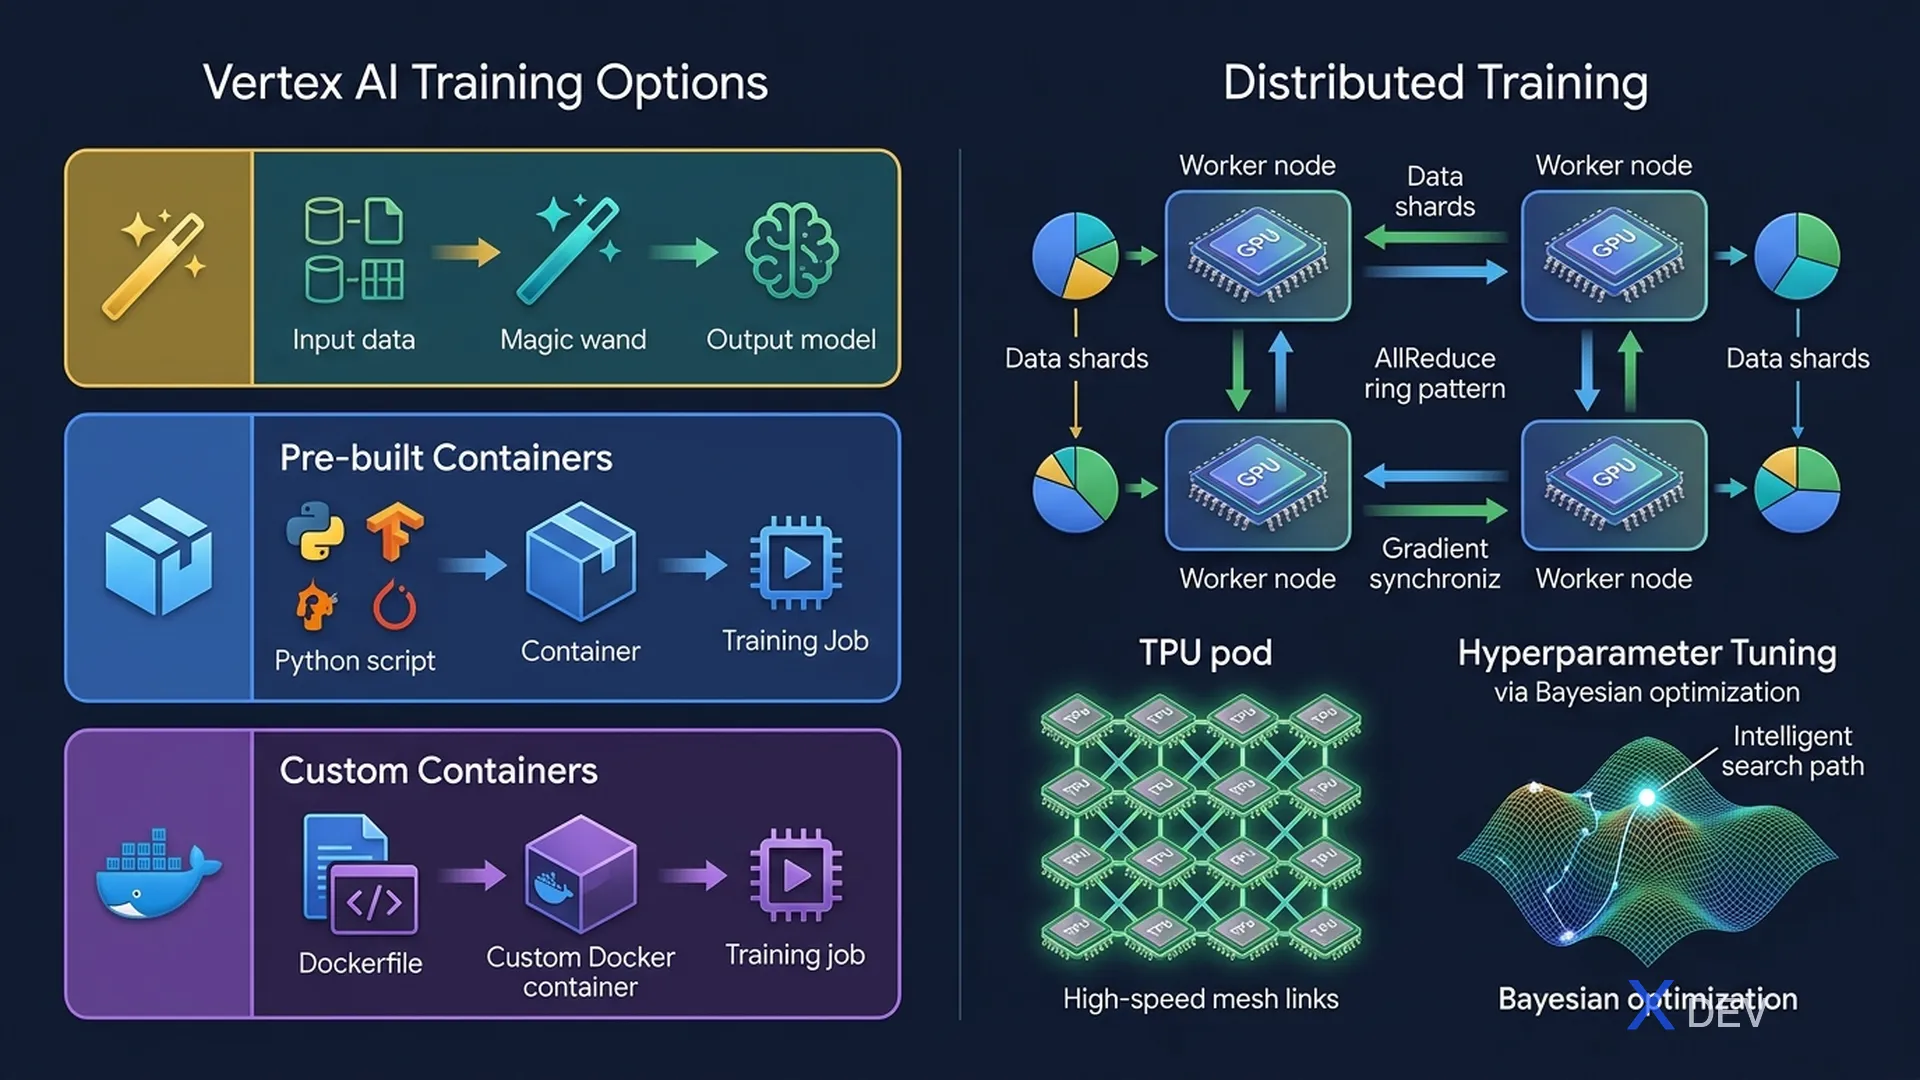
Vertex AI自訂訓練:Training Jobs、AutoML、分散式訓練與最佳化
1. Vertex AI自訂訓練
自訂訓練允許您在Google Cloud基礎設施上執行自己的訓練程式碼。有兩種打包程式碼的方式:
| 方法 | 說明 | 使用時機 |
|---|---|---|
| 預建容器 | GCP提供的容器:TF、PyTorch、Scikit-learn、XGBoost | 標準ML框架,快速設定 |
| 自訂容器 | 建構自己的Docker映像檔 | 自訂依賴、特殊環境 |
Custom Training Job Structure:

training_package/ (Python package or Docker image)
│
├── trainer/
│   ├── __init__.py
│   ├── task.py        ← entry point (main training script)
│   └── model.py       ← model definition
│
└── setup.py

Arguments passed via:
  TRAINING_DATA_URI: gs://bucket/data/
  TRAINING_OUTPUT_URI: gs://bucket/model/
  Hyperparameters: --learning-rate=0.001
2. 運算選項
| 硬體 | 最適用途 | 備註 |
|---|---|---|
| CPU | Scikit-learn、小型表格資料 | 最便宜,無GPU平行處理 |
| GPU(T4、A100、V100) | 深度學習、NLP、電腦視覺 | 深度學習比CPU快10-100倍 |
| TPU v3、v4 | TensorFlow大規模訓練 | Google專用硬體;對TF/JAX非常快 |
考試提示: TPU是Google專用硬體,針對TensorFlow和JAX最佳化。GPU適用於所有框架。TPU對於非常大的TF模型最具成本效益;GPU更通用。考試可能問「TensorFlow大規模訓練最具成本效益」→ TPU。
3. Vertex AI上的分散式訓練
| 策略 | 說明 | 使用場景 |
|---|---|---|
| 資料平行處理 | 將資料分散到各工作節點,相同模型 | 大多數深度學習訓練場景 |
| 模型平行處理 | 將模型層分散到各工作節點 | 模型太大無法放入單一GPU |
| MirroredStrategy(TF) | 多GPU、單一機器 | 單節點、多GPU |
| MultiWorkerMirroredStrategy | 多GPU、多機器 | 叢集訓練 |
| ParameterServerStrategy | 透過參數伺服器進行非同步更新 | 非常大的模型(舊版) |
4. Vertex AI AutoML
| AutoML類型 | 輸入資料 | 支援的任務 |
|---|---|---|
| AutoML Tabular | CSV、BigQuery表格 | 分類、迴歸、預測 |
| AutoML Image | JPEG、PNG、BMP | 分類(單/多標籤)、物件偵測、分割 |
| AutoML Text | 文字文件 | 分類、實體擷取、情感分析 |
| AutoML Video | MP4、AVI、MOV | 分類、物件偵測、動作辨識 |
5. Vertex AI超參數調優
Vertex AI超參數調優自動尋找最佳的超參數組合。
| 搜尋演算法 | 說明 |
|---|---|
| 網格搜尋 | 窮舉式、昂貴;適用小搜尋空間 |
| 隨機搜尋 | 隨機取樣;通常比網格搜尋好 |
| 貝葉斯最佳化 | 使用高斯過程的智慧搜尋;最有效率 |
HPT Job Setup:

hyperparameters:
  - parameter_id: learning_rate
    type: DOUBLE
    min_value: 0.0001
    max_value: 0.1
    scale: LOG  ← log scale for LR

  - parameter_id: batch_size
    type: INTEGER
    values: [32, 64, 128, 256]

metric:
  metric_id: val_accuracy
  goal: MAXIMIZE

max_trial_count: 50
parallel_trial_count: 5
6. 練習題
Q1: 團隊想在多台機器上(每台8個GPU)訓練自訂TensorFlow模型。他們希望在所有工作節點間同步梯度,不使用參數伺服器。應使用哪種TensorFlow分散策略?
- A) MirroredStrategy
- B) MultiWorkerMirroredStrategy ✓
- C) ParameterServerStrategy
- D) TPUStrategy
解說:MultiWorkerMirroredStrategy支援跨多台機器(每台多個GPU)的同步資料平行訓練。MirroredStrategy僅適用於單機多GPU。ParameterServerStrategy使用非同步更新。TPUStrategy專用於TPU pod。
Q2: 一家公司需要訓練影像分類模型,但團隊沒有深度學習專業知識。他們有5,000張標籤的商品圖片。哪個Vertex AI選項需要最少的ML專業知識?
- A) 使用TensorFlow CNN的Vertex AI自訂訓練
- B) Vertex AI AutoML Image Classification ✓
- C) Dataproc Spark ML
- D) BigQuery ML
解說:AutoML Image Classification自動處理架構選擇、超參數調優和訓練。團隊只需上傳標籤圖片並指定任務。不需要任何程式碼或深度學習專業知識。
Q3: 在評估訓練成本高的深度學習模型且搜尋空間很大時,哪種超參數搜尋策略最有效率?
- A) 網格搜尋 — 測試所有組合
- B) 隨機搜尋 — 均勻取樣
- C) 貝葉斯最佳化 — 使用過去的試驗結果引導搜尋 ✓
- D) 手動調優 — 專家選擇參數
解說:貝葉斯最佳化使用高斯過程建構目標函數的概率模型,根據過去的試驗結果智慧選擇下一個要評估的超參數配置。比網格搜尋或隨機搜尋用更少的試驗就能找到好的配置。