レッスンの目的
このレッスンを終えると、次のことができるようになります:
- 高可用性 (HA) がデータベース システムにとって重要である理由を理解する_
- PostgreSQL の HA 実装方法をマスター_
- Patroni、Repmgr、およびPacemaker_
- PostgreSQL システム HA
1 の全体的なアーキテクチャを理解します。高可用性が必要な理由
1.1。単一点障害 (SPOF) の問題
単一サーバーを備えた従来のデータベース システムの場合:
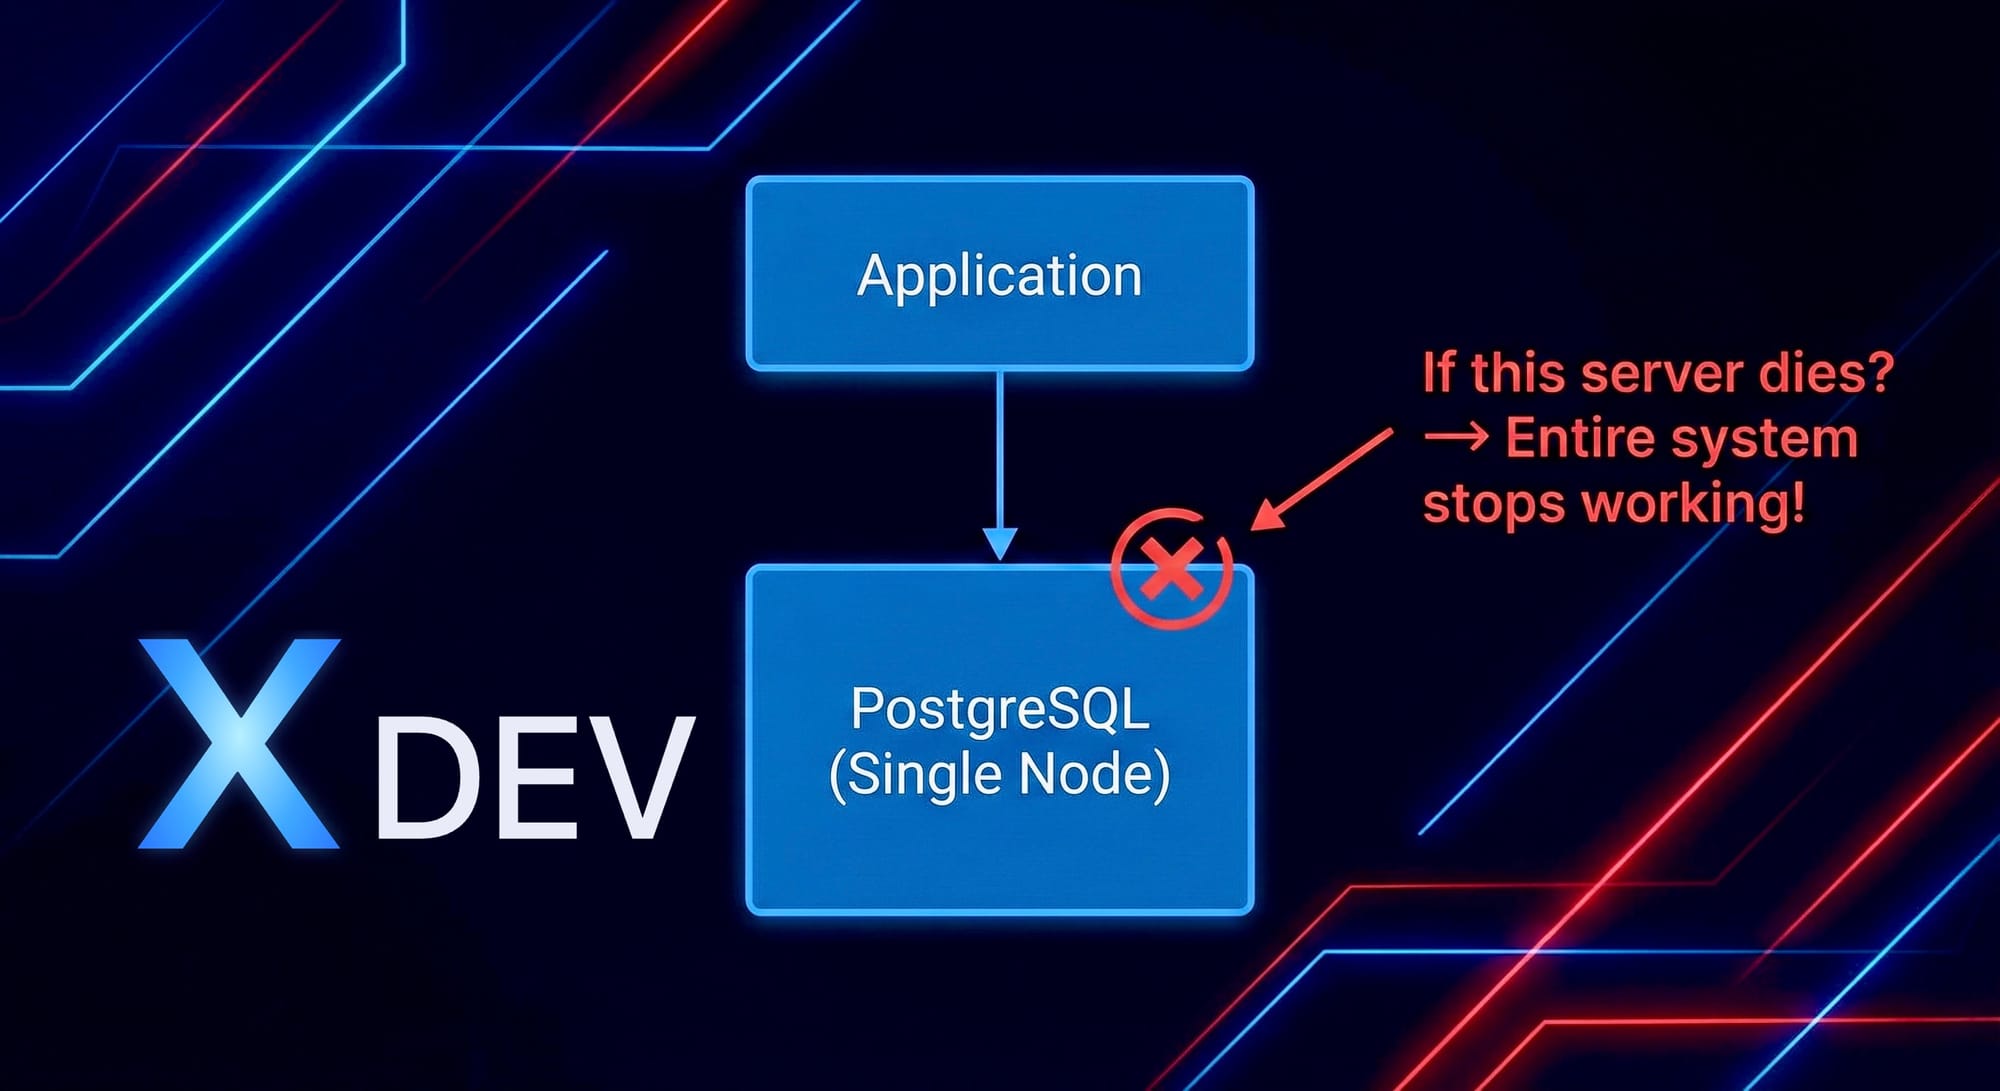
次の場合の結果データベース サーバーがクラッシュするエラー:
- ダウンタイム: アプリケーションがデータにアクセスできない
- 収益損失: ダウンタイムが発生すると、1 分ごとに数百万ドルの損失が発生します。ドン
- 評判の損失: ユーザーはサービスを使用できなくなります
- データ損失: タイムリーなバックアップ時間がない場合
1.2。ダウンタイムの一般的な原因
| 原因__HTMLTAG_57___ | 評価 | 影響 |
|---|---|---|
| ハードウェア エラー (ディスク、RAM、CPU) | 30% | 高 |
| ネットワーク エラー | 20% | 平均 |
| ソフトウェア エラー/バグ__HTMLTAG_83___ | 25% | 高 |
| メンテナンスには計画があります__HTMLTAG_91___ | 15% | 制御可能 |
| 人的エラー__HTMLTAG_99___ | 10% | 高 |
1.3.高可用性とは何ですか?
高可用性 (HA) は、1 つ以上のコンポーネントに障害が発生した場合でもシステムが継続的な動作を維持できる能力です。
測定インジケーター HA:
___HTMLタグ_142___| 利用可能状況 | ダウンタイム/年 | ダウンタイム/月 | レベル |
|---|---|---|---|
| 99% (2 ナイン) | 3.65 日 | 7.2 時間 | 低 |
| 99.9% (スリーナイン) | 8.76 時間 | 43.2 分 | 平均 |
| 99.99% (フォーナイン) | 52.56 分__HTMLTAG_157___ | 4.32 分__HTMLTAG_159___ | 高 |
| 99.999% (ファイブナイン) | 5.26 分 | 25.9 秒 | 非常に高い |
1.4。 HA の利点
ビジネス上の利点:
- ダウンタイムと収益損失を最小限に抑える_
- システムの信頼性を向上_
- ユーザーの向上エクスペリエンス_
- SLA (サービス レベル アグリーメント) を満たす_
技術的利点:_
- プライマリ サーバーに問題__HTMLTAG_198___
- _ゼロダウンタイムメンテナンス_
- _読み取りクエリのロード
- 災害復旧
- データ保護
2。 PostgreSQL
2.1 の HA メソッド。ログ配送 (WAL 配送)_
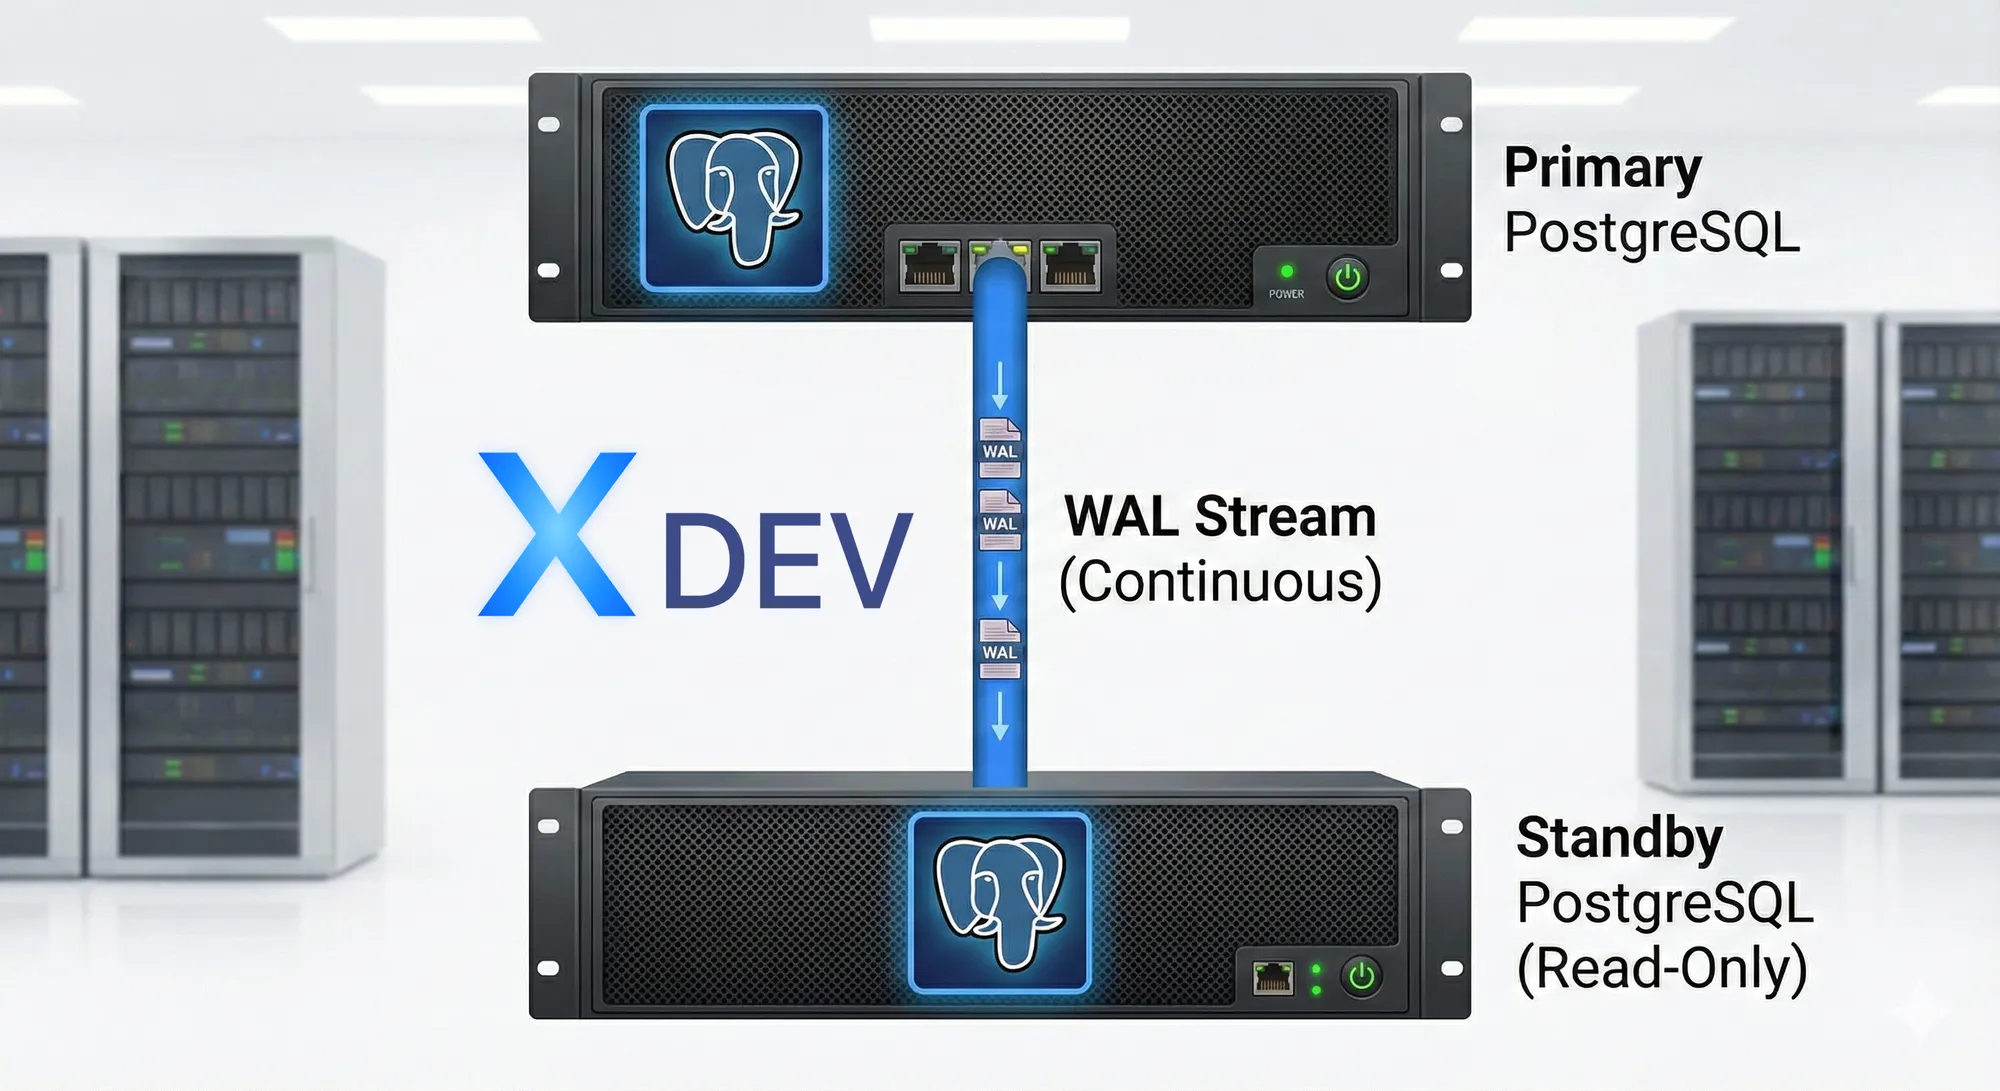
使い方動作:_
- プライマリ サーバーが WAL (先行書き込みログ) ファイルを書き込む
- WAL ファイルがスタンバイ サーバーにコピーされる
- スタンバイ サーバーが WAL を再生して同期するデータ_
利点ポイント:
- シンプルでセットアップが簡単
- リソース消費量が少ないオリジナル
短所:
- 目標復旧時間 (RTO) が高い (分→時間)
- 自動なしフェイルオーバー
- データ損失が発生する可能性があります__HTMLTAG_252___
- スタンバイをクエリできません (ウォームスタンバイ)
2.2。ストリーミング レプリケーション
仕組み:
- プライマリ ストリーム WAL がスタンバイにリアルタイムで記録_
- スタンバイが変更を適用すぐに
- スタンバイは読み取りクエリを処理できます (ホットスタンバイ)
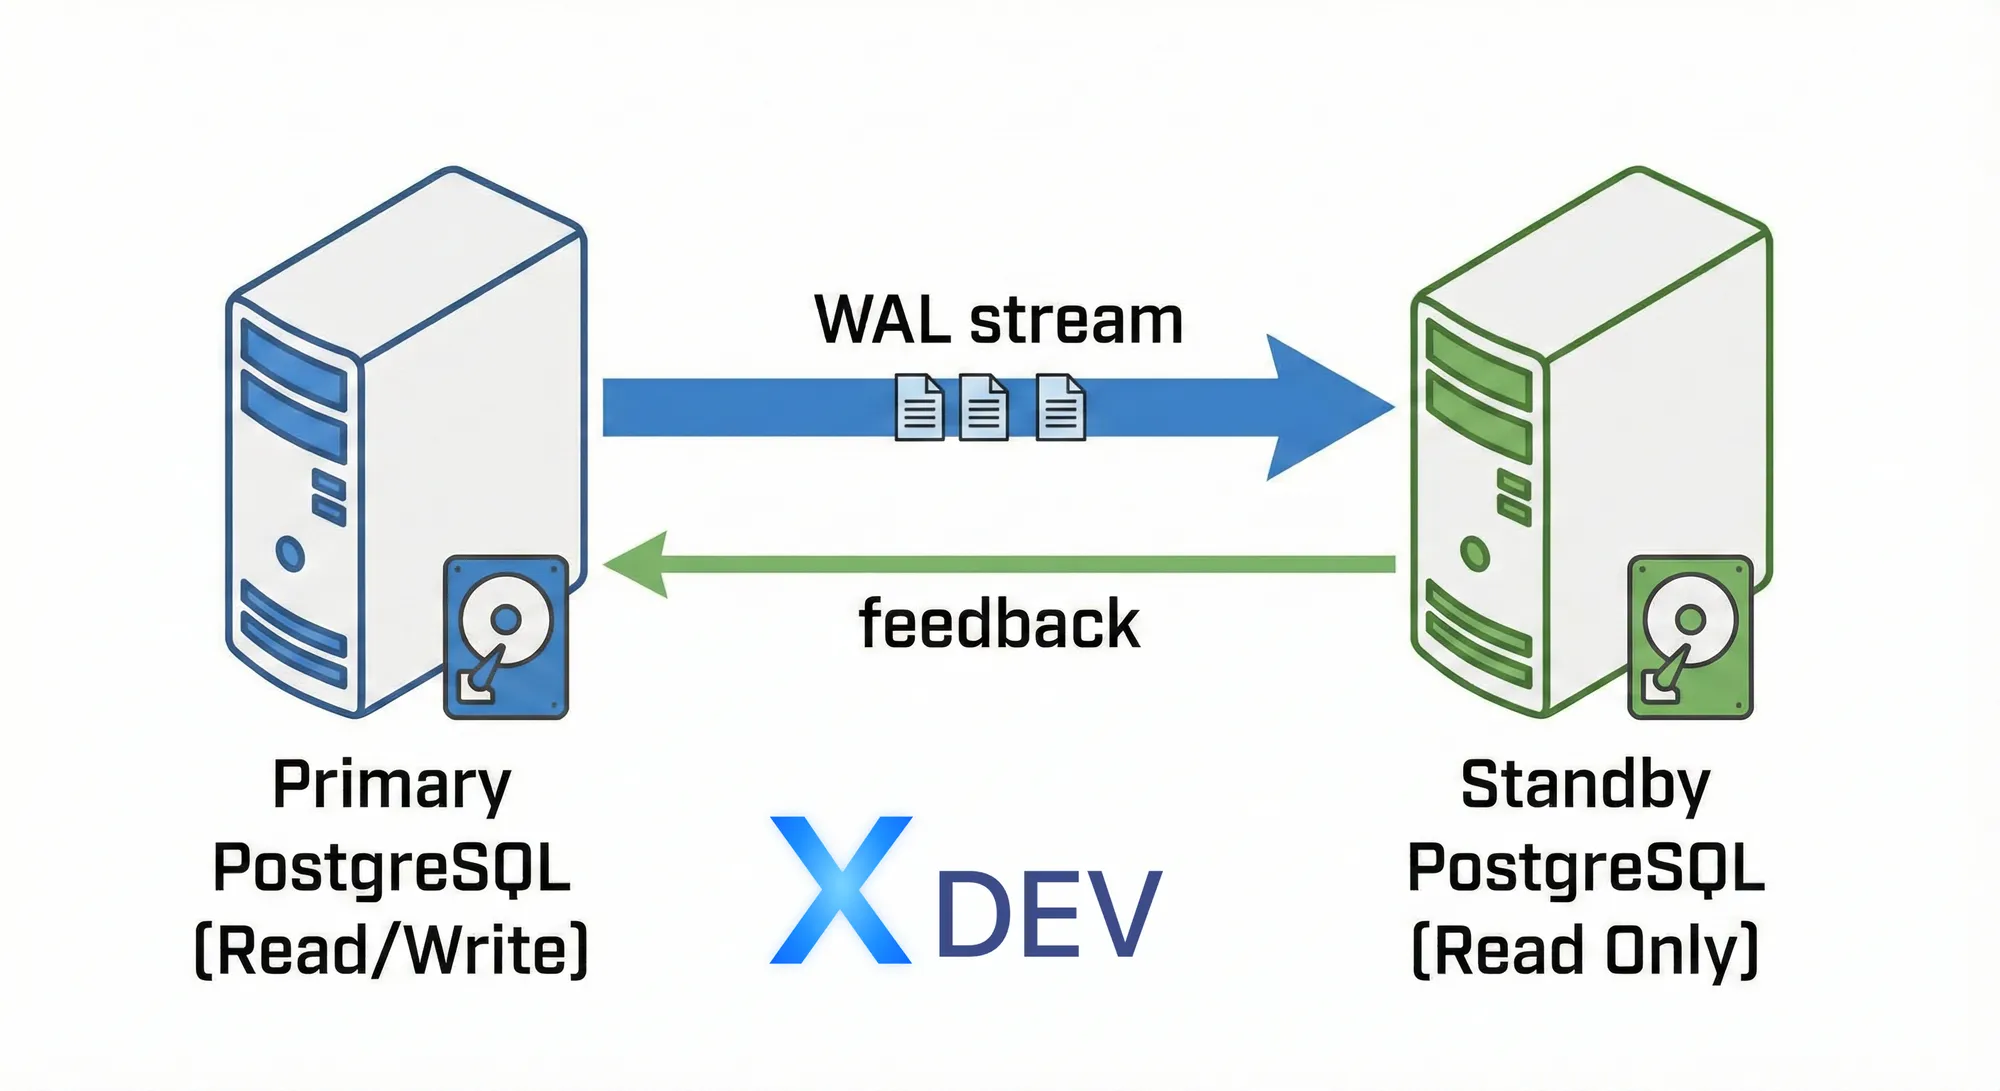
利点:
- 低遅延 (&lと; 1 秒)_
- ホット スタンバイは読み取りクエリを処理できます
- 同期モードによりデータ損失が軽減されます__HTMLTAG_287___
_欠点ポイント:_
- 手動フェイルオーバーがまだ必要_
- 自動化のための外部ツールが必要_
2.3。論理レプリケーション
仕組み:
- 論理レベル (テーブル、行) で複製
- 選択的レプリケーションを有効にするデータ_
- パブリッシャー → サブスクライバー モデル
長所:
- 異なる PostgreSQL 間のレプリケーションバージョン_
- _選択的レプリケーション (一部のテーブルのみ)_
- _マルチマスター可能 ( BDR)_
短所:_
- 物理レプリケーションよりもオーバーヘッドが高い
- なし メインの HA ソリューション (通常はデータに使用)配布)
2.4。共有ストレージ (SAN)_
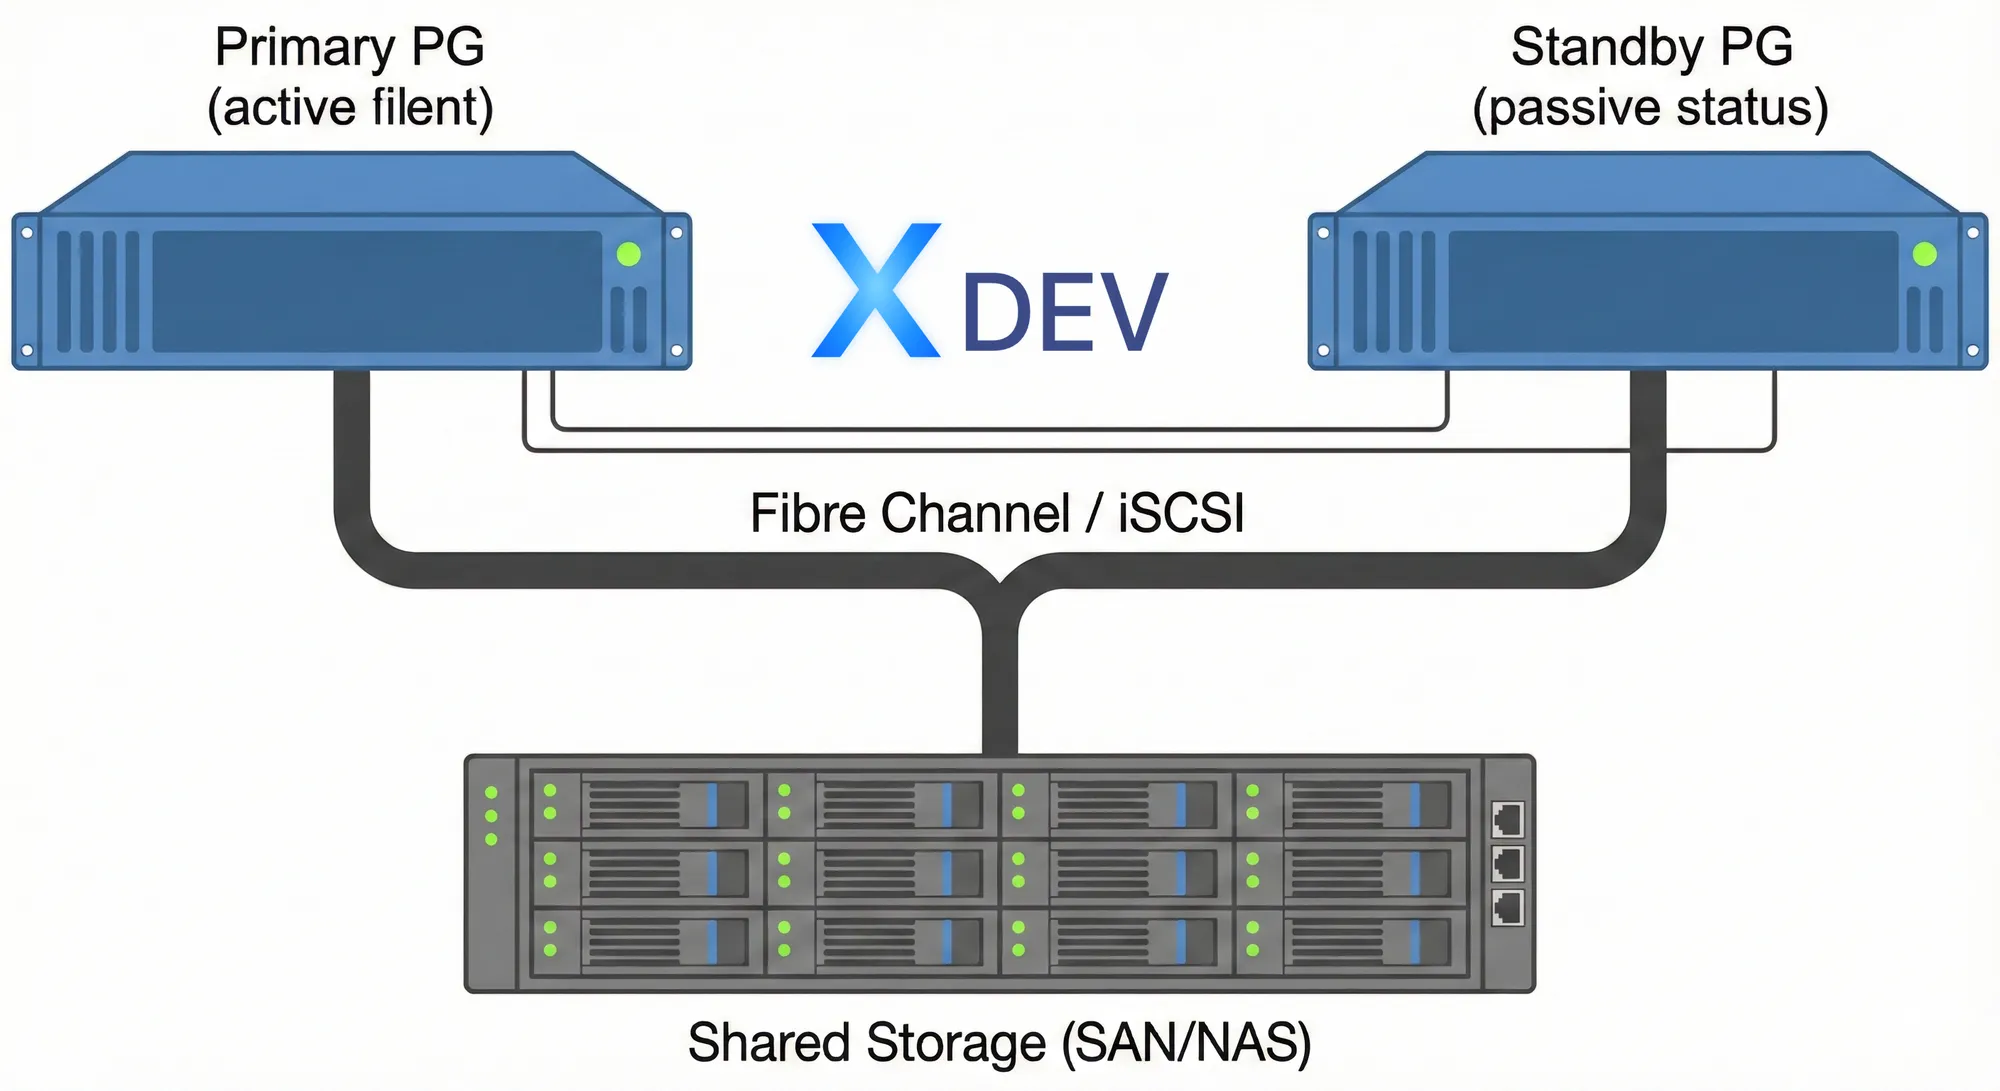
利点:
- フェイルオーバーが速い (PostgreSQL を起動するだけ)_
- データなし損失_
短所:
- 高価 (SAN インフラストラクチャが必要)
- SAN が単一ポイントになる失敗
- 保守が複雑
3。比較: Patroni vs Repmgr vs Pacemaker
3.1。 Patroni_
特徴:_
- _Python ベース_
- DCS (etcd、Consul、ZooKeeper) を使用してクラスターを保存状態_
- 管理用 REST API
- 自動スマート フェイルオーバー_
- テンプレート ベース構成_
利点:
- ✅ インストールと構成が簡単 画像
- ✅ 強力な REST API_
- ✅ Kubernetes との優れた統合_
- ✅ 活発な開発、大規模なコミュニティ__HTMLTAG_399___
- ✅ 自動リーダー選出
- ✅ ローリングリスタート、ゼロダウンタイムアップデート_
欠点:
- ❌ DCSに依存(コンポーネントの追加)
- ❌ DCSの学習が必要(etcd/領事)
適切なケースを使用してください:
- クラウドネイティブ アプリケーション
- Kubernetes デプロイメント
- マイクロサービス アーキテクチャ
- 高いニーズ自動化
3.2。 Repmgr
機能:
- 2ndQuadrant (EnterpriseDB) のオープンソース ツール
- スタンドアロン ツール、 DCS_
- クォーラム投票用の監視ノード_
- コマンドラインベース管理_
利点:
- ✅ 外部 DCS の追加が不要
- ✅ より簡単Patroni_
- ✅ 優れたドキュメント
- ✅ 成熟した、安定
短所:
- ❌ 自動化機能が少ない Patroni
- ❌ REST がないAPI_
- ❌ 小規模コミュニティ
- ❌ 複雑なフェイルオーバーの詳細
適切なケースを使用する:
- _従来型インフラストラクチャ
- 単一のシンプルで少数のノード
- DCS を追加したくない
3.3。 Pacemaker + Corosync_
機能:_
- 高可用性クラスターフレームワーク (Linux-HA)
- さまざまなタイプのリソースの管理PostgreSQL_
- 投票クォーラムメカニズム
- スプリットブレインを回避するためのフェンシング/STONITH_
長所スコア:
- ✅ 成熟し、本番環境で実証済み (20 年以上)
- ✅ 多くのサービス (PostgreSQL、Web サーバーなど) を管理
- ✅ 強力なフェンシングメカニズム_
- ✅ 共有ストレージをサポート
欠点:_
- ❌ セットアップと設定が非常に複雑保守_
- ❌ 学習曲線が高い_
- ❌ XML 構成の読み取りが難しい
- ❌ デバッグが難しい
ユースケースが適しているケース:
- エンタープライズ環境_
- 多くのサービスを管理する必要がある
- 共有ストレージ (SAN) がある
- チームには経験があるペースメーカー_
3.4。概要比較表
| 基準 | パトローニ | _Repmgr | ペースメーカー |
|---|---|---|---|
| _複雑さ | 平均 | 低 | 高 |
| 学習曲線 | 平均 | 低 | 非常に高い |
| セットアップ時間 | ニャン | ニャン | 遅い |
| 自動フェイルオーバー | ✅ 素晴らしい | _✅ 良い | ✅ 素晴らしい |
| _REST API | ✅ はい | ❌ いいえ | ❌ いいえ_ |
| _Kubernetes サポート | ✅ 素晴らしい | ⚠️ 限定 | ❌ いいえ |
| コミュニティ | _⭐⭐⭐⭐⭐ | _⭐⭐⭐ | _⭐⭐⭐⭐ |
| ドキュメント | _⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | _⭐⭐⭐_ |
| 依存関係_ | DCS (etcd/領事) | なし | なし |
| _最適 | モダン/クラウド | 簡単なセットアップ | エンタープライズ/複合施設 |
3.5。推奨_
次の場合は Patroni を選択してください:
- クラウドまたは Kubernetes にデプロイ_
- 自動化と REST API が必要
- _チーム最新の DevOps ツールの使用経験がある
- ✅ これが現在最も人気のあるオプションではありません
_Repmgr を選択してくださいif:
- 簡単なセットアップ、少数のノード (2 ~ 3)
- DCS に依存したくない
- チームは従来の PostgreSQL に精通していますツール_
次の場合はペースメーカーを選択してください:
- 複雑なエンタープライズ環境
- Pacemakerインフラストラクチャはすでに利用可能___HTMLTAG_721__HTMLTAG_722____多くのサービスを同時に管理する必要がある_
- 共有ストレージが利用可能(SAN)
4。システム概要アーキテクチャ Patroni + etcd
4.1。 3 ノード クラスター アーキテクチャ_
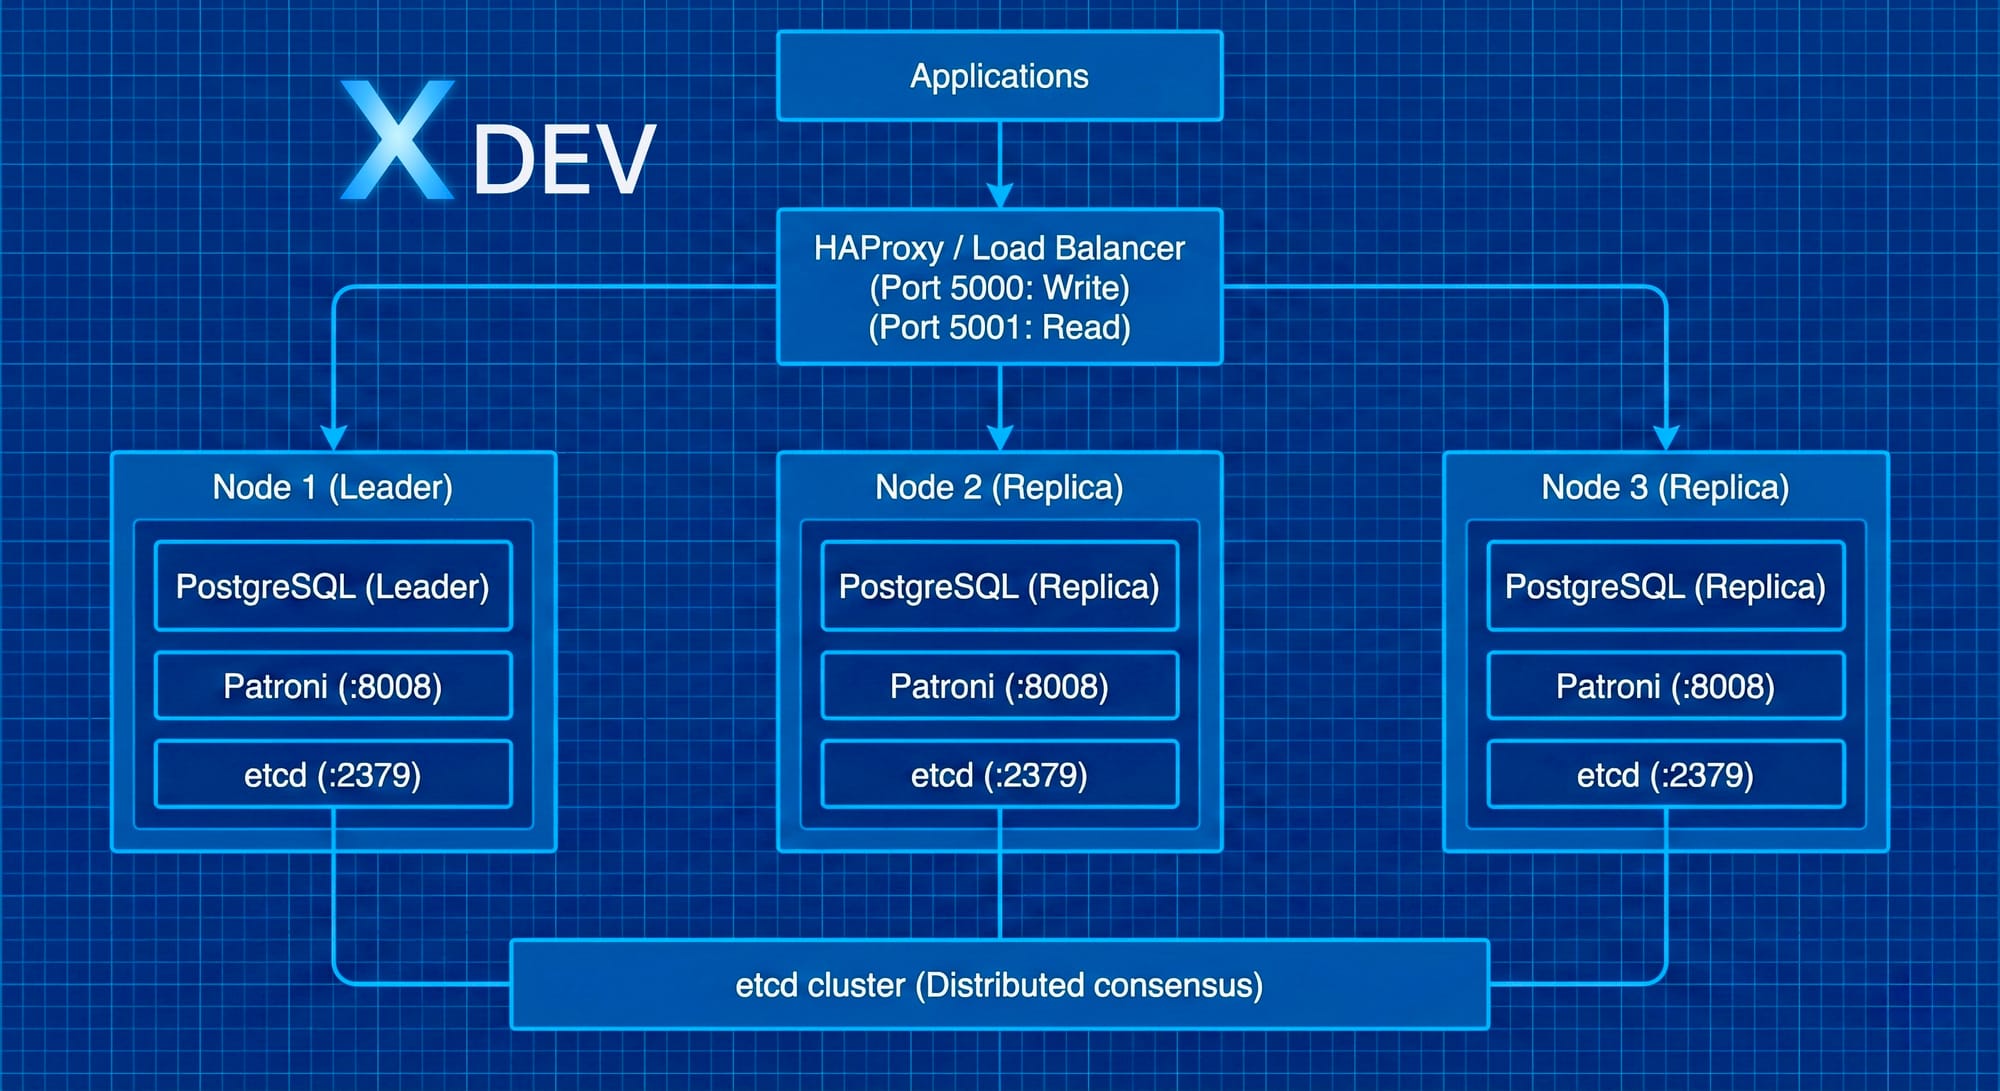
4.2。メインコンポーネント_
PostgreSQL
- データベースメインエンジン_
- 1 つのノードがリーダー (読み取り/書き込み)
- 他のノードがレプリカ(読み取り専用)
- ストリーミング レプリケーションを使用してセットを同期
Patroni
- PostgreSQL ライフサイクル管理_
- _ノードの健全性の監視_
- 自動フェイルオーバーの実行____HTMLTAG_765__HTMLTAG_766___REST API (:8008) を公開してクラスター状態をクエリ_
- 構成の読み取り/書き込みDCS
etcd (DCS - 分散構成ストア)
- クラスターの状態と構成の保存
- リーダーの選出 (どのノードがリーダー)
- 分散ロック機構
- 3 ノードなどがクォーラムを形成 (多数決)_
HAProxy (オプションですが、推奨)_
- _ロードバランサー
- 書き込みトラフィックのルート→リーダー
- 読み取りトラフィックのルート→レプリカ(ラウンドロビン)
- ヘルスチェックと自動ルーティングフェイルオーバー
4.3。アクティビティ フロー_
1。通常操作_
1. Application gửi query → HAProxy
2. HAProxy kiểm tra health check
3. Route write → Leader, read → Replicas
4. Patroni trên mỗi node:
   - Gửi heartbeat vào etcd mỗi 10s
   - Update health status
   - Maintain leader lease
2。リーダー障害の検出
1. Node 1 (Leader) gặp sự cố → stop heartbeat
2. etcd phát hiện: leader lease expired (30s)
3. Patroni trên Node 2 và Node 3 nhận ra
4. Leader election được trigger
3。自動フェイルオーバー プロセス_
Timeline: 0s  ──────────► 30s ──────► 45s ──────► 60s
          │              │           │            │
      Leader dies    etcd detects  New leader  Applications
                     lease expire   elected     reconnect
                                   (Node 2)
Node 1:   LEADER ──────► DOWN ──────────────────► STANDBY (sau khi recover)
Node 2:   REPLICA ─────────────────► LEADER ────► LEADER
Node 3:   REPLICA ──────────────────────────────► REPLICA
4。フェイルオーバー後
- Node 2 trở thành Leader mới
- Node 3 vẫn là Replica, đổi replication source sang Node 2
- HAProxy tự động detect và route traffic sang Node 2
Node 1 (khi recover) sẽ join lại như Replica
4.4。重要なシナリオ
シナリオ 1: 計画的な切り替え
# Admin muốn maintenance Node 1 (Leader) $ patronictl switchover postgres-clusterPatroni sẽ:
- Tạm dừng ghi vào Leader hiện tại
- Đợi Replica sync hoàn toàn (zero lag)
- Promote Replica → Leader
- Demote Leader cũ → Replica
Zero data loss, downtime < 5s
シナリオ 2: スプリット ブレイン予防_
Tình huống: Network partition giữa nodesetcd quorum (3 nodes):
- Partition A: Node 1, Node 2 (2 nodes = majority)
- Partition B: Node 3 (1 node = minority)
Kết quả: ✅ Partition A: Tiếp tục hoạt động, có thể elect leader ❌ Partition B: Không thể elect leader (không đủ quorum)
→ Tránh được 2 leaders cùng tồn tại!
シナリオ 3: ノードの回復
Node 1 recover sau khi die:
- Patroni start và đọc cluster state từ etcd
- Nhận ra Node 2 đang là Leader
- Tự động rejoin như Replica
- Sử dụng pg_rewind để sync data nếu có divergence
Bắt đầu streaming replication từ Node 2
4.5。タイムライン設定 (重要なパラメータ)
# patroni.yml
bootstrap:
dcs:
ttl: 30                    # Leader lease time (30s)
loop_wait: 10              # Check interval (10s)
retry_timeout: 10          # Retry time
maximum_lag_on_failover: 1048576  # Max lag for failover candidate (1MB)
説明:
ttl: 30: リーダーは更新する必要があります30 秒ごとにリースします。そうでない場合は、デッドとみなされますloop_wait: 10: Patroni は 10 秒ごとに健全性をチェック- フェイルオーバー トリガー: (ttl -loop_wait) が終了したとき → ~20~30代
5。概要_
重要なポイント_
- 高可用性は必須__HTMLTAG_857___実稼働システムでダウンタイムとデータ損失を削減するには
- ストリーミング レプリケーション + 自動フェイルオーバー_ は、PostgreSQL で最も一般的な HA 方法です_
- Patroni が最良の選択__HTMLTAG_865___ 現在のほとんどのユースケースには次のとおりです:
- セットアップと保守が簡単
- 自動スマートフェイルオーバー__HTMLTAG_870__
- REST 強力な API__HTMLTAG_872__
- クラウド/K8 との優れた統合
- 3 ノード アーキテクチャ (Patroni + etcd による)
- 自動フェイルオーバー (RTO < 30 秒)
- 同期レプリケーションによるデータ損失ゼロ
- スプリットブレイン防止
- 読み取りのスケーラビリティワークロード
宿題
- さまざまな可用性レベル (99%、99.9%、99.99%) でのシステムのダウンタイムを計算
- 特定のユースケース (ノード数、データセンター、RTO/RPO 要件) の HA アーキテクチャ
- HA を使用する場合とビジネスのダウンタイムを許容する場合のコストを比較
次のレッスンの準備
レッスン 2 で詳しく説明します。 ストリーミング レプリケーション - PostgreSQL HA の基礎:
- WAL の詳細な動作メカニズム
- 同期レプリケーションと非同期レプリケーション
- レプリケーションスロット
- ラボ: 手動レプリケーション設定_