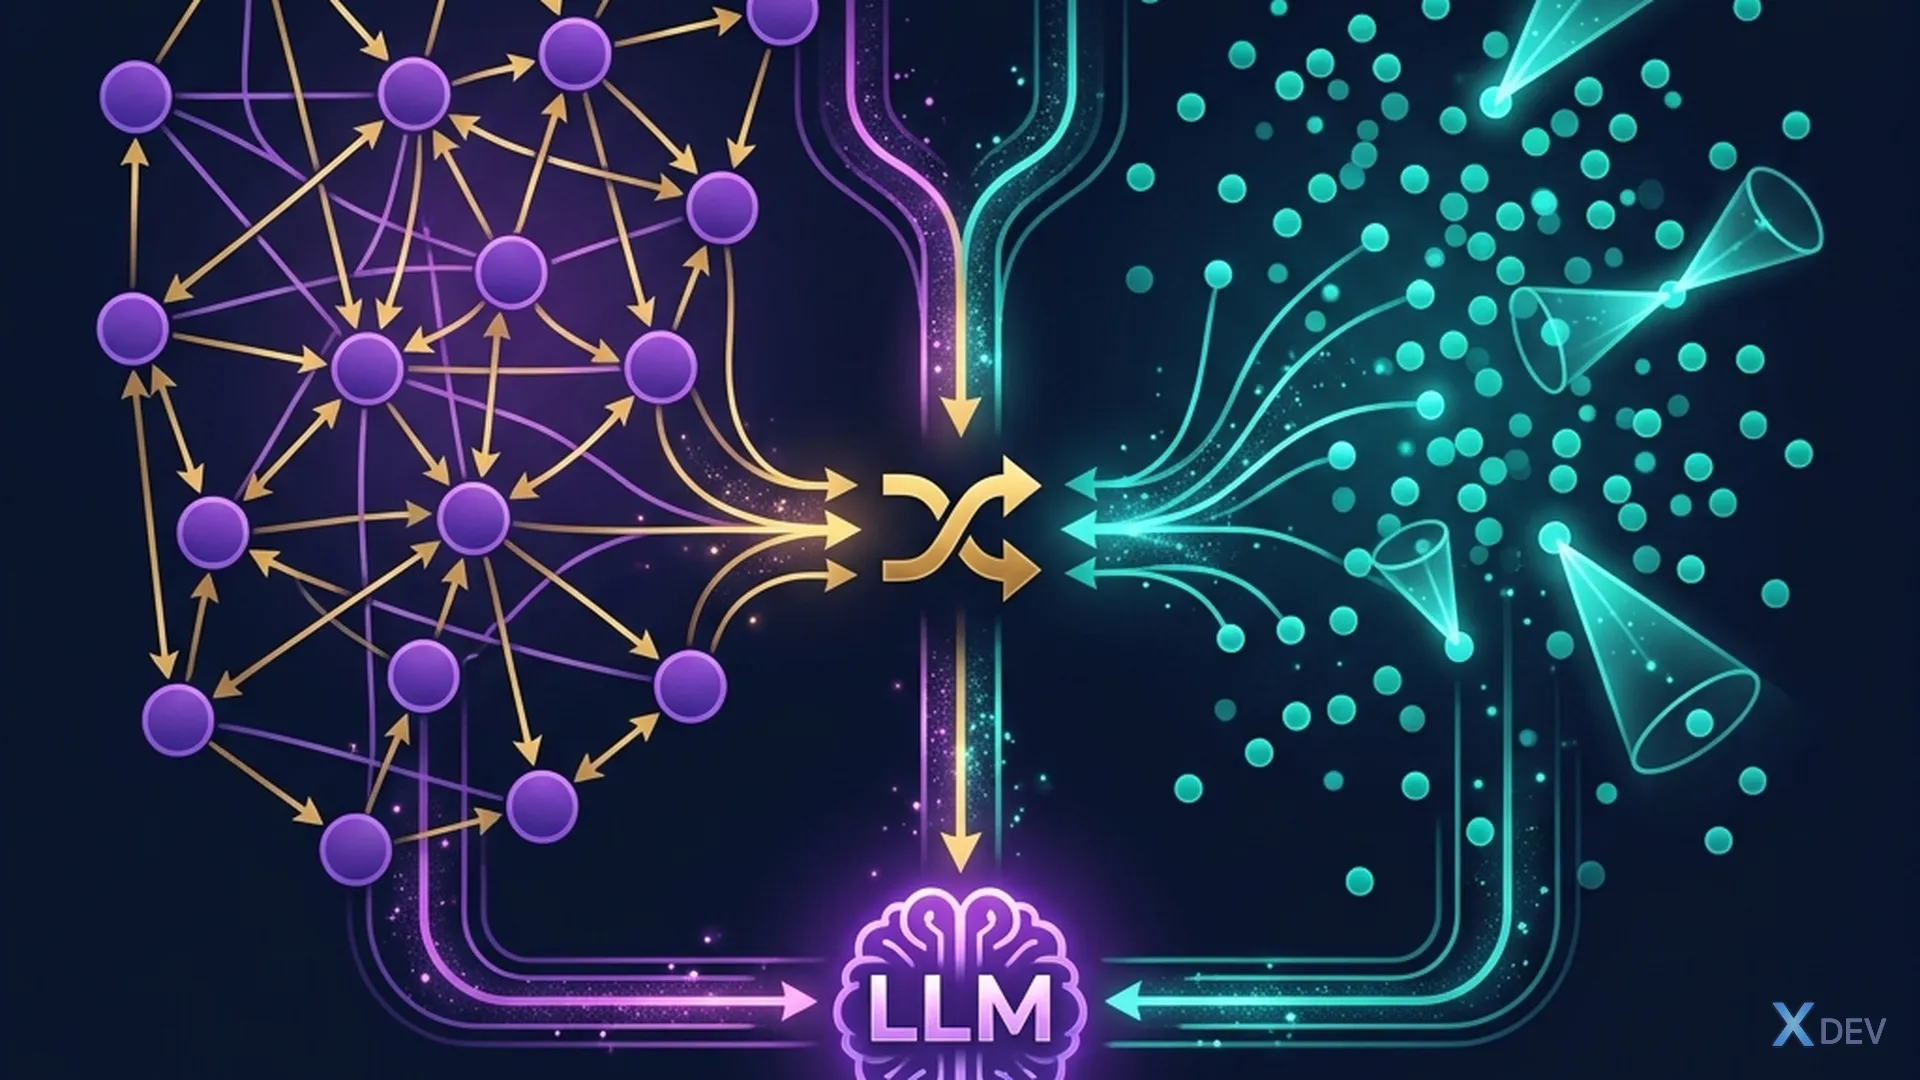
はじめに
ベクトル検索は セマンティクス に従って検索しますが、エンティティ間の 関係は理解できません。質問にマルチホップ推論が必要な場合、ベクトル検索は失敗することがよくあります。
例: 「プロジェクトマネージャーのアルファの上司は誰ですか?」
- ベクトル検索で「Alpha project」を含む段落が見つかる → PM が Minh であることがわかる
- しかし、「Minh の上司」は別のチャンクにあり、意味的に無関係であるため、見つかりません。
- ナレッジグラフ:
Minh --[quản_lý]--> Alpha、Hùng --[quản_lý]--> Minh→今すぐ返信してください!
この記事の内容は次のとおりです。
- ナレッジ グラフ — ドキュメントからエンティティ関係グラフを構築する
- Graph RAG — マルチホップ推論のためにグラフとベクトルを組み合わせます
- Microsoft GraphRAG — 実稼働対応のフレームワーク
1. 基礎知識グラフ
1.1 概念
Knowledge Graph = Đồ thị gồm:
  - Nodes (entities): Người, Địa điểm, Dự án, Phòng ban...
  - Edges (relationships): quản_lý, thuộc_về, làm_việc_tại...

Ví dụ:
  [Minh] ──quản_lý──→ [Dự án Alpha]
  [Minh] ──thuộc_về──→ [Phòng IT]
  [Hùng] ──quản_lý──→ [Minh]
  [Hùng] ──thuộc_về──→ [Ban Giám đốc]
  [Dự án Alpha] ──sử_dụng──→ [Python]
  [Dự án Alpha] ──deadline──→ [2025-06-30]
1.2 テキストからナレッジグラフを抽出する
"""Dùng LLM để trích xuất entities và relationships"""
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)

EXTRACT_PROMPT = ChatPromptTemplate.from_messages([
    ("system", """Trích xuất entities và relationships từ đoạn văn.
Output dạng JSON:
{{
  "entities": [
    {{"name": "...", "type": "Person|Org|Project|Location|Tech"}},
  ],
  "relationships": [
    {{"source": "...", "relation": "...", "target": "..."}},
  ]
}}"""),
    ("human", "{text}"),
])

text = """Minh là Project Manager của dự án Alpha, thuộc phòng IT.
Dự án Alpha sử dụng Python và PostgreSQL, deadline 30/6/2025.
Minh báo cáo trực tiếp cho Giám đốc Hùng."""

result = (EXTRACT_PROMPT | llm).invoke({"text": text})
print(result.content)
# {
#   "entities": [
#     {"name": "Minh", "type": "Person"},
#     {"name": "Alpha", "type": "Project"},
#     {"name": "Phòng IT", "type": "Org"},
#     {"name": "Hùng", "type": "Person"},
#     {"name": "Python", "type": "Tech"},
#     {"name": "PostgreSQL", "type": "Tech"}
#   ],
#   "relationships": [
#     {"source": "Minh", "relation": "quản_lý", "target": "Alpha"},
#     {"source": "Minh", "relation": "thuộc_về", "target": "Phòng IT"},
#     {"source": "Alpha", "relation": "sử_dụng", "target": "Python"},
#     {"source": "Alpha", "relation": "sử_dụng", "target": "PostgreSQL"},
#     {"source": "Minh", "relation": "báo_cáo", "target": "Hùng"}
#   ]
# }
1.3 Neo4j に保存する
"""Lưu Knowledge Graph vào Neo4j"""
from neo4j import GraphDatabase

driver = GraphDatabase.driver(
    "bolt://localhost:7687",
    auth=("neo4j", "password")
)

def create_graph(entities, relationships):
    with driver.session() as session:
        # Tạo nodes
        for entity in entities:
            session.run(
                "MERGE (n:{type} {{name: $name}})".format(type=entity["type"]),
                name=entity["name"]
            )

        # Tạo edges
        for rel in relationships:
            session.run(
                """MATCH (a {{name: $source}}), (b {{name: $target}})
                   MERGE (a)-[:{relation}]->(b)""".format(relation=rel["relation"]),
                source=rel["source"],
                target=rel["target"]
            )

# Query: "Ai quản lý dự án Alpha?"
result = session.run("""
    MATCH (person)-[:quản_lý]->(project {name: 'Alpha'})
    RETURN person.name
""")
# → "Minh"

# Multi-hop: "Sếp của người quản lý dự án Alpha?"
result = session.run("""
    MATCH (boss)-[:quản_lý]->(manager)-[:quản_lý]->(project {name: 'Alpha'})
    RETURN boss.name
""")
# → "Hùng" ← Vector search KHÔNG THỂ trả lời!
💡 演習 1: テキスト (少なくとも 10 個のエンティティ) からナレッジ グラフを抽出します。 Neo4j に保存します。 3 つのマルチホップの質問を試みます。
2. グラフ RAG — グラフ + ベクトルの組み合わせ
2.1 アーキテクチャ
                    User Query
                        │
            ┌───────────┼───────────┐
            │                       │
    ┌───────┴───────┐       ┌───────┴───────┐
    │  Vector Store │       │  Knowledge    │
    │  (semantic)   │       │  Graph (Neo4j)│
    └───────┬───────┘       └───────┬───────┘
            │                       │
     Semantic chunks         Graph traversal
     (context rộng)          (quan hệ chính xác)
            │                       │
            └───────────┬───────────┘
                        │
                   Merge context
                        │
                      LLM → Answer
2.2 LangChain + Neo4j による実装
"""Graph RAG: kết hợp Neo4j graph + Chroma vector"""
from langchain_community.graphs import Neo4jGraph
from langchain.chains import GraphCypherQAChain
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="gpt-4o", temperature=0)

# Neo4j graph
graph = Neo4jGraph(
    url="bolt://localhost:7687",
    username="neo4j",
    password="password",
)

# GraphCypherQAChain: LLM tự viết Cypher query
graph_chain = GraphCypherQAChain.from_llm(
    llm=llm,
    graph=graph,
    verbose=True,
)

# Query multi-hop
result = graph_chain.invoke(
    "Liệt kê tất cả tech stack mà team của Hùng sử dụng?"
)
# LLM tự generate Cypher:
# MATCH (Hùng {name:'Hùng'})-[:quản_lý]->(person)
#       -[:quản_lý]->(project)-[:sử_dụng]->(tech)
# RETURN DISTINCT tech.name
2.3 ハイブリッド: グラフ コンテキスト + ベクトル コンテキスト
"""Kết hợp graph traversal + vector search"""
def hybrid_graph_rag(question, graph_chain, vector_retriever, llm):
    # 1. Graph context (quan hệ, facts)
    try:
        graph_context = graph_chain.invoke(question)["result"]
    except Exception:
        graph_context = "Không tìm thấy thông tin trong graph."

    # 2. Vector context (nội dung chi tiết)
    vector_docs = vector_retriever.invoke(question)
    vector_context = "\n".join([d.page_content for d in vector_docs])

    # 3. Merge và trả lời
    prompt = f"""Dựa trên thông tin sau, trả lời câu hỏi.

**Thông tin từ Knowledge Graph:**
{graph_context}

**Thông tin từ tài liệu:**
{vector_context}

**Câu hỏi:** {question}
**Trả lời:**"""

    return llm.invoke(prompt).content
3. Microsoft GraphRAG
3.1 GraphRAG アーキテクチャ
Microsoft GraphRAG はパイプライン全体を自動化します。
Documents → Entity Extraction → Community Detection → Summarization
                │                       │                    │
         Entities &              Groups of related      Summary per
         Relationships           entities (Leiden)       community
                │                       │                    │
                └───────────────────────┼────────────────────┘
                                        │
                                 Query modes:
                            Local search │ Global search
                            (specific)   │ (broad themes)
3.2 Microsoft GraphRAG のセットアップ
# Cài đặt
pip install graphrag

# Init project
graphrag init --root ./my-rag-project

# Cấu hình settings.yaml
# - llm: model, api_key
# - embeddings: model
# - chunks: size, overlap
"""Index tài liệu"""
# graphrag index --root ./my-rag-project
# → Tự extract entities, build graph, detect communities, summarize

"""Query"""
# Local search: tìm thông tin cụ thể
# graphrag query --root ./my-rag-project --method local \
#   --query "Ai quản lý dự án Alpha?"

# Global search: tổng hợp theo chủ đề
# graphrag query --root ./my-rag-project --method global \
#   --query "Tóm tắt các dự án đang triển khai và tech stack?"
3.3 ローカル検索とグローバル検索
| モード | 仕組み | いつ使用するか |
|---|---|---|
| ローカル | 関連するエンティティを検索 → グラフをトラバース → コンテキスト | 具体的で事実に基づく質問 |
| グローバル | コミュニティの概要を使用する → 概要 | 一般質問、テーマ |
4. GraphRAG と Vector RAG の比較
4.1 ベンチマーク
| 基準 | ベクトルラグ | グラフ RAG | ハイブリッド |
|---|---|---|---|
| シングルホップクエリ | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐ |
| マルチホップクエリ | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 要約 | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| セットアップの複雑さ | ⭐ (シンプル) | ⭐⭐⭐ (複雑) | ⭐⭐⭐⭐ |
| インデックス作成のコスト | 低い | Cao (LLM 抽出物) | 曹操 |
| クエリのレイテンシ | 速い | 遅い | 平均 |
4.2 Graph RAG をいつ使用するか?
✅ Dùng Graph RAG khi:
  - Câu hỏi multi-hop, cần suy luận qua nhiều entities
  - Tài liệu có nhiều quan hệ phức tạp (org chart, supply chain)
  - Cần tổng hợp theo chủ đề (global search)
  - Domain có entity types rõ ràng (legal, medical, HR)

❌ KHÔNG cần Graph RAG khi:
  - Câu hỏi đơn giản, 1-hop
  - Tài liệu ít quan hệ (blog posts, FAQ)
  - Budget thấp (indexing tốn nhiều LLM calls)
  - Latency-critical (graph query chậm hơn vector)
💡 演習 2: Microsoft GraphRAG を使用してドキュメント フォルダーのインデックスを作成します。 5 つの具体的な質問 + 5 つの一般的な質問について、ローカル検索結果とグローバル検索結果を比較します。
概要
| コンセプト | 覚えておいてください |
|---|---|
| ナレッジ グラフ | エンティティ関係グラフ、マルチホップに適しています |
| エンティティの抽出 | LLM を使用してテキストからエンティティと関係を抽出する |
| Neo4j | グラフ データベース、Cypher を使用したクエリ |
| GraphCypherQAChain | LLM は独自の Cypher クエリを作成します。 |
| Microsoft GraphRAG | フレームワーク自動: 抽出 → コミュニティ → 要約 |
| ローカル vs グローバル | ローカル = 具体的な事実、グローバル = テーマ |
| ハイブリッド | グラフの事実 + ベクトルのコンテキスト = 最良の結果 |
一般的な演習
- ✅ 2 つの小さな演習 (1、2) を完了します。
- 完全なグラフ パイプライン: 10 個以上のドキュメントから独自のナレッジ グラフを構築します。 LLM を使用してエンティティを抽出 → Neo4j を保存 → GraphCypherQAChain を実装 → 10 個のマルチホップ センテンスをテストします。
- ハイブリッド システム: 組み合わせたシステムを構築します: Neo4j グラフ + クロマ ベクトル。ルーターは質問の種類に応じてデータ ソースを自動的に選択します。純粋なベクトル RAG と精度を比較します。
- 視覚化: Neo4j からグラフをエクスポート → NetworkX または Neo4j ブラウザを使用して視覚化します。スクリーンショット 1 つのサブグラフには少なくとも 20 個のノードがあります。
次の記事: マルチモーダル RAG — ドキュメント内の画像、表、グラフを処理します — RAG はテキストだけを扱うものではありません。