ATLAS 解決了「定義世代」與基礎「characterization」。當你需要進階統計方法(causal inference、ML)時,就需要 HADES — OHDSI 官方的 R 套件集。本文總覽堆疊、PLE/PLP 工作流程,以及如何發表網絡研究。
1. HADES 是什麼
40+ R 套件,MIT 授權,可從 CRAN 或 GitHub 安裝。
2. 安裝
# 安裝 Strategus(orchestrator) - 會帶入其他套件
install.packages("Strategus")

# 或個別安裝
install.packages(c(
  "DatabaseConnector", "SqlRender", "FeatureExtraction",
  "CohortMethod", "PatientLevelPrediction", "Characterization",
  "CohortDiagnostics", "Achilles", "DataQualityDashboard"
))

# Postgres 的 JDBC driver
DatabaseConnector::downloadJdbcDrivers("postgresql")
需求:R >= 4.2、Java >= 11,百萬人以上資料集需 16GB+ RAM。
3. 連接資料庫
library(DatabaseConnector)
connectionDetails <- createConnectionDetails(
  dbms = "postgresql",
  server = "host/db_name",
  user = "omop_reader",
  password = Sys.getenv("OMOP_PASSWORD"),
  port = 5432,
  pathToDriver = "~/jdbcDrivers"
)

cdmDatabaseSchema <- "cdm"
cohortDatabaseSchema <- "results"
4. CohortMethod — 病人層級估計(PLE)
PLE 回答:「藥物 A 與藥物 B,哪個較少引起副作用 X?」 屬於比較性療效研究。
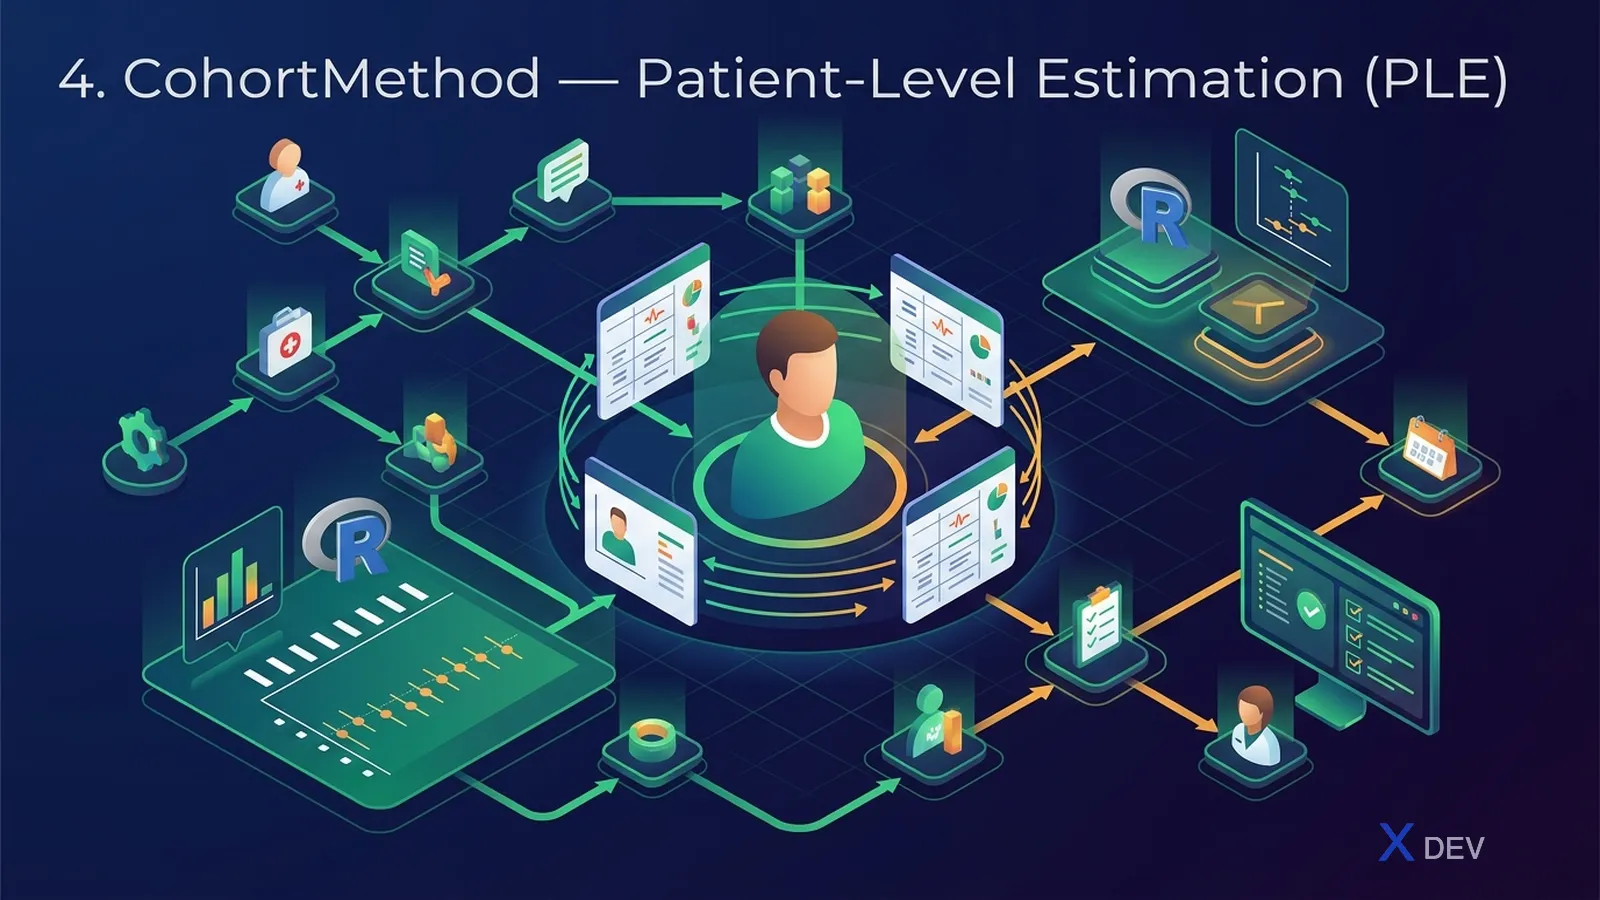
4.1 PLE 工作流程
library(CohortMethod)

# 1. 取得資料
cmData <- getDbCohortMethodData(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = cdmDatabaseSchema,
  targetId = 1,         # 世代 A id
  comparatorId = 2,     # 世代 B id
  outcomeIds = c(3),    # outcome 世代
  covariateSettings = createDefaultCovariateSettings()
)

# 2. 傾向分數模型
ps <- createPs(
  cohortMethodData = cmData,
  prior = createPrior("laplace", exclude = c(0))
)

# 3. 1:1 最近鄰配對
strataPop <- matchOnPs(ps, maxRatio = 1)

# 4. Outcome 模型(Cox)
outcomeModel <- fitOutcomeModel(
  population = strataPop,
  modelType = "cox",
  stratified = TRUE
)

summary(outcomeModel)
# Hazard Ratio: 0.85 (95% CI 0.78-0.93)
4.2 OHDSI 標準診斷
採信結果之前,必須檢查:
- Equipoise:兩世代 PS 重疊充足
- Covariate balance:配對後所有 covariate 的 SMD < 0.1
- Negative control distribution:負對照 HR 應接近 1
- Empirical calibration:依系統性誤差調整 HR
OHDSI 標準:只發表通過所有診斷的結果。
5. PatientLevelPrediction(PLP)— ML
PLP 回答:「病人 X 在未來 T 天內有多少 % 可能罹患 Y?」
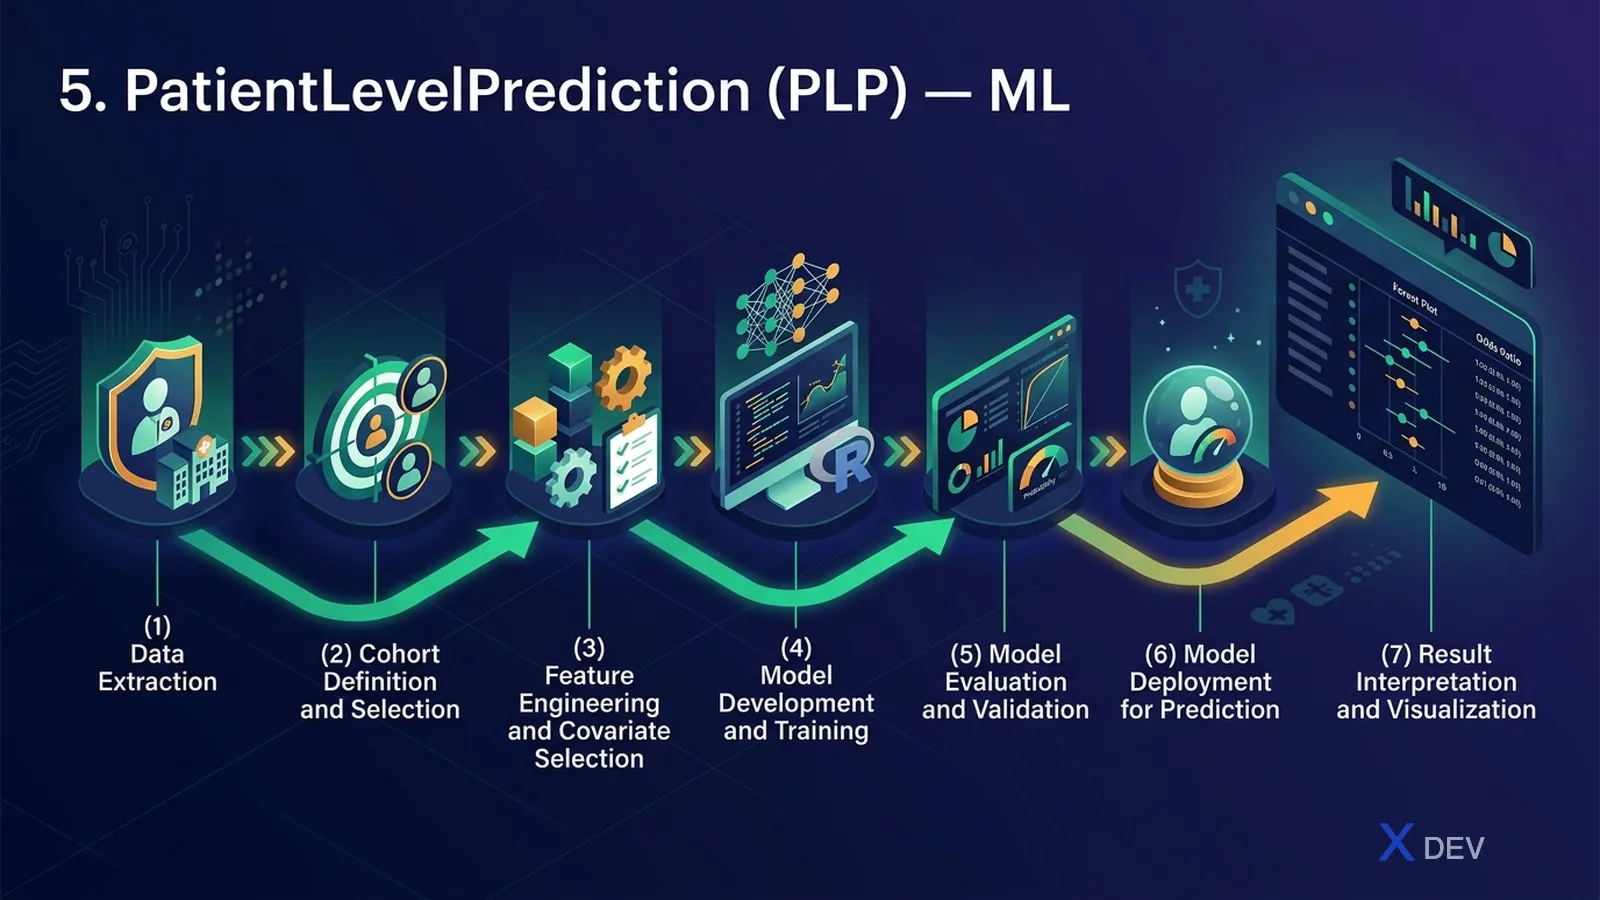
5.1 PLP 程式
library(PatientLevelPrediction)

# 1. 取得 plpData
plpData <- getPlpData(
  databaseDetails = createDatabaseDetails(...),
  covariateSettings = createDefaultCovariateSettings(),
  cohortId = 1,    # at-risk population
  outcomeIds = 2,  # outcome
  ...
)

# 2. 母體
population <- createStudyPopulation(
  plpData = plpData,
  outcomeId = 2,
  riskWindowStart = 1,
  riskWindowEnd = 365,
  requireTimeAtRisk = TRUE
)

# 3. 訓練 Lasso
modelSettings <- setLassoLogisticRegression()
results <- runPlp(
  plpData = plpData,
  population = population,
  modelSettings = modelSettings,
  splitSettings = createDefaultSplitSetting(splitSeed = 42)
)

# 4. 檢視
viewPlp(results)
# AUC = 0.78, calibration intercept = -0.05
5.2 外部驗證
External validation = 在 CDM A 訓練的模型 → 在 CDM B(同 schema、不同資料)上預測。這是臨床 ML 的金標準 — 證明模型可推廣。
externalValidatePlp(
  plpResult = results,
  validationDatabaseDetails = list(otherCdmDetails)
)
6. Characterization(進階世代比較)
library(Characterization)

# Setup
cSettings <- createCharacterizationSettings(
  timeAtRiskSettings = createTimeAtRiskSettings(
    riskWindowStart = 1, riskWindowEnd = 365
  ),
  dechallengeRechallengeSettings = createDechallengeRechallengeSettings(
    targetIds = c(1, 2),
    outcomeIds = c(3)
  ),
  aggregateCovariateSettings = createAggregateCovariateSettings(
    targetIds = c(1, 2), outcomeIds = c(3)
  )
)

runCharacterizationAnalyses(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = cdmDatabaseSchema,
  characterizationSettings = cSettings,
  outputDirectory = "char_results/"
)
輸出:time-to-event、dechallenge-rechallenge(藥物-事件因果)、世代 A vs B 的彙總 covariate。
7. SelfControlledCaseSeries (SCCS)
當沒有對照組時使用 — 病人作為自己的對照(比較暴露期 vs 未暴露期)。適合使用人數少藥物的藥物監視。
library(SelfControlledCaseSeries)

sccsData <- getDbSccsData(
  connectionDetails = connectionDetails,
  cdmDatabaseSchema = cdmDatabaseSchema,
  outcomeIds = c(3),
  exposureIds = c(1)
)

sccsModel <- fitSccsModel(...)
8. Strategus — 編排多種方法
Strategus 是 JSON config + R 工作流,可為單一研究執行整個 pipeline(DQ → CohortDiagnostics → PLE → PLP → Char)。
library(Strategus)

# 1. 定義 modules
analysisSpecifications <- createEmptyAnalysisSpecificiations() %>%
  addCharacterizationModuleSpecifications(...) %>%
  addCohortMethodModuleSpecifications(...) %>%
  addPatientLevelPredictionModuleSpecifications(...)

# 2. 在本地 CDM 執行
execute(
  analysisSpecifications = analysisSpecifications,
  executionSettings = createCdmExecutionSettings(
    workDatabaseSchema = "results",
    cdmDatabaseSchema = "cdm",
    workFolder = "tmp/work",
    resultsFolder = "tmp/results"
  )
)
輸出 schema 一致 → 可上傳至中央伺服器做 meta-analysis。
9. 網絡研究模式
越南可以以 Site 角色加入 — 不需高深的程式技能,只需 CDM + 執行 R 套件即可。
10. EvidenceSynthesis(meta-analysis)
當有 N 個 site 的結果時:
library(EvidenceSynthesis)

# 輸入:每個 site 的 HR + log SE
results <- data.frame(
  site = c("VN", "EU1", "EU2", "US1"),
  logRr = c(-0.16, -0.20, -0.18, -0.22),
  seLogRr = c(0.05, 0.04, 0.03, 0.02)
)

# 隨機效應 meta-analysis
meta <- computeBayesianMetaAnalysis(results)
plotMetaAnalysisForest(meta, results)
11. HADES 常見陷阱
- ❌ 忘記負對照 → 系統性偏差未調整
- ❌ PLP 訓練未做外部驗證 → overfit 不會被發現
- ❌ PS 模型未含關鍵 confounder → 偏差
- ❌ 目標世代與對照世代重疊 → 嚴重偏差
- ❌ 配對後未檢查 covariate balance → 分析無意義
- ❌ Test set 因 feature extraction 滲漏 → AUC 假性偏高
12. HADES 文件
- Book of OHDSI 第 12-15 章(PLE、PLP、SCCS、網絡研究)
- HADES 網站:ohdsi.github.io/Hades/
- OHDSI Forum:forums.ohdsi.org
- Strategus 教學影片
- Atlas Demo 上的 case studies
13. HADES 學習路徑
- 學 OMOP SQL 與 ATLAS(1 個月)
- R + tidyverse 基礎(2 週)
- CohortDiagnostics — 為 1 個世代執行診斷(1 週)
- CohortMethod tutorial(以 Eunomia 練習,2 週)
- PatientLevelPrediction tutorial(2 週)
- 以 contributor 身份加入 1 項網絡研究(1-2 個月)
- 主導 1 個小型研究(3-6 個月)
14. 越南使用情境
| 問題 | 方法 |
|---|---|
| 越南人最佳的高血壓治療策略? | CohortMethod (PLE) |
| 預測哪些糖尿病病人會再住院? | PatientLevelPrediction (PLP) |
| 比較癌症的流行病學與西方的差異 | Characterization |
| 監控新藥上市後的副作用 | SelfControlledCaseSeries |
| 加入 DARWIN EU 研究 | Strategus + 分享彙總結果 |
結論
HADES 將 CDM 變成完整的 RWE 實驗室。投入學 HADES = 投入成為真正的 OHDSI Practitioner。越南有絕佳機會參與 EHDEN/DARWIN/N3C 網絡研究。