 AI
Ollama + MLX:在 Mac 上透過 Apple Silicon 本地執行 AI,速度提升 3 倍——2026 完整指南
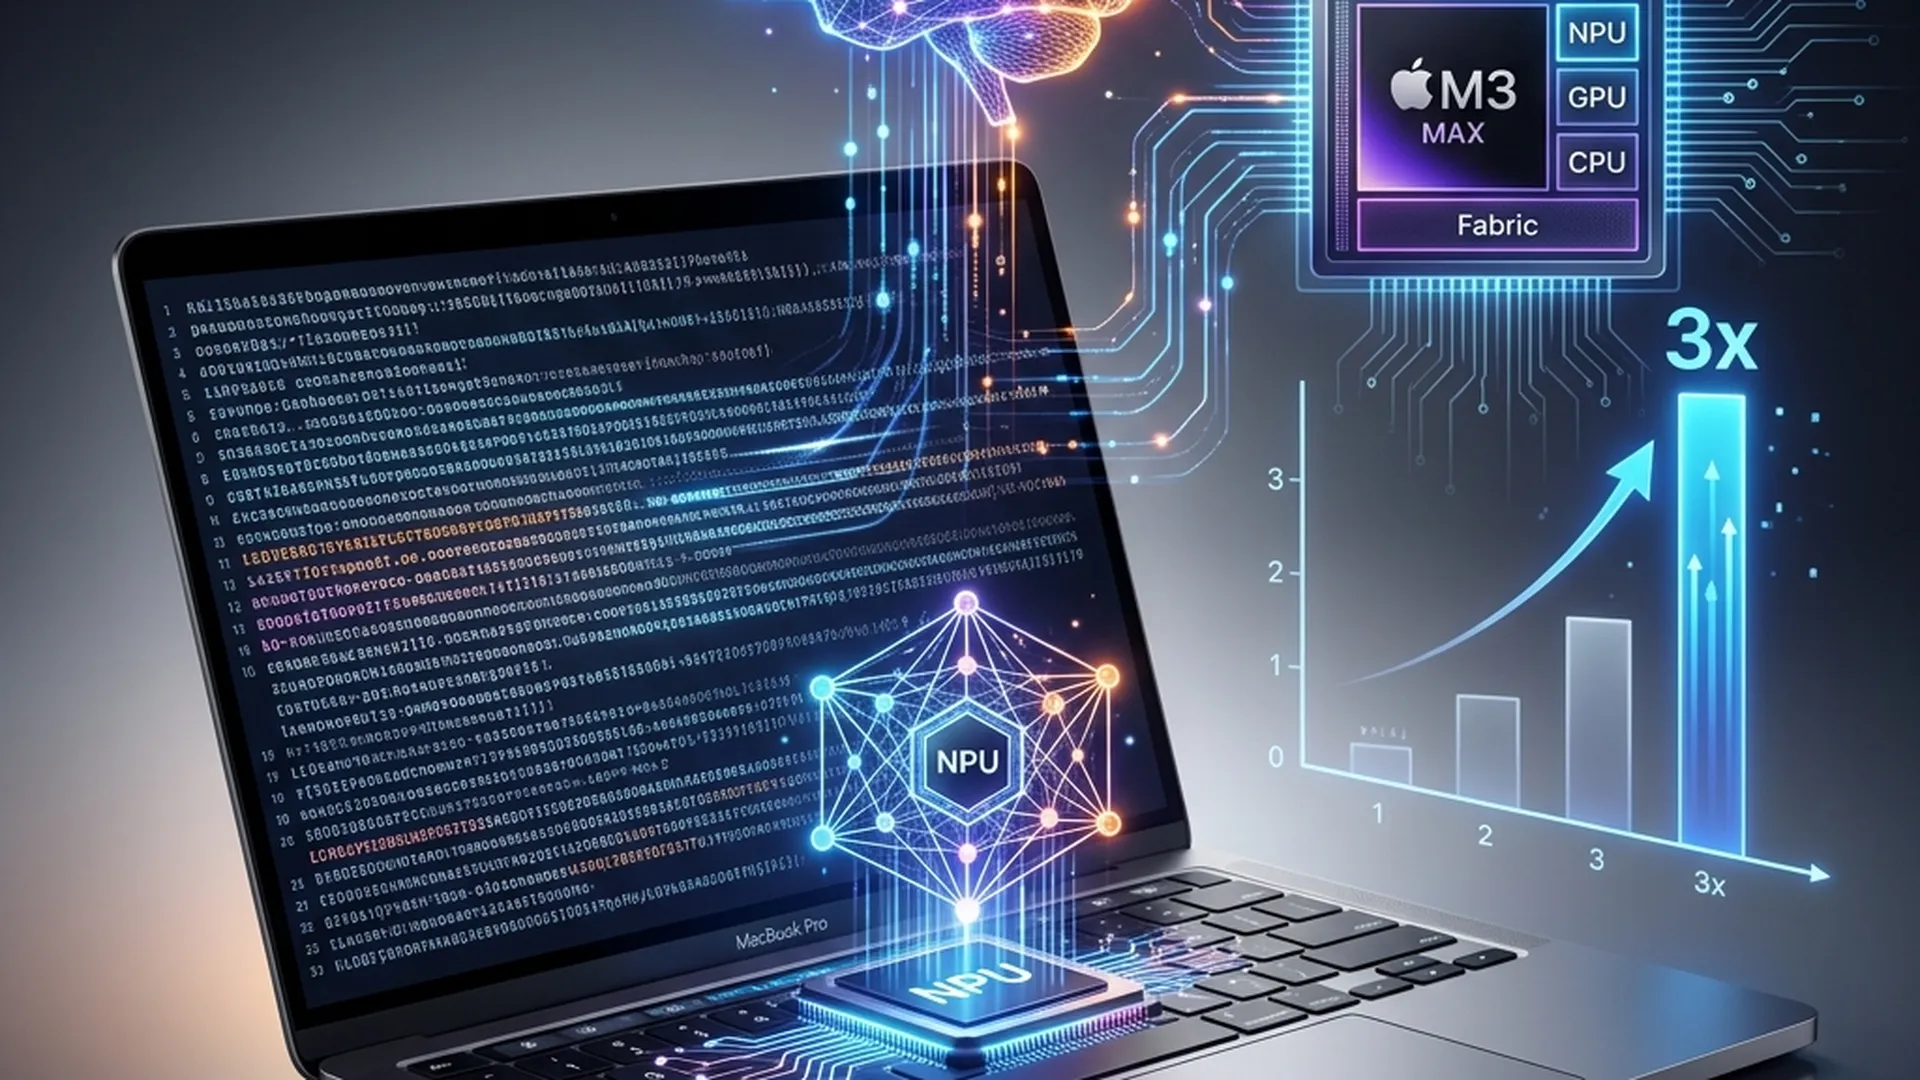
Ollama 0.19 整合 Apple 的 MLX 後端——在 M5 上實現解碼速度提升 93%、預填充速度提升 57%。全面深入分析統一記憶體架構,涵蓋 M1 到 M5 的實測效能數據,以及充分發揮 Apple Silicon 潛力的逐步設定指南。
 Duy Tran18 分鐘
3 個項目
AIOllama 0.19 整合 Apple 的 MLX 後端——在 M5 上實現解碼速度提升 93%、預填充速度提升 57%。全面深入分析統一記憶體架構,涵蓋 M1 到 M5 的實測效能數據,以及充分發揮 Apple Silicon 潛力的逐步設定指南。
Duy Tran18 分鐘
在 Apple Silicon 上使用 Gemma 4 建構本地 AI 技術棧的實戰系列。涵蓋 Ollama 設定、API 整合、RAG 管線、混合檢索,到內部環境的可觀測性與安全強化。
使用 Ollama 和 MLX 在 Mac Apple Silicon (M1/M2/M3/M4) 上本地運行 LLM 的綜合指南。從初始安裝到使用 MLX 框架進行 3 倍加速、管理多個模型、將 API 整合到應用程式以及優化 GPU/RAM 效能。全部親自動手,隱私第一,無需網路。