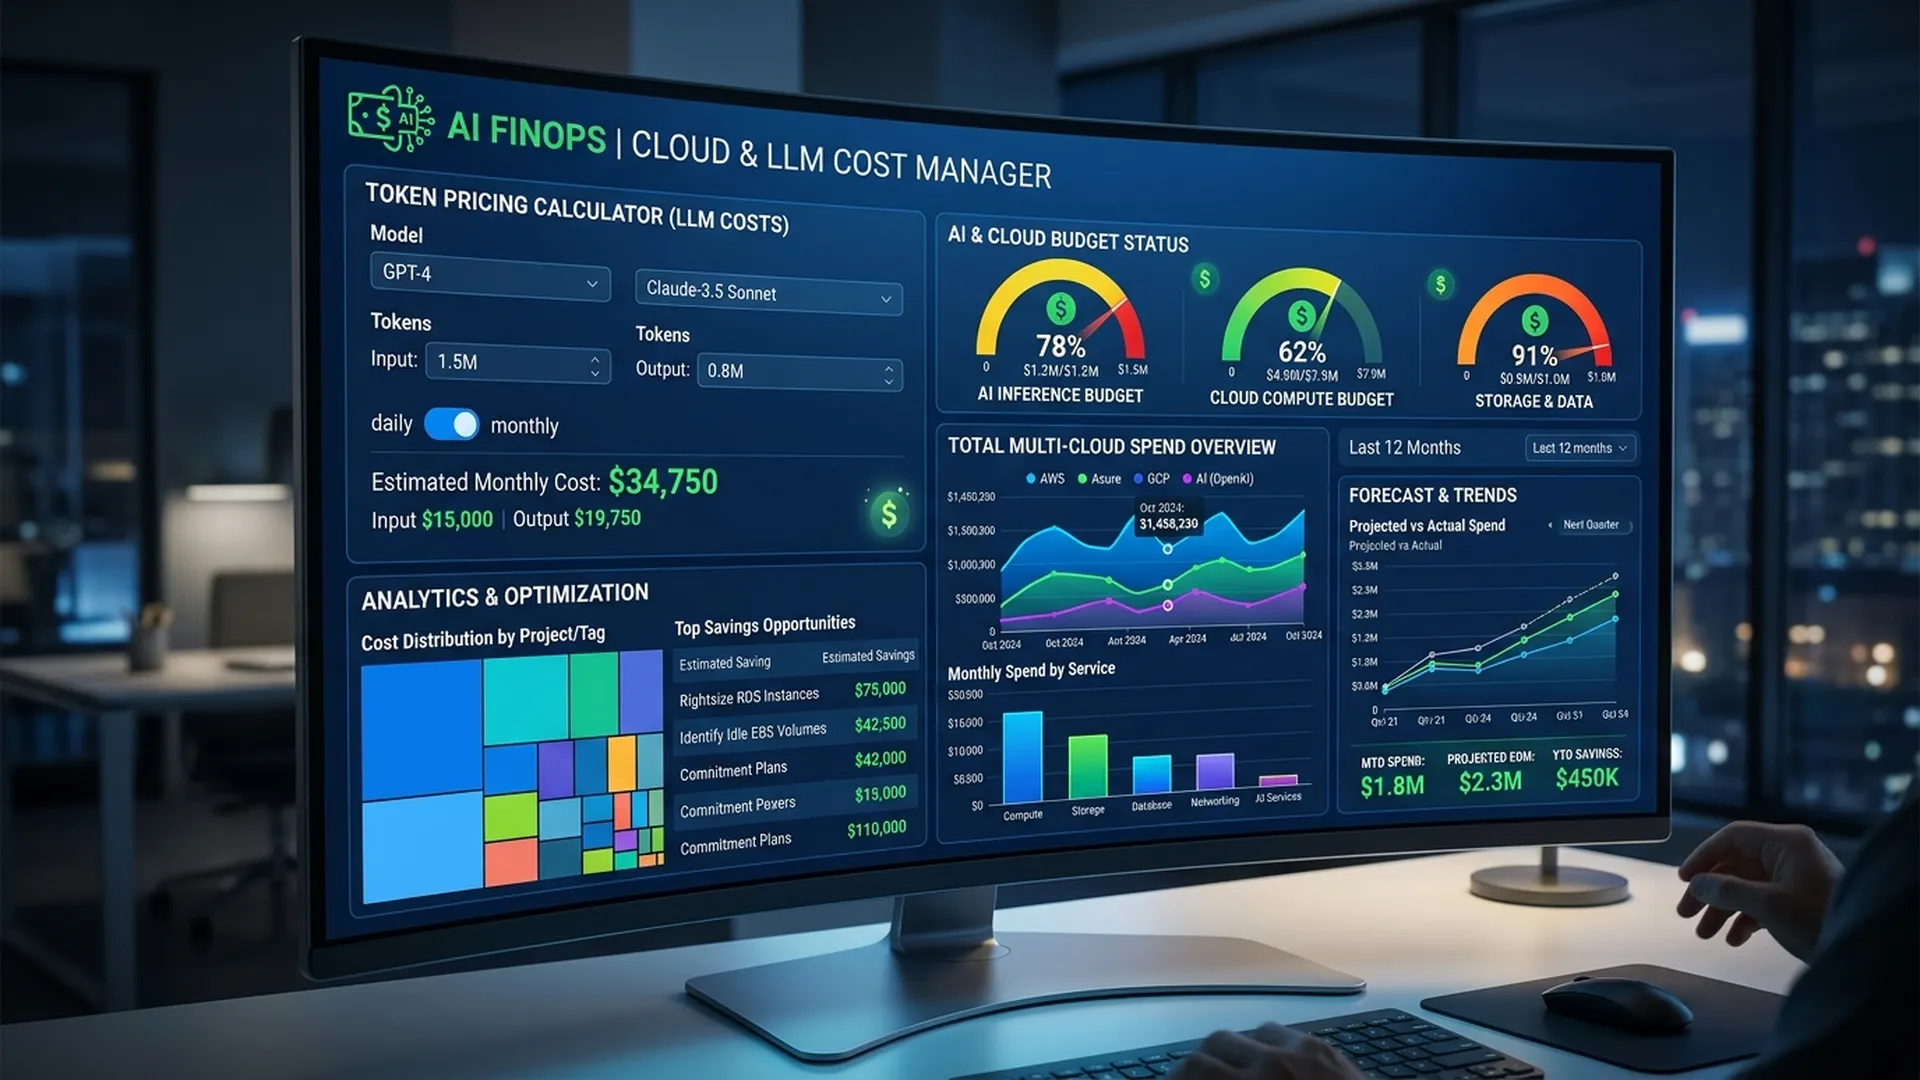
BA が「AI にいくらかかるか」を技術チーム任せにするのは誤りです。stakeholder に「この機能は投資価値があるか」と聞かれたとき、BA は「tech に確認します」ではなく、数値で答える必要があります。
1. BA が把握すべき AI コストの種類
1.1 Token-based Pricing(LLM API)
多くの LLM API は token 単位で課金します(文字数でも単語数でもない)。
1 token ~= 英語 4 文字 ~= 3/4 単語
"Hello world" ~= 2 tokens
A4 1 ページ ~= 500-700 tokens
価格例(参考、2026年5月):
| Model | Input | Output | 用途 |
|---|---|---|---|
| GPT-4o mini | $0.15/1M tokens | $0.60/1M tokens | 高ボリューム、単純タスク |
| GPT-4o | $2.50/1M tokens | $10/1M tokens | 複雑タスク、高品質 |
| Claude Sonnet | $3/1M tokens | $15/1M tokens | reasoning、coding、analysis |
| Gemini Flash | $0.075/1M tokens | $0.30/1M tokens | 低コスト、汎用用途 |
1.2 コスト見積もり式
Monthly cost = Daily requests x Avg tokens/request x Cost per token x 30 days

例: サポート chatbot
- 500 requests/day
- 800 input + 400 output = 1200 tokens/request
- Model: GPT-4o mini ($0.15 input, $0.60 output)

Cost = 500 x [(800 x $0.15) + (400 x $0.60)] / 1,000,000 x 30
     = 500 x [($0.00012) + ($0.00024)] x 30
     = 500 x $0.00036 x 30
     = $5.40/月(chatbot としては非常に低コスト)
2. Latency と Compute Cost
API コスト以外に次も含めます。
| Cost Type | 説明 | BA が知るべきこと |
|---|---|---|
| Compute (GPU) | self-hosted で model を実行 | GPU 種別により $0.5-5/時間 |
| Embedding | vector search、RAG | $0.02/1M tokens(低コスト) |
| Storage | vector DB、model weights | ボリュームにより $20-100/月 |
| Inference latency | 待ち時間による UX コスト | 一般に P95 < 3s が許容目安 |
3. Cloud AI API と Self-hosted の比較
| 観点 | Cloud API | Self-hosted |
|---|---|---|
| 初期費用 | $0 | $10K-100K+(GPU) |
| 変動費 | token 従量課金 | 電力 + cloud GPU |
| Latency | 0.5-3s | 0.1-1s(local GPU) |
| Data privacy | vendor に送信 | 社内保持 |
| 運用負荷 | ほぼ不要 | MLOps チームが必要 |
| 適する場面 | MVP、低〜中ボリューム | 大規模運用、機微データ |
BA の目安:
- < 1M tokens/month -> ほぼ Cloud API が安い
-
100M tokens/month -> Self-hosted が 6-12 か月で ROI プラス化の可能性
- 医療/金融など分類データ -> Self-hosted が必須の場合あり
4. BA が提案できる FinOps 実践
4.1 Cost Alert 設計
チームに次の設定を要求します。
Alert Level 1: 月次予算の 70% 到達 -> BA + PM に通知
Alert Level 2: 月次予算の 90% 到達 -> leadership に通知
Alert Level 3: 100% 超過時に非クリティカル機能を自動停止(hard cap)
4.2 Token 最適化戦略
コーディング不要で BA が提案できる施策:
| Strategy | 内容 | 削減ポテンシャル |
|---|---|---|
| Prompt caching | system prompt を再利用 | input tokens 30-50% 削減 |
| Model routing | 単純タスクは小型 model を使用 | routine task コスト 60-90% 削減 |
| Context pruning | 不要な履歴を削除 | 1 リクエストあたり 20-40% 削減 |
| Batch processing | 非リアルタイム要求をまとめる | 最大 50% 割引効果 |
| Output length limit | output token 上限を設定 | output コスト 20-30% 削減 |
4.3 ビジネス指標あたりコスト
API コストだけを見ないこと。
Cost per resolved ticket = Monthly AI cost ÷ Tickets resolved by AI
Cost per qualified lead = Monthly AI cost ÷ Leads qualified by AI
Cost savings vs manual = (FTE hours saved x hourly rate) - AI cost
5. BA向け Budget Estimation テンプレート
## AI Feature Cost Estimate
**Feature:** [Name] | **Date:** [YYYY-MM] | **Owner:** [BA]

### Volume Assumptions
| Parameter | Estimate | Source |
|-----------|----------|--------|
| Daily active users | [X] | Analytics/forecast |
| Requests per user per day | [Y] | UX assumption |
| Total daily requests | [XxY] | Calculated |

### Per-Request Cost
| Component | Cost | Notes |
|-----------|------|-------|
| LLM API (input) | $[X]/1K tokens | [Model name] |
| LLM API (output) | $[X]/1K tokens | [Model name] |
| Avg tokens per request | [X] input + [Y] output | Estimated from prototype |
| **Cost per request** | **$[total]** | |

### Monthly Projection
| Scenario | Cost | Notes |
|----------|------|-------|
| Conservative (50% of estimate) | $[X] | Low adoption |
| Base case | $[Y] | Expected |
| Peak (200% of estimate) | $[Z] | Viral/spike |

### ROI Estimate
- Manual cost replaced: $[X]/month
- AI cost: $[Y]/month
- Net savings: $[X-Y]/month
- Break-even: [N] months
まとめ
BA は cloud architecture を深く知らなくても AI コスト見積もりに参加できます。token pricing の理解、cloud と self-hosted の使い分け、cost alert 設計ができれば、business case の精度向上と budget overrun 防止に十分貢献できます。
stakeholder に「この AI 機能はいくらかかるか」と聞かれても、このテンプレートがあれば 30 分以内で回答できます。