過去2年間で、AI Solution Architectはテック業界で最も求められるポジションの一つになりました。GenAI、LLM、そしてすべての製品にAIを統合する需要の爆発的な増加により、企業はもはやモデルを訓練できる人材だけでなく、コンセプトから本番まで、AIシステム全体を設計できる人材を求めています。
しかしこの道のりは簡単ではありません。深い技術スキル、システム思考、ビジネスコミュニケーション能力という希少な組み合わせが必要です。この記事では、空虚な理論ではなく、実践的なロードマップをお伝えします。
1. AI Solution Architectとは?
AI Solution Architectは、組織内のAI/MLソリューションの全体的なアーキテクチャを設計する人物です。ビジネスステークホルダー、データサイエンティスト、MLエンジニア、そしてプラットフォームチームの橋渡し役を担います。
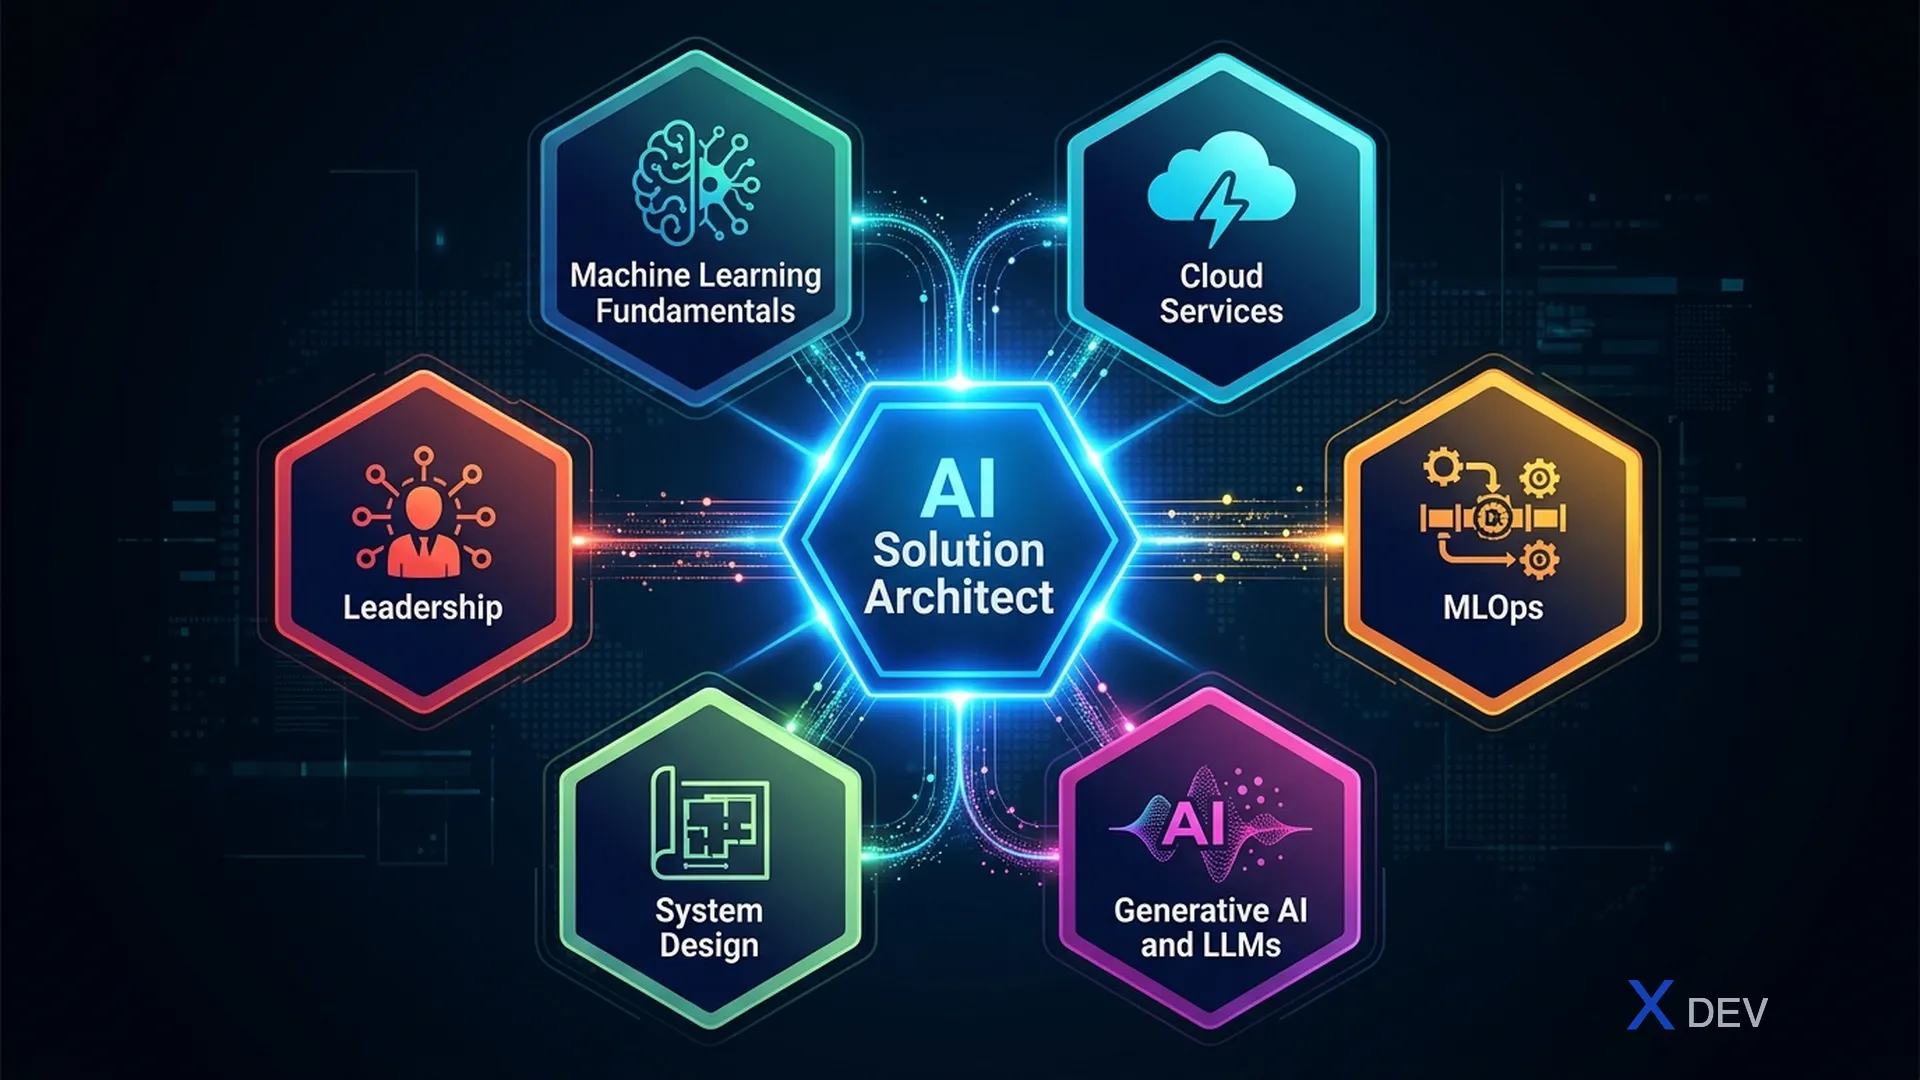
コアの責務
| 領域 | 具体的な業務 |
|---|---|
| ディスカバリー | ビジネス課題の評価、AIが適切なソリューションかの判断、ROIの見積もり |
| アーキテクチャ設計 | エンドツーエンドパイプラインの設計:データ取得→特徴エンジニアリング→学習→サービング→モニタリング |
| 技術選定 | クラウドサービス、フレームワーク、モデルの種類、ベクターデータベース、オーケストレーションツールの選択 |
| ガバナンス | MLOps、モデルレジストリ、A/Bテスト、コンプライアンス(GDPR、AI法)の確立 |
| ステークホルダーコミュニケーション | C-levelへの技術的意思決定の説明、チームへのトレーニング、RFC/ADRドキュメントの作成 |
他のロールとの比較
最初に理解しておくべき重要なことは、AI Solution ArchitectはデータサイエンティストやMLエンジニアを置き換えるのではなく、相乗効果を生む三角形を形成して共同作業するということです。
| ロール | コアフォーカス | 成果物 | タイムホライゾン |
|---|---|---|---|
| データサイエンティスト | リサーチ、実験、プロトタイピング | 訓練済みモデル、研究報告書、実験結果 | 1〜4週間 |
| MLエンジニア | モデルの本番化、パイプライン構築、API | デプロイされたエンドポイント、CI/CDパイプライン、フィーチャーストア | 1〜3ヶ月 |
| AI Solution Architect | システム設計、技術選定、チームの橋渡し | アーキテクチャブループリント、ADR、コストモデル | 3〜12ヶ月 |
| プラットフォーム/クラウドエンジニア | インフラ、K8s、セキュリティ、ネットワーキング | Kubernetesクラスター、VPC、IAMポリシー | 継続的 |
データサイエンティストはモデリングと実験に深く取り組みます。MLエンジニアは本番化とスケーリングを担当します。AI Solution Architectは全体像を把握します。このロールなしにAIチームは機能しません。
いつビジネスはAI Solution Architectを必要とするか?
注意すべき警告サイン:
- データサイエンスチームはモデルを構築できるが、本番環境へのデプロイ方法を誰も知らない
- 複数のAIイニシアティブが存在するが、各チームが独自のアプローチに従い、共通の標準がない
- クラウドAIのコストが予算を超過し、その理由が明確でない
- リーダーシップが1〜2プロジェクトから企業全体へとAIをスケールしたい
- コンプライアンス、モデルバイアス、データガバナンスに関する問題が発生し始めている
2. なぜこのロールは急成長しているのか
2025〜2026年の市場データ
- **Fortune 500企業の80%**がAIチームを持つか構築中(McKinsey 2025)
- AI Architectへの需要はLinkedInで2023年から2026年にかけて340%増加
- GenAIが新たな需要を生む:RAGアーキテクチャ、マルチエージェントシステム、LLMOps、AIゲートウェイ
- AIアーキテクト/AIエンジニアのポジションが世界で13万件以上(Indeed、2026年Q1)
人材不足の理由
これは極めて希少なT字型のロールです:幅(多くのことを知る)と深さ(いくつかの領域を習得する)の両方が必要です。実際には:
- データサイエンティストはモデリングが得意だが、システム設計とクラウドが弱い
- バックエンドエンジニアはシステム設計が得意だが、MLを知らない
- DevOpsエンジニアはインフラが得意だが、MLワークフローを理解していない
- AIアーキテクトはこの3つすべてが必要 — さらにビジネススキルも
給与の目安(2026年)
| 地域 | ジュニア(0〜2年) | ミッド(3〜5年) | シニア(5年以上) |
|---|---|---|---|
| ベトナム | 年収$25K〜$40K | 年収$45K〜$70K | 年収$80K〜$120K+ |
| シンガポール | 年収$80K〜$110K | 年収$120K〜$160K | 年収$180K〜$250K+ |
| 米国(リモート) | 年収$130K〜$170K | 年収$180K〜$240K | 年収$250K〜$350K+ |
注意: 給与は会社、業界(フィンテック/ヘルステックはより高い)、ポートフォリオによって異なります。本番AIシステムでの実際の経験は、経験年数よりも重要です。
3. 4フェーズロードマップ
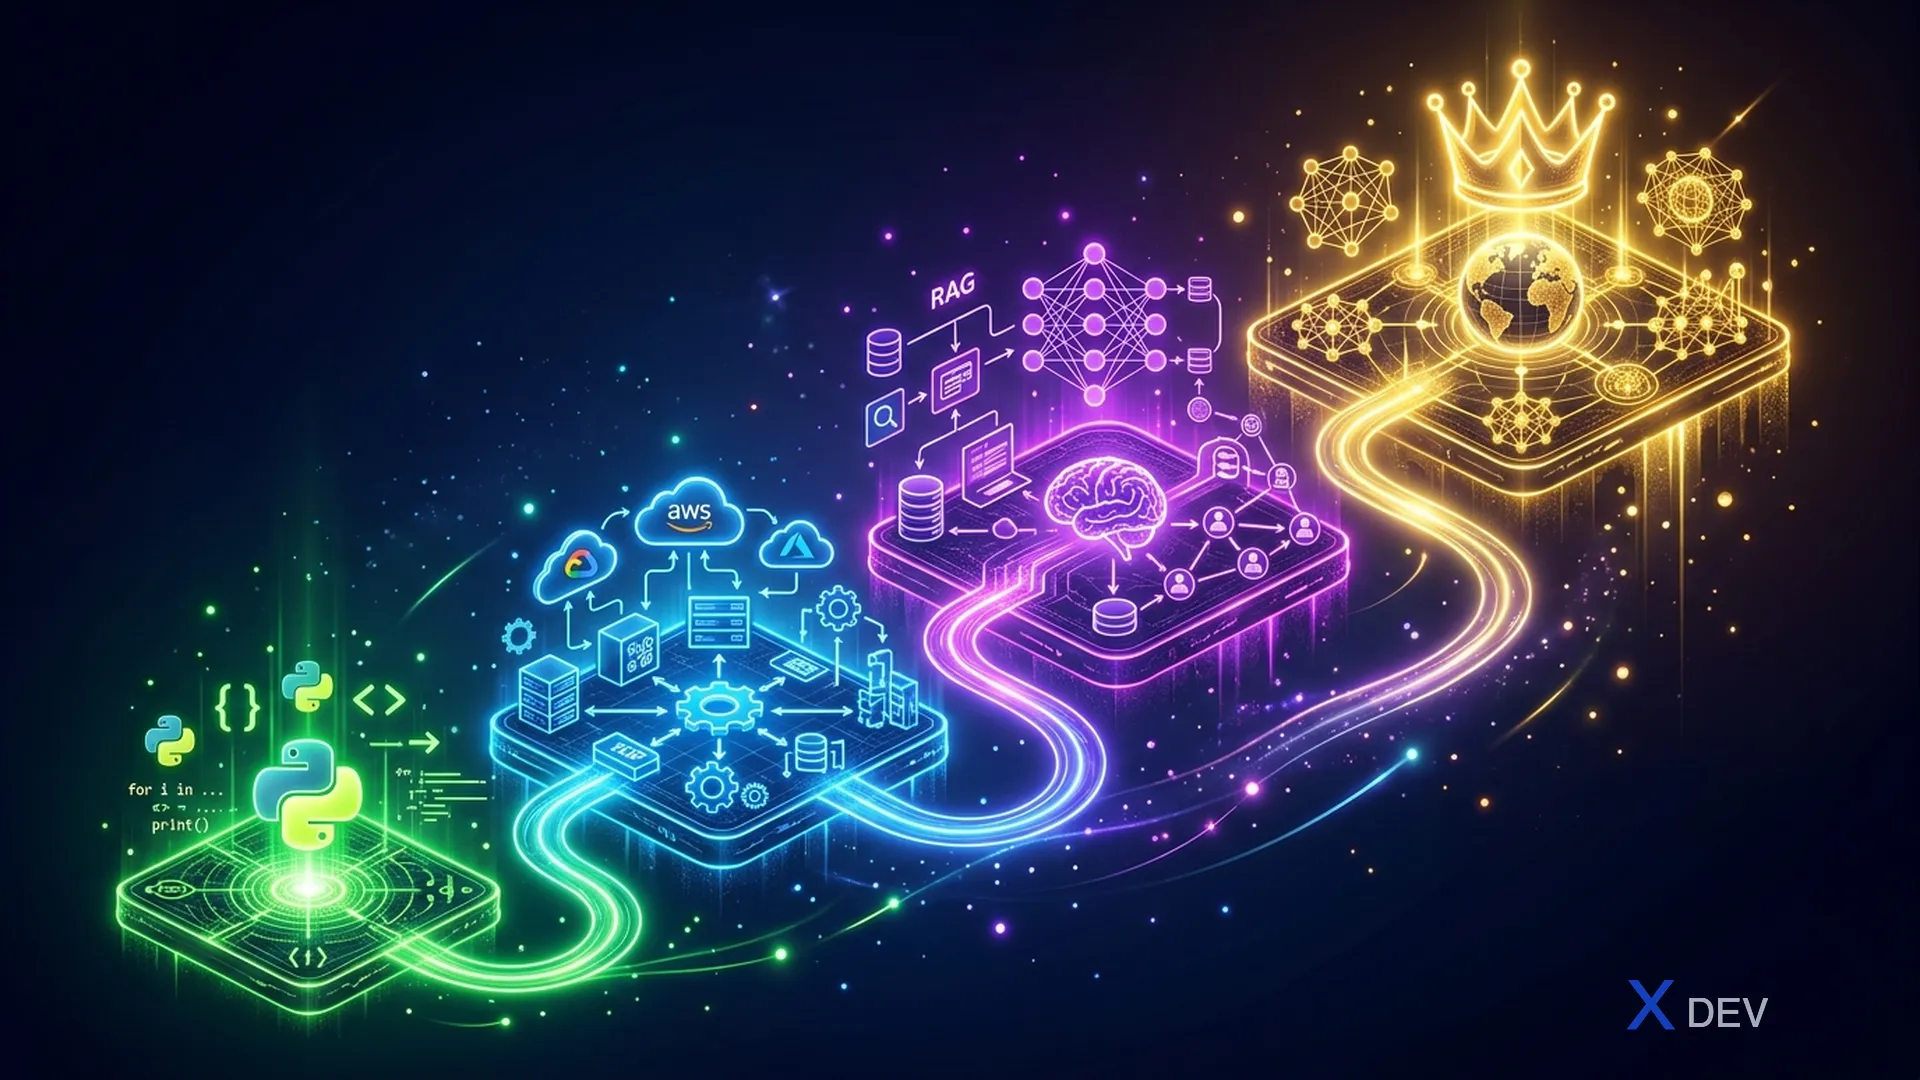
フェーズ1:技術的基礎(6〜12ヶ月)
博士号は必要ありませんが、テクノロジーが変わるたびに崩れないしっかりとした基礎が必要です。
プログラミングとソフトウェアエンジニアリング
- Pythonの熟練:リスト内包表記、ジェネレーター、デコレーター、async/await、型ヒント
- デザインパターン:Factory、Observer、Strategy、Repository — 暗記ではなく、いつ使うかを理解する
- クリーンアーキテクチャ、関心の分離、依存性注入
- FastAPIまたはFlaskでのREST API、内部サービス向けgRPC
- Gitフロー、コンベンショナルコミット、コードレビューのエチケット
- Docker:最適化されたDockerfile、マルチステージビルド、.dockerignore
- テスト:pytestによるユニットテスト、モッキング、統合テスト
マイルストーンチェック: 完全なPython REST API(認証、CRUD、テスト、Docker)を1日で構築できますか?
機械学習の基礎
scikit-learnをブラックボックスとして使うだけでなく、内部を理解する必要があります:
- 教師あり学習: 線形/ロジスティック回帰(なぜクロスエントロピーが損失関数なのかを理解)、決定木(情報利得とは何かを知る)、アンサンブル手法(ランダムフォレスト、勾配ブースティング)
- 教師なし学習: K-Means(慣性とエルボー法を知る)、PCA(固有値と分散説明率を理解)、DBSCAN
- モデル評価: 不均衡データに対するprecision/recall/F1、AUC-ROC vs AUC-PR、RMSE vs MAE
- 特徴エンジニアリング: スケーリング、エンコーディング、特徴選択
- 検証: 適切なtrain/validation/testの分割、交差検証、時系列分割
- 過学習/未学習: 学習曲線を読んで問題を診断する
深層学習
- ニューラルネットワーク:順伝播、逆伝播、勾配フロー
- CNN:畳み込み、プーリング、受容野
- RNN、LSTM:系列モデリング、忘却ゲート
- Transformer: 2026年では必須。自己注意メカニズム、マルチヘッドアテンション、位置エンコーディング
- 転移学習:特徴抽出 vs ファインチューニング
- フレームワーク:PyTorch(優先)、TensorFlow/Keras
数学と統計
- 線形代数: 行列乗算、SVD、固有値
- 微積分: 連鎖律(逆伝播)、勾配とは何か、ヤコビアン行列
- 確率と統計: ベイズ定理、MLE vs MAP、一般的な分布、仮説検定
- 最適化: SGD、Adam、学習率スケジューリング
おすすめリソース:
- fast.ai — Practical Deep Learning、無料で非常に実践的
- AndrewNgのMLスペシャライゼーション(Coursera)
- 『Designing Machine Learning Systems』— Chip Huyen
- 『The Elements of Statistical Learning』(無料PDF)
フェーズ2:クラウド + MLOps + システム設計(6〜12ヶ月)
このフェーズがデータサイエンティストとSolution Architectを差別化するフェーズです。
クラウドAIサービス(1〜2つのクラウドを選択し、深く学ぶ)
AWS — 最大のシェア:
- SageMaker:トレーニングジョブ、エンドポイント、パイプライン、フィーチャーストア、モデルレジストリ、Clarify
- Bedrock:Foundation Model API、Knowledge Bases(管理されたRAG)、Agents、Guardrails
- インフラ:Step Functions、Lambda、ECS/EKS、S3
Google Cloud — MLに最適:
- Vertex AI:AutoML、カスタムトレーニング、パイプライン、モデルレジストリ、フィーチャーストア
- BigQuery ML:CREATE MODEL SQL構文
- データ:Dataflow、Pub/Sub、Dataproc、Cloud Composer
Azure — エンタープライズで人気:
- Azure ML Studio:デザイナー、自動ML、パイプライン
- Azure OpenAI Service:GPT-4o、DALL-E、Whisper
- Azure AI Search:ハイブリッド検索
MLOps
MLOpsはAIアーキテクトのDNAです。MLOpsを知らない = アーキテクトではない。
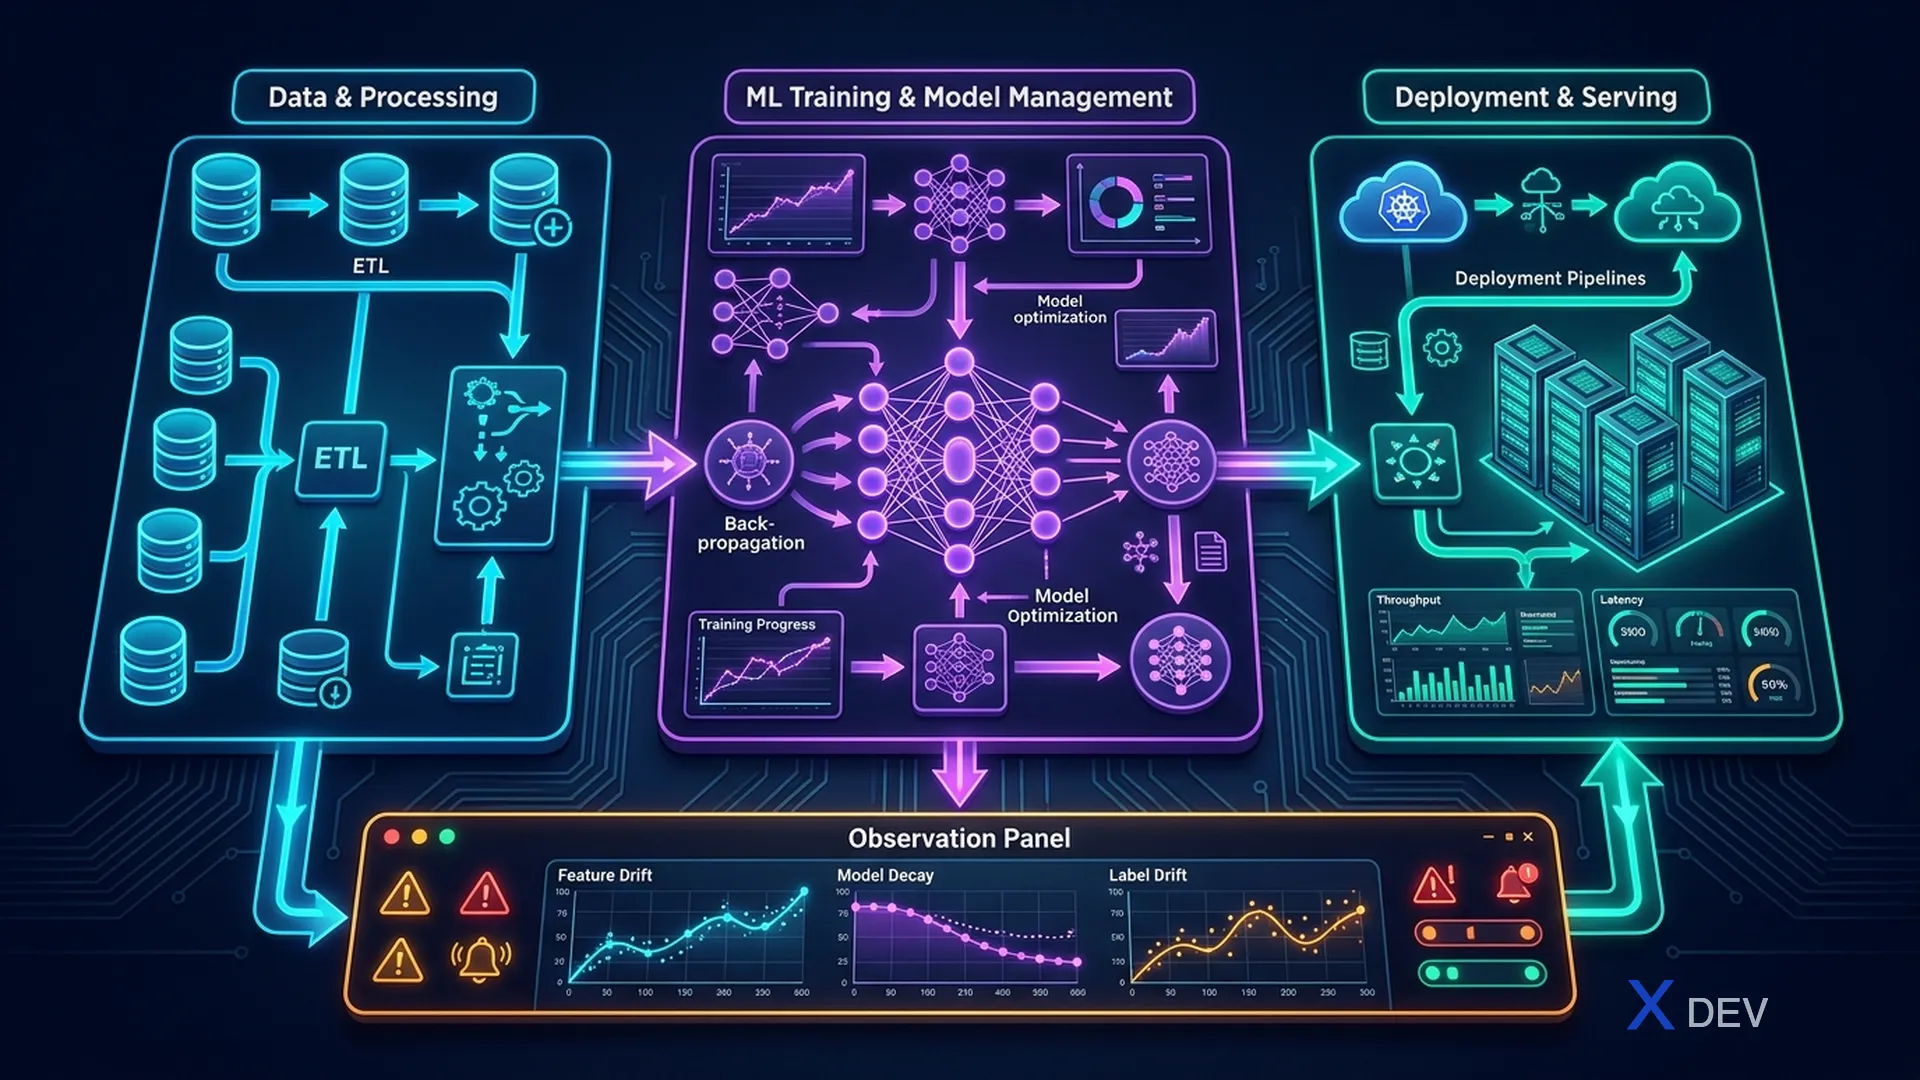
データパイプライン:
- 取り込み:データベース、API、ストリーミングソースからデータレイクへ
- 検証:Great Expectations、TFX ExampleValidator
- 変換:tf.Transform
- フィーチャーストア:オンラインサービング vs オフラインサービング
モデルパイプライン:
- 実験追跡:MLflow、W&B Runs
- バージョニング:データのDVC、コードのGit、モデルのMLflow Model Registry
- ハイパーパラメータチューニング:Optuna、Ray Tune
- 評価:TFMA(スライスされた評価)
デプロイメントパイプライン:
- サービングパターン:リアルタイム vs 非同期 vs バッチ予測
- ブルーグリーンデプロイメント
- カナリアデプロイメント:0% → 5% → 25% → 100%
- シャドウモード
オブザーバビリティ:
- データドリフト:入力特徴分布のモニタリング(PSI、KSテスト)
- 予測ドリフト:出力ラベル分布の変化モニタリング
- インフラ:レイテンシパーセンタイル(p50/p95/p99)、スループット、エラー率
AIのためのシステム設計
アーキテクトのコアスキル。5分でこれらの質問に答えられる必要があります:
サービングアーキテクチャの決定:
- リアルタイム vs バッチ:レイテンシ要件 < 200ms → リアルタイム;1時間以上待てる → バッチ
- モデルサイズ vs レイテンシ:大型モデル(7B+パラメーター)はGPUで高速だが費用も高い
- キャッシュ:高頻度で同じ入力の予測はキャッシュすべき
必読書:
- 『Designing Machine Learning Systems』— Chip Huyen(業界のバイブル)
- 『Machine Learning Engineering』— Andriy Burkov
- 『Fundamentals of Data Engineering』— Joe Reis & Matt Housley
フェーズ3:GenAIアーキテクチャと専門化(6〜12ヶ月)
2026年において、AI Solution Architectは必ずGenAIアーキテクチャを習得しなければなりません。
LLMとFoundation Models
情報に基づいた決定を下すのに十分な理解が必要です:
- Transformerアーキテクチャ: 自己注意O(n²)の複雑さ、KVキャッシュの重要性
- 2026年のモデル階層:
- フロンティア: GPT-4.5、Claude 4 Opus、Gemini 2.5 Ultra
- ワークホース: Claude 4 Sonnet、GPT-4o、Gemini 2.5 Pro
- 高速/低コスト: Claude 4 Haiku、Gemini 2.5 Flash、GPT-4o mini
- オープンソース: Llama 4、Qwen 3、Mistral Large
- トークン化: トークン数がコストに影響することを知る
- 構造化出力: JSONモード、関数呼び出し、Pydanticバリデーション
RAG(検索拡張生成)
RAGは最も一般的なパターンであり、多くのチームが最も多くの間違いを犯す領域でもあります:
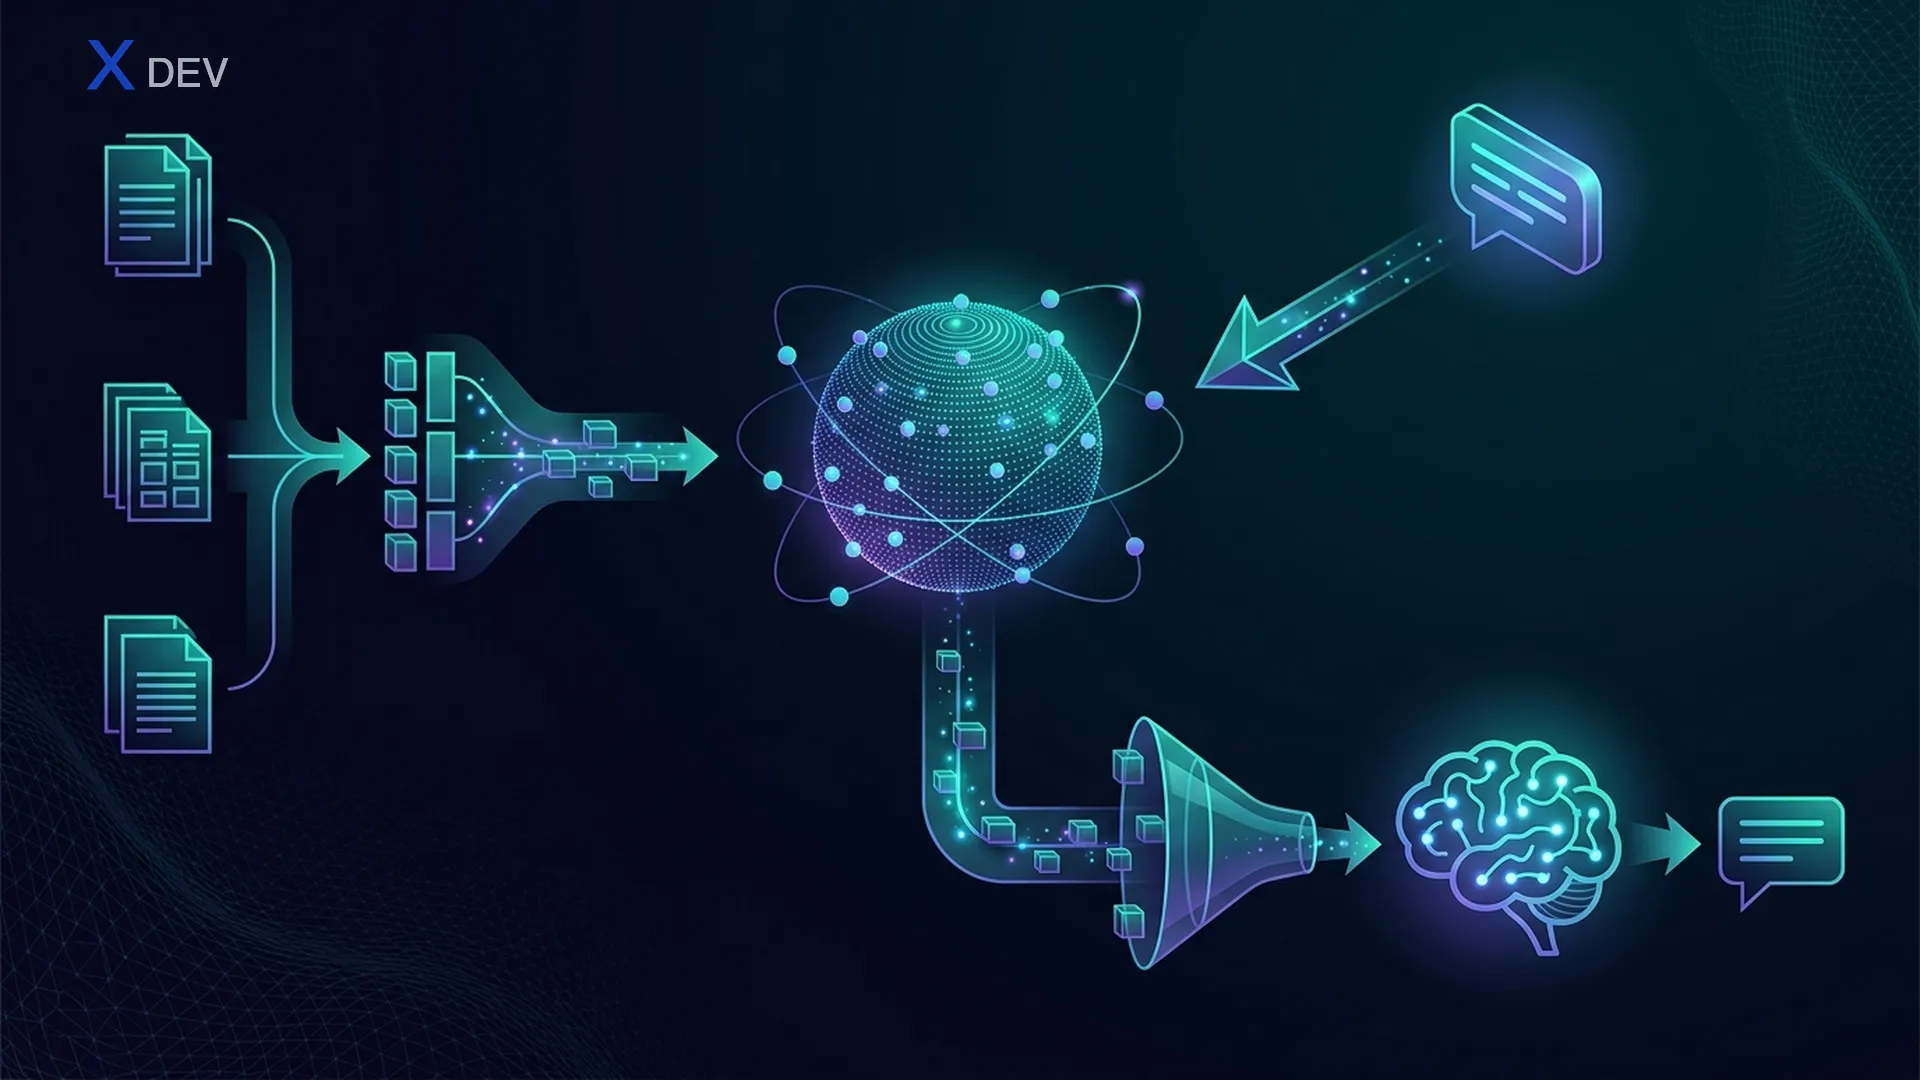
インデックスパイプライン:
- ドキュメント読み込み:PDF(unstructured.io、PyMuPDF)、HTML、Confluence、Notion
- チャンキング戦略:固定サイズ、再帰的文字、セマンティック、ドキュメント対応
- 埋め込み:text-embedding-3-large、text-embedding-004、multilingual-e5-large
- ベクターストア:Pinecone、Weaviate、Qdrant、pgvector、Redis
検索パイプライン:
- クエリ前処理:スペルチェック、クエリ拡張、クエリ分解
- 検索タイプ:密な検索(埋め込み類似度)、疎な検索(BM25/TF-IDF)、ハイブリッド検索
- 再ランキング:BAAI/bge-reranker、Cohere Rerank
- メタデータフィルタリング
生成パイプライン:
- コンテキストウィンドウ管理
- プロンプトテンプレート
- ストリーミング
- 後処理:事実抽出、ソース帰属、信頼スコアリング
評価:
- 忠実性(faithfulness):0〜1
- 回答の関連性(answer relevance):0〜1
- コンテキストリコール(context recall):0〜1
- ツール:RAGAS、TruLens、DeepEval
AIエージェントアーキテクチャ
マルチエージェントシステムは2026年の最大のトレンドです:
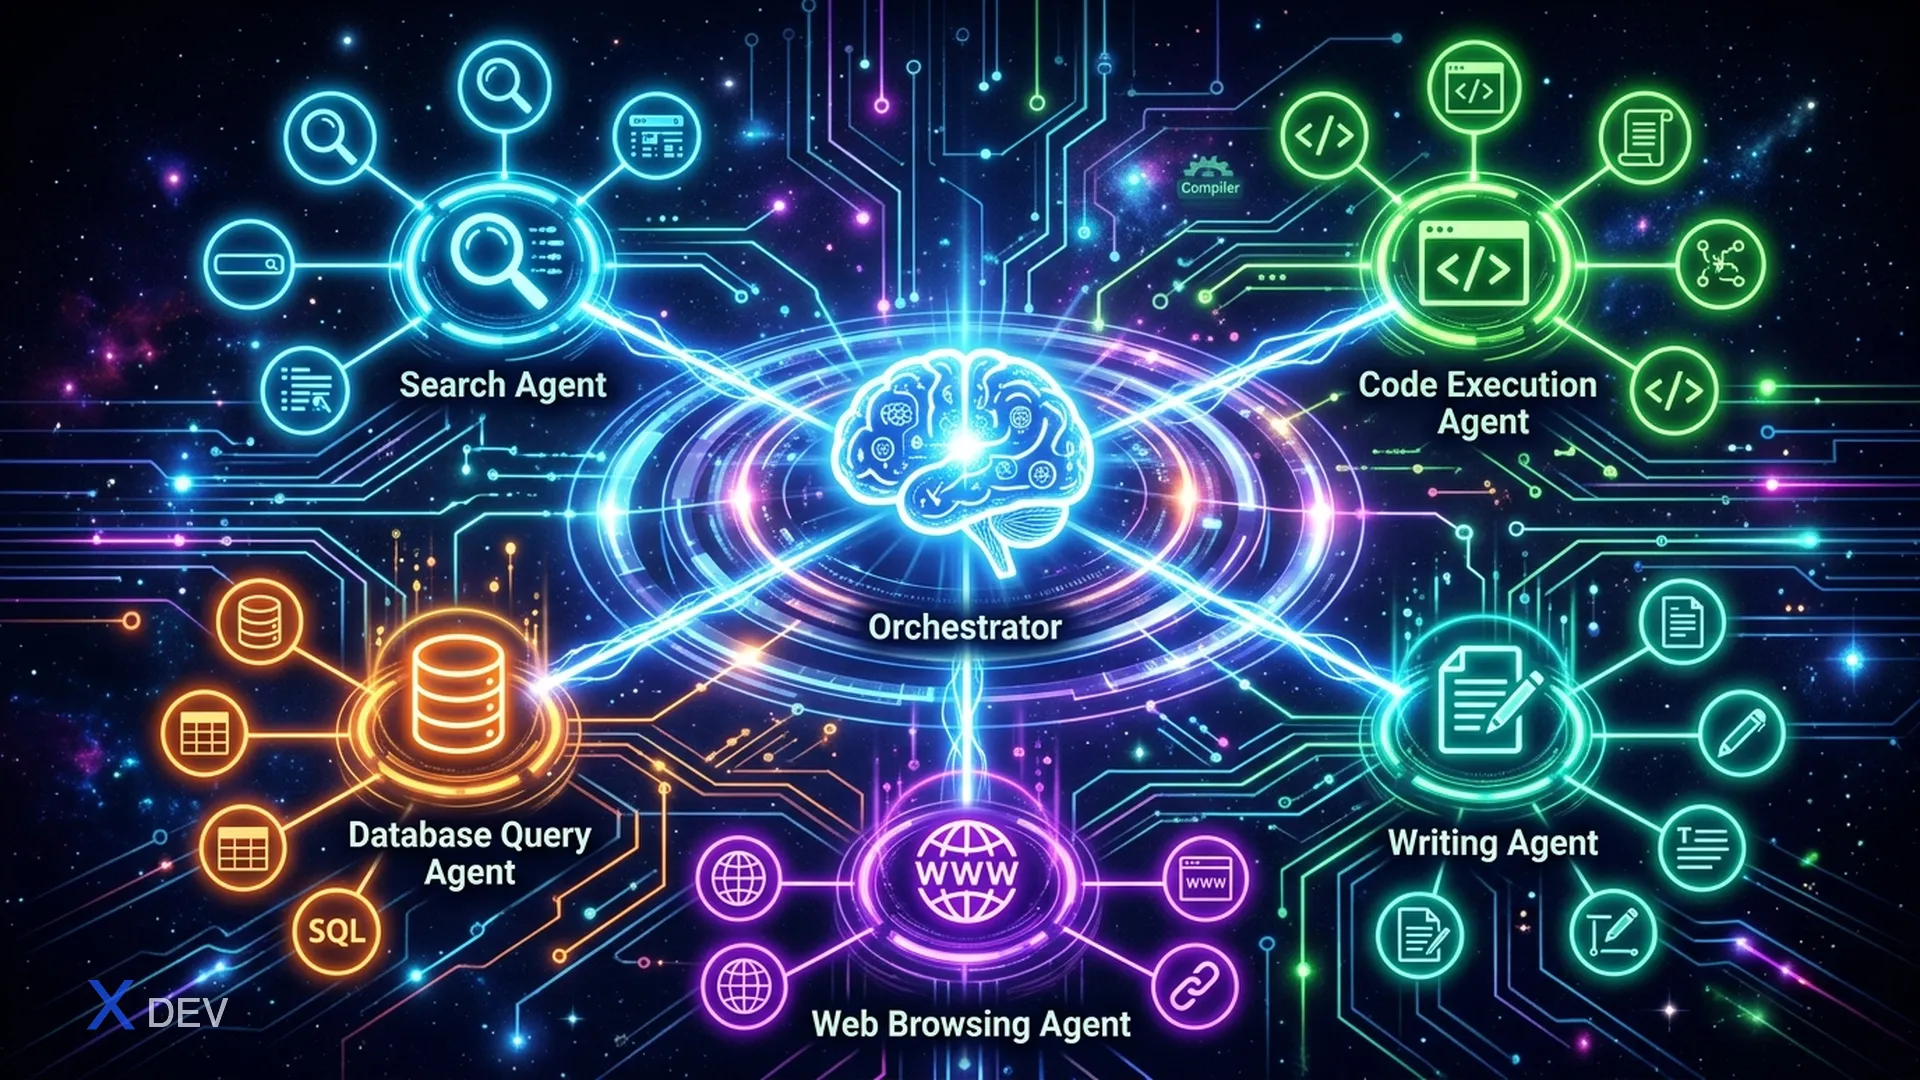
AIエージェントの構造:
- ブレイン(LLM): 推論、計画、意思決定
- メモリ: 短期、長期、エピソード的、セマンティック
- ツール: API、データベース、コードエグゼキューター、Webブラウザ
- 知覚: 入力プロセッサ
- アクション: テキスト生成、API呼び出し、コード実行
マルチエージェントパターン:
- 順次: エージェントA → B → C
- 並列: 複数エージェントが同時実行、アグリゲーターが結果をまとめる
- 階層型: オーケストレーターが専門エージェントに割り当て(エンタープライズで最も一般的)
- ディベート/クリティーク: 一方のエージェントが生成し、もう一方が批評して改善
2026年のフレームワーク:
- LangGraph — グラフベースのエージェントオーケストレーション
- CrewAI — ロールベースのエージェント
- AutoGen — 会話ベースのマルチエージェント
- Amazon Bedrock Agents — 管理型、AWS連携
- Vertex AI Agent Builder — 管理型、Google Cloud連携
AIゲートウェイとLLMOps
1つのモデルから多くのモデルへスケールする際には、インフラ層が必要です:
AIゲートウェイの責務:
- ルーティング: シンプルなクエリは安価なモデルへ、複雑なクエリは強力なモデルへ
- レート制限: プロバイダーのレート制限を超えないよう確保
- キャッシュ: セマンティックキャッシュ(コスト30〜70%削減)
- フォールバック: プライマリモデルがダウンした際のフェイルオーバー
- コスト追跡: チーム/機能/ユーザー別のコスト帰属
ツールエコシステム:
- LiteLLM — 100以上のLLMプロバイダーへの統一API
- Portkey — 管理型AIゲートウェイ
- LangSmith — LangChainのオブザーバビリティプラットフォーム
- Langfuse — オープンソースLLMオブザーバビリティ
フェーズ4:リーダーシップとビジネスインパクト(継続的)
このフェーズがアーキテクトとシニアエンジニアを区別します。
ステークホルダーコミュニケーションスキル
C-levelへの説明:
こう言わない:「QLoRAでLLMをファインチューニングし、8x A100でvLLMをK8sにデプロイして...」
代わりにこう言う:「お客様サポートの質問80%を自動処理するAIシステムを構築します。応答時間を4時間から3秒に短縮し、年間$2Mのコスト削減を見込んでいます。投資額:ビルド$500K + 年間運用$150K。8ヶ月でROIがプラスになります。」
アーキテクチャ決定レコード(ADR)の作成:
ADRはアーキテクトが作成する最も重要なドキュメントです:
# ADR-042: カスタマーサポートボットにファインチューニングではなくRAGを選択

## コンテキスト
チームは5万件のドキュメントナレッジベース(週200件更新)に基づいて
質問に答えるチャットボットを構築する必要があります。

## 決定
ファインチューニングではなく、pgvector + GPT-4o TurboでRAGを使用

## 検討した代替案
1. GPT-3.5のファインチューニング:学習コスト$3万 + KBの更新ごとに再学習 → 却下
2. PineconeによるフルRAG:月$8千の運用コスト → 却下(コスト高)
3. pgvectorによるRAG(選択):既存PostgreSQLを活用 → 月$800

## 結果
+ ナレッジベース更新が即時反映、再学習不要
+ 代替案Bの10倍低コスト
- 埋め込みパイプラインのメンテナンスが必要
- 128Kトークンのコンテキストウィンドウ制限(このユースケースには十分)
AIコストの見積もり:
- 1日10万APIコール × $0.001/コール(GPT-4o mini)= $100/日 = $3K/月
- 1日100万トークン × $0.002/1Kトークン = $2/日 = $60/月
- GPUインファレンス(1x A10G):$1.006/時間 × 24時間 × 30 = $724/月
ガバナンスとコンプライアンス(2026年から必須)
EU AI法(2026年完全施行):
- 高リスクAIシステム(人事、与信スコアリング、医療、法執行):適合性評価、人間による監督、透明性が必要
- 限定リスク(チャットボット):AIと話していることの開示が必要
- 最小リスク(スパムフィルター):追加要件なし
4. 有用な認定資格
認定資格が全てではありませんが、体系的な知識を示すのに役立ちます。
優先度高(少なくとも2つは取得すべき)
| 認定資格 | フォーカス | 学習期間 | 価格(USD) |
|---|---|---|---|
| AWS Solutions Architect – Professional | クラウドアーキテクチャパターン、コスト最適化、セキュリティ | 2〜3ヶ月 | $300 |
| AWS Certified AI Practitioner (AIF-C01) | AWS上のAI/ML、Bedrock、SageMaker | 1〜2ヶ月 | $150 |
| Google Cloud Pro ML Engineer | Vertex AI、MLOps、BigQuery ML | 2〜3ヶ月 | $200 |
| CKA – Certified Kubernetes Administrator | MLワークロードのコンテナオーケストレーション | 1〜2ヶ月 | $395 |
5. 本物のポートフォリオ > 学位
AI Solution Architectには、Kaggleのノートブックではなく、システム設計能力を実証するポートフォリオが必要です。
ポートフォリオに含めるべき5つのプロジェクト
1. 本番グレードのRAGシステム
- ドキュメント処理パイプライン:PDF/Word → チャンク → 埋め込み → ベクターストア
- ハイブリッド検索:密(埋め込み)+ 疎(BM25)、Reciprocal Rank Fusion
- クロスエンコーダーによる再ランキング
- 評価パイプライン:RAGASメトリクスの自動化
- FastAPI、WebSocketによるストリーミングAPI
- 技術: LangChain/LlamaIndex、pgvector/Qdrant、FastAPI、Grafana
2. エンドツーエンドのMLOpsパイプライン
- データ検証:Great Expectationsの自動チェック
- 保存された変換グラフによる特徴エンジニアリング
- 実験追跡付きトレーニングジョブ(MLflow + W&B)
- 自動評価ゲート:ベースラインを超えた場合のみデプロイ
- カナリアデプロイメント:10% → 50% → 100%
- 技術: Kubeflow PipelinesまたはVertex AI Pipelines、MLflow、Docker、Kubernetes
3. ビジネスワークフロー向けマルチエージェントシステム
- LangGraph StateGraphを使ったオーケストレーターエージェント
- 専門エージェント:リサーチャー、ライター、クリティック、ファクトチェッカー
- ツール統合:検索、コード実行(E2Bサンドボックス)、ドキュメント読み取り
- 技術: LangGraph、Anthropic Claude API、Tavily、E2B、FastAPI
4. カスタムインフラによるリアルタイムMLサービング
- Triton Inference Server:モデルアンサンブル、動的バッチング
- フィーチャーストア:Redisによるオンラインフィーチャー(5ms未満のルックアップ)
- 自動スケーリング:GPU利用率に基づくK8s HPA
- A/Bテスト:2つのモデルバージョン間のトラフィック分割
5. アーキテクチャ決定ドキュメント
- 実際のAI問題(自己提案)
- 完全なADRの作成:コンテキスト → オプション → 決定 → トレードオフ → コストモデル
- C4モデルによるアーキテクチャ図作成
- リスク評価マトリクス
6. 転職パス — どこからAIアーキテクトへ?
データサイエンティストから:
あなたが持つもの: 深いML知識、実験設計、統計 不足するもの: システム設計、クラウドアーキテクチャ、本番エンジニアリング
ロードマップ:
- Docker + Kubernetesを学ぶ(1〜2ヶ月)
- すでに持つモデルのMLOpsパイプラインを構築(2〜3ヶ月)
- クラウド認定取得(2〜3ヶ月)
- チームのアーキテクチャディスカッションへの参加開始
バックエンド/ソフトウェアエンジニアから:
あなたが持つもの: システム設計、API開発、データベース、本番経験 不足するもの: ML基礎、AI特有のパターン
ロードマップ:
- fast.aiコース + Andrew Ng MLスペシャライゼーション(3〜4ヶ月)
- シンプルなエンドツーエンドRAGアプリケーションの構築(1〜2ヶ月)
- 既存のプロジェクトへのMLサービング統合
DevOps/クラウドエンジニアから:
あなたが持つもの: インフラ、K8s、ネットワーキング、CI/CD、セキュリティ 不足するもの: MLの概念、AIツール
ロードマップ:
- ML基礎(2〜3ヶ月)
- 既存のクラスターにMLflowをセットアップ
- 適切なモニタリングでLLM API(vLLMまたはOllama)をデプロイ
7. よくある失敗
❌ モデリングのみに集中する
「SOTA モデルを訓練した」— 素晴らしいですが、アーキテクトはそれをデプロイ、スケール、モニタリング、3年間維持する方法を知る必要があります。
❌ データエンジニアリングを無視する
最高のモデルも、データパイプラインが悪ければ無用です。Garbage in, garbage out。
❌ ビジネスコンテキストを理解しない
最良の技術的ソリューションがビジネス問題を解決しなければ = 時間とお金の無駄。
❌ 最初から過剰エンジニアリングする
「マルチリージョンK8sのRayによる分散学習クラスターが必要」— 1万行の訓練データのモデルに対して。
❌ コストを最初から無視する
GPUインファレンスは高価です。アーキテクトはアーキテクチャ選択時にコストモデルを構築する必要があります。
❌ 提示前にテストしない
PoC なしにアーキテクチャ提案を提示する = 高リスク。
❌ 概念ではなくツールを学ぶ
LangChain バージョン 0.3 は 0.2 と大きく異なります。基礎となる概念を理解せずにツールの使い方だけを学ぶと、ツールが変わったときに迷ってしまいます。
8. 典型的な1日の業務
08:30   MLエンジニアリングチームとのスタンドアップ
        → モデルパフォーマンスダッシュボードのレビュー
        → 昨日のレイテンシスパイクについて議論(根本原因:コールドスタートの遅延)

09:00   深作業:カスタマーサポートボット v2のRAGアーキテクチャ設計
        → 現在の問題:精度が低い(55%)、改善策を検討
        → リサーチ:ハイブリッド検索 vs 純粋な密検索 → 両方テスト

10:30   プロダクトマネージャーとCPOとのミーティング(30分)
        → 3つのオプションを提示:RAG v2、ファインチューニング、エージェントベース
        → ビジネス言語でトレードオフを説明

13:30   PoC:ドキュメント分類タスクのGPT-4o mini vs Gemini 2.5 Flashのテスト
        → 基準:精度、レイテンシ、コスト

15:00   インシデントポストモーテム:先週のサービングレイテンシスパイク
        → 根本原因分析:フィーチャーストアRedisタイムアウトのカスケード

16:30   ジュニアアーキテクトとの1:1
        → RAG実装のレビュー、ハイブリッド検索インデックスの説明

17:00   個人学習
        → 論文読む:「Scaling LLM Test-Time Compute」(30分)
9. 学習リソース
書籍(読む順序)
| 書籍 | 読むタイミング | なぜ |
|---|---|---|
| 『Designing Machine Learning Systems』— Chip Huyen | 最初から | MLシステム設計のバイブル。2〜3回読む |
| 『Fundamentals of Data Engineering』— Joe Reis | フェーズ2 | データプラットフォームはAIの基盤 |
| 『Machine Learning Engineering』— Andriy Burkov | フェーズ2 | A〜ZまでのプロダクションML |
| 『Building LLM Apps』— Valentina Alto | フェーズ3 | RAG、エージェント、LLMOpsの実践 |
| 『Staff Engineer』— Will Larson | フェーズ4 | 技術的リーダーシップ |
ブログとニュースレター
- Chip Huyen's Blog (huyenchip.com)
- Eugene Yan's Blog (eugeneyan.com)
- Sebastian Raschka's Newsletter
- The Batch (deeplearning.ai/the-batch)
- Latent Space (latent.space)
10. 結論
AI Solution Architectへの道に近道はありません。必要なのは:
- 強固な技術的基礎 — ML、DL、クラウド、システム設計
- 実践的なMLOpsスキル — パイプライン、モニタリング、CI/CD
- GenAIアーキテクチャの習得 — RAG、エージェント、LLMOps
- ビジネス思考 — コストモデリング、ROI、ステークホルダーコミュニケーション
- 継続的な学習 — この分野は3〜6ヶ月ごとに変化する
良いニュース:すべてを一度に習得する必要はありません。基礎から始め、サイドプロジェクトを通じてポートフォリオを構築し、徐々にシステム設計とリーダーシップへと拡張してください。2〜3つの本番グレードのプロジェクトを持つポートフォリオは、通常、何も示すものがない5年の経験よりも価値があります。
世界はAIシステムを本番環境のために設計できる人材を必要としています。今日始めれば、2年後にはまったく異なる立場にいるでしょう。
あなたは今、このパスのどこにいますか?コメントで教えてください — すべてのコメントに返信するよう努めます。