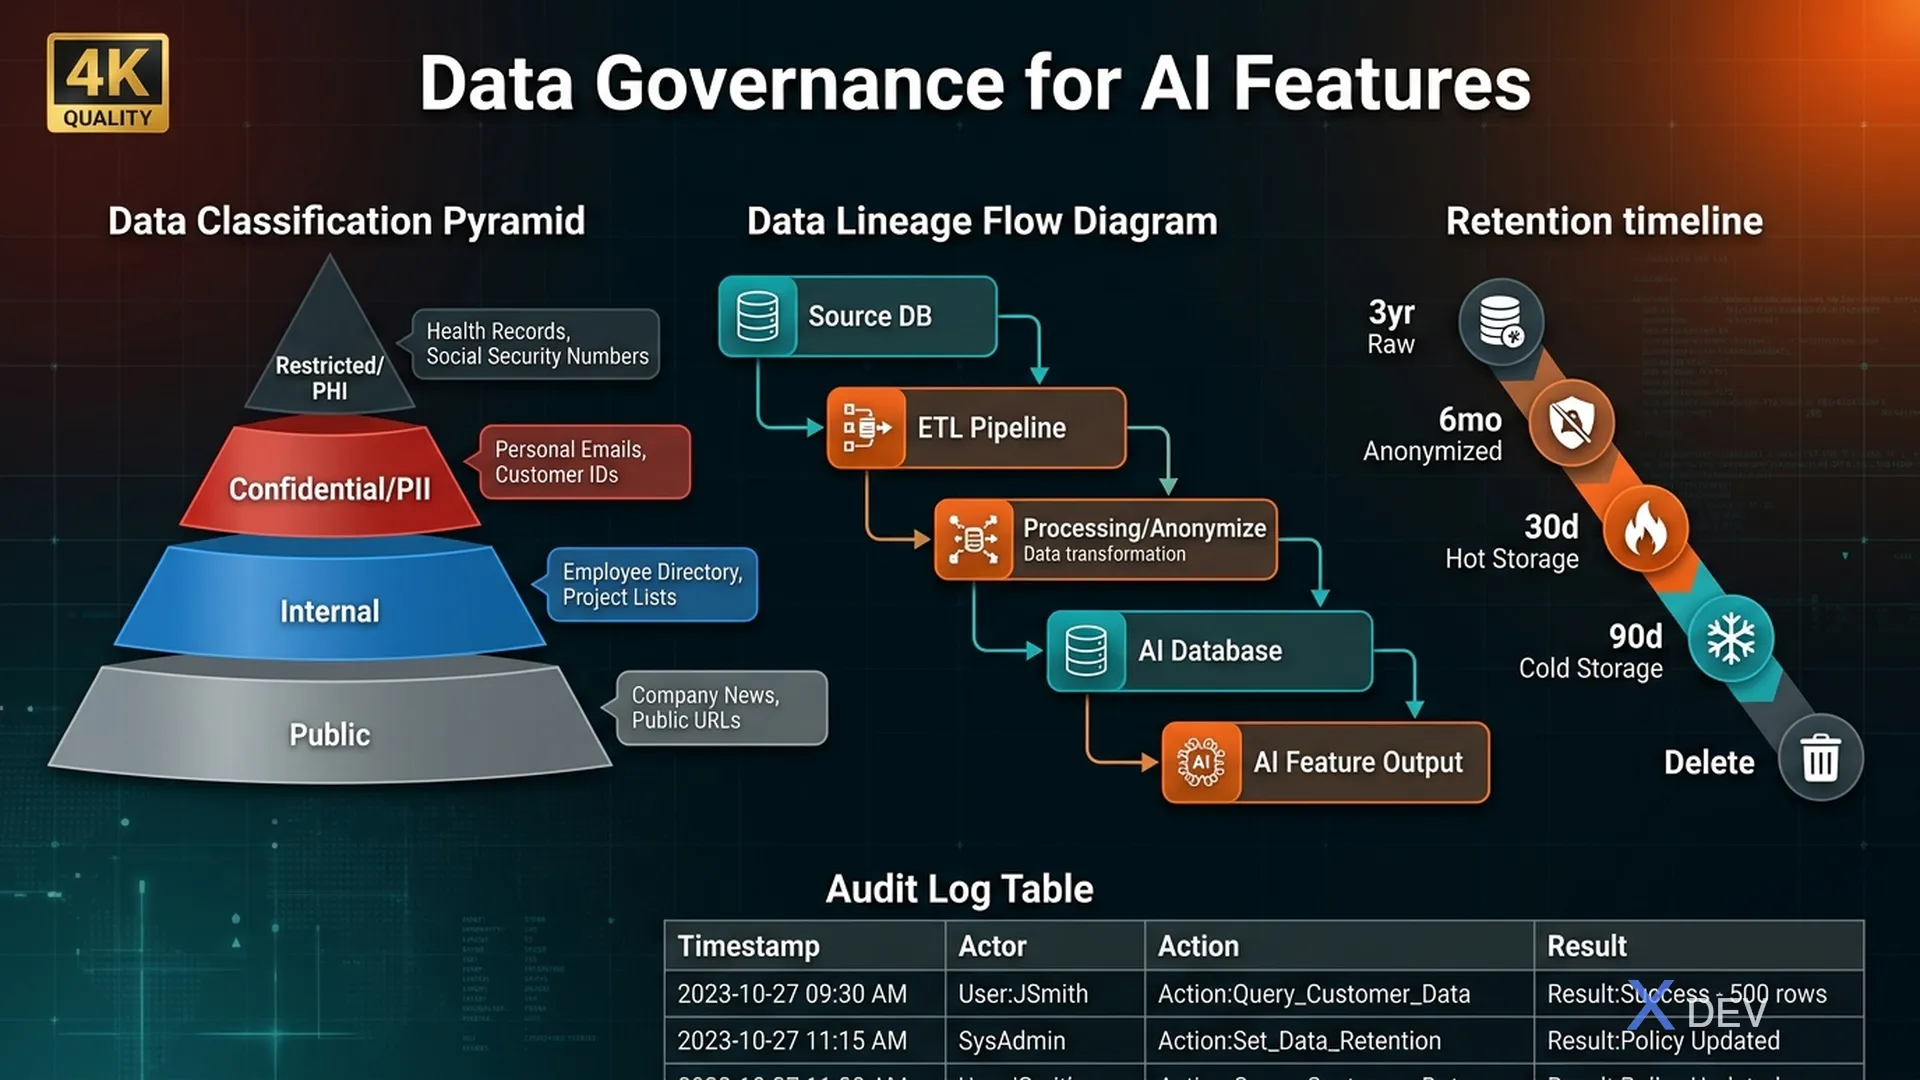
「このデータを AI トレーニングに使用できるか?」「顧客データをどのくらい保持するのか?」「本番環境データにアクセスできる人は誰か?」— データ ガバナンス ポリシーがない場合、BA に明確な答えはありません。
このガイドは BA が AI 機能用のデータ ガバナンス フレームワークを構築する方法を教えます。
1. データ ガバナンス対データ セキュリティ
| 側面 | データ ガバナンス | データ セキュリティ |
|---|---|---|
| 焦点 | どのデータ?どこから?何に使用? | 誰がアクセス?どのように保護? |
| 所有者 | BA、データ スチュワード | セキュリティ チーム、DevOps |
| 範囲 | リネージ、ライフサイクル、品質 | 暗号化、監査ログ、アクセス制御 |
| 質問 | 「このデータを使用できるか?」 | 「誰がこのデータにアクセスできるか?」 |
**BA はガバナンスに焦点を当て、**セキュリティ チームはコントロールを実装します。
2. データ リネージ — ソースからデータを追跡
データ リネージ = ソース → 処理 → AI → 出力からのデータの文書化されたパス
例:AI チャットボットが製品の推奨を提案

ソース データ:
  ├─ 本番 DB:user_transactions テーブル
  ├─ サード パーティ:product_catalog API
  └─ ユーザー入力:チャット メッセージ

処理:
  ├─ ETL パイプラインが user_transactions を毎日抽出
  ├─ product_catalog と結合
  ├─ user_id → user_hash を匿名化
  └─ AI 機能データベースにロード

AI 処理:
  ├─ Embedding モデルが user_hash + product_features を消費
  ├─ 類似度検索 + ランキング
  └─ 上位 5 推奨を出力

出力:
  └─ フロントエンドが推奨を表示
      ├─→ ユーザーが見た推奨を追跡
      ├─→ ユーザーがクリックした推奨を追跡
      └─→ トレーニング データへのフィードバック ループ?
BA がドキュメント化する必要がある:
- ソース システム + 抽出頻度
- データ変換ルール(匿名化?集計?)
- AI データが保存されているデータベース/テーブル
- アクセス権限(読み取り専用?書き込み?)
- 保有:処理後、ソース データをどのくらい保持?
3. データ 分類 — PII / PHI / Public
感度レベルでデータを分類:
| レベル | 定義 | 例 | ハンドリング |
|---|---|---|---|
| Public | 機密でない、共有可能 | 製品カタログ、一般的なフィードバック | 制限なし |
| Internal | 社内のみ、顧客向けではない | 売上メトリクス、社内メール | アクセス制限 |
| Confidential (PII/PHI) | 顧客個人/健康データ | 名前、メール、電話、医療記録 | 暗号化、匿名化、監査ログ |
| Restricted | 規制要件 | クレジットカード、生体認証データ | コンプライアンス チーム承認 |
例:
ユーザー テーブル フィールド:
- user_id(数値) → INTERNAL(識別に役立つ)
- email → CONFIDENTIAL(PII、GDPR)
- age → CONFIDENTIAL(PII、差別リスク)
- purchase_history → INTERNAL + 追跡
- medical_history → RESTRICTED(HIPAA 下の PHI)

フィールドごとのポリシー:
- AI トレーニング データにどの機能を含められるか?
- どの機能を匿名化する必要があるか?
- AI に使用できない機能は?
4. 保有ポリシー — 保持期間
ポリシー:顧客トランザクション データ保有

生データ(ソース):
  ├─ 本番 DB で保持:3 年(財務監査要件による)
  ├─ 1 年後にコールド ストレージに移動
  └─ 3 年後に削除(法的保有ない限り)

AI トレーニング データ(処理済み):
  ├─ 匿名化スナップショット保持:モデル バージョン管理用 6 か月
  ├─ ユーザーがオプトアウトしたら即座に削除
  └─ ユーザー アカウント削除時に削除(GDPR 忘れられる権利)

チャット履歴(ユーザー インタラクション):
  ├─ ホット ストレージで 30 日間保持(エスカレーション ハンドリング用)
  ├─ 30 日後にアーカイブ(コールド ストレージ 60 日)
  └─ 合計 90 日後に削除(ユーザーがトレーニングにオプトイン中止)
削除のトリガー:
- ユーザーが削除をリクエスト(忘れられる権利)
- ユーザーが AI トレーニングからオプトアウト
- 保有期間が期限切れ
- データ品質チェック失敗
- 規制要件が変更
5. プロヴァナンス追跡 — 誰がデータを使用?いつ?
すべてのアクセス/使用を追跡:
監査ログ例:

タイムスタンプ       | アクター      | アクション                | アクセス データ              | 結果
2026-05-05 10:15 | david@co     | Download data export  | user_transactions.csv  | ✅ 成功
2026-05-05 10:20 | ai_pipeline  | Read user_features    | anonymized_user_*.db   | ✅ 50K レコード
2026-05-05 10:25 | sarah@qa     | Execute unit test     | test_dataset.json      | ✅ すべてパス
2026-05-05 10:30 | external_ai  | Attempted read PII    | email_addresses.csv    | ❌ ブロック
監査するもの:
- データにアクセスした人(ユーザー/サービス アカウント)
- いつ(タイムスタンプ)
- どのデータ(テーブル/フィールド レベル)
- アクション(読み取り/書き込み/削除/エクスポート)
- 結果(成功/ブロック/エラー)
- コンテキスト(どの IP、どのシステム)
6. データ ガバナンス ポリシー テンプレート
# データ ガバナンス ポリシー:[AI 機能名]

## 1. データ 分類

| データ ソース | 分類 | PII? | 感度 | 使用 |
|----------|-------------|-------|--------|------|
| user_id | Internal | いいえ | 中程度 | Train、serve |
| email | Confidential | はい | 高 | Serve のみ、train なし |
| age | Confidential | はい | 高 | 匿名化後に Train |

## 2. データ リネージ

- **ソース**:production.user_transactions(MySQL)
- **抽出**:毎日 2 AM(UTC)Airflow DAG 経由
- **処理**:
  - PII を匿名化(メール ハッシュ、電話削除)
  - 年齢を 5 年バケットに集計
- **ストレージ**:warehouse.ai_features(BigQuery)
- **保有**:モデル バージョン用 6 か月

## 3. アクセス制御

| 役割 | データ | 権限 | コンテキスト |
|------|------|---------|-----------|
| データ サイエンティスト | anonymized_features | 読み取り | モデル トレーニング用のみ |
| ML エンジニア | model_artifacts | 読み取り/書き込み | Prod デプロイ |
| BA | 使用メトリクス | 読み取り | 月次レビュー |
| 外部 AI ベンダー | なし | - | 直接アクセスなし |

## 4. 保有スケジュール

- 生データ:3 年間保持
- 匿名化データ:6 か月間保持
- チャット ログ:30 日間(ホット)→ 90 日間(コールド)→ 削除
- 削除トリガー:ユーザー オプトアウト、アカウント削除、保有期限

## 5. ユーザー権利

- ユーザーが要求可能:私たちが持っているデータは何か?
- ユーザーが要求可能:私のデータをすべて削除(GDPR)
- ユーザーが要求可能:データをエクスポート
- ユーザーがオプトアウト可能:「AI トレーニングに会話を使用しないでください」

## 6. コンプライアンス 要件

- GDPR:個人データは同意 + 削除権が必要
- CCPA:カリフォルニア州居民はデータ販売からオプトアウト可能
- HIPAA:健康データは AI 使用前に非識別化が必要
- 地方法:[地域固有を追加]
7. BA 向け実装チェックリスト
開発前
☐ すべてのソースのデータ分類を定義
☐ PII/PHI フィールドを特定
☐ 決定:匿名化または除外?
☐ 保有ポリシーを設定
☐ リネージをドキュメント化
☐ コンプライアンス レビューを取得

開発中
☐ 機密フィールドのデータ マスキングを実装
☐ 監査ログを追加
☐ データ削除をテスト(保有期限切れ)
☐ ユーザー オプトアウト トリガーをテスト
☐ QA が正しいデータ フローを検証

リリース後
☐ 月次監査ログ レビュー
☐ 四半期保有ポリシー レビュー
☐ 監視:不正なアクセス?
☐ 追跡:ユーザー削除リクエスト?
☐ 規制が変わったらポリシーを更新
8. BA が防ぐべき一般的な違反
❌「後でデータを匿名化する」→ データは PII のまま ✅ ソースで匿名化、AI 処理前
❌「モデル改善用にユーザー チャットを 5 年間保持」→ GDPR 違反 ✅ デフォルトで 30 日間保持、ユーザー オプトアウトまたは忘れられる権利で削除
❌「AI ベンダーは本番環境データベースへのアクセスが必要」→ セキュリティ ナイトメア ✅ 月次に匿名化データセットをエクスポート、ベンダーはそれで作業
❌「監査証跡は不要、社内」→ 後で準拠を証明できない ✅ 常にログ:誰が、何を、いつ、なぜ、すべてのデータ アクセス
まとめ
AI のデータ ガバナンス = 分類(PII?)+ リネージ(どこから?)+ 保有(どのくらい?)+ アクセス(誰が見える?)+ プロヴァナンス(監査証跡)。
BA はシステムを構築する必要はありませんが、開発ビルド前に明確なポリシーを定義する必要があります。後でコンプライアンス質問が生じたときに、BA が参照すべき具体的なポリシーがあります。