サンプル CDM の Eunomia は 2,700 人。本物の CDM は 100 万〜1 億人規模です。技術的ギャップは非常に大きい。本記事ではベトナム規模での Postgres OMOP CDM 運用ベストプラクティスを整理します。
1. ハードウェアサイジング
| 規模 | vCPU | RAM | SSD | RAM/data 比 |
|---|---|---|---|---|
| Dev (Eunomia) | 4 | 16 GB | 100 GB | n/a |
| 10 万人 | 8 | 32 GB | 500 GB | 1:5 |
| 100 万人 | 16 | 64 GB | 2 TB | 1:8 |
| 1000 万人 | 32 | 256 GB | 10 TB | 1:10 |
| 1 億人(BHYT 規模) | 64+ | 512 GB+ | 50 TB+ | 1:15 |
ストレージ分割:
pg_data:SSD NVMe RAID 10pg_wal:別 SSD(低レイテンシ)pg_temp:別 SSD(sort/hash join spill 用)
2. PostgreSQL 設定
# 64GB RAM 向け postgresql.conf
shared_buffers = 16GB              # RAM の 25%
effective_cache_size = 48GB         # RAM の 75%
work_mem = 256MB                    # クエリごと、同時実行に注意
maintenance_work_mem = 4GB
wal_buffers = 64MB
max_wal_size = 16GB
min_wal_size = 4GB
checkpoint_timeout = 30min
default_statistics_target = 500     # OMOP は skew が大きいので高めに
random_page_cost = 1.1              # SSD
effective_io_concurrency = 200      # SSD NVMe
max_parallel_workers_per_gather = 4
max_parallel_workers = 16
jit = on                            # PG12+、analytics に有効
work_mem × 同時接続数が RAM を超え得るので、pgBouncer transaction pooling、最大 50 接続を推奨。
3. インデックス戦略
OHDSI が標準 DDL を公開:OMOPCDM_postgresql_5.4_indices.sql。ワークロードに応じて追加:
-- 最もホットなテーブル:condition_occurrence、drug_exposure、measurement
CREATE INDEX idx_co_person ON condition_occurrence(person_id);
CREATE INDEX idx_co_concept ON condition_occurrence(condition_concept_id);
CREATE INDEX idx_co_date ON condition_occurrence USING BRIN(condition_start_date);  -- 時系列に BRIN

CREATE INDEX idx_co_concept_date ON condition_occurrence(condition_concept_id, condition_start_date);

-- Vocabulary
CREATE INDEX idx_concept_std ON concept(standard_concept) WHERE standard_concept = 'S';
CREATE INDEX idx_ca_anc_desc ON concept_ancestor(ancestor_concept_id, descendant_concept_id);

-- Cohort
CREATE INDEX idx_cohort_id_person ON cohort(cohort_definition_id, subject_id);

-- 部分統計
ALTER TABLE condition_occurrence ALTER COLUMN condition_concept_id SET STATISTICS 1000;
ANALYZE condition_occurrence;
4. 大規模データセット向けパーティション
CREATE TABLE condition_occurrence (
  ...
) PARTITION BY RANGE (condition_start_date);

CREATE TABLE condition_occurrence_2026
  PARTITION OF condition_occurrence
  FOR VALUES FROM ('2026-01-01') TO ('2027-01-01');

CREATE INDEX idx_co_2026_person ON condition_occurrence_2026(person_id);
メリット:
- 日付による pruning → クエリが 10 倍高速
- 古いパーティションの drop が高速(5 年保持)
- メンテナンス(VACUUM、REINDEX)の並列化
代替案:日付以外のコホートクエリ向けには person_id HASH パーティション。
5. Vacuum と bloat
OMOP は再 ETL で UPDATE/DELETE が多発 → bloat が大きい。
-- Auto vacuum チューニング
ALTER TABLE condition_occurrence SET (
  autovacuum_vacuum_scale_factor = 0.05,
  autovacuum_analyze_scale_factor = 0.02,
  fillfactor = 90
);

-- 大規模操作の手動実行
VACUUM ANALYZE condition_occurrence;
REINDEX TABLE CONCURRENTLY condition_occurrence;
Bloat モニタリング:
SELECT schemaname, relname, n_dead_tup, n_live_tup,
       round(n_dead_tup::numeric / NULLIF(n_live_tup, 0), 3) AS dead_ratio
FROM pg_stat_user_tables
WHERE n_dead_tup > 1000
ORDER BY dead_ratio DESC;
6. バックアップと DR
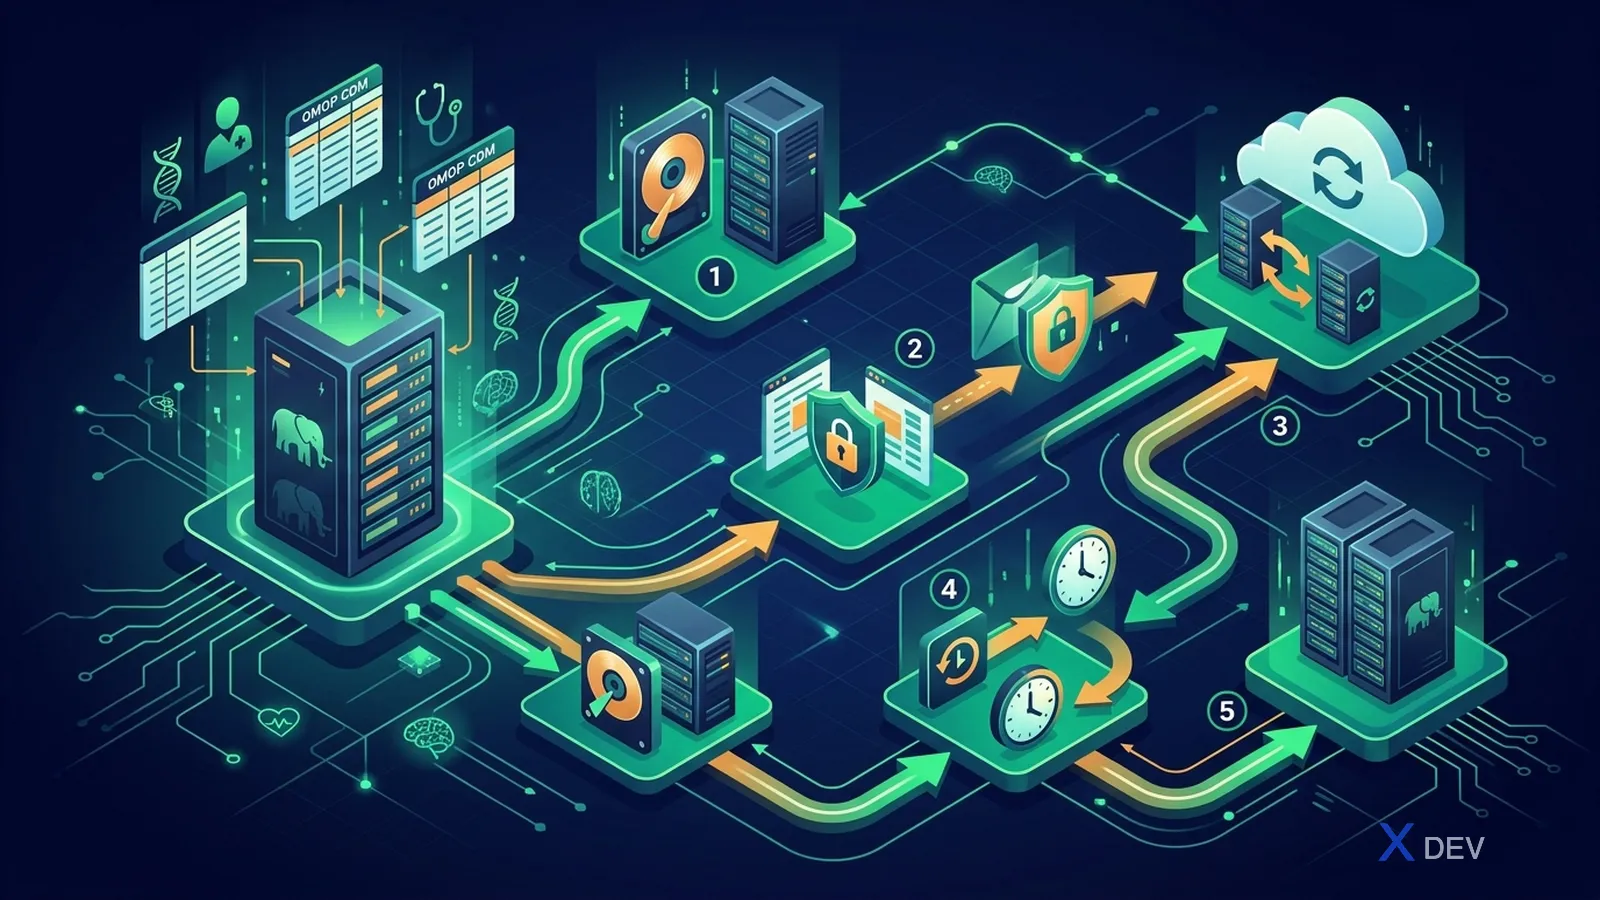
2026 年のパターン:
- 同 DC 内 streaming replication 1 standby(フェイルオーバー < 30 秒)
- DR サイトへの非同期レプリケーション
- pgBackRest 週次フル + 日次インクリメンタル + 連続 WAL → S3
- RPO 5 分、RTO < 1 時間
ベトナム:医療データは ベトナム個人データ保護法 2025(2026 年 1 月 1 日施行、政令 13/2023 を置換)で 機微個人データ に該当 — 国内保管必須、海外リージョンの S3 は使用不可。ベトナムのオブジェクトストレージを利用:VNG Cloud、Viettel IDC、FPT Cloud、CMC Cloud(いずれも個人データ保護法準拠認証あり)。
7. ベトナム個人データ保護法 2025 に従ったセキュリティ
2026 年法令アップデート:ベトナム個人データ保護法(2025 年 6 月国会通過、2026 年 1 月 1 日施行)は政令 13/2023/NĐ-CP を継承・強化し、診察治療法 No. 15/2023/QH15(2024 年 1 月 1 日施行 — 病歴記録、電子健康記録の保管を規定)と組み合わせて適用されます。
医療データの主要要件:
- at-rest と in-transit の暗号化
- すべての PII/PHI アクセスの監査ログ
- CCCD/BHYT の pseudonymize
- 国内保管
- DPO(Data Protection Officer)の責任
- 定期的なリスク評価
7.1 暗号化
# postgresql.conf
ssl = on
ssl_cert_file = '/etc/ssl/certs/postgres.crt'
ssl_key_file = '/etc/ssl/private/postgres.key'
ssl_ciphers = 'HIGH:!aNULL:!MD5'
At-rest:LUKS / ZFS encryption / TDE(Postgres 18 ネイティブ)を使用。
7.2 person_source_value の Pseudonymize
-- 生 CCCD は保存しない
person_source_value = encode(
  hmac(cccd::bytea, current_setting('app.pseudonym_secret')::bytea, 'sha256'),
  'hex'
);
鍵は別の Vault / KMS で管理。
7.3 Row-level security
ALTER TABLE person ENABLE ROW LEVEL SECURITY;

CREATE POLICY person_policy ON person
  FOR SELECT
  TO research_user
  USING (location_id IN (
    SELECT location_id FROM user_location_access
    WHERE user_id = current_user
  ));
7.4 監査ログ
-- pg_audit 拡張
CREATE EXTENSION pgaudit;
ALTER SYSTEM SET pgaudit.log = 'read,write,role,ddl';
ログは SIEM(Wazuh、Elasticsearch)へ送信。
8. ユーザーとロールのパターン
-- ロール分離
CREATE ROLE omop_owner;            -- DDL、ETL
CREATE ROLE omop_etl LOGIN;        -- ETL サービスアカウント
CREATE ROLE omop_analyst LOGIN;    -- HADES、analytics
CREATE ROLE omop_atlas_webapi LOGIN;  -- WebAPI サービス
CREATE ROLE omop_readonly_external LOGIN;  -- DARWIN EU パートナー

-- 付与
GRANT USAGE ON SCHEMA cdm TO omop_analyst, omop_atlas_webapi;
GRANT SELECT ON ALL TABLES IN SCHEMA cdm TO omop_analyst, omop_atlas_webapi;

-- Cohort スキーマは書き込み可
GRANT INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA results TO omop_atlas_webapi;
9. Vocabulary アップグレードのワークフロー
頻度:四半期。バージョンログを保管:
CREATE TABLE vocabulary_history (
  id SERIAL,
  vocabulary_version TEXT,
  installed_at TIMESTAMP,
  installed_by TEXT,
  rollback_available BOOLEAN
);
10. モニタリングスタック
| レイヤ | ツール |
|---|---|
| Postgres メトリクス | pg_stat_statements + Postgres Exporter + Prometheus + Grafana |
| Slow query | pg_stat_statements top 100 |
| Lock | pg_locks クエリ、idle_in_transaction > 10 分でアラート |
| レプリカラグ | streaming_lag クエリ |
| ETL ジョブ | Airflow / Prefect ダッシュボード |
| DQD トレンド | 週次 DQD スケジュール + Grafana で pct_failed パネル |
| セキュリティ | SIEM でロール昇格、大量 SELECT count にアラート |
11. キャパシティプランニング
| Component | 増加指標 |
|---|---|
condition_occurrence | 患者あたり月 3〜5 行 |
drug_exposure | 患者あたり月 5〜10 |
measurement | 患者あたり月 10〜20(検査 + バイタル) |
| Vocabulary | 四半期アップグレードで +500MB |
| Cohort テーブル | コホート生成ごと +50MB |
| 監査ログ | トラフィックにより日 100MB〜1GB |
ディスクは 3〜5 年先まで計画。
12. Kubernetes / マネージド Postgres?
選択肢:
- ベアメタル Postgres:制御性高、コスト低、運用負荷大
- Patroni + etcd クラスタ:自前構築の HA
- CloudNativePG / Zalando on K8s:モダン、スケーリング良
- マネージド:AWS RDS / GCP Cloud SQL / Azure Database — ベトナム:Viettel IDC PaaS Postgres、VNG Cloud Database
OMOP の大規模スケールでは、ベアメタルまたは CloudNativePG が依然として最高性能の選択肢。
13. スキーママイグレーションの CI/CD
# 生 SQL ではなく Liquibase / Flyway
flyway migrate -url=jdbc:postgresql://... -user=... -password=...
各マイグレーションにバージョン + スクリプト + ロールバック。
Vocabulary 変更は別ワークフロー(schema migration ではない)。
14. 学んだこと
- condition/drug/measurement を年でパーティション分割するとクエリが 5〜10 倍速くなる
- 日付列の BRIN インデックスはディスク節約
- 同時 50 接続超なら pgBouncer transaction pooling は必須
- ホットテーブルへの aggressive な vacuum で bloat 回避
- Vault でシークレットを Postgres 設定から分離
- 四半期ごとにバックアップリストアをテスト — テストしないバックアップは無いに等しい
- Vocabulary アップグレードはスキーマスワップしないと 1〜2 時間ダウンタイムになる
まとめ
Production OMOP には Postgres + DevOps + セキュリティのスキルが必要です。Day 1 から正しく投資すれば、リファクタなしで 1 億イベント超までスケールできます。特にベトナムでは 個人データ保護法 2025(2026 年 1 月 1 日施行)と 診察治療法 15/2023 に準拠したセキュリティが必要です — pseudonymize、監査、国内保管、DPO 必須、すべての研究プロジェクトに DPIA。