Eunomia 範例 CDM 有 2,700 人。實際 CDM 可能有 1 百萬到 1 億人。技術差距非常大。本文整理越南規模 Postgres OMOP CDM 的 production 最佳實務。
1. 硬體規模
| 規模 | vCPU | RAM | SSD | RAM/資料比 |
|---|---|---|---|---|
| Dev (Eunomia) | 4 | 16 GB | 100 GB | n/a |
| 10 萬病人 | 8 | 32 GB | 500 GB | 1:5 |
| 100 萬病人 | 16 | 64 GB | 2 TB | 1:8 |
| 1000 萬病人 | 32 | 256 GB | 10 TB | 1:10 |
| 1 億病人(BHYT 規模) | 64+ | 512 GB+ | 50 TB+ | 1:15 |
分區:
pg_data:SSD NVMe RAID 10pg_wal:獨立 SSD(低延遲)pg_temp:獨立 SSD(sort/hash join 溢位)
2. PostgreSQL 設定
# 64GB RAM 的 postgresql.conf
shared_buffers = 16GB              # 25% RAM
effective_cache_size = 48GB         # 75% RAM
work_mem = 256MB                    # 每查詢,須注意 concurrent
maintenance_work_mem = 4GB
wal_buffers = 64MB
max_wal_size = 16GB
min_wal_size = 4GB
checkpoint_timeout = 30min
default_statistics_target = 500     # OMOP skew 大故設高
random_page_cost = 1.1              # SSD
effective_io_concurrency = 200      # SSD NVMe
max_parallel_workers_per_gather = 4
max_parallel_workers = 16
jit = on                            # PG12+,對分析有利
注意 work_mem × concurrent connection 可能超過 RAM → 應採用 pgBouncer transaction pooling,connection 上限 50。
3. 索引策略
OHDSI 已發布標準 DDL:OMOPCDM_postgresql_5.4_indices.sql。可依 workload 補充:
-- 最熱的資料表:condition_occurrence、drug_exposure、measurement
CREATE INDEX idx_co_person ON condition_occurrence(person_id);
CREATE INDEX idx_co_concept ON condition_occurrence(condition_concept_id);
CREATE INDEX idx_co_date ON condition_occurrence USING BRIN(condition_start_date);  -- 時序資料用 BRIN

CREATE INDEX idx_co_concept_date ON condition_occurrence(condition_concept_id, condition_start_date);

-- Vocabulary
CREATE INDEX idx_concept_std ON concept(standard_concept) WHERE standard_concept = 'S';
CREATE INDEX idx_ca_anc_desc ON concept_ancestor(ancestor_concept_id, descendant_concept_id);

-- Cohort
CREATE INDEX idx_cohort_id_person ON cohort(cohort_definition_id, subject_id);

-- 局部統計值
ALTER TABLE condition_occurrence ALTER COLUMN condition_concept_id SET STATISTICS 1000;
ANALYZE condition_occurrence;
4. 大型資料集的 Partition
CREATE TABLE condition_occurrence (
  ...
) PARTITION BY RANGE (condition_start_date);

CREATE TABLE condition_occurrence_2026
  PARTITION OF condition_occurrence
  FOR VALUES FROM ('2026-01-01') TO ('2027-01-01');

CREATE INDEX idx_co_2026_person ON condition_occurrence_2026(person_id);
優點:
- 依日期 pruning → 查詢加速 10 倍
- 刪除舊分區極快(資料保留 5 年)
- 維護(VACUUM、REINDEX)可平行進行
替代方案:依 person_id HASH 分區,適合多樣化日期範圍的世代查詢。
5. Vacuum 與 bloat
OMOP 在重跑 ETL 時會有大量 UPDATE/DELETE → bloat 大。
-- Auto vacuum 調整
ALTER TABLE condition_occurrence SET (
  autovacuum_vacuum_scale_factor = 0.05,
  autovacuum_analyze_scale_factor = 0.02,
  fillfactor = 90
);

-- 大型操作手動執行
VACUUM ANALYZE condition_occurrence;
REINDEX TABLE CONCURRENTLY condition_occurrence;
監控 bloat:
SELECT schemaname, relname, n_dead_tup, n_live_tup,
       round(n_dead_tup::numeric / NULLIF(n_live_tup, 0), 3) AS dead_ratio
FROM pg_stat_user_tables
WHERE n_dead_tup > 1000
ORDER BY dead_ratio DESC;
6. 備份與災難復原
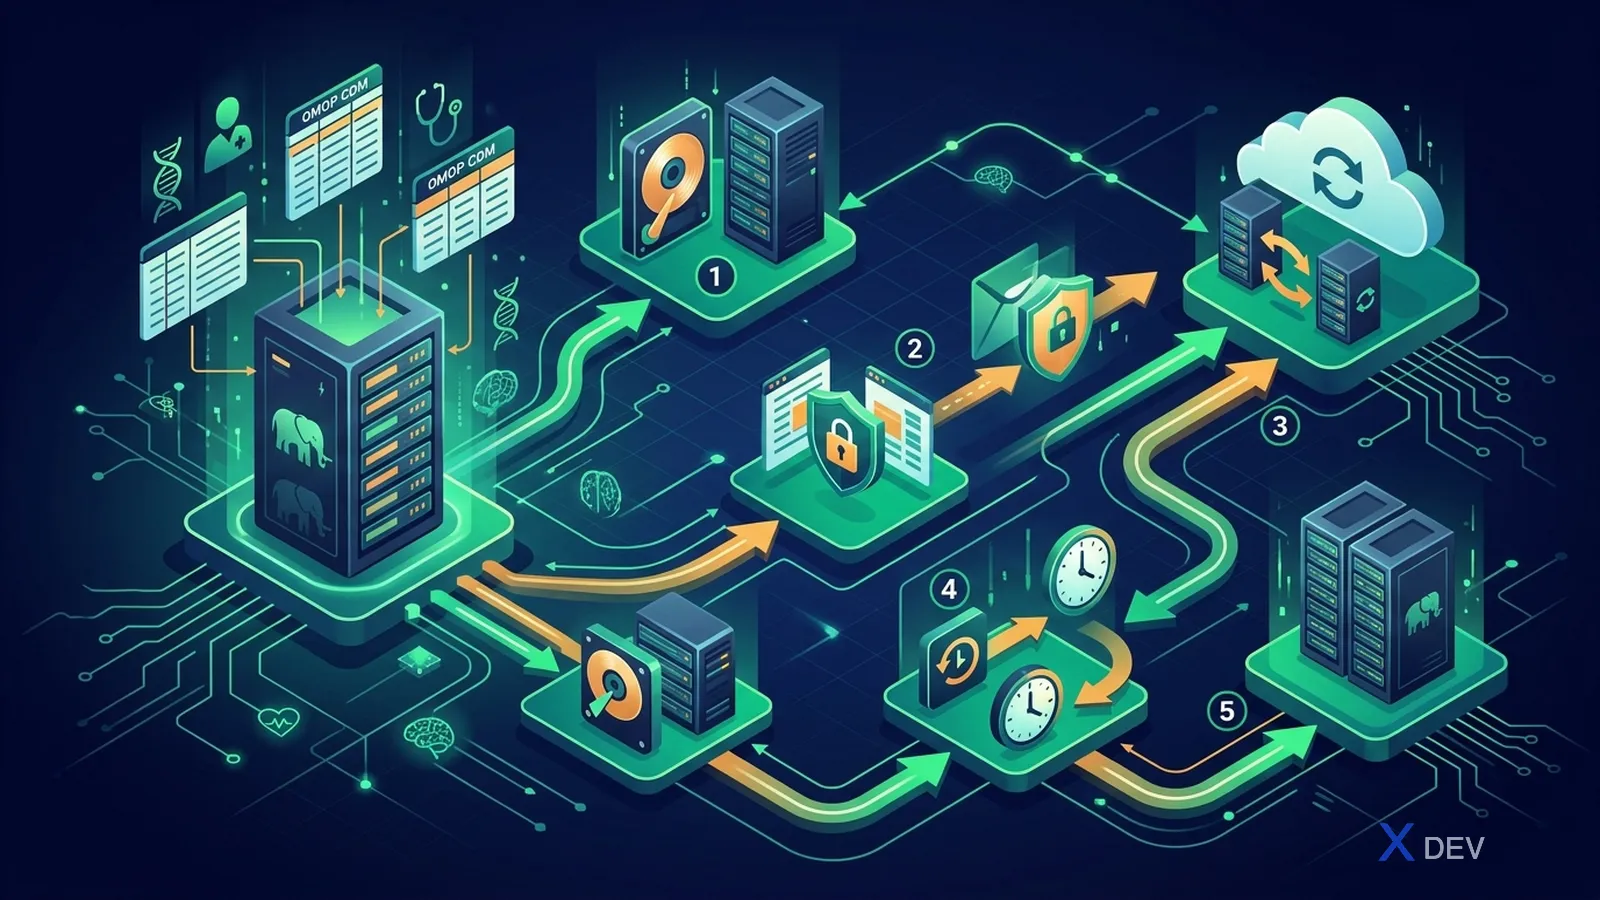
2026 年的常見模式:
- 同 DC 串流複寫 1 個 standby(failover < 30 秒)
- 至 DR 站點的非同步複寫
- pgBackRest 每週完整 + 每日增量 + 持續 WAL → S3
- RPO 5 分鐘,RTO < 1 小時
越南:醫療資料屬於敏感個人資料,依**越南個人資料保護法 2025(2026 年 1 月 1 日生效,取代第 13/2023 號政令)**規定 — 必須在境內儲存,不可使用境外 S3 region。請使用越南雲端供應商:VNG Cloud、Viettel IDC、FPT Cloud、CMC Cloud(均符合個資保護法合規認證)。
7. 依越南個人資料保護法 2025 的安全性
2026 年法規更新:越南個人資料保護法(2025 年 6 月國會通過,2026 年 1 月 1 日生效)取代並升級第 13/2023 號政令,並結合第 15/2023/QH15 號醫療法(2024 年 1 月 1 日生效) — 規範電子病歷與電子健康紀錄(HSDT)的保存。
醫療資料的主要要求:
- 靜態與傳輸中加密
- 所有 PII/PHI 存取均需稽核紀錄
- 假名化身分證字號 / BHYT 號
- 境內儲存
- 由資料保護長(DPO)負責
- 定期風險評估
7.1 加密
# postgresql.conf
ssl = on
ssl_cert_file = '/etc/ssl/certs/postgres.crt'
ssl_key_file = '/etc/ssl/private/postgres.key'
ssl_ciphers = 'HIGH:!aNULL:!MD5'
靜態加密:採用 LUKS / ZFS 加密 / TDE(Postgres 18 原生)。
7.2 假名化 person_source_value
-- 不存原始身分證字號
person_source_value = encode(
  hmac(cccd::bytea, current_setting('app.pseudonym_secret')::bytea, 'sha256'),
  'hex'
);
金鑰存放於獨立的 Vault / KMS。
7.3 列級安全性(Row-level security)
ALTER TABLE person ENABLE ROW LEVEL SECURITY;

CREATE POLICY person_policy ON person
  FOR SELECT
  TO research_user
  USING (location_id IN (
    SELECT location_id FROM user_location_access
    WHERE user_id = current_user
  ));
7.4 稽核紀錄
-- pg_audit 擴充
CREATE EXTENSION pgaudit;
ALTER SYSTEM SET pgaudit.log = 'read,write,role,ddl';
紀錄送至 SIEM(Wazuh、Elasticsearch)。
8. 使用者與角色模式
-- 角色分離
CREATE ROLE omop_owner;            -- DDL、ETL
CREATE ROLE omop_etl LOGIN;        -- ETL service account
CREATE ROLE omop_analyst LOGIN;    -- HADES、analytics
CREATE ROLE omop_atlas_webapi LOGIN;  -- WebAPI service
CREATE ROLE omop_readonly_external LOGIN;  -- DARWIN EU partner

-- Grant
GRANT USAGE ON SCHEMA cdm TO omop_analyst, omop_atlas_webapi;
GRANT SELECT ON ALL TABLES IN SCHEMA cdm TO omop_analyst, omop_atlas_webapi;

-- Cohort schema 開放寫入
GRANT INSERT, UPDATE, DELETE ON ALL TABLES IN SCHEMA results TO omop_atlas_webapi;
9. 詞彙升級工作流程
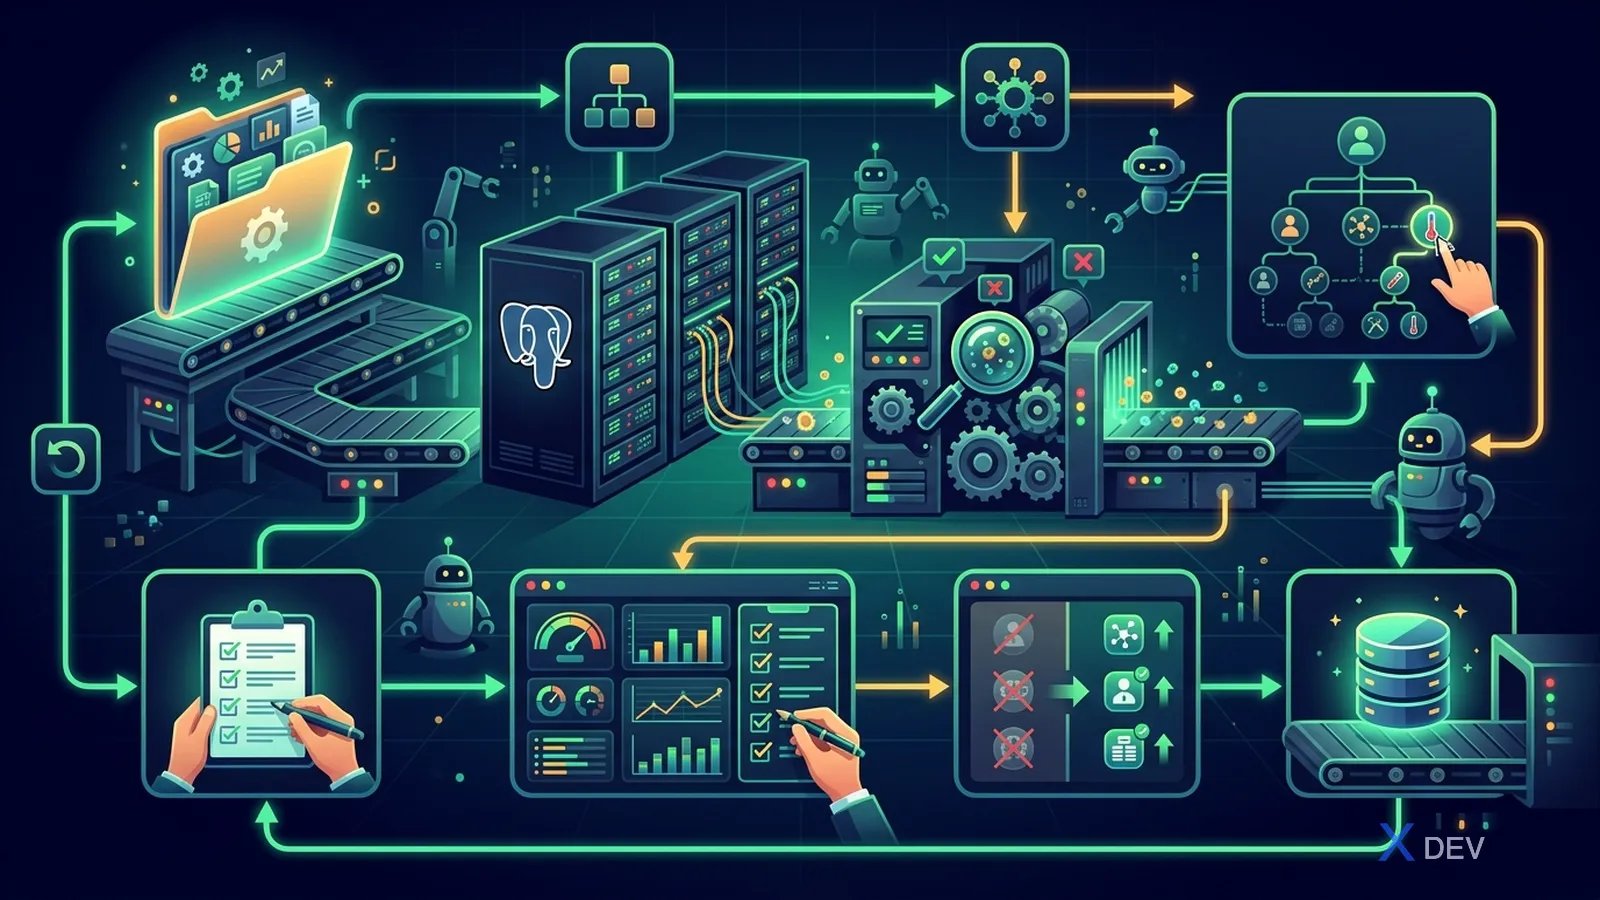
頻率:每季。保留版本紀錄:
CREATE TABLE vocabulary_history (
  id SERIAL,
  vocabulary_version TEXT,
  installed_at TIMESTAMP,
  installed_by TEXT,
  rollback_available BOOLEAN
);
10. 監控堆疊
| 層次 | 工具 |
|---|---|
| Postgres 指標 | pg_stat_statements + Postgres Exporter + Prometheus + Grafana |
| 慢查詢 | pg_stat_statements top 100 |
| 鎖 | pg_locks 查詢,idle_in_transaction > 10 分鐘告警 |
| Replica lag | streaming_lag 查詢 |
| ETL job | Airflow / Prefect dashboard |
| DQD trend | 每週排程 DQD + Grafana 顯示 pct_failed |
| 安全性 | SIEM 對角色提權、大量 SELECT count 告警 |
11. 容量規劃
| 元件 | 成長指標 |
|---|---|
condition_occurrence | 每病人每月 ~3-5 筆 |
drug_exposure | 每病人每月 ~5-10 筆 |
measurement | 每病人每月 ~10-20 筆(lab + vital) |
| Vocabulary | 每季升級 +500MB |
| Cohort 表 | 每次世代產生 +50MB |
| 稽核紀錄 | 依流量每天 100MB-1GB |
依 3-5 年的前瞻規劃磁碟容量。
12. Kubernetes / 託管 Postgres?
選項:
- Bare metal Postgres:控制力強、成本低、運維重
- Patroni + etcd cluster:自建 HA
- CloudNativePG / Zalando 在 K8s:現代,擴展性好
- 託管:AWS RDS / GCP Cloud SQL / Azure Database — 越南:Viettel IDC PaaS Postgres、VNG Cloud Database
OMOP 大規模情境 → bare metal 或 CloudNativePG 仍是效能最佳的選擇。
13. Schema migration 的 CI/CD
# 用 Liquibase / Flyway 取代手寫 SQL
flyway migrate -url=jdbc:postgresql://... -user=... -password=...
每個 migration 都有版本 + 腳本 + rollback。
詞彙升級採獨立工作流(非 schema migration)。
14. 經驗教訓
- 將 condition/drug/measurement 依年份 partition,可讓查詢加速 5-10 倍
- 在 date 欄位用 BRIN index 可節省磁碟
- 並行連線超過 50 時必須使用 pgBouncer transaction pooling
- 對熱表使用較積極的 vacuum 以避免 bloat
- Vault 將 secret 與 Postgres config 分離
- 每季測試備份還原 — 沒測試的備份等於沒備份
- 詞彙升級若不採 schema swap 可能造成 1-2 小時停機
結論
Production OMOP 同時需要 Postgres + DevOps + 安全性技能。Day 1 就投入正確,可擴展至 1 億+ 事件而無需重構。越南尤其需依個人資料保護法 2025(2026 年 1 月 1 日生效)與第 15/2023 號醫療法進行假名化、稽核、境內儲存,DPO 為強制要求,任何研究專案都必須做 DPIA。