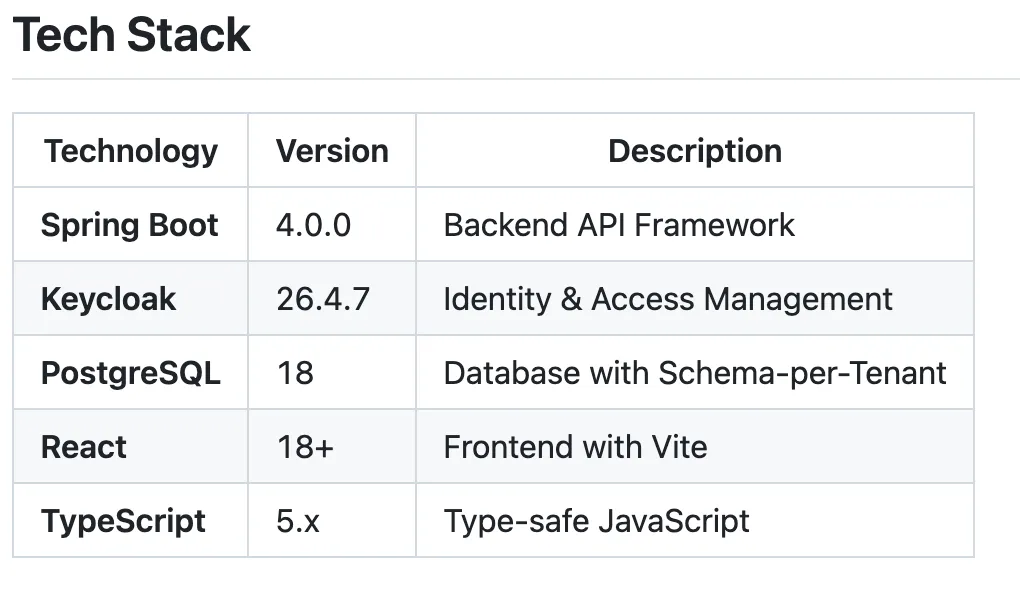
ピアユニットが相互に完全に分離されている一方で、上司がすべての部下のデータを監視できるシステムを構築するにはどうすればよいでしょうか?この記事では、政府から多国籍企業、数千の支店を持つ小売チェーンに至るまで、階層構造システムのデータ分散化アーキテクチャを詳細に分析します。
パート 1: 分散化の問題
1.1.階層構造の特徴
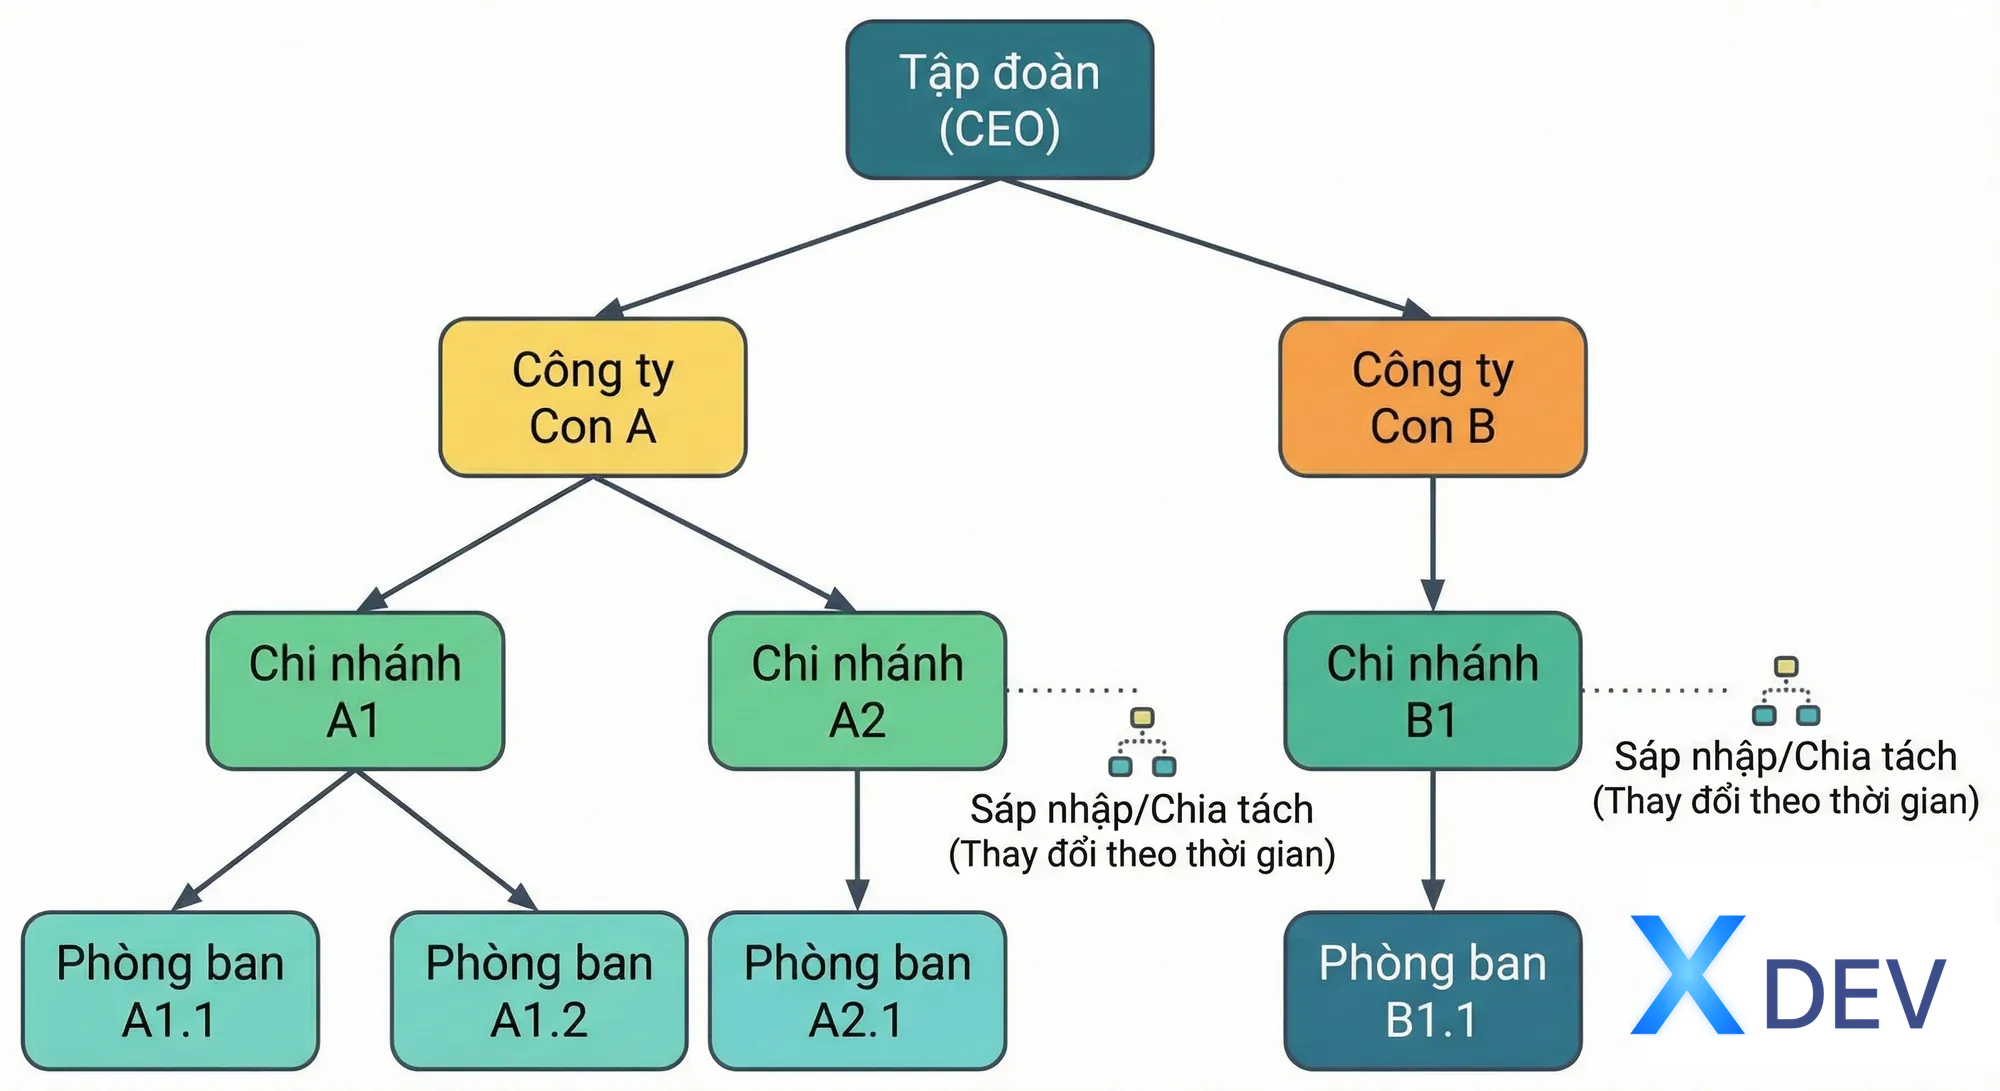
多くの組織は階層構造に従って運営されています。企業には子会社があり、子会社には支店があり、支店には部門があります。政府には省庁、州、地区、区、コミューンがあります。小売チェーンには地域、地域、店舗があります。
これらの構造に共通するのは人間関係です 親子 ユニット間で次の特性を持つツリーを形成します。
- 各ユニット (ルートを除く) には親ユニットが 1 つだけあります
- 各ユニットには多くのサブユニットを含めることができます
- ツリーの深さは枝によって異なる場合があります
- 時間の経過とともに構造が変化する可能性があります(合併、分割、再編)
1.2.特定の許可が必要です
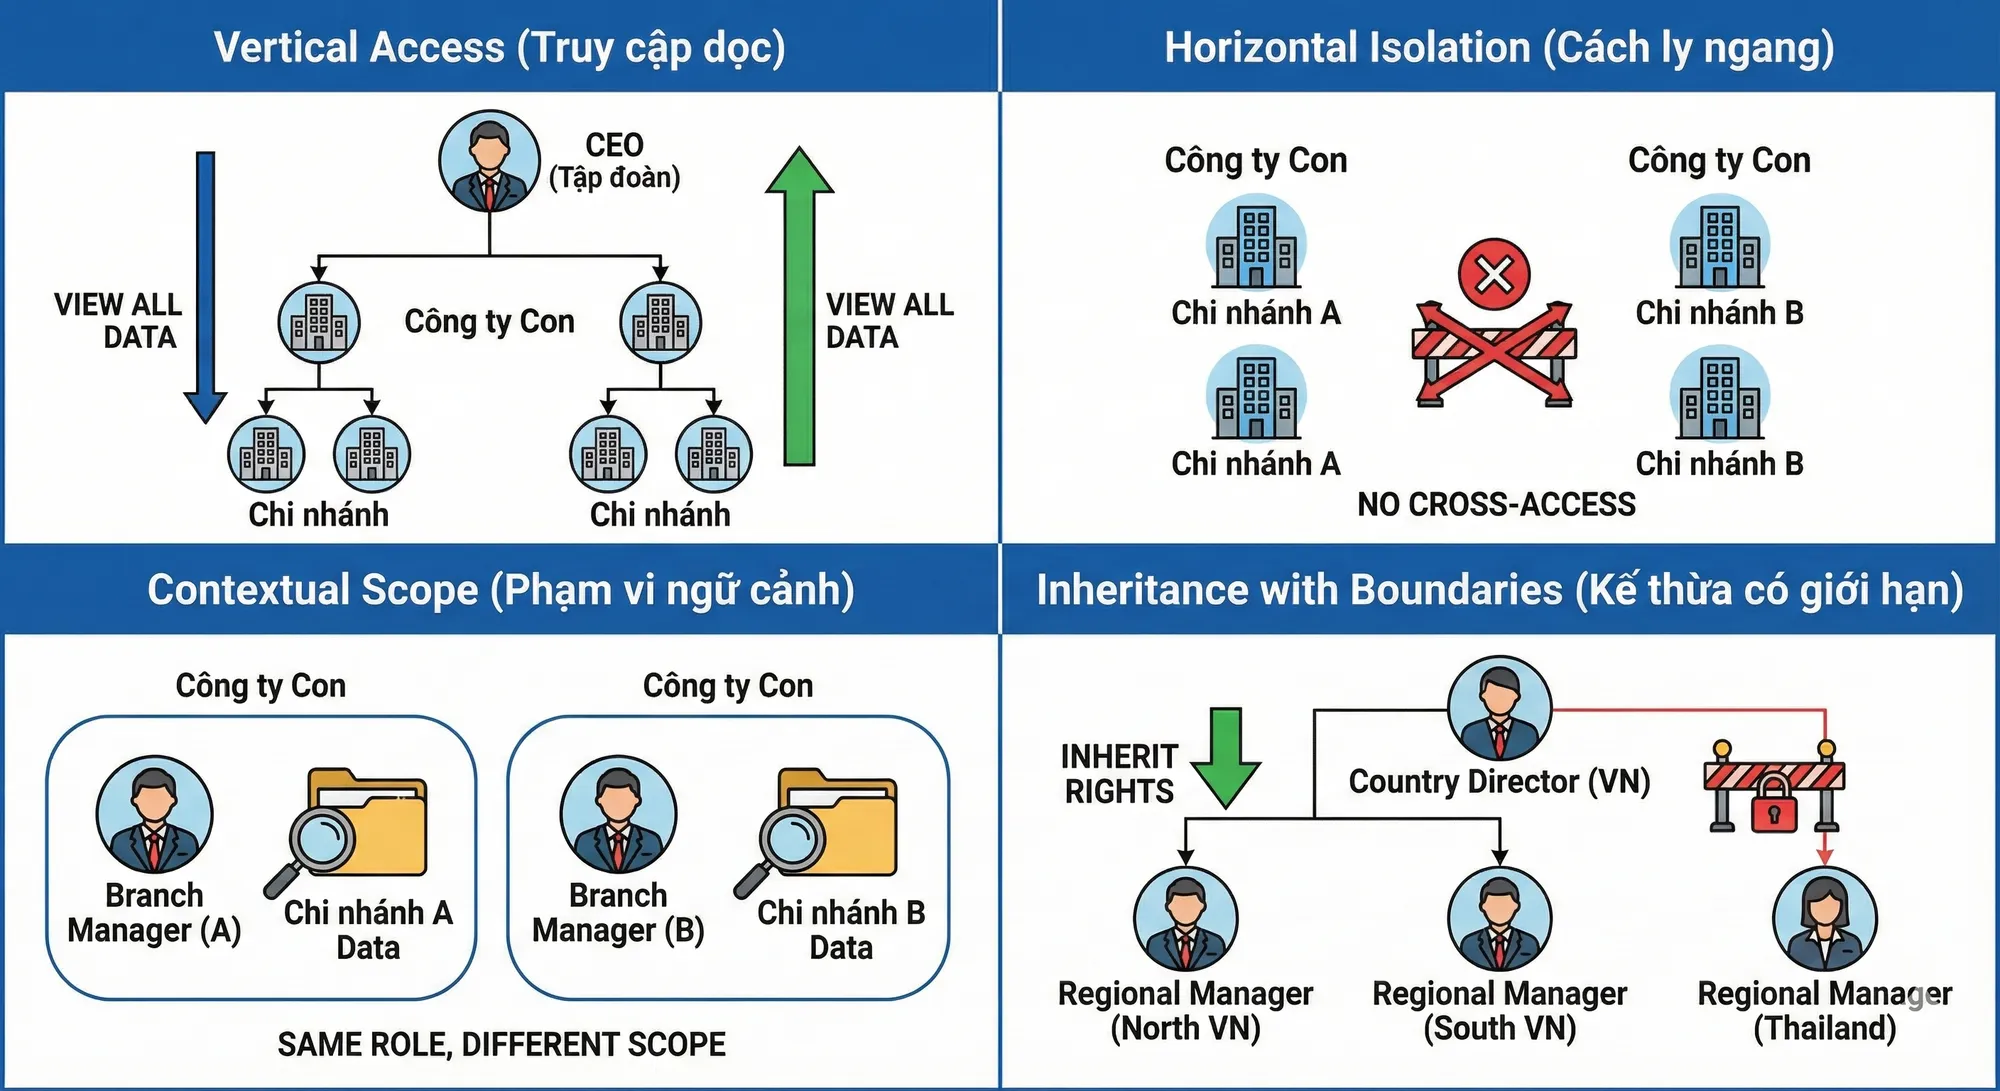
分散システムでは、フラットな許可モデルでは満たすことができない特別な許可要件が課されます。
垂直アクセス: 上司はすべての部下のデータを参照できる必要があります。 CEO は、すべての子会社や関連会社を含む企業全体のレポートを確認する必要があります。地域マネージャーは、地域内のすべての店舗のデータを確認する必要があります。
水平方向の分離: 同じレベルのユニットは、お互いのデータを参照することはできません。支店 A は、支店 B の収益を確認できません (両方が同じ子会社に属している場合でも)。これにより、公正な競争とビジネス情報のセキュリティが確保されます。
コンテキストの範囲: 同じ役割ですが範囲が異なります。支店 A の「支店長」は支店 A のみを管理します。支店Bの「支店長」は支店Bを管理するだけです。役割も権限も同じですが、アクセスできるデータが全く異なります。
境界のある継承: 権限は垂直方向に継承されますが、水平方向には継承されません。カントリーディレクターは、その国内では地域マネージャーのすべての権利を継承しますが、他の国では何も継承しません。
1.3.なぜフラットな分散化が失敗するのか
フラットな分散モデルでは、階層の概念を使用せずに、ユーザーまたはロールに権限を直接割り当てます。階層に適用すると、多くの問題に直面します。
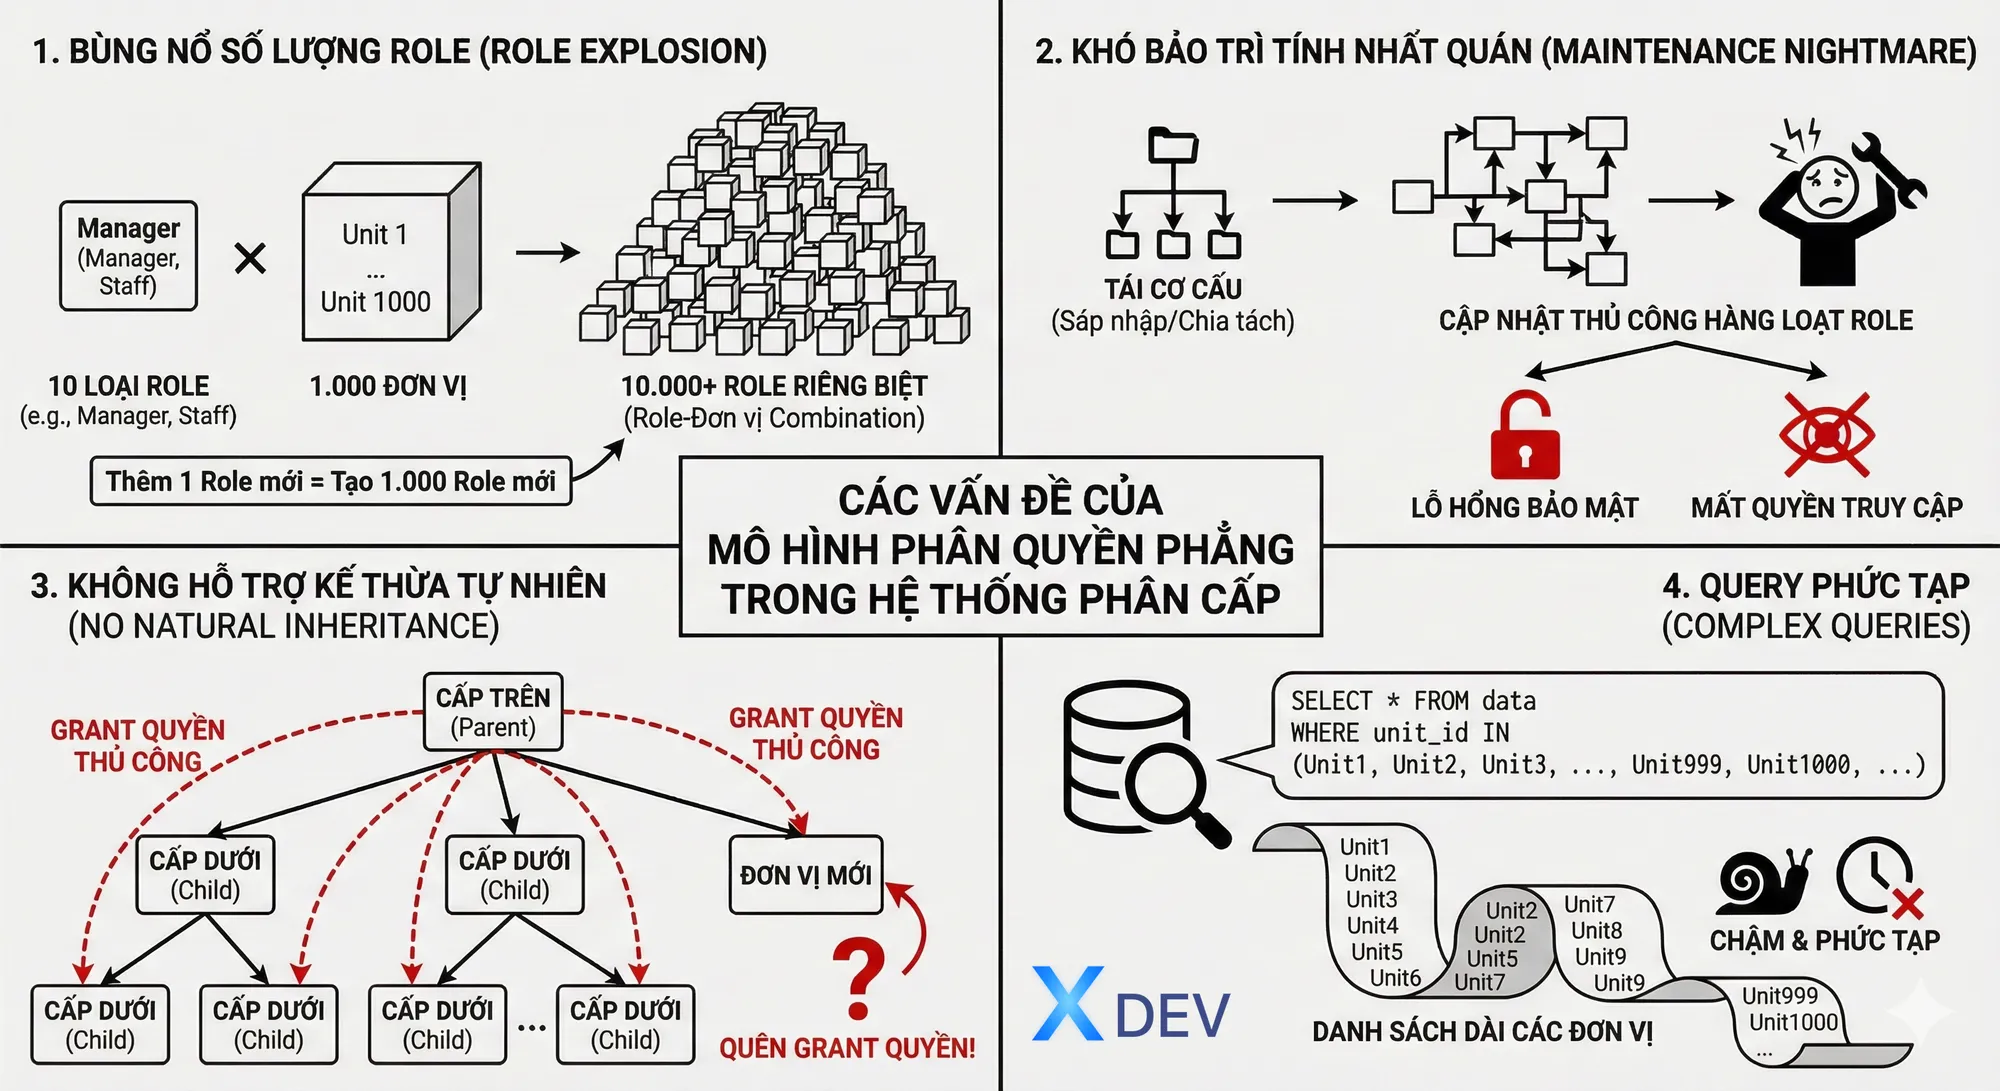
役割の数が爆発的に増加: 10 種類のロールと 1,000 個のユニットがある場合、理論的には 10,000 個の個別のロールが必要になります (各ロール ユニットは組み合わせです)。新しいロール タイプを追加すると、1,000 個の新しいロールが作成されることになります。
一貫性を維持するのが難しい: ユニットが再構築 (合併、分割) される場合、関連するすべての役割を手動で更新する必要があります。エラーはセキュリティ違反や有効なアクセス権の喪失につながります。
自然継承はサポートされていません: 上司が下位データを表示するには、各下位ユニットに手動で権限を付与する必要があります。新しいユニットを追加するとき、上司に権限を与えるのを忘れがちです。
複雑なクエリ: 各データ クエリには許可される単位の長いリストを含める必要があるため、クエリが複雑になり、時間がかかります。
1.4.規模と複雑さ
問題は次のように複雑になります。
- ユニット数: 数十から数万まで
- ツリーの深さ: 2~3レベルから5~6レベル以上まで
- 構造のダイナミクス: 固定構造と頻繁に変更される構造
- ユーザー数: 数百から数百万まで
- レイテンシー要件: リアルタイム アプリケーションの場合はミリ秒
- コンプライアンス要件: 監査証跡、データの保存場所、暗号化
パート 2: 理論的基礎
2.1. NIST 標準に準拠した RBAC とバリアント
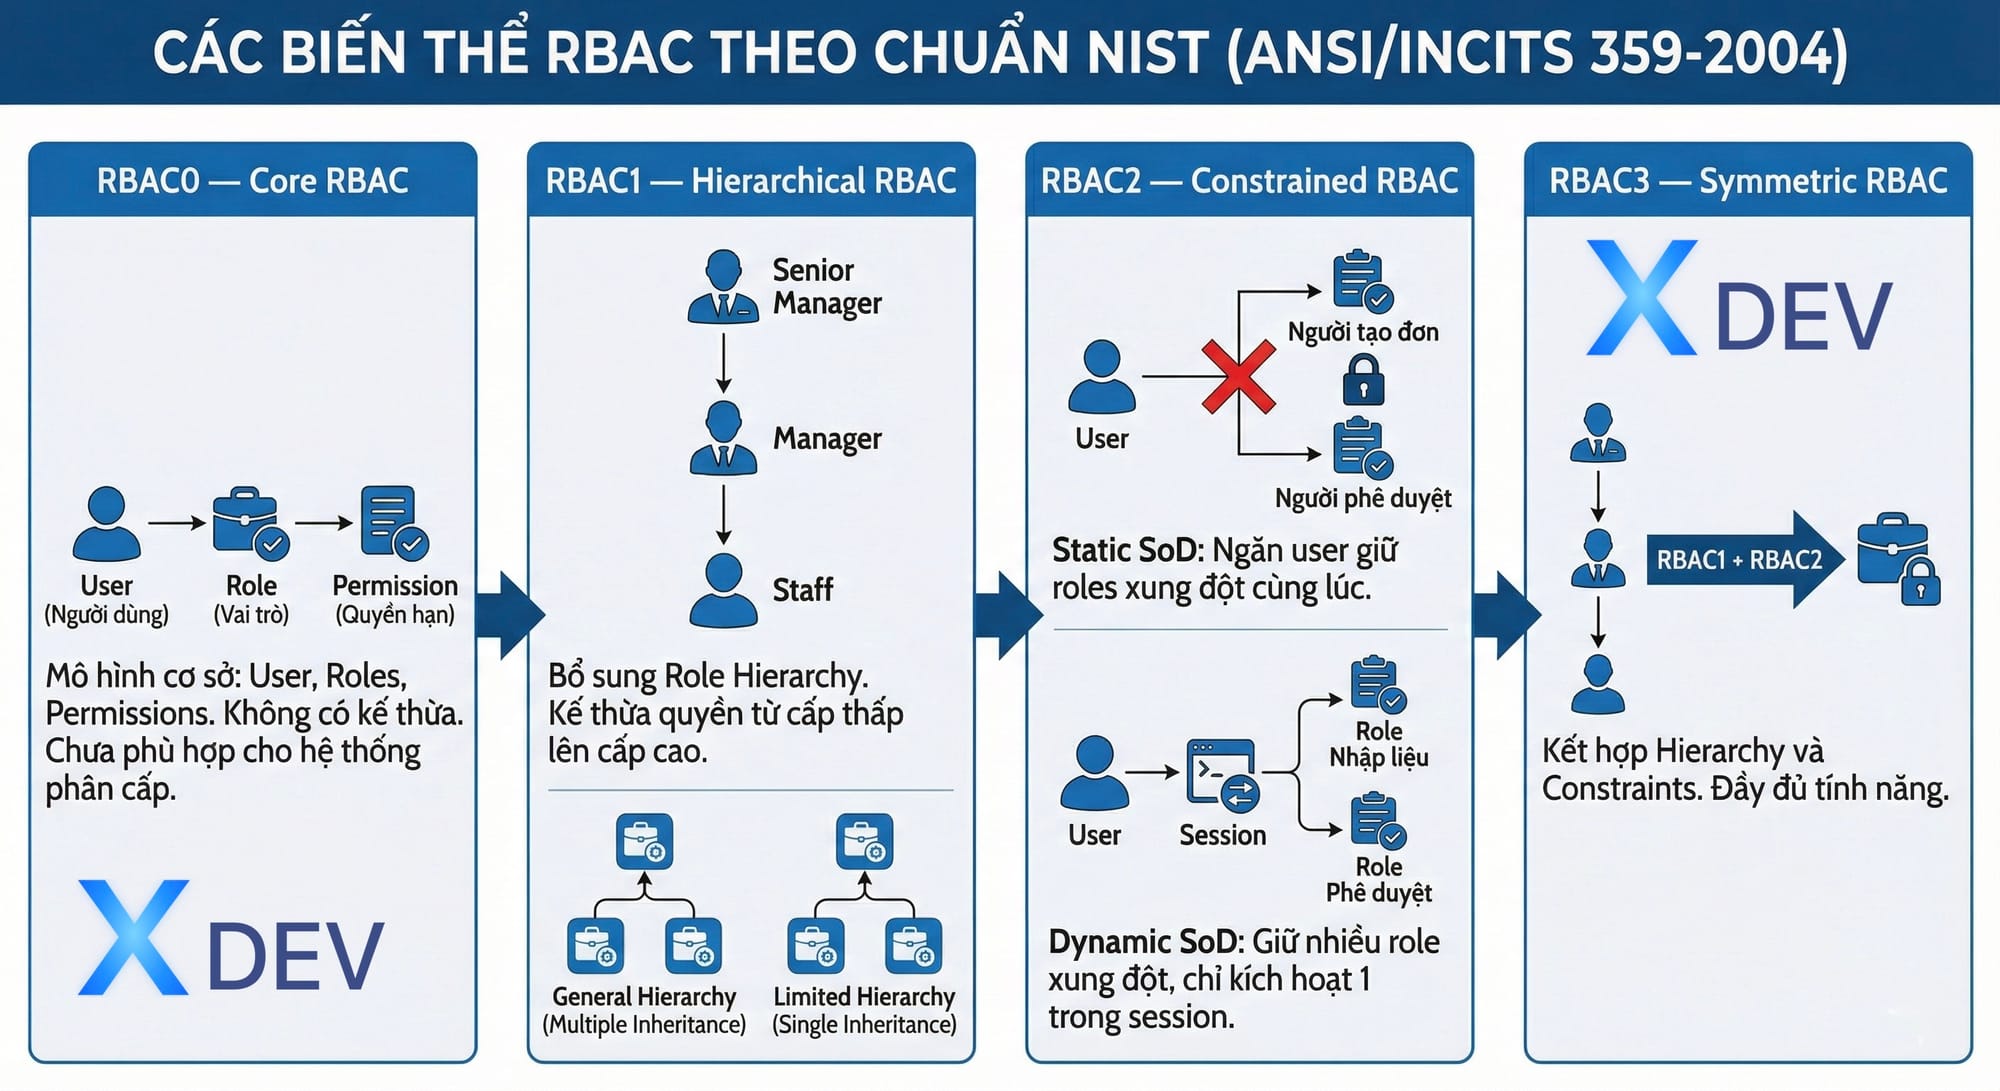
役割ベースのアクセス制御 (RBAC) は、ANSI/INCITS 359-2004 標準で NIST によって標準化されており、次の 4 つのレベルに分かれています。
RBAC0 — コア RBAC: ユーザー、ロール、権限の 3 つのコンポーネントを含む基本モデル。ユーザーにはロールが割り当てられ、ロールには権限が割り当てられます。これは基礎ですが、継承の概念が欠けており、階層システムには適していません。
RBAC1 — 階層型 RBAC: 役割階層が追加され、高レベルの役割が低レベルの役割のすべての権限を継承できるようになりました。例: シニア マネージャーはマネージャーから権限を継承し、マネージャーはスタッフから権限を継承します。これは階層的な組織構造に最も適したモデルです。
階層には 2 つのタイプがあります。
- 一般的な階層: 複数の継承が可能 - 1 つのロールが他の多くのロールから継承可能
- 限定された階層: 単一の継承のみが許可されます。各ロールは単一のロールからのみ継承し、単純なツリーを作成します。
RBAC2 — 制約付き RBAC: 制約を追加します。最も重要なのは職務分離 (SoD) です。
- 静的 SoD: ユーザーが競合する役割を同時に保持できないようにします。たとえば、「注文作成者」と「注文承認者」の両方になることはできません。
- 動的SoD: 複数の競合するロールを保持できますが、セッション内で同時にアクティブ化することはできません。ユーザーは「データ入力」と「承認」の両方の役割を持つことができますが、ログイン時にどちらかを選択する必要があります。
RBAC3 — 対称 RBAC: RBAC1 と RBAC2 を組み合わせて、完全な階層と制約を提供します。
2.2. ABAC — 属性ベースのアクセス制御
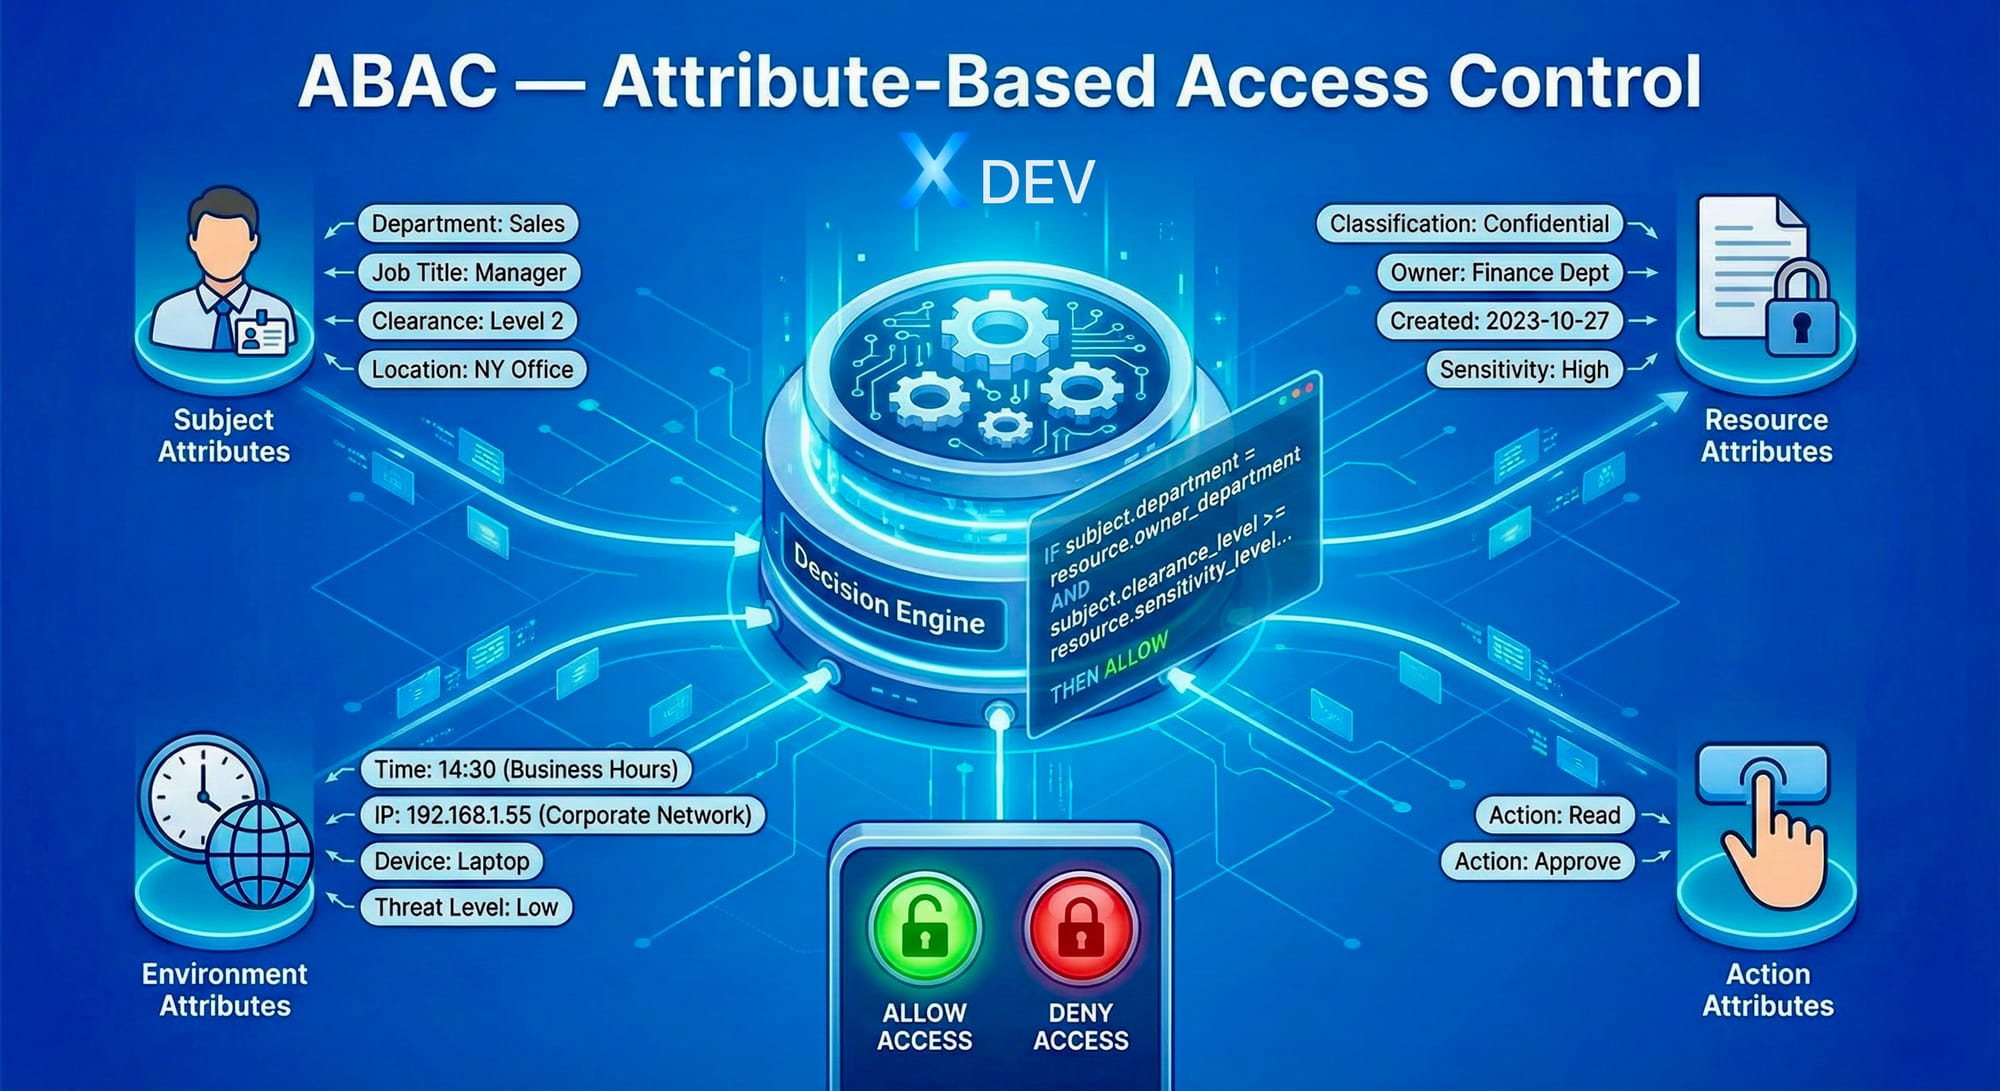
ABAC は、認可の決定を行うときに複数の属性を評価することで RBAC を拡張します。
- 件名の属性: ユーザープロパティ — 部門、役職、許可レベル、場所
- リソースの属性: リソースのプロパティ - 分類、所有者、作成日、機密レベル
- 環境属性: コンテキスト プロパティ — 時刻、IP アドレス、デバイス タイプ、脅威レベル
- アクション属性: アクションの種類 - 読み取り、書き込み、削除、承認
ポリシー ABAC はルールとして記述されます。たとえば:
IF subject.department = resource.owner_department
AND subject.clearance_level >= resource.sensitivity_level
AND environment.time IN business_hours
AND environment.ip_range IN corporate_network
THEN ALLOW action
ABAC は強力で柔軟性がありますが、展開が複雑でデバッグが難しく、ポリシーが複雑な場合はパフォーマンスに影響を与える可能性があります。完全な代替としてではなく、詳細な制御が必要な場合には、RBAC に加えて ABAC を使用することをお勧めします。
2.3.マルチテナンシーとモデル
マルチテナンシーは、システムが分離されたデータを使用して複数の独立したテナント (ユニット/組織) にサービスを提供できるようにするアーキテクチャです。
サイロ化モデル — テナントごとのデータベース: 各テナントには個別のデータベースがあります。完全な分離、テナントごとのカスタマイズが容易、データ常駐要件への準拠が容易。欠点: インフラストラクチャのコストが高い、テナントの数が多い場合の維持が困難、テナント間のレポートが複雑。
ブリッジ モデル — テナントごとのスキーマ: テナントは同じデータベース インスタンスを共有しますが、各テナントには独自のスキーマがあります。分離と効率のバランス。欠点: 1 つのデータベース内のスキーマの数が限られている、移行が複雑。
プールされたモデル — すべてを共有: すべてのテナントは同じデータベースとスキーマを共有し、tenant_id 列によって区別されます。コストが最も低く、拡張が容易で、保守も容易です。短所: アプリケーション層とデータベース層で強力な分離メカニズムが必要であり、1 つのバグがすべてのテナントに影響を与える可能性があります。
推奨事項: ほとんどの場合、行レベル セキュリティ (RLS) を備えたプール モデル。データ常駐に特別な要件がある場合、またはテナントに詳細なカスタマイズが必要な場合にのみ、サイロ モデルを使用してください。
2.4.階層型マルチテナンシー
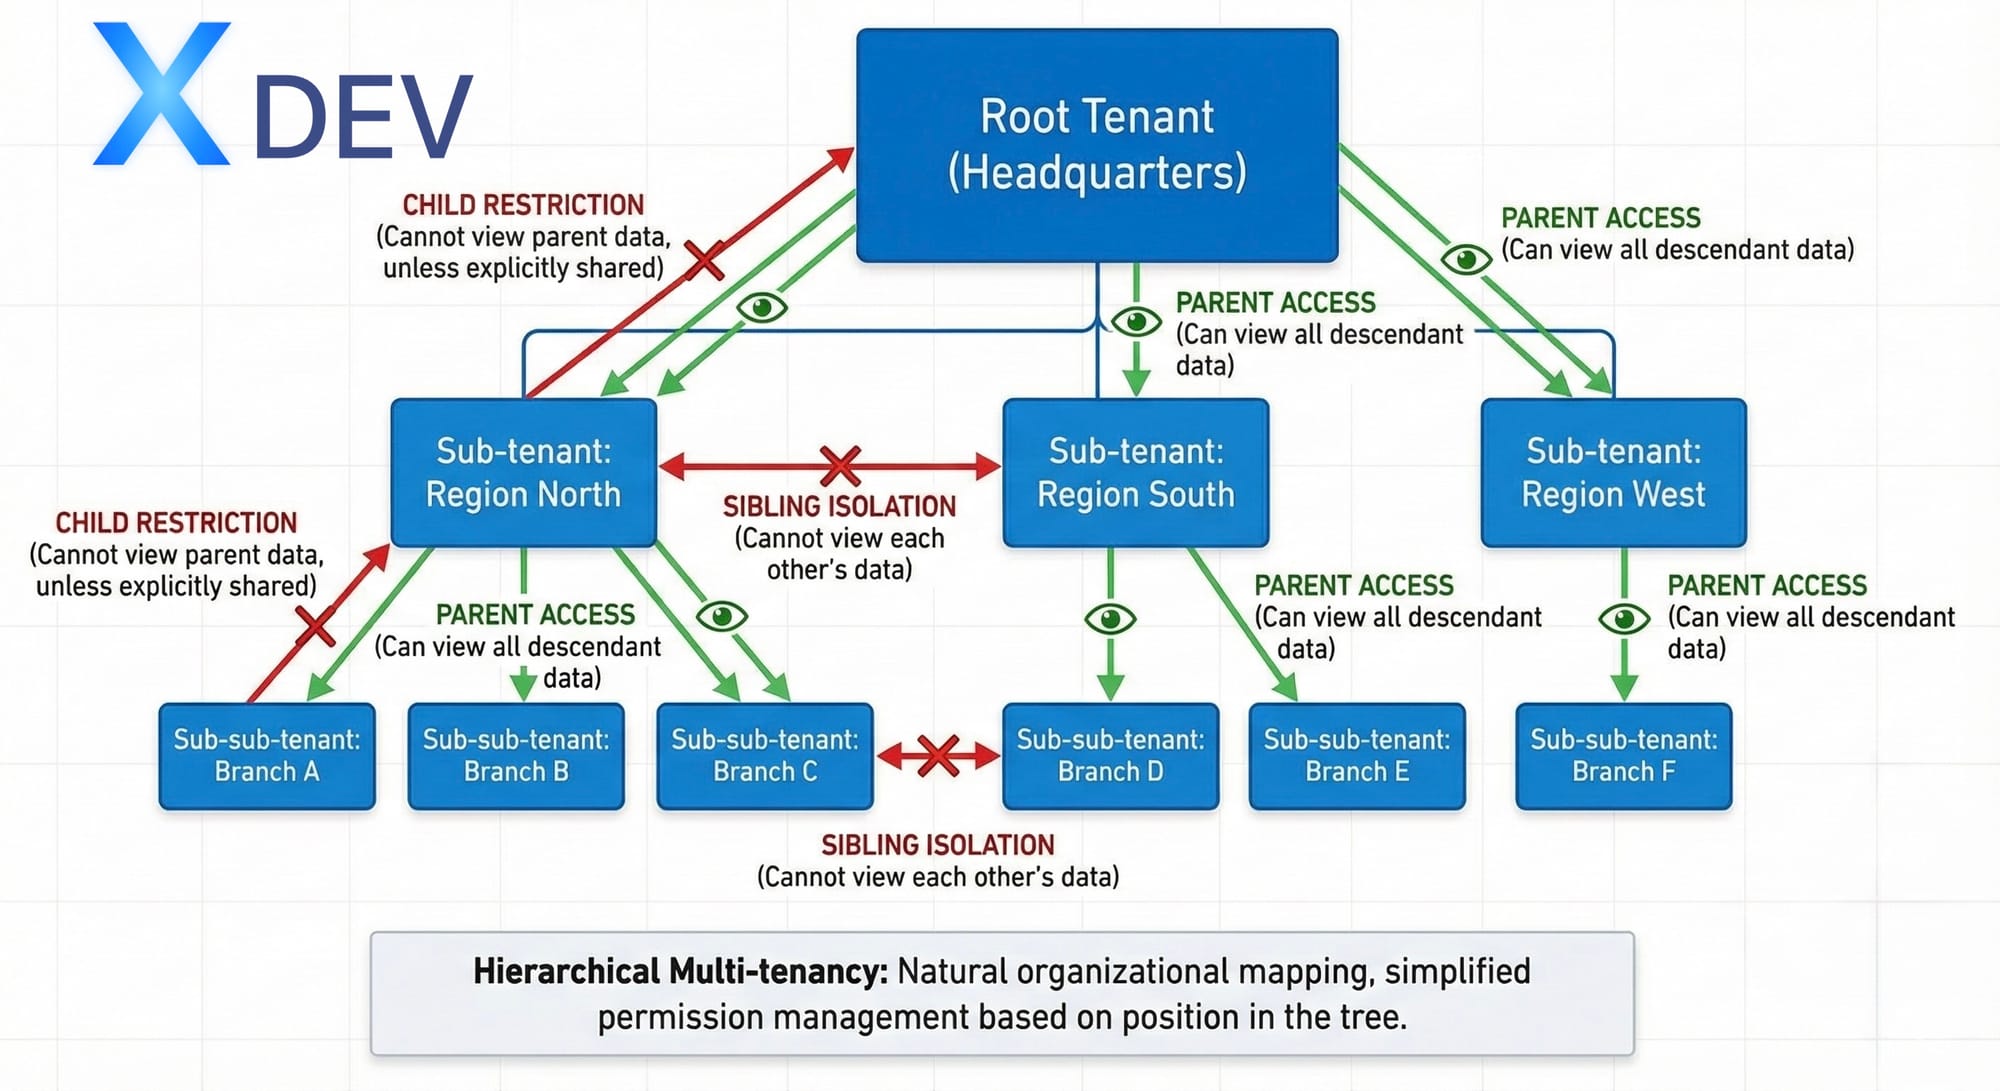
以下はマルチテナントを階層構造に拡張したもので、テナントがフラット リストではなくツリーに編成されています。
Root Tenant (Headquarters)
├── Sub-tenant: Region North
│   ├── Sub-sub-tenant: Branch A
│   ├── Sub-sub-tenant: Branch B
│   └── Sub-sub-tenant: Branch C
├── Sub-tenant: Region South
│   ├── Sub-sub-tenant: Branch D
│   └── Sub-sub-tenant: Branch E
└── Sub-tenant: Region West
    └── Sub-sub-tenant: Branch F
アクセスルール:
- 親テナントはすべての子孫テナントのデータを表示できます
- 兄弟テナント (同じレベル、同じ親) はお互いのデータを表示できません
- 子テナントは親のデータを表示できません(明示的に共有されたデータを除く)
このモデルは組織構造に自然にマッピングされ、権限管理が簡素化されます。各ユニットに権限を付与する代わりに、ツリー内でのユーザーの位置を決定するだけです。
パート 3: 階層のデータ モデルの設計
3.1.データベース内でツリーを表現する方法
リレーショナル データベースでツリー構造を表現するには多くのアプローチがあり、それぞれに独自のトレードオフがあります。
隣接リスト: 各ノードは、その親の ID を直接保存します。これが最もシンプルで自然な方法です。
利点: 理解しやすく、実装も簡単で、挿入/更新/削除が簡単で、外部キーを使用して整合性を強制するのも簡単です。
短所: すべての子孫または祖先を取得するためのクエリには再帰クエリ (SQL の WITH RECURSIVE) が必要ですが、深いツリーや大きなツリーでは時間がかかる可能性があります。
次の場合に適しています。 ツリーはあまり深くなく (< 10 レベル)、主に親子を直接クエリし、構造は頻繁に変更されます。
ネストされたセット: 各ノードには、左と右の 2 つの値が保存されます。ノードのすべての子孫は範囲 (parent.left、parent.right) 内に left/right を持ちます。
利点: 子孫のクエリは非常に高速で (BETWEEN 条件のみが必要)、再帰は必要ありません。
短所: 挿入/更新/削除は、他の多くのノードの左側/右側を更新する必要があるため、非常に遅くなります。同時変更は複雑です。
次の場合に適しています。 ツリーはめったに変更されず、子孫を頻繁にクエリするため、書き込みパフォーマンスのトレードオフを受け入れることができます。
クロージャテーブル: すべての祖先と子孫のペアを深さのある別のテーブルに保存します。たとえば、A → B → C の場合、クロージャ テーブルには (A,A,0)、(A,B,1)、(A,C,2)、(B,B,0)、(B,C,1)、(C,C,0) が含まれます。
利点: クエリの祖先と子孫はどちらも高速であり、再帰の必要はありません。 「ノード X から深さ 2 のすべてのノード」などの複雑なクエリを適切にサポートします。
短所: ストレージ容量を消費します (最悪の場合 O(n²))。挿入/削除では、クロージャ テーブル内の多くの行を更新する必要があります。
次の場合に適しています。 祖先と子孫の両方を定期的にクエリする必要がありますが、ツリーは大きすぎず、トレードオフのストレージを受け入れることができます。
実体化されたパス: 各ノードは、ルートからそれ自体へのパスを、通常は文字列 (例: "/1/5/12/") または配列 (例: [1, 5, 12]) として保存します。
利点: 子孫を簡単にクエリします (LIKE '/1/5/%' または配列に含まれる)。挿入は簡単です (親のパスを知る必要があるだけです)。効率的にインデックスを作成できます。
短所: サブツリーを移動するには、すべての子孫のパスを更新する必要があります。木々が深く茂り、道が長くなることもあります。
次の場合に適しています。 ツリー構造はめったに変更されず (移動/再親化はまれです)、子孫のクエリは頻繁に行われ、読み取りと書き込みのパフォーマンスのバランスが必要です。
3.2.推奨: 配列を使用した実体化されたパス
管理/組織階層については、 マテリアライズされたパスは配列を使用します 次の理由から、これは最適な選択です。
- 組織構造の変更はまれです (年に数回)
- 「X のすべてのサブユニット」というクエリは非常に一般的です (委任の場合)
- PostgreSQL と最新のデータベースは、効率的な GIN インデックスを備えた配列をサポートしています
- RLS ポリシーと簡単に組み合わせることができます
Organizational_units テーブルを設計します。
| コラム | 種類 | 説明 |
|---|---|---|
| ID | UUID | 主キー |
| コード | VARCHAR | ユニットコード(固有) |
| 名前 | VARCHAR | ユニット名 |
| レベル | ENUM | レベル(本社、地域、支店など) |
| 親ID | UUID | 親への FK (ルートの場合は null 可能) |
| 先祖のパス | UUID[] | ルートから親までの ID の配列 |
| 作成日 | タイムスタンプ | 作成時間 |
| 更新済み | タイムスタンプ | 更新時間 |
データの例:
| ID | 名前 | レベル | 親ID | 先祖のパス |
|---|---|---|---|---|
| uuid-1 | 本社 | 本社 | ヌル | [] |
| uuid-2 | 北地域 | 地域。地域 | uuid-1 | [uuid-1] |
| uuid-3 | 支店A | 枝。支店 | uuid-2 | [uuid-1、uuid-2] |
| uuid-4 | ブランチB | 枝。支店 | uuid-2 | [uuid-1、uuid-2] |
リージョン North (uuid-2) のすべての子孫をクエリします。
SELECT * FROM organizational_units
WHERE uuid-2 = ANY(ancestor_path);
このクエリは、ブランチ A とブランチ B、つまり、ancestor_path に uuid-2 を持つすべてのユニットを返します。
3.3.インデックス戦略
大規模なデータセットでパフォーマンスを確保するには:
ancestor_path の GIN インデックス: クエリ「X = ANY(ancestor_path)」を迅速に実行できるようにします。
parent_id の B ツリー インデックス: 親子を直接クエリしてみましょう。
(レベル、parent_id) の複合インデックス: 「リージョン X に属するすべてのブランチ」というクエリが与えられます。
アクティブなレコードの部分インデックス: 論理的な削除がある場合は、アクティブなレコードのみにインデックスを付けます。
3.4.構造変化への対応
構造が変更される場合 (ユニットをある親から別の親に移動する場合)、そのユニットとすべての子孫の ancestor_path を更新する必要があります。
ステップ 1: 新しい ancestor_path = [new_parent.ancestor_path, new_parent.id] を計算します。
ステップ 2: 子孫ごとに、ancestor_path 内の古いプレフィックスを新しいプレフィックスに置き換えます。
注: サブツリーが大きい場合、これは重い操作になります。オフピーク時間帯に実行する必要があり、バッチ処理と進行状況の追跡が必要になる場合があります。
パート 4: 行レベルのセキュリティ — 保護の最終層
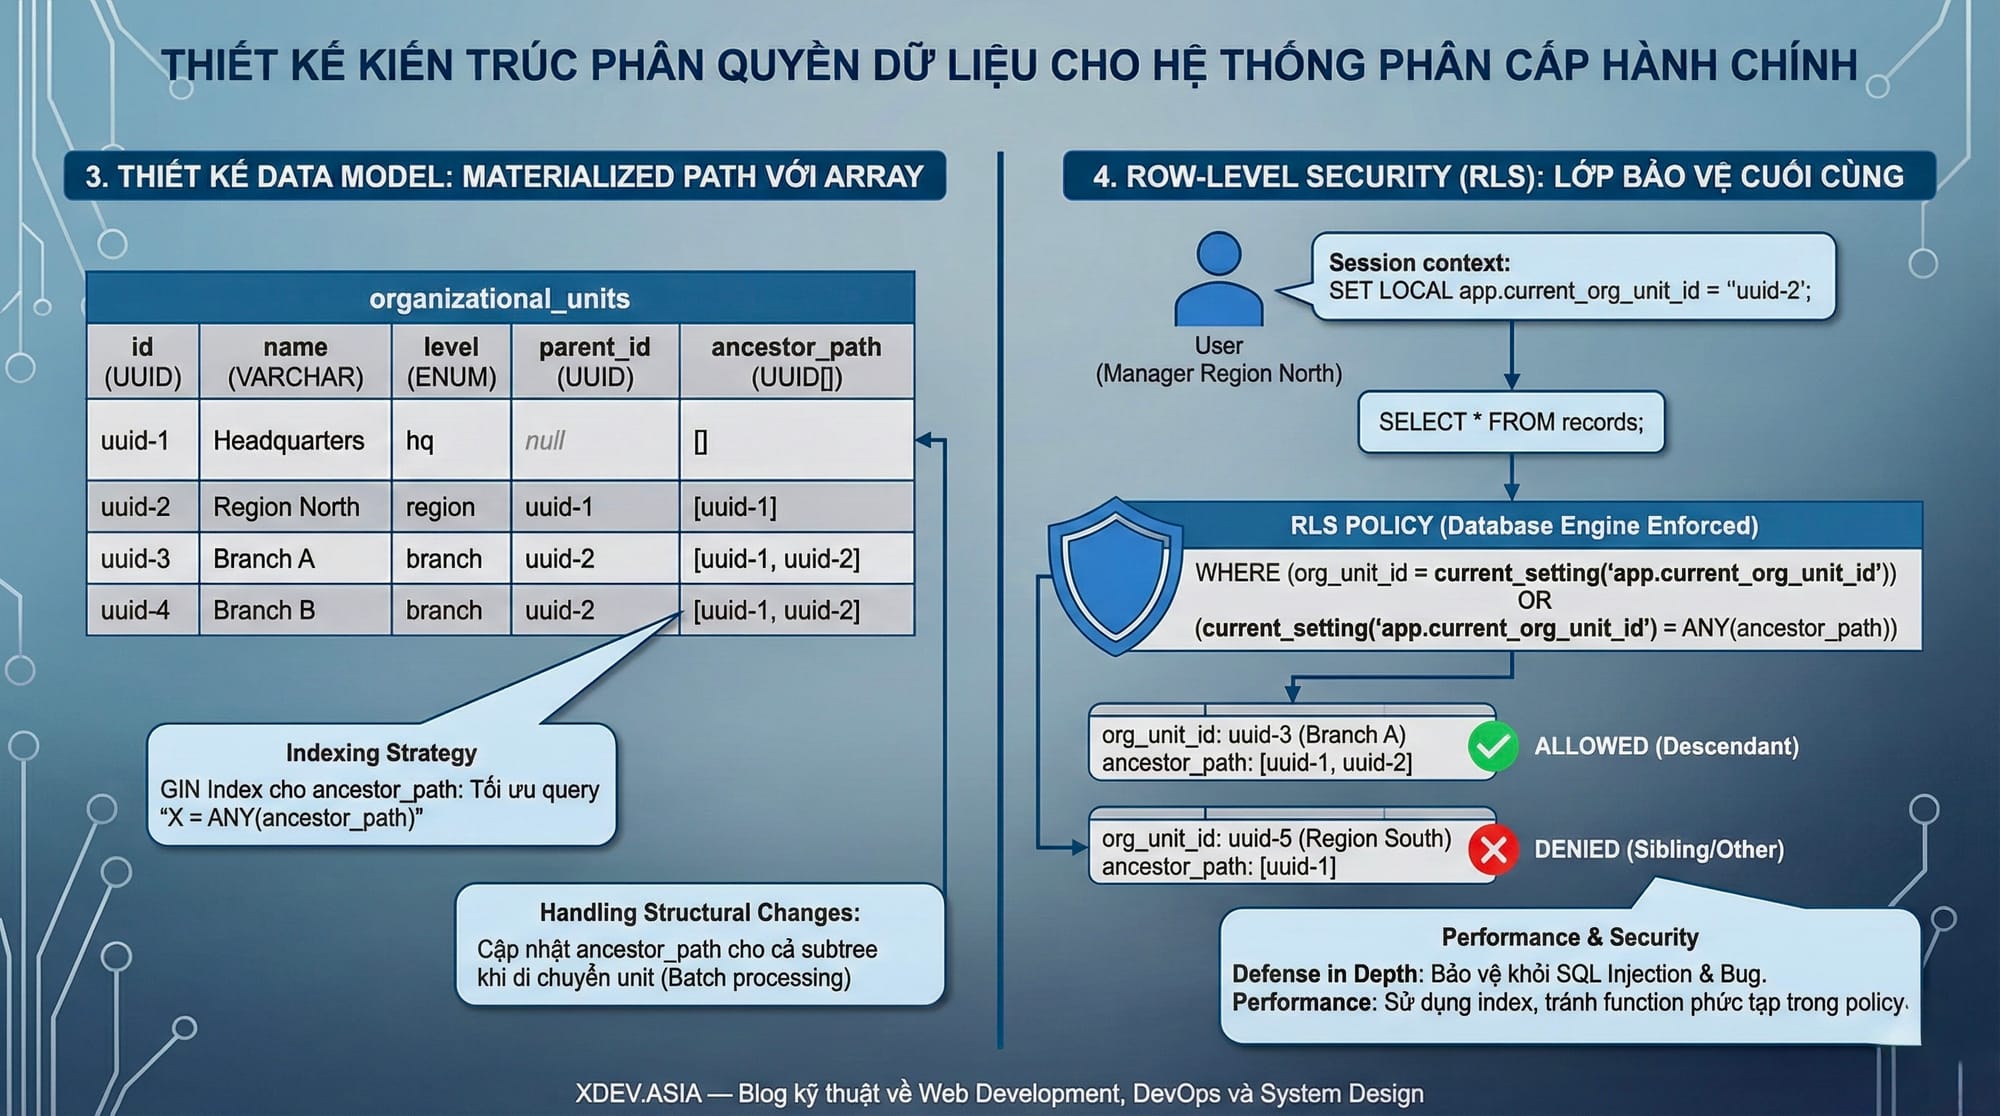
4.1.なぜ RLS が必要なのでしょうか?
アプリケーションレベルの認可では、アプリケーションコード内の権限がチェックされます。これは一般的な方法ですが、次のような弱点があります。
- コードのバグ: 開発者が新しい API に権限チェックを追加するのを忘れました
- SQLインジェクション: 攻撃者はアプリケーション層をバイパスし、データベースに直接アクセス
- データベースへの直接アクセス: DBA、BI ツール、またはハッカーはデータベース アクセス資格情報を持っています
- マイクロサービスの複雑さ: 多くのサービスが同じデータベースにアクセスするため、すべてのサービスが正しいアクセス許可を確実にチェックすることが困難になります
行レベル セキュリティ (RLS) は、行レベルでアクセス制御ポリシーを定義できるようにするデータベース (PostgreSQL、SQL Server、Oracle) の機能です。ポリシーはデータベース エンジンによって適用され、アプリケーションからバイパスすることはできません。
多層防御: アプリケーションにバグがある場合でも、攻撃者が SQL インジェクションを行った場合でも、データベースは現在のユーザーが表示を許可されている行のみを返します。 RLS は保護の最後の層であり、アプリケーション レベルのチェックに代わるものではなく、追加のセキュリティ層を追加します。
4.2. RLS の仕組み
ステップ 1 — ボード上で RLS を有効にします。 デフォルトでは、RLS はオフになっています。有効にすると、そのテーブル上のすべてのクエリがポリシーによってフィルタリングされます。
ステップ 2 — ポリシーの定義: ポリシーは、どの行にアクセスを許可するかを決定するブール式です。ポリシーは、SELECT、INSERT、UPDATE、DELETE に個別に、またはすべてに適用できます。
ステップ 3 — セッションコンテキストを設定します。 アプリケーションはクエリを実行する前にセッション変数 (current_user_id、current_org_unit_id など) を設定します。ポリシーはこれらの変数を使用してフィルタリングします。
ステップ 4 — クエリの実行: データベースは、ポリシーの条件をすべてのクエリの WHERE 句に自動的に追加します。ユーザーはこれを変更する必要はありません (変更できません)。
4.3.階層型アクセスのポリシー設計
設計された ancestor_path モデルを使用すると、ポリシーにより階層アクセスが許可されます。
ロジック: ユニット X に属するユーザーは、次の場合にレコードへのアクセスを許可されます。
- レコードはユニット X、またはに属します
- ユニット X は、レコードを所有するユニットの ancestor_path にあります (つまり、X はそのユニットの祖先です)。
解釈:
- ブランチ A のスタッフ (uuid-3) は、org_unit_id = uuid-3 のレコードのみを表示できます。
- Manager リージョン北 (uuid-2) は、org_unit_id = uuid-2、uuid-3、uuid-4 (リージョンおよびリージョンに属するすべてのブランチ) のレコードを表示できます。
- 執行本部 (uuid-1) はすべての記録を表示できます
4.4.セッションコンテキスト管理
RLS ポリシーは、「現在のユーザーがどのユニットに属しているか」を知る必要があります。この情報はセッション変数を通じて渡されます。
PostgreSQL の場合: 使用する セット そして 現在の設定():
-- Application set context sau khi xác thực user
SET LOCAL app.current_user_id = 'user-uuid';
SET LOCAL app.current_org_unit_id = 'uuid-3';
-- Policy đọc context
current_setting('app.current_org_unit_id', true)
重要な注意事項:
- 使用する
ローカルに設定(トランザクション内でのみ有効) 代わりにセット(セッション中に有効) リクエスト間のコンテキスト リークを避けるため - 各トランザクションの開始時に常にコンテキストを設定する
- コンテキストが設定されていない場合の処理 (デフォルトは拒否)
4.5.パフォーマンスに関する考慮事項
RLS ポリシーは行ごとに評価され、パフォーマンスに影響を与える可能性があります。
ポリシーでインデックス付き列が使用されていることを確認してください。 ポリシーチェックの場合 org_unit_id = 任意(...)、org_unit_id のインデックスが必要です。
ポリシーでの複雑な関数呼び出しを回避します。 各行がその関数を呼び出します。関数がデータベースにクエリを実行すると、N+1 個の問題が発生します。
STABLE/IMMUTABLE 関数を使用します。 PostgreSQL がクエリ内の結果をキャッシュできるようにします。
具体化されたアクセス許可を考慮してください。 リアルタイムのアクセス許可を計算する代わりに、事前に計算して別のテーブルに保存することができ、ポリシーを検索するだけで済みます。
4.6.管理操作の RLS をバイパスする
場合によっては、RLS をバイパスする必要があります。
- システム移行
- バッチ処理ジョブ
- すべてのテナントにわたるレポート
- 緊急アクセス
安全な方法:
- BYPASSRLS 権限を持つ別のデータベース ロールを作成する
- このロールは特定のサービス アカウントによってのみ使用されます
- このロールを使用するすべてのアクセスは詳細に記録されます
- 役割が乱用されていないことを確認するための定期的な監査
パート 5: ロール階層と権限の設計
5.1.役割と範囲を分ける
よくある間違いは、ロールとスコープを同じエンティティに結合することです。たとえば、ロール「Branch_A_Manager」、「Branch_B_Manager」、「Region_North_Manager」を作成します。これにより、役割の数が爆発的に増加します。
より良いデザイン: 役割 (機能) とスコープ (スコープ) の分離:
| ユーザー | 役割 | スコープ (組織単位) |
|---|---|---|
| アリス | マネージャー | 支店A |
| ボブ | マネージャー | ブランチB |
| キャロル | マネージャー | 北地域 |
| デイブ | アナリスト | 本社 |
同じ役割「マネージャー」ですが、範囲が異なります。マネージャーの権限は一度定義され、スコープによってどのデータへのアクセスが許可されるかが決まります。
5.2.役割階層の設計
機能上の役割 (機能別):
| 役割 | 説明 | 一般的な権限 |
|---|---|---|
| ビューア | データとレポートを表示する | 読む |
| オペレーター | 日常業務の処理 | 読み取り、作成、更新 |
| マネージャー | チーム管理、承認 | 読み取り、作成、更新、承認 |
| 管理者 | 構成管理 | 読み取り、作成、更新、削除、構成 |
| 監査役 | 監査 | 読み取り (監査ログを含む) |
役割の継承:
Administrator
    ↓ inherits
Manager
    ↓ inherits
Operator
    ↓ inherits
Viewer
管理者には、マネージャー、オペレーター、閲覧者のすべての権限が自動的に付与されます。
監査役 通常、この階層には特別な権限 (監査ログを参照) はありますが、変更権限がないため、この階層には含まれません。
5.3.許可の粒度
権限はさまざまな詳細レベルで定義できます。
粗粒度 (粗い):
レコード:読み取り— あらゆる種類のレコードを読み取るレコード:書き込み— あらゆる種類のレコードを作成/編集します
きめ細かい (詳細):
customer_records:読み取りcustomer_records:作成customer_records:更新customer_records:削除財務記録:読み取り財務記録:承認
推奨事項: 粗いものから始めて、実際に必要になったときに改良してください。最初から権限を過剰に設計すると、システムが複雑で管理が困難になります。
5.4.職務分離の実施
SoD は、複数の人がプロセスに参加することを要求することで、不正行為やエラーを防ぎます。
静的 SoD — 競合する役割:
| 役割A | 役割B | 理由 |
|---|---|---|
| 依頼者 | 承認者 | リクエストを自己承認しないでください |
| データ入力 | 監査役 | 監査人は独立していなければならない |
| 開発者 | デプロイヤー | 開発と運用を分離する |
ユーザーにロールを割り当てるときは、そのユーザーが競合するロールをすでに持っているかどうかを確認してください。 「はい」の場合は、割り当てを拒否します。
動的 SoD — 競合するアクティベーション:
ユーザーが複数のロールを保持できるようにしますが、一度にアクティブになるのは 1 つのロールのみです。たとえば、ユーザーは「データ入力」と「レビュー担当者」の役割を持つことができますが、ログイン時にどちらかを選択する必要があります。これにより、特定のトランザクションが 1 人によって完全に制御されることがなくなりながら、柔軟性 (同じ人が複数のことを実行できる) が可能になります。
トランザクションベースの SoD:
各取引を確認してください。例: 注文にはフィールドがあります 作成者 そして 承認済み。システムの施行 承認済み != 作成済み。アプリケーションの作成者がアプリケーション自体を承認した者になることはできません。
パート 6: 機密データの処理
6.1.データの分類
すべてのデータに同じレベルの保護が必要なわけではありません。データの分類は最初のステップです。
| 分類 | 例 | 保護レベル |
|---|---|---|
| 公共 | 会社名、公告等 | 最小限 |
| 内部 | 社内メモ、組織図 | 標準のアクセス制御 |
| 機密 | 財務報告書、顧客リスト | アクセス制限、監査ログ |
| 敏感 | PII、健康記録、給与情報 | 暗号化、厳格なアクセス、詳細な監査 |
| 制限付き | 営業秘密、M&A計画 | 必知事項、特別承認 |
6.2.フィールドレベルのアクセス制御
RLS は行レベルで制御します。ただし、場合によってはフィールド (列) レベルでの制御が必要になることがあります。
たとえば: テーブル 従業員。従業員 ID、名前、電子メール、部門、給与、SSN の列があります。人事部はすべてを見ることができます。マネージャーはチームの ID、名前、電子メール、部門を確認できますが、給与と SSN は確認できません。
実装アプローチ:
ビューベース: 各ロールの列のサブセットを含むビューを作成します。マネージャーのクエリ ビューには給与/SSN がありません。
アプリケーションレベルの予測: ロールが表示を許可されているアプリケーションのみの SELECT 列。
列レベルの暗号化: 機密列を暗号化し、キーを持つロールのみを復号化します。
動的データマスキング: データベースは、完全なアクセス権を持たないロールに対してマスクされた値 (SSN の場合は xxx-xx-1234 など) を返します。
6.3.暗号化戦略
保存時の暗号化: ディスク上のすべてのデータベース ファイルを暗号化します。物理的アクセス (盗難、不適切な廃棄) からの保護。アプリケーションに対して透過的 - コードを変更する必要はありません。
透過的データ暗号化 (TDE): データベースは書き込み時に自動的に暗号化され、読み取り時に復号化されます。データ ファイルとバックアップを保護します。許可されたデータベース ユーザーからは保護されません。
アプリケーションレベルの暗号化: アプリケーションはデータベースに送信する前に暗号化し、受信後に復号化します。データベース管理者およびデータベースにアクセスできるすべてのユーザーからの保護。欠点: 暗号化されたデータに対してクエリを実行することはできません (検索可能な暗号化を使用しない限り)。
列レベルの暗号化: 特定の列のみを暗号化します。セキュリティと使いやすさのバランス。暗号化されていない列に対してクエリを実行できます。
機密データに関する推奨事項:
- 保存時の暗号化: 常にオン (ベースライン保護)
- アプリケーションレベルの暗号化: 機密性の高い分野 (SSN、健康データ)
- 列レベルの暗号化: 時折検索が必要な中程度の機密性のフィールド用
6.4.鍵の管理
暗号化の強度はキー管理と同じくらいです。
キーストレージ: キーをコード、構成ファイル、または暗号化されたデータと同じデータベースに保存しないでください。 AWS KMS、HashiCorp Vault、Azure Key Vault などの専用のキー管理システム (KMS) を使用します。
キーのローテーション: 定期的 (たとえば、毎年) および問題が発生した場合 (キーが公開される可能性がある) にキーを変更します。新しいキーでデータを再暗号化します。
主要な階層: マスターキーはデータキーを暗号化します。データキーは実際のデータを暗号化します。ローテーションが必要な場合は、新しいマスター キーを使用してデータ キーを再暗号化するだけでよく、すべてのデータを再暗号化する必要はありません。
キーへのアクセス: 最小特権の原則。復号化する必要があるサービスのみがキーにアクセスできます。すべてのアクセスキーを監査します。
パート 7: 監査証跡とコンプライアンス
7.1.ログに記録する内容
監査ログでは、誰がどのリソースに何をしたか、いつ、どこから、そしてなぜ (可能な場合) に答えるのに十分な情報を収集する必要があります。
認証イベント:
- ログイン成功/失敗
- ログアウト
- パスワードの変更/リセット
- MFA イベント
- セッションタイムアウト
認可イベント:
- アクセスが許可されました
- アクセスが拒否されました
- 権限昇格の試行
- 役割/権限の変更
データアクセスイベント:
- 機密データの読み取り (必須)
- 通常データの読み取り (オプション、要件に基づく)
- レコードの作成
- レコードを更新します (前後の値を含む)
- レコードの削除
構成の変更:
- システム設定が変更されました
- ユーザー/ロールの管理
- ポリシーの変更
- 統合構成
異常:
- 異常なアクセスパターン
- 複数回失敗した試行
- 新しい場所/デバイスからのアクセス
- 一括データアクセス
7.2.ログエントリの構造
各ログ エントリには次のものが含まれている必要があります。
| フィールド | 説明 | 例 |
|---|---|---|
| タイムスタンプ | 時間 (タイムゾーンあり) | 2025-01-15T14:30:00Z |
| イベントID | 一意の識別子 | uuid |
| イベントの種類 | イベントの種類 | データアクセス |
| アクション。アクション | 具体的な行動 | 読む |
| 俳優ID | ユーザーがやります | ユーザーUID |
| 俳優の役割 | 現在の役割 | マネージャー |
| アクター組織ユニット | ユーザー単位 | ブランチ UUID |
| リソースタイプ | リソースの種類 | 顧客レコード |
| リソースID | リソースID | レコード-uuid |
| resource_org_unit | 所有ユニット | ブランチ UUID |
| 結果。結果 | 結果 | 成功/拒否 |
| ip_アドレス | 送信元IP | 192.168.1.100 |
| ユーザーエージェント | 顧客情報 | モジラ/5.0... |
| セッションID | セッション識別子 | セッション-uuid |
| 詳細。詳細 | 追加情報 | JSONオブジェクト |
7.3.ログの整合性と保持
不変性: 監査ログは不変でなければなりません。監査ログを変更または削除することはできません。使用:
- ライトワンスストレージ (WORM)
- トリガーを備えた追加専用テーブルにより更新/削除が防止される
- ブロックチェーンベースの検証
- 改ざんを検出するための通常のハッシュ チェーン
保持ポリシー:
- アクティブ ストレージ: 90 日 (調査のための迅速なアクセス)
- アーカイブ保管期間: 1 ~ 7 年 (コンプライアンス要件に応じて)
- 明確なポリシーを定義し、アーカイブ/パージを自動化する
ログのアクセス制御:
- 監査ログへのアクセスに対する個別の権限
- セキュリティ/コンプライアンス チームのみがアクセスできる
- 監査ログへのログアクセス (メタ監査)
7.4.監視と警告
ログは誰も見なければ価値がありません。実装:
リアルタイムアラート:
- 複数回のログイン試行失敗 → ブルートフォースの可能性
- アクセス拒否の急増 → 不正アクセス試行の可能性
- 大量のデータアクセス → データ漏洩の可能性
- 通常とは異なる場所からのアクセス → アカウントが侵害された可能性
- 機密データへの時間外アクセス → 調査が必要
定期的なレビュー:
- 毎週: アクセス拒否パターンを確認する
- 毎月: 役割の割り当てを確認し、過剰な権限を持つアカウントを探します。
- 四半期ごと: フルアクセスのレビュー、未使用の権限の削除
- 毎年: ポリシーのレビュー、組織変更に基づいて更新
パート 8: 統合パターン
8.1.アイデンティティプロバイダーの統合
ほとんどの組織は、Active Directory、Okta、Auth0、Keycloak などのアイデンティティ プロバイダー (IdP) をすでに持っています。分散型システムは以下を統合する必要があります。
SAML 2.0: エンタープライズ SSO の標準。 IdP はユーザーを認証し、ユーザー ID と属性を含む SAML アサーションを送信します。サービス プロバイダー (アプリケーション) はアサーションを信頼し、セッションを作成します。
OAuth 2.0 / OpenID Connect: Web やモバイルで人気の現代の標準。 IdP 発行の JWT トークンには、ユーザーに関するクレームが含まれています。アプリケーションはトークンを検証し、クレームを抽出します。
トークンに含めるクレーム:
- sub: ユーザー識別子
- ロール: ロール名の配列
- org_unit_id: プライマリ組織単位
- org_unit_path: ルートから組織ユニットまでのフルパス
- 権限: (オプション) ロールから派生していない場合の明示的な権限
8.2. APIゲートウェイと認可
API ゲートウェイは、すべての API リクエストのエントリ ポイントです。これは、最初の認可レイヤーを実装するのに理想的な場所です。
トークンの検証: JWT 署名を検証し、有効期限を確認し、発行者を検証します。
大まかな認可: ユーザーがこの API を呼び出す権限を持っているかどうかを確認します (トークン内のロールに基づいて)。
レート制限: 悪用を防止し、役割ごとに制限を区別できます。
コンテキストインジェクション: トークンからクレームを抽出し、ダウンストリーム サービスが使用するリクエスト ヘッダーに挿入します。
注: API Gateway は大まかなチェックのみを実行する必要があります。きめ細かい承認 (たとえば、ユーザーがこの特定のレコードにアクセスする権限を持っているかどうか) は、アプリケーションとデータベース (RLS) によって処理される必要があります。
8.3.サービス間の認可
マイクロサービス アーキテクチャでは、サービスが相互に呼び出します。これらの呼び出しを承認する必要があります。
サービスアカウント: 各サービスには独自の ID (サービス アカウント) があります。サービス A がサービス B を呼び出すと、サービス B は A の ID を検証し、A に権限があるかどうかを確認します。
トークンの伝播: ユーザーのトークンは、あるサービスから別のサービスに転送されます。元のユーザーの権限に基づくダウンストリーム サービスの承認。
ハイブリッドアプローチ: 両方を組み合わせます。サービス A は、サービス A の ID (サービス レベルの認証用) とユーザーのトークン (ユーザー レベルの認証用) の両方を使用してサービス B を呼び出します。サービス B は両方をチェックします。
8.4.認可決定のキャッシング
承認チェックは、特に複雑な ABAC の場合、コストがかかる場合があります。キャッシュはパフォーマンスの向上に役立ちます。
権限キャッシュ: 「ユーザー X に権限 Y があるか」という結果を短い TTL (数分) でキャッシュします。ロール/権限が変更された場合は無効になります。
ポリシー決定キャッシュ: 複雑なABACポリシーの結果をキャッシュします。キー = 関係するすべての属性のハッシュ。
ネガティブ キャッシュ: すべての「拒否」結果をキャッシュします。ただし、許可が与えられたばかりの場合は、偽陰性に注意してください。
キャッシュ無効化戦略:
- 時間ベース: 短い TTL (1 ~ 5 分)
- イベントベース: 役割の割り当てが変更されたときに無効化
- ハイブリッド: TTL + イベントベースの無効化
パート 9: テストと検証
9.1.認可テストのピラミッド
単体テスト: 個々の権限チェック機能をテストします。ロール X を持つユーザーは、アクション Y を実行できますか?エッジケースをテストします: null 入力、無効なロール、期限切れのセッション。
統合テスト: API からデータベースまでエンドツーエンドでテストします。 RLS ポリシーが正しく機能することを確認します。モックではなく実際のデータベースを使用してテストします。
陰性検査: 陽性反応と同様に重要です。ユーザーがアクセスすべきではないものにアクセスできないことを確認します。見落とされがちですが、セキュリティにとって重要です。
テナント間テスト: データの分離を確認します。テナント A のクエリのユーザーは、テナント B のデータを決して返してはなりません。
権限昇格テスト: 認証をバイパスしようとします。データベースへの直接アクセス、トークンの操作、セッション コンテキストの構築を試してください。
9.2.階層アクセスのテスト シナリオ
シナリオ 1: 垂直アクセス
- リージョンレベルのクエリのユーザー → リージョンデータとそのリージョン下のすべてのブランチデータを返す必要があります
- ブランチレベルのクエリのユーザー → そのブランチのデータのみを返す必要があります
シナリオ 2: 水平方向の分離
- ブランチ A クエリのユーザー → ブランチ B データを返すべきではありません
- リージョン北クエリのユーザー → リージョン南データを返すべきではありません
シナリオ 3: 移動操作
- ブランチをリージョン北からリージョン南に移転しました
- リージョン北のユーザーのクエリ → 移動されたブランチ データを返さないようにする必要があります
- リージョン南のユーザーのクエリ → 移動されたブランチ データを返す必要があります
シナリオ 4: 複数組織のユーザー
- ユーザーが複数の組織単位に属している (まれですが、可能性があります)
- クエリは、割り当てられたすべてのユニットからのデータの和集合を返す必要があります
9.3.セキュリティテスト
侵入テスト:
- 外部チームを雇うか、OWASP ZAP、Burp Suite などのツールを使用する
- 認可バイパスの脆弱性に焦点を当てる
- テストトークンの操作、パラメータの改ざん、オブジェクトの直接参照
コードレビュー:
- 認可関連のコードをすべて確認します。
- 新しいエンドポイントで認証チェックが欠落していないか確認する
- RLS ポリシーが機密データを含むすべてのテーブルをカバーしていることを確認します
構成監査:
- 役割の定義と割り当てを確認する
- 過剰な権限を持つアカウントを探す
- 孤立したアクセス許可 (割り当てられているが使用されていない) を確認します。
パート 10: 運用上の考慮事項
10.1.導入戦略
段階的ロールアウト:
フェーズ 1 — 基礎 (1 ~ 2 か月目):
- 組織単位階層モデルのデプロイ
- ロール継承を使用した基本的な RBAC の実装
- 重要なテーブルで RLS を有効にする
フェーズ 2 — 硬化 (3 ~ 4 か月目):
- 包括的な監査ログ
- SoD制約
- 機密データの暗号化
- セキュリティテスト
フェーズ 3 — アドバンスト (月 5 ~ 6):
- 複雑なシナリオのためのABAC
- フィールドレベルのアクセス制御
- セルフサービスの許可リクエスト
- 分析と異常検出
10.2.エッジケースの処理
組織単位を持たないユーザー: デフォルトの拒否。データにアクセスする前に、ユーザーには組織単位が割り当てられている必要があります。
複数の組織単位を持つユーザー: アクセス可能なデータの結合。混乱を避けるために慎重な設計が必要です。
組織単位の再構築: ダウンタイムを計画するか、段階的な移行を実施します。変更を伝えます。
緊急アクセス: 緊急時の「ガラス割り」手順。大量にログが記録され、正当な理由が必要で、自動期限切れになります。
孤立したデータ: 組織単位に属するデータが削除されました。ポリシーを定義します: アーカイブ、移行、または削除。
10.3.モニタリングとヘルスチェック
追跡する指標:
- 認可決定のレイテンシ (P50、P95、P99)
- キャッシュヒット率
- アクセス拒否イベントの数
- RLS ポリシーの実行時間
- セッションコンテキストセットが失敗する
ヘルスチェック:
- 必要なすべてのテーブルで RLS ポリシーが有効になっている
- すべてのリクエストに対してセッション コンテキストが適切に設定される
- IdP接続
- 監査ログの取り込み率
アラートしきい値:
- 認証遅延 > 100ms (P95)
- アクセス拒否率のスパイク > 200% ベースライン
- RLS ポリシー評価エラー
- 監査ログのギャップ
10.4.災害復旧
バックアップ要件:
- RLS ポリシーを備えたデータベース
- IdP 構成 (ロール、グループ、マッピング)
- アプリケーション認可の構成
- 監査ログ (コンプライアンスにとって重要)
回復手順:
- データベースを復元し、RLS ポリシーが損なわれていないことを確認します
- IdP同期を確認する
- 既知のシナリオで認可をテストする
- 監査ログを確認してギャップがないか確認する
緊急時の手順:
- すべてのアクセスを迅速に取り消す手順 (侵害の場合)
- 特定のユーザーのアクセスを復元する手順
- エスカレーション連絡先
結論: 覚えておくべき原則
階層構造の分散システムの構築は複雑な問題ですが、適切な原則を使用すれば解決できます。
多層防御: どのレイヤーも完全に信頼しないでください。 API ゲートウェイ + アプリケーション + データベース RLS は複数の保護層を作成します。
最低特権: 必要最小限の権限を付与します。付与されたアクセス許可を取り消すよりも、アクセス許可を追加する方が簡単です。
懸念事項の分離: ロール(機能)とスコープ(スコープ)を分ける。ロールは「何ができるか」を定義し、スコープは「どこで行うか」を定義します。
階層的な継承: ツリー構造を利用して権限を自動的に取得します。上司は部下の閲覧権限を継承します。
水平方向の分離: ピアユニットは完全に分離する必要があります。兄弟へのアクセス パスはありません。
すべてを監査する: ログは「誰が、いつ、どこで何をしたか」を再現できるほど詳細に記録されます。これはコンプライアンスと調査の要件です。
陰性の場合をテストする: 「アクセス可能」だけでなく「アクセス不能」も確認します。陰性検査は見逃されがちですが、重要です。
変化の計画: 組織構造も変わります。柔軟性を考慮した設計: ユニットの追加、移動、階層の再構築が簡単です。
これらの原則と提案されたアーキテクチャ (階層型 RBAC + サブテナント + RLS + 包括的監査) を使用すると、あらゆる分散型組織向けに堅牢でスケーラブルで安全な分散型システムを構築できます。
コードデモはこちら https://github.com/xdev-asia-labs/spring-multitenant-rbac