如何建構一個上級可以監控所有下級數據,而同級單位之間完全隔離的系統?本文詳細分析了分層結構系統的資料去中心化架構—從政府到跨國公司,再到擁有數千個分店的零售連鎖店。
第 1 部分:去中心化問題
1.1.層次結構的特徵
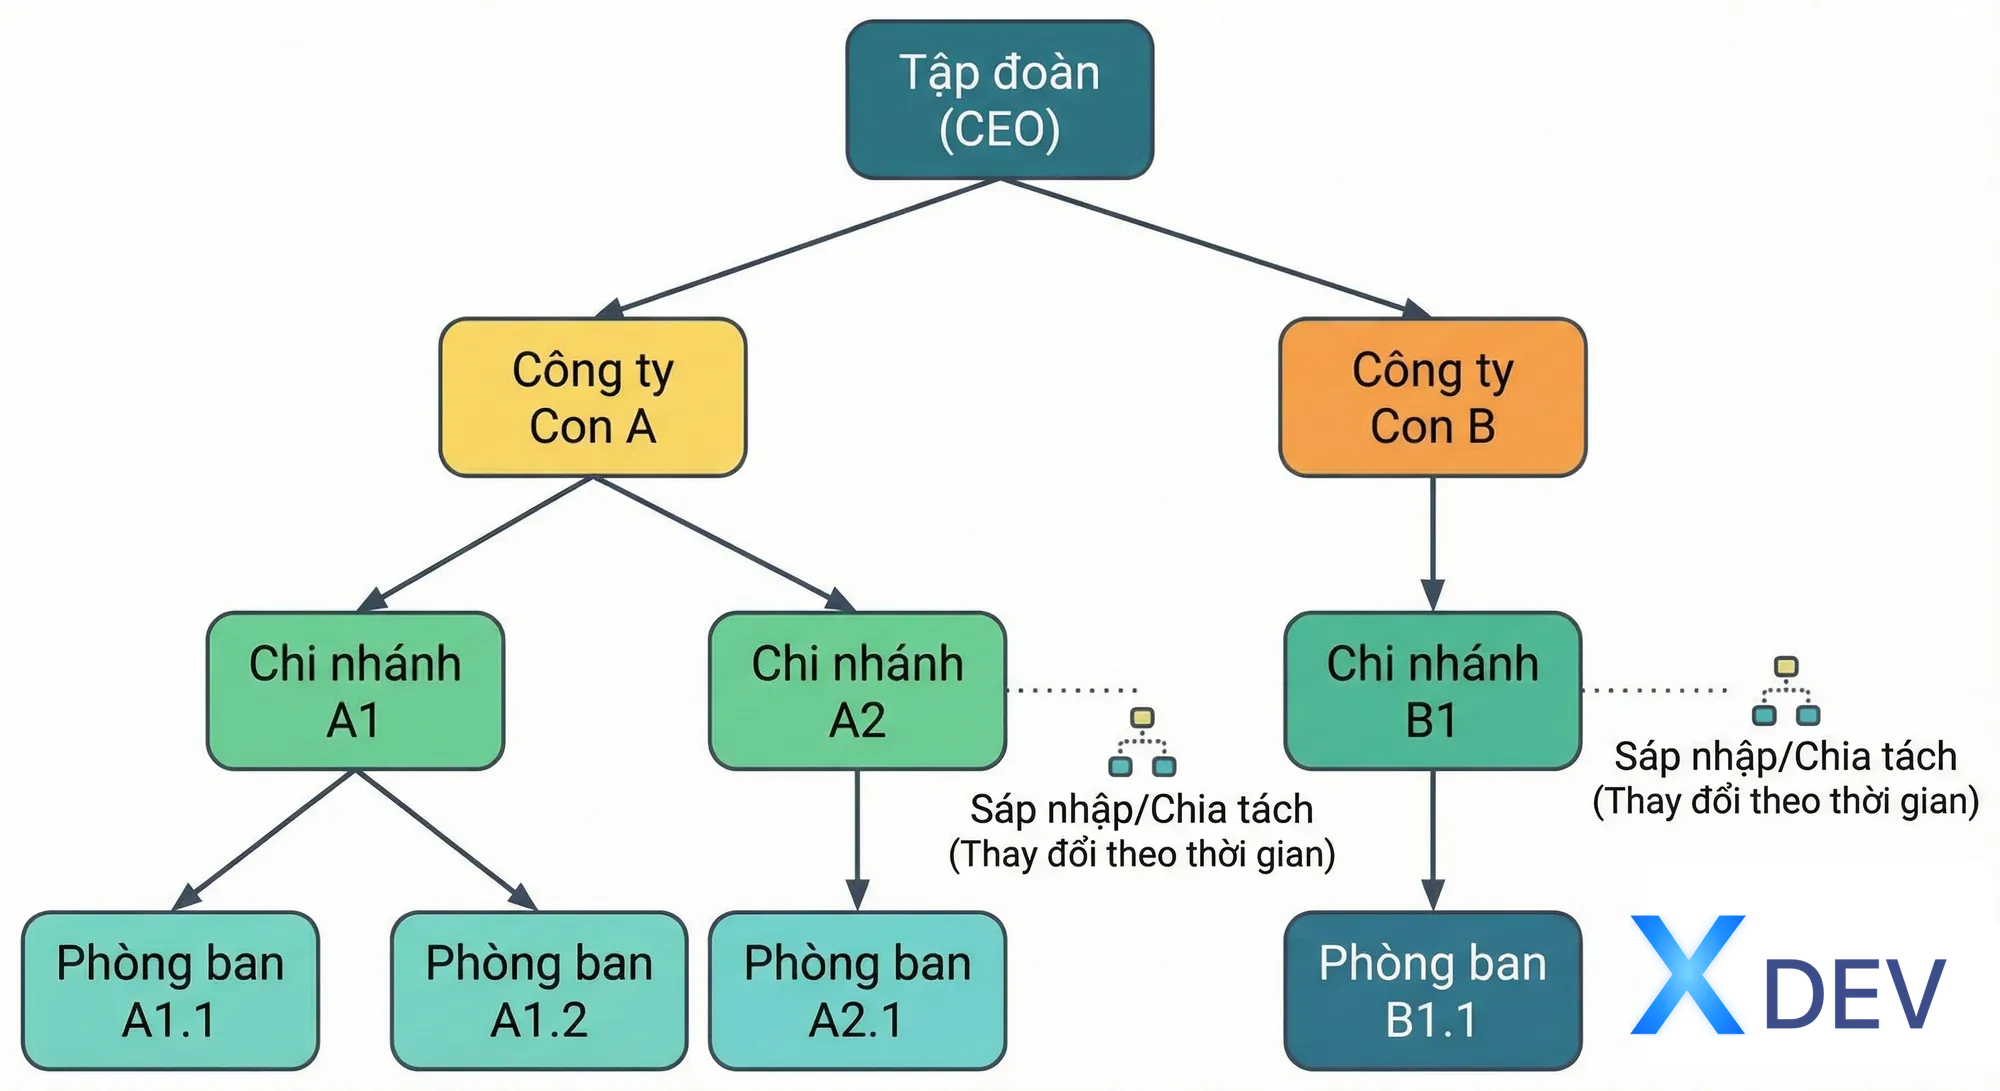
許多組織依照層級結構運作:公司有子公司,子公司有分支機構,分支機構有部門。政府設有部會、省、區、區和公社。零售連鎖店有區域、區域和商店。
這些結構的共同點是關係 親子 單元之間形成一棵具有以下特徵的樹:
- 每個單元(根除外)只有一個父單元
- 每個單元可以有多個子單元
- 樹的深度可能因分支而異
- 結構會隨著時間的推移而改變(合併、分立、重組)
1.2.需要特定授權
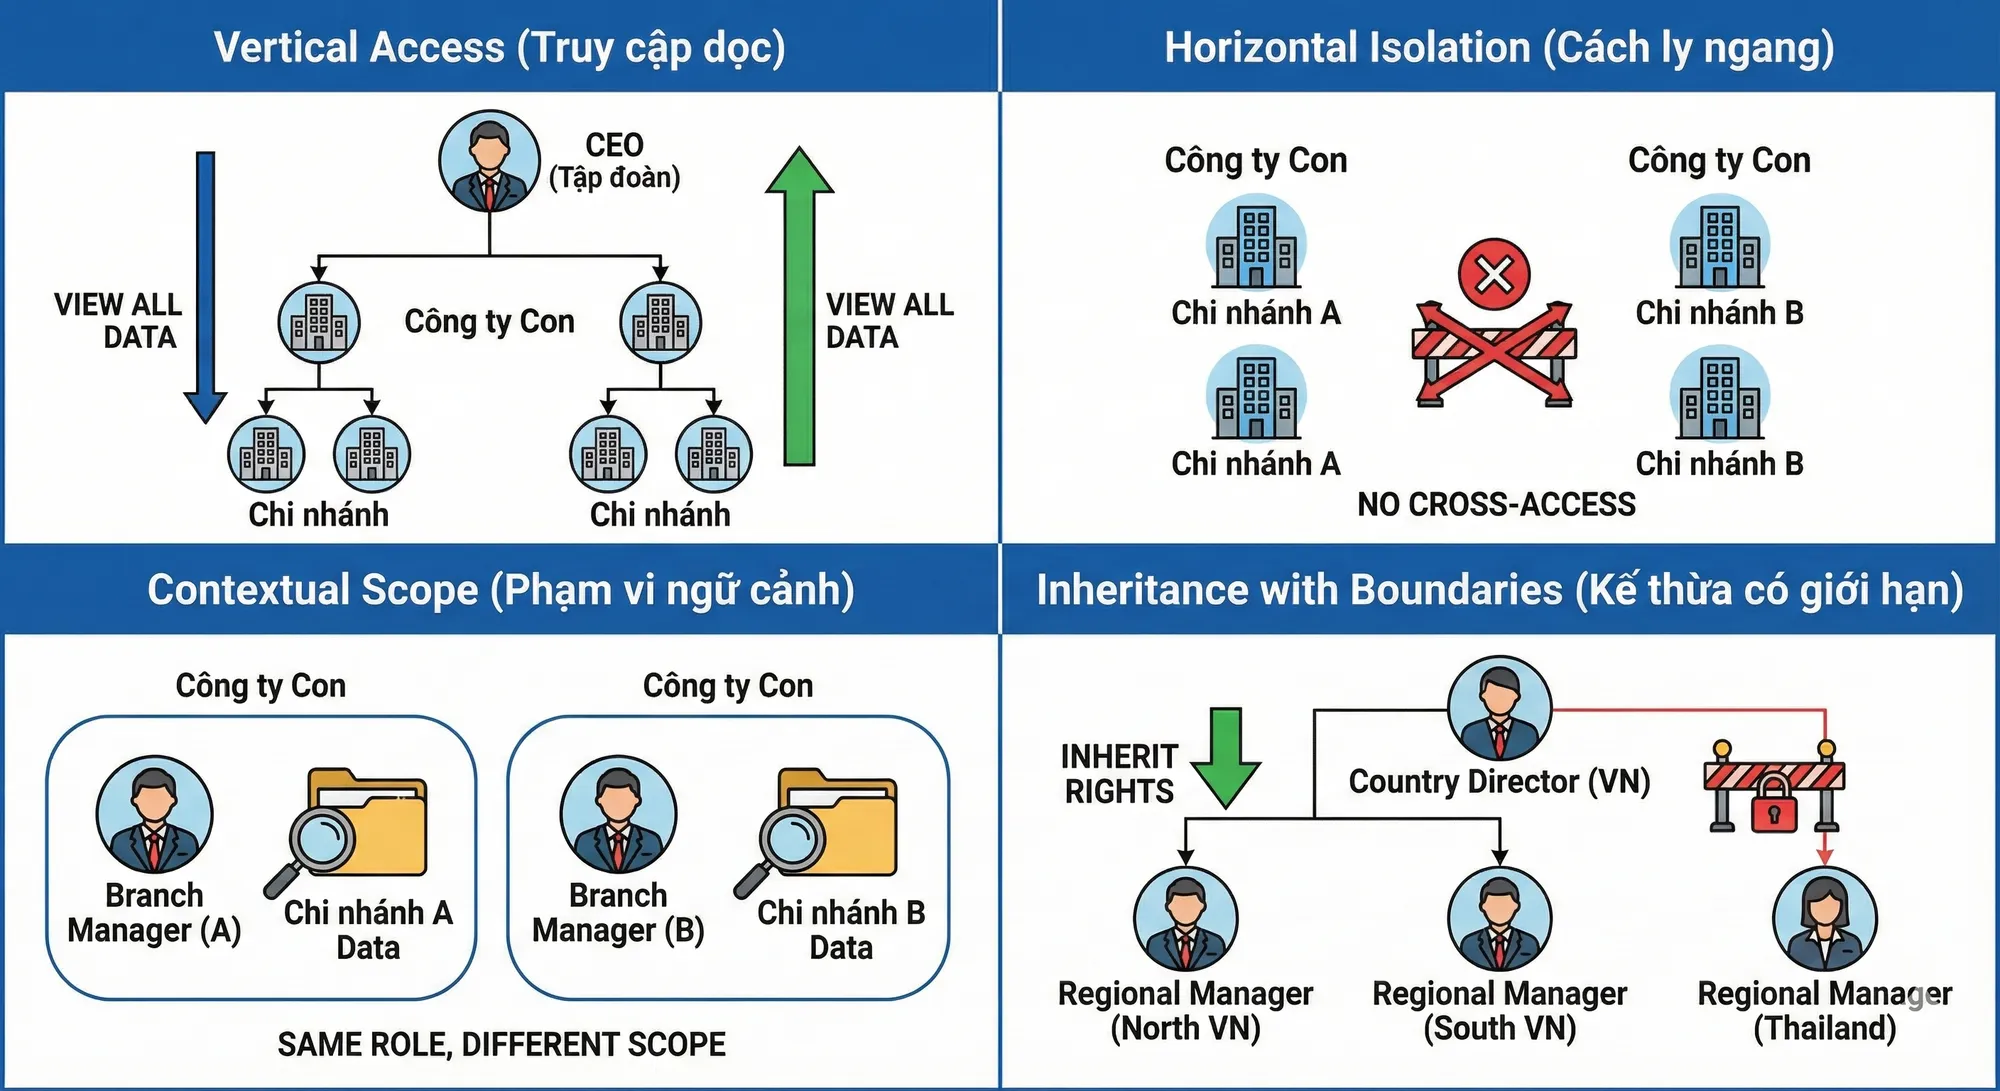
去中心化系統提出了扁平權限模型無法滿足的特殊權限要求:
垂直訪問: 上級需要能夠看到所有下級的資料。執行長需要查看整個公司的報告,包括所有子公司和附屬公司。區域經理需要查看該區域所有商店的數據。
水平隔離: 同一等級的單位之間不能互相查看對方的資料。分公司 A 無法看到分公司 B 的收入,即使兩者屬於同一子公司。這保證了公平競爭和商業資訊安全。
上下文範圍: 角色相同但範圍不同。 A分行的「分行經理」僅管理A分行; B分公司的「分公司經理」只管理B分公司,角色相同,權限相同,但允許存取的資料完全不同。
有邊界的繼承: 權限是垂直繼承的,而不是水平繼承的。國家總監繼承區域經理在該國家/地區的所有權利,但在其他國家/地區則沒有權利。
1.3.為什麼扁平化去中心化會失敗
扁平化的去中心化模型直接將權限分配給使用者或角色,沒有層級的概念。當應用於層次結構時,它面臨許多問題:
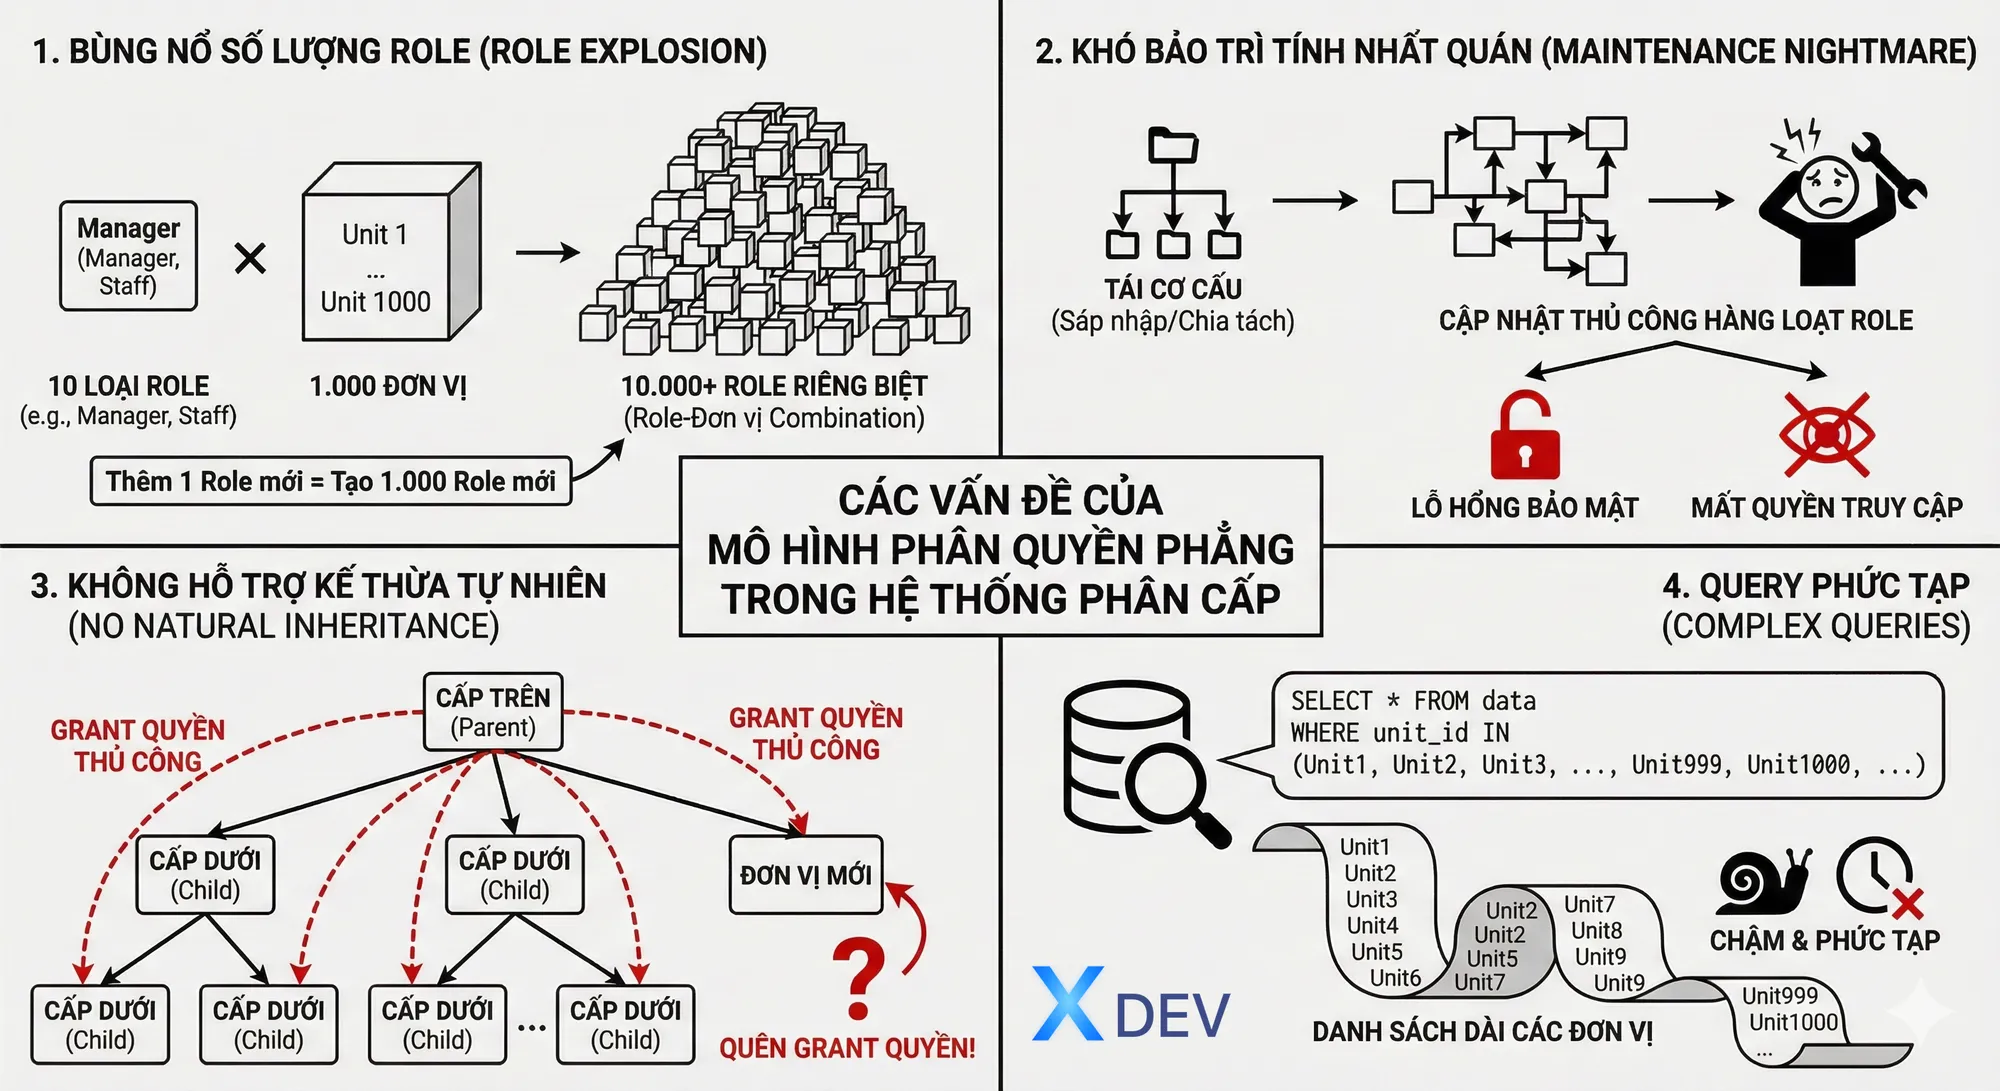
角色數量爆炸性成長: 如果有10種角色和1000個單元,理論上需要10000個單獨的角色(每個角色單元是一個組合)。新增角色類型意味著創建 1,000 個新角色。
難以保持一致性: 當一個單位重組(合併、分立)時,所有相關角色都需要手動更新。錯誤會導致安全漏洞或有效存取權限的遺失。
不支援自然繼承: 為了讓上級能夠查看下級數據,需要手動授予各個下級單位的權限。新增單位時,很容易忘記向上級授予權限。
複雜查詢: 每次資料查詢都需要包含一長串允許的單位,使得查詢複雜且緩慢。
1.4.規模和複雜性
問題的複雜度隨著以下因素的增加而增加:
- 單位數量: 從幾十到數萬
- 樹深度: 從2-3級到5-6級或更多
- 結構動力學: 固定結構與頻繁變化
- 用戶數: 從幾百到數百萬
- 延遲要求: 即時應用程式的毫秒級
- 合規要求: 審計追蹤、資料駐留、加密
第二部分:理論基礎
2.1.符合 NIST 標準的 RBAC 和變體
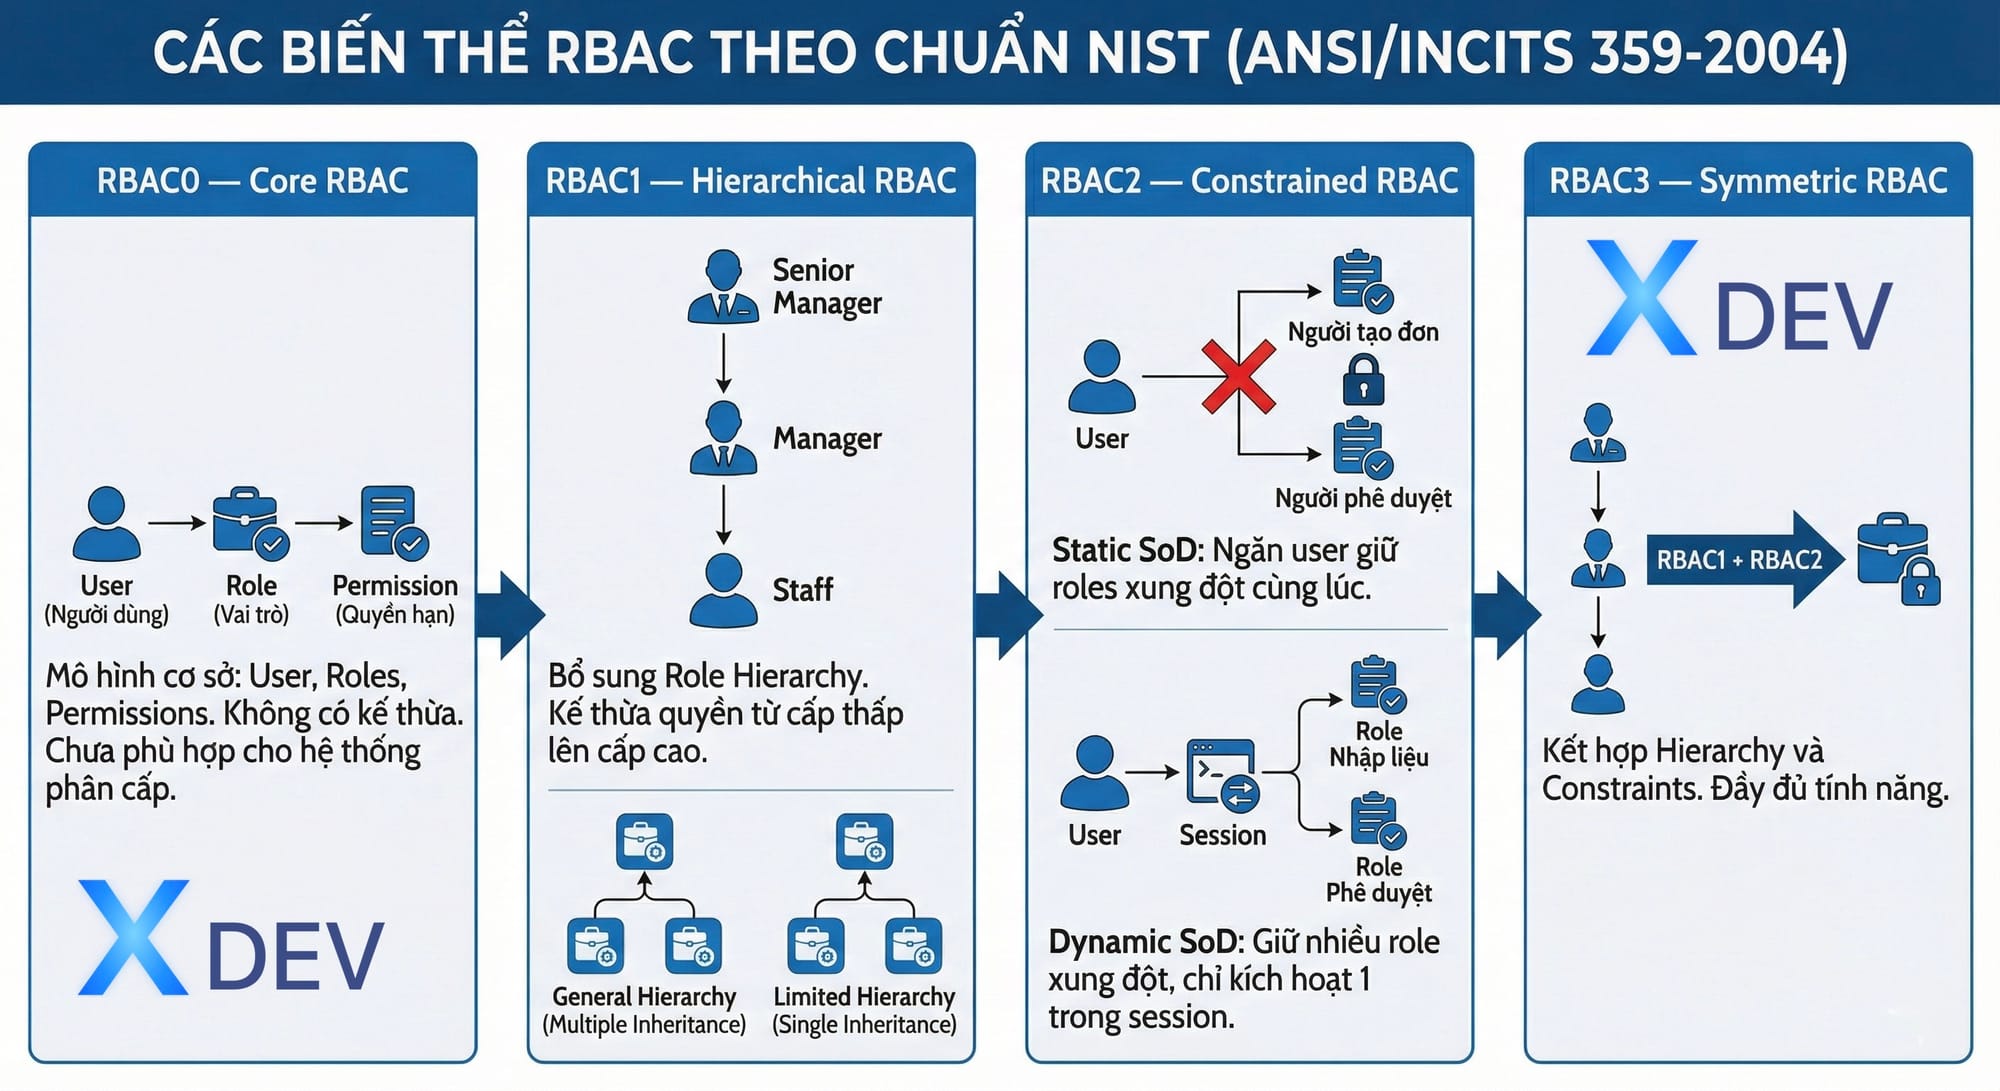
基於角色的存取控制(RBAC)由 NIST 在 ANSI/INCITS 359-2004 標準中標準化,分為 4 個等級:
RBAC0 — 核心 RBAC: 具有三個元件的基本模型:使用者、角色和權限。使用者被指派給角色,角色被指派權限。這是基礎,但缺乏繼承的概念,不適合等級制度。
RBAC1 — 分層 RBAC: 新增角色層級,高階角色繼承低階角色的所有權限。例如:高階經理繼承經理的權限,經理繼承員工的權限。這是最適合層級組織結構的模式。
有兩種類型的層次結構:
- 一般層次結構: 允許多重繼承-一個角色可以繼承許多其他角色
- 有限的層次結構: 只允許單繼承-每個角色只繼承一個角色,創造一個簡單的樹
RBAC2 — 受限 RBAC: 增加約束,最重要的是職責分離(SoD):
- 靜態SOD: 防止使用者同時擔任衝突的角色。例如,不可能同時是「訂單創建者」和「訂單審批者」。
- 動態SOD: 允許在會話中保留多個衝突的角色,但不能同時啟動。使用者可以同時擁有「資料輸入」和「批准」角色,但登入時必須選擇其中一個。
RBAC3 — 對稱 RBAC: 結合 RBAC1 和 RBAC2,提供完整的層次結構和約束。
2.2. ABAC:基於屬性的存取控制
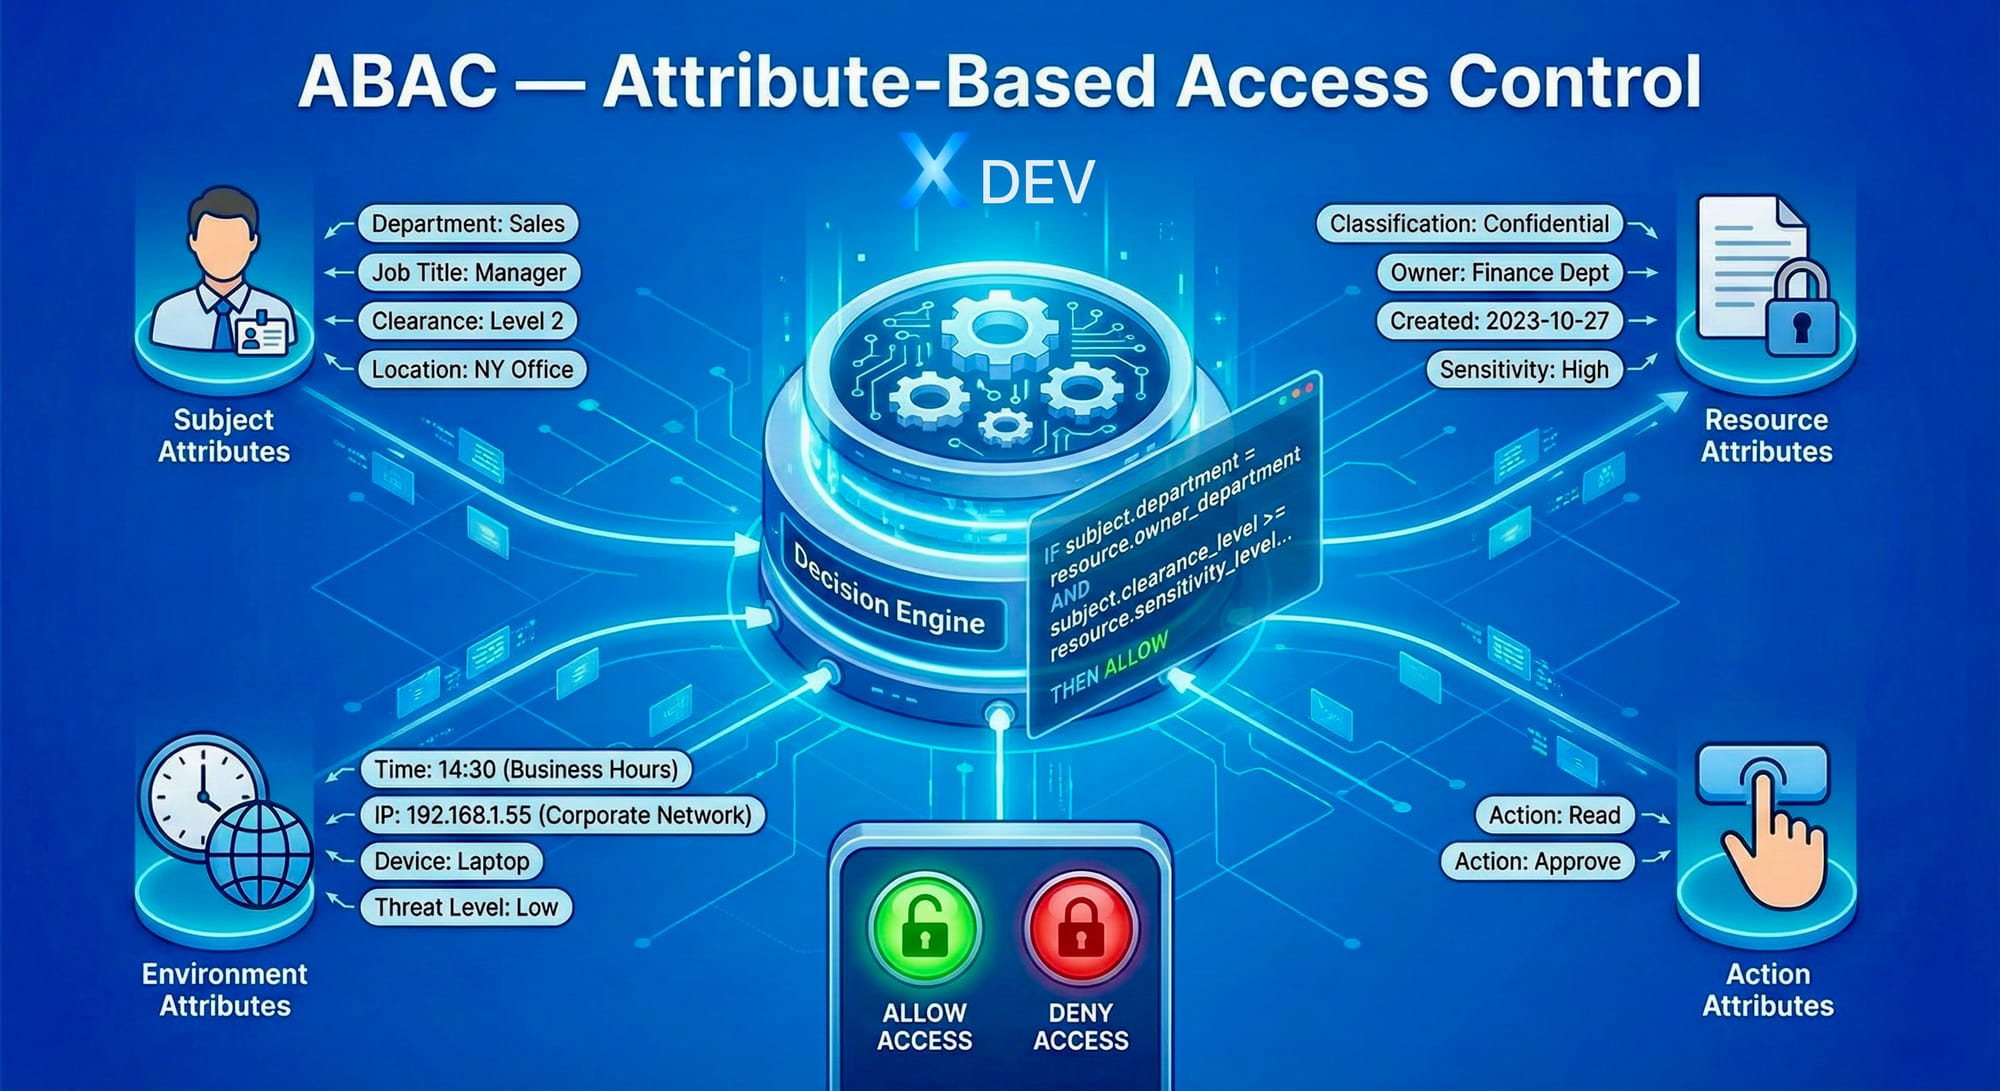
ABAC 透過在做出授權決策時評估多個屬性來擴展 RBAC:
- 主題屬性: 使用者屬性 — 部門、職位、許可證等級、地點
- 資源屬性: 資源屬性 — 分類、擁有者、建立日期、敏感級別
- 環境屬性: 上下文屬性 — 一天中的時間、IP 位址、裝置類型、威脅級別
- 動作屬性: 操作類型 — 讀取、寫入、刪除、批准
政策 ABAC 是作為規則而寫的。例如:
IF subject.department = resource.owner_department
AND subject.clearance_level >= resource.sensitivity_level
AND environment.time IN business_hours
AND environment.ip_range IN corporate_network
THEN ALLOW action
ABAC 功能強大且靈活,但部署複雜、難以調試,如果策略複雜,可能會影響效能。在需要詳細控制的情況下,建議除了 RBAC 之外還使用 ABAC,而不是作為完全替代方案。
2.3.多租戶和模型
多租戶是一種架構,允許系統為多個獨立租戶(單位/組織)提供隔離資料服務:
孤立模型 - 每個租戶的資料庫: 每個租戶都有一個單獨的資料庫。絕對隔離,易於每個租戶定制,易於滿足資料駐留要求。缺點:基礎設施成本高,租戶數量較多時難以維護,跨租戶報告複雜。
橋模型 - 每個租戶的架構: 租用戶共享相同的資料庫實例,但每個租用戶都有自己的架構。隔離與效率之間的平衡。缺點:一個資料庫中的模式數量有限,遷移複雜。
池化模型-共享一切: 所有租用戶共享相同的資料庫和架構,透過tenant_id 欄位進行區分。成本最低,易於擴展,易於維護。缺點:應用層和資料庫層需要強大的隔離機制,一個bug可能會影響所有租用戶。
推薦: 大多數情況下具有行級安全性 (RLS) 的池化模型。僅當資料駐留有特殊要求或租戶需要深度自訂時才使用孤立模型。
2.4.分層多租戶
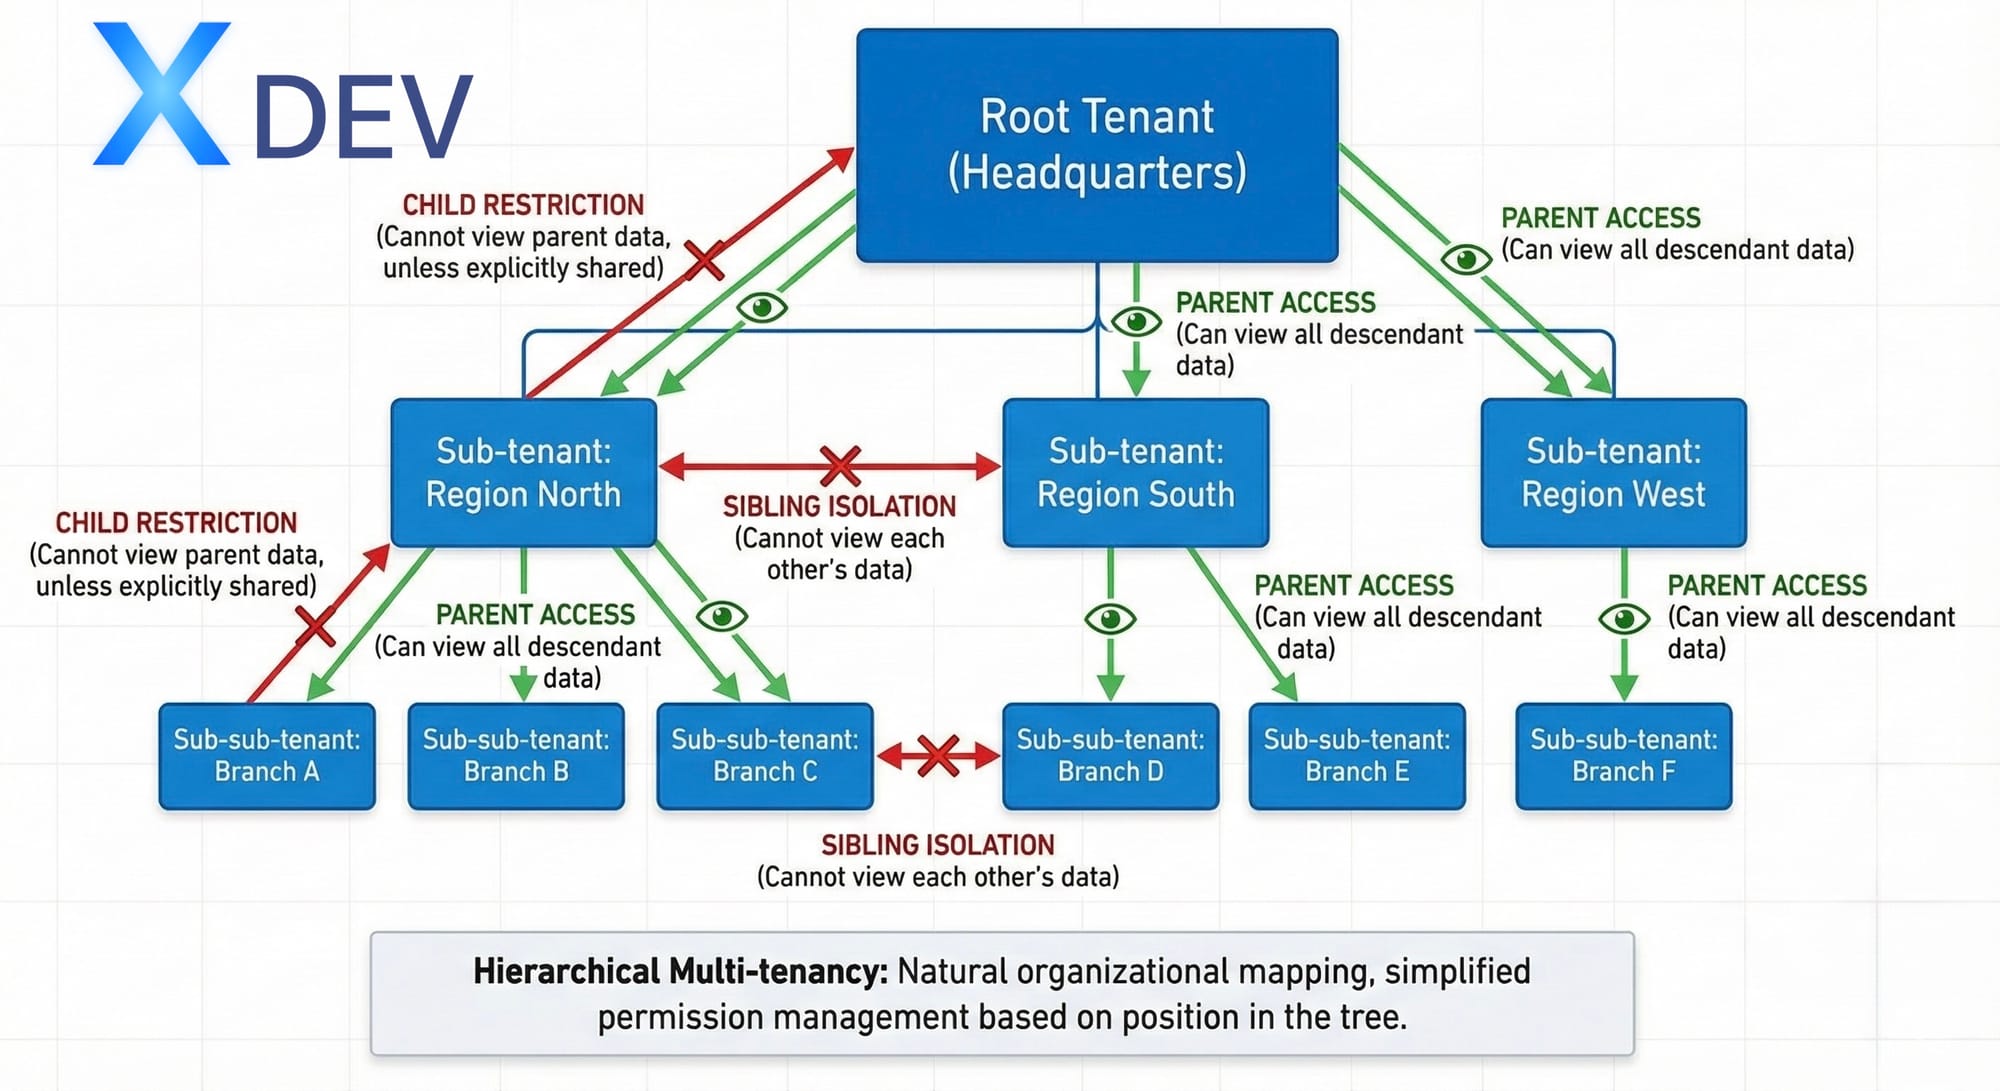
這是多租戶對分層結構的擴展,其中租戶被組織成樹而不是平面列表:
Root Tenant (Headquarters)
├── Sub-tenant: Region North
│   ├── Sub-sub-tenant: Branch A
│   ├── Sub-sub-tenant: Branch B
│   └── Sub-sub-tenant: Branch C
├── Sub-tenant: Region South
│   ├── Sub-sub-tenant: Branch D
│   └── Sub-sub-tenant: Branch E
└── Sub-tenant: Region West
    └── Sub-sub-tenant: Branch F
訪問規則:
- 父租戶可以查看所有後代租戶的數據
- 同級租戶(同級、同父級)無法查看彼此的數據
- 子租戶無法查看父租戶的資料(明確共享的資料除外)
這種模型自然地映射到組織結構中並簡化了權限管理:無需向每個單元授予權限,只需確定使用者在樹中的位置即可。
第 3 部分:設計層次結構資料模型
3.1.在資料庫中表示樹的方法
在關聯式資料庫中表示樹結構有多種方法,每種方法都有自己的權衡:
邻接列表: 每個節點直接儲存其父節點的 ID。這是最簡單、最自然的方式。
優點: 易於理解,易於實現,簡單的插入/更新/刪除,易於使用外鍵強制執行完整性。
缺點: 查詢以檢索所有後代或祖先需要遞歸查詢(SQL 中的 RECURSIVE),對於深樹或大樹來說,該查詢可能會很慢。
適合以下情況: 樹不太深(<10層),主要是直接父子查詢,結構變化頻繁。
嵌套集: 每個節點儲存兩個值:左和右。節點的所有後代在範圍內具有左/右(parent.left、parent.right)。
優點: 查詢後代非常快(只需要BETWEEN條件),不需要遞歸。
缺點: 插入/更新/刪除非常慢,因為它必須更新許多其他節點的左/右。並發修改比較複雜。
適合以下情況: 樹很少改變,經常查詢後代,可以接受寫入效能權衡。
关闭表: 將所有祖先-後代對儲存在一個單獨的表中,並具有深度。例如,如果 A → B → C,則閉包表包含 (A,A,0)、(A,B,1)、(A,C,2)、(B,B,0)、(B,C,1)、(C,C,0)。
優點: 查詢祖先和後代都很快,不需要遞歸。對複雜查詢的良好支持,例如“節點 X 深度為 2 的所有節點”。
缺點: 消耗儲存空間(最壞情況下為 O(n²))。插入/刪除需要更新閉包表中的許多行。
適合以下情況: 需要定期查詢祖先和後代,樹不太大,可以接受權衡儲存。
物化路径: 每個節點儲存從根到自身的路徑,通常作為字串(例如“/1/5/12/”)或陣列(例如[1, 5, 12])。
優點: 輕鬆查詢後代(例如“/1/5/%”或陣列包含)。插入很簡單(只需要知道父級的路徑)。可以有效索引。
缺點: 移動子樹需要更新所有後代的路徑。樹木茂密,小路可以很長。
適合以下情況: 樹結構很少變化(移動/重新父級很少),查詢後代頻繁,需要平衡讀寫效能。
3.2.推薦:帶有數組的物化路徑
對於行政/組織層級結構, 物化路徑使用數組 是最佳選擇,因為:
- 組織結構很少變化(每年幾次)
- 查詢「X 的所有子單元」很常見(用於委託)
- PostgreSQL 和現代資料庫支援具有高效 GIN 索引的數組
- 易於與 RLS 策略結合
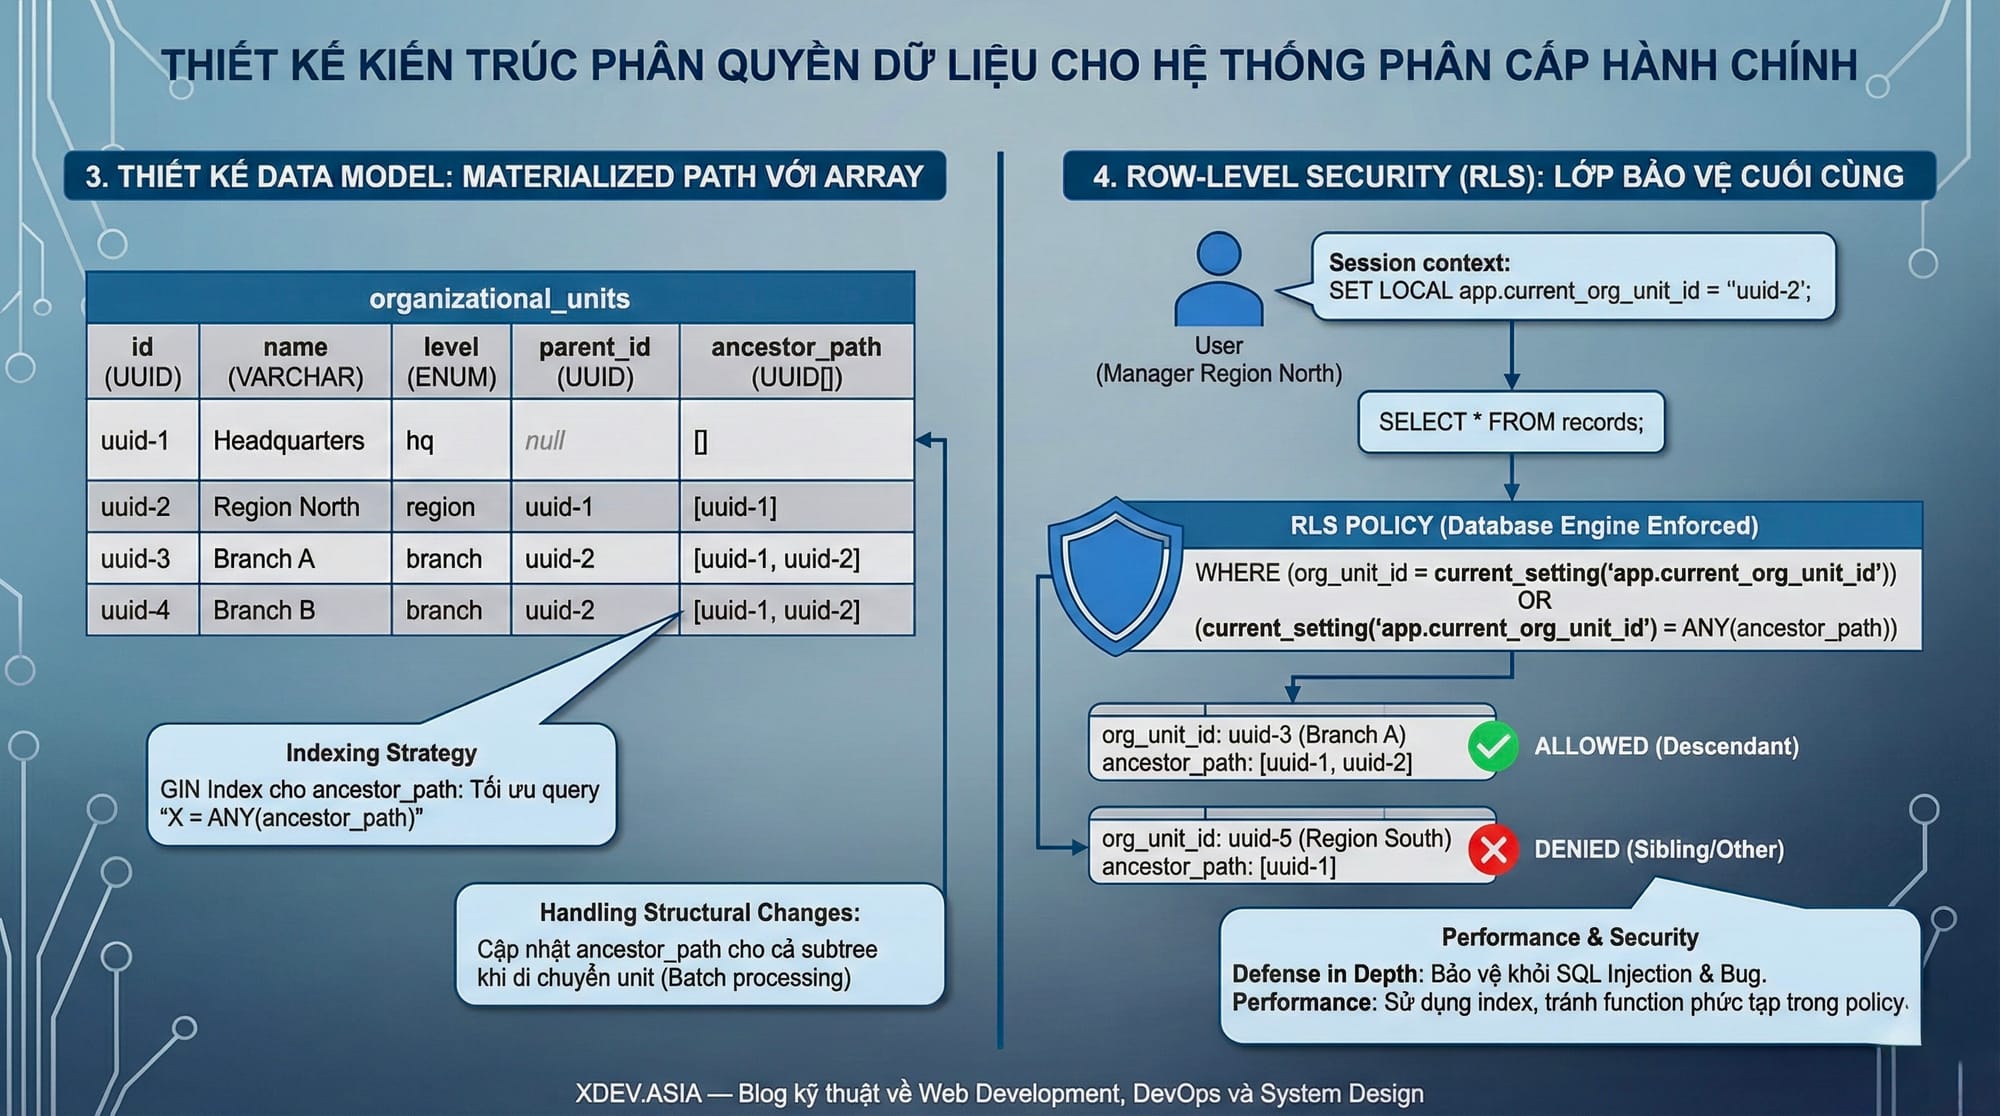
設計organizational_units表:
| 專欄 | 類型 | 描述 |
|---|---|---|
| 編號 | 通用唯一識別符 | 主鍵 |
| 程式碼 | VARCHAR | 單位代碼(唯一) |
| 姓名 | VARCHAR | 單位名稱 |
| 水平 | 列舉 | 級別(總部、地區、分公司…) |
| 父 ID | 通用唯一識別符 | FK 到父級(根可為空) |
| 祖先路徑 | UUID[] | 從根到父級的 ID 數組 |
| 創建時間 | 時間戳 | 創建時間 |
| 更新時間 | 時間戳 | 更新時間 |
資料範例:
| 編號 | 姓名 | 水平 | 父 ID | 祖先路徑 |
|---|---|---|---|---|
| uuid-1 | 總部 | 總部 | 空 | [] |
| uuid-2 | 北部地區 | 地區。地區 | uuid-1 | [uuid-1] |
| uuid-3 | A分行 | 分支。分行 | uuid-2 | [uuid-1,uuid-2] |
| uuid-4 | B分行 | 分支。分行 | uuid-2 | [uuid-1,uuid-2] |
查詢 Region North (uuid-2) 的所有後代:
SELECT * FROM organizational_units
WHERE uuid-2 = ANY(ancestor_path);
此查詢返回 Branch A 和 Branch B — 祖先路徑中具有 uuid-2 的所有單位。
3.3.索引策略
為了確保大型資料集的效能:
祖先路徑的 GIN 索引: 允許查詢“X = ANY(ancestor_path)”快速運行。
Parent_id 的 B 樹索引: 讓我們直接查詢父子關係。
(級別,parent_id)的複合索引: 給定查詢「屬於 X 區域的所有分支」。
活動記錄的部分索引: 如果存在軟刪除,則僅索引活動記錄。
3.4.處理結構性變化
當結構發生變化(將一個單元從一個父單元移動到另一個單元)時,有必要更新該單元和所有後代的祖先路徑:
步驟一: 計算新的ancestor_path = [new_parent.ancestor_path, new_parent.id]
步驟2: 對於每個後代,將祖先路徑中的舊前綴替換為新前綴
注意: 如果子樹很大,這是一個繁重的操作。應在非高峰時段完成,可能需要批次和進度追蹤。
第 4 部分:行級安全性 — 最後一層保護
4.1.為什麼需要 RLS?
應用程式層級授權檢查應用程式程式碼中的權限。這是一種流行的方式,但也有缺點:
- 程式碼中的錯誤: 開發人員忘記向新 API 新增權限檢查
- SQL注入: 攻擊者繞過應用層,直接存取資料庫
- 直接資料庫存取: DBA、BI 工具或駭客擁有資料庫存取憑證
- 微服務複雜性: 許多服務存取同一個資料庫,因此很難確保它們都檢查正確的權限
行級安全性 (RLS) 是資料庫(PostgreSQL、SQL Server、Oracle)的功能,允許在行級定義存取控制策略。策略由資料庫引擎強制執行,不能從應用程式中繞過。
縱深防禦: 即使應用程式存在錯誤,即使攻擊者進行了 SQL 注入,資料庫仍然只傳回允許目前使用者查看的行。 RLS 是最後一層保護,不會取代應用程式層級檢查,而是增加額外的安全層。
4.2. RLS 的工作原理
步驟 1 — 在板上啟用 RLS: 預設情況下,RLS 處於關閉狀態。啟用後,該表上的所有查詢都將透過策略進行篩選。
第 2 步 — 政策定義: 策略是一個布林表達式,用於確定允許存取哪些行。策略可以單獨或全部應用於 SELECT、INSERT、UPDATE、DELETE。
步驟 3 — 設定會話上下文: 應用程式在執行查詢之前設定會話變數(例如current_user_id、current_org_unit_id)。策略使用這些變數進行過濾。
第 4 步 — 查詢執行: 資料庫會自動將策略中的條件加入到每個查詢的 WHERE 子句中。使用者不需要(也不能)更改此設定。
4.3.分級存取的策略設計
透過設計的ancestor_path模型,該策略允許分層存取:
邏輯: 如果符合以下條件,則屬於 X 單元的使用者可以存取記錄:
- 記錄屬於單位 X,OR
- 單元 X 位於擁有該記錄的單元的祖先路徑中(即 X 是該單元的祖先)
釋義:
- A分行員工(uuid-3)只能查看org_unit_id = uuid-3的記錄
- 管理員 Region North (uuid-2) 可以查看 org_unit_id = uuid-2, uuid-3, uuid-4 的記錄(region 以及屬於該 Region 的所有分支)
- 執行總部(uuid-1)可以查看所有記錄
4.4.會話上下文管理
RLS策略需要知道「目前使用者屬於哪個單位」。此資訊透過會話變數傳遞:
在 PostgreSQL 中: 使用 設定 和 目前設定():
-- Application set context sau khi xác thực user
SET LOCAL app.current_user_id = 'user-uuid';
SET LOCAL app.current_org_unit_id = 'uuid-3';
-- Policy đọc context
current_setting('app.current_org_unit_id', true)
重要提示:
- 使用
設定本地(僅在交易中有效)改為設定(會話期間有效)以避免請求之間的上下文洩漏 - 始終在每個事務開始時設定上下文
- 處理未設定上下文的情況(預設拒絕)
4.5.性能考慮因素
RLS 策略針對每一行進行評估,這可能會影響效能:
確保策略使用索引列: 如果政策檢查 org_unit_id = 任意(...),需要 org_unit_id 上的索引。
避免策略中複雜的函數呼叫: 每行都會呼叫該函數。如果函數查詢資料庫,就會出現N+1的問題。
使用 STABLE/IMMUTABLE 函數: 允許 PostgreSQL 快取查詢結果。
考慮具體化權限: 無需計算即時權限,而是可以預先計算並保存在單獨的表中,只需查找策略即可。
4.6.繞過 RLS 進行管理操作
有些情況需要繞過RLS:
- 系統遷移
- 批次作業
- 向所有租戶報告
- 緊急頻道
安全方法:
- 使用 BYPASSRLS 權限建立單獨的資料庫角色
- 該角色僅由特定服務帳戶使用
- 使用此角色的所有存取都會詳細記錄
- 定期審核以確保角色不被濫用
第五部分:角色層次結構與權限設計
5.1.獨立的角色和範圍
一個常見的錯誤是將角色和範圍合併到同一個實體。例如,建立角色「Branch_A_Manager」、「Branch_B_Manager」、「Region_North_Manager」。這導致角色數量激增。
更好的設計: 分離角色(function)和範圍(scope):
| 使用者 | 角色 | 範圍(組織單位) |
|---|---|---|
| 愛麗絲 | 主管 | A分行 |
| 鮑伯 | 主管 | B分行 |
| 卡羅爾 | 主管 | 北部地區 |
| 戴夫 | 分析師 | 總部 |
相同的角色「經理」但範圍不同。管理員的權限定義一次,範圍決定允許存取哪些資料。
5.2.角色層級設計
職能角色(依職能):
| 角色 | 描述 | 典型權限 |
|---|---|---|
| 觀眾 | 查看數據和報告 | 閱讀 |
| 操作員 | 處理日常運作 | 閱讀、建立、更新 |
| 主管 | 團隊管理、審批 | 閱讀、建立、更新、批准 |
| 管理員 | 配置管理 | 讀取、建立、更新、刪除、配置 |
| 審計員 | 審計 | 讀取(包括審核日誌) |
角色繼承:
Administrator
    ↓ inherits
Manager
    ↓ inherits
Operator
    ↓ inherits
Viewer
管理員自動擁有管理員、操作員和查看者的所有權限。
審計員 通常不在該層次結構中,因為它具有特殊權限(請參閱審核日誌)但沒有修改權限。
5.3.權限粒度
權限可以在許多詳細層級上定義:
粗粒度(coarse):
記錄:已讀— 讀取所有類型的記錄記錄:寫入— 建立/編輯所有類型的記錄
細粒度(細節):
客戶記錄:已讀客戶記錄:建立客戶記錄:更新客戶記錄:刪除財務記錄:已讀財務記錄:批准
推薦: 從粗粒度開始,依照實際需求進行細化。從一開始就過度設計權限會導致系統複雜且難以管理。
5.4.職責分離的實施
SoD 透過要求多人參與流程來防止詐欺和錯誤。
靜態 SOD — 角色衝突:
| 角色A | 角色B | 原因 |
|---|---|---|
| 請求者 | 審核人 | 不要自行批准您的請求 |
| 資料輸入 | 審計員 | 審計師必須是獨立的 |
| 開發商 | 部署者 | 獨立的開發和運營 |
為使用者指派角色時,請檢查該使用者是否已經具有衝突的角色。如果是,則拒絕分配。
動態 SoD — 衝突的啟動:
允許使用者擔任多個角色,但一次只能啟動一個角色。例如,使用者可以擁有「資料輸入」和「審閱者」角色,但登入時必須選擇其中一個。這允許靈活性(同一個人可以做多件事),同時仍然確保特定交易不完全由一個人控制。
基於交易的 SoD:
檢查每筆交易。例如:訂單有一個字段 創建者 和 核准人。制度執行 批准者! = 創建者。創建應用程式的人不能是批准該應用程式本身的人。
第 6 部分:處理敏感數據
6.1.資料分類
並非所有資料都需要相同等級的保護。資料分類是第一步:
| 分類 | 範例 | 防護等級 |
|---|---|---|
| 公有 | 公司名稱、公告 | 最小 |
| 內部 | 內部備忘錄、組織架構圖 | 標準存取控制 |
| 機密 | 財務報告、客戶名單 | 限制存取、審核日誌記錄 |
| 敏感 | PII、健康記錄、薪資資訊 | 加密、嚴格存取、詳細審核 |
| 受限 | 商業機密、併購計劃 | 需知基礎、特別批准 |
6.2.現場級存取控制
RLS 在行級別進行控制。但有時需要在欄位(列)層級進行控制:
例如: 表 員工。員工 有列:id、姓名、電子郵件、部門、薪水、ssn。 HR可以看到這一切。經理可以看到他的團隊的 ID、姓名、電子郵件、部門,但看不到薪水和 ssn。
實施辦法:
基於視圖: 為每個角色建立包含列子集的視圖。經理查詢檢視沒有工資/ssn。
應用級投影: 僅應用程式允許角色查看的 SELECT 列。
列級加密: 加密敏感列,僅解密具有金鑰的角色。
動態資料脫敏: 資料庫為不具有完全存取權限的角色傳回屏蔽值(例如,SSN 為 xxx-xx-1234)。
6.3.加密策略
靜態加密: 加密磁碟上的所有資料庫檔案。防止物理接觸(竊盜、不當處置)。對應用程式透明——無需更改程式碼。
透明資料加密(TDE): 資料庫在寫入時自動加密,讀取時自動解密。保護資料檔案和備份。不防止授權資料庫使用者。
應用程式級加密: 應用程式在傳送到資料庫之前加密,接收後解密。保護資料庫管理員和具有資料庫存取權限的任何人。缺點:無法查詢加密資料(除非使用可搜尋加密)。
列級加密: 僅加密特定列。安全性和可用性之間的平衡。可以查詢未加密的列。
針對敏感資料的建議:
- 靜態加密:始終開啟(基線保護)
- 應用程式級加密:適用於高度敏感的欄位(SSN、健康資料)
- 列級加密:適用於需要偶爾搜尋的中等敏感字段
6.4.密鑰管理
加密的強度取決於密鑰管理:
密鑰儲存: 切勿將金鑰儲存在代碼、設定檔或與加密資料相同的資料庫中。使用專用金鑰管理系統 (KMS),例如 AWS KMS、HashiCorp Vault、Azure Key Vault。
按鍵輪換: 定期(例如每年)以及出現問題(密鑰可能會暴露)時更改密鑰。使用新密鑰重新加密資料。
關鍵層次結構: 主密鑰加密資料密鑰。資料密鑰加密實際資料。如果需要輪換,只需使用新的主密鑰重新加密資料密鑰即可,無需重新加密所有資料。
存取密鑰: 最小特權原則。只有需要解密的服務才能存取金鑰。審核所有存取金鑰。
第 7 部分:審計追蹤與合規性
7.1.記錄什麼
審核日誌記錄需要捕捉足夠的資訊來回答:誰對哪個資源做了什麼、何時、從何處以及為什麼(如果可用)。
身份驗證事件:
- 登入成功/失敗
- 退出
- 密碼更改/重置
- 外交部活動
- 會話逾時
授權事件:
- 已授予存取權限
- 訪問被拒絕
- 權限提升嘗試
- 角色/權限更改
資料存取事件:
- 讀取敏感資料(強制)
- 讀取正常資料(可選,根據需求)
- 建立記錄
- 更新記錄(包含之前/之後的值)
- 刪除記錄
配置變更:
- 系統設定已修改
- 使用者/角色管理
- 政策變化
- 整合配置
異常情況:
- 不尋常的訪問模式
- 多次嘗試失敗
- 從新位置/設備訪問
- 大量資料存取
7.2.日誌條目結構
每個日誌條目需要包含:
| 領域 | 描述 | 範例 |
|---|---|---|
| 時間戳 | 時間(附時區) | 2025-01-15T14:30:00Z |
| 事件ID | 唯一識別符 | uuid |
| 事件類型 | 事件類型 | 資料存取 |
| 行動。行動 | 具體行動 | 閱讀 |
| 演員 ID | 用戶這樣做 | 使用者uuid |
| 演員角色 | 目前的角色 | 主管 |
| 演員組織單位 | 使用者單位 | 分支 uuid |
| 資源類型 | 資源類型 | 客戶記錄 |
| 資源ID | 資源ID | 記錄-uuid |
| 資源組織單位 | 所屬單位 | 分支 uuid |
| 結果。結果 | 結果 | 成功/失敗 |
| IP位址 | 來源IP | 192.168.1.100 |
| 使用者代理 | 客戶資訊 | Mozilla/5.0... |
| 會話ID | 會話標識符 | 會話 uuid |
| 詳細資訊。詳情 | 附加資訊 | JSON 物件 |
7.3.日誌完整性和保留
不變性: 審核日誌必須是不可變的-任何人都不允許修改或刪除它們。用途:
- 一次寫入儲存(WORM)
- 帶有觸發器的僅附加表可防止更新/刪除
- 基於區塊鏈的驗證
- 用於檢測篡改的常規哈希鏈
保留政策:
- 活動儲存:90 天(快速存取以進行調查)
- 檔案儲存:1-7年(取決於合規要求)
- 定義明確的策略並自動歸檔/清除
日誌的存取控制:
- 審計日誌存取的單獨權限
- 只有安全/合規團隊有權訪問
- 記錄審核日誌的存取(元審核)
7.4.監控和警報
如果沒有人看到,日誌就沒有價值。實施:
即時警報:
- 多次失敗的登入嘗試 → 可能的暴力破解
- 存取被拒絕峰值 → 可能未經授權的存取嘗試
- 大量資料存取 → 可能的資料洩露
- 從異常位置存取 → 帳戶可能被盜
- 非工作時間存取敏感資料 → 需要調查
定期檢討:
- 每週:檢查訪問被拒絕模式
- 每月:檢查角色分配,尋找權限過高的帳戶
- 季度:全面存取權限審核,刪除未使用的權限
- 每年:政策審查,根據組織變化進行更新
第 8 部分:整合模式
8.1.身分提供者集成
大多數組織已經擁有身分提供者 (IdP),例如 Active Directory、Okta、Auth0、Keycloak。去中心化系統需要整合:
SAML 2.0: 企業 SSO 標準。 IdP 對使用者進行身份驗證,傳送包含使用者身分和屬性的 SAML 斷言。服務提供者(應用程式)信任斷言並建立會話。
OAuth 2.0 / OpenID 連線: 現代標準,流行於網路和行動裝置。 IdP 頒發的 JWT 令牌包含有關使用者的聲明。應用程式驗證令牌並提取聲明。
包含在令牌中的聲明:
- 子:用戶標識符
- 角色:角色名稱數組
- org_unit_id:主要組織單位
- org_unit_path:從根到組織單位的完整路徑
- 權限:(可選)如果不是從角色派生的,則為明確權限
8.2. API網關與授權
API網關是所有API請求的入口點。這是實現第一個授權層的理想位置:
令牌驗證: 驗證 JWT 簽名、檢查過期情況、驗證頒發者。
粗粒度授權: 檢查使用者是否有呼叫該介面的權限(根據token中的角色)。
速率限制: 防止濫用,可以依角色區分限制。
上下文注入: 從令牌中提取聲明,注入請求標頭以供下游服務使用。
注意: API網關應該只進行粗粒度的檢查。細粒度授權(例如,使用者是否有權存取此特定記錄)應由應用程式和資料庫 (RLS) 處理。
8.3.服務間授權
在微服务架构中,服务之间是相互调用的。需要授權這些呼叫:
服務帳戶: 每個服務都有自己的身分(服務帳戶)。當服務A呼叫服務B時,服務B驗證A的身份並檢查A是否有權限。
代幣傳播: 使用者的令牌從一項服務轉發到另一項服務。基於原始使用者權限的下游服務授權。
混合方法: 將兩者結合起來。服務 A 使用以下兩者呼叫服務 B:服務 A 的身份(用於服務等級驗證)和使用者令牌(用於使用者等級驗證)。服務 B 檢查兩者。
8.4.快取授權決策
授權檢查的成本可能很高,尤其是對於複雜的 ABAC。緩存有助於提高效能:
權限快取: 將結果「使用者 X 是否有權限 Y」快取在短 TTL(幾分鐘)內。當角色/權限改變時失效。
策略决策缓存: 快取複雜的ABAC策略的結果。鍵 = 所有涉及的屬性的雜湊值。
负缓存: 快取所有「被拒絕」的結果。但如果剛剛獲得許可,請小心漏報。
快取失效策略:
- 基於時間:短 TTL(1-5 分鐘)
- 基於事件:角色分配更改時無效
- 混合:TTL + 基於事件的失效
第 9 部分:測試和驗證
9.1.授權測試金字塔
單元測試: 測試單獨的權限檢查功能。給定具有角色 X 的用戶,他們可以執行操作 Y 嗎?測試邊緣情況:空輸入、無效角色、過期會話。
集成测试: 從 API 到資料庫進行端到端測試。驗證 RLS 策略是否正常運作。使用真實資料庫而不是模擬資料庫進行測試。
陰性測試: 與陽性測試同樣重要。驗證使用者無法存取他們不應該存取的內容。很容易被忽視,但對安全至關重要。
跨租戶測試: 驗證資料隔離。租户 A 查询的用户 → 不应返回租户 B 数据。
權限提升測試: 尝试绕过授权。嘗試直接資料庫存取、操作令牌、偽造會話上下文。
9.2.分層訪問的測試場景
场景一:垂直接入
- Region等級查詢中的使用者→應傳回Region資料+該Region下的所有Branch數據
- 分支層級查詢中的使用者 → 應僅傳回該分支的數據
場景二:水平隔離
- 分支 A 查詢中的使用者 → 不應傳回分支 B 數據
- 北部地區的用戶查詢 → 不應返回南部地區的數據
場景 3:移動操作
- 分行從北區遷至南區
- 北部地區查詢中的使用者 → 不應再傳回移動的分支數據
- 南部地區的使用者查詢 → 應傳回移動的分支數據
場景 4:多組織用戶
- 使用者屬於多個組織部門(罕見但可能)
- 查詢應傳回所有分配單元的資料並集
9.3.安全測試
滲透測試:
- 僱用外部團隊或使用 OWASP ZAP、Burp Suite 等工具
- 重點在於授權繞過漏洞
- 測試令牌操作、參數篡改、直接物件引用
程式碼審查:
- 檢查所有與授權相關的程式碼
- 檢查新端點是否缺少授權檢查
- 驗證 RLS 策略會覆寫所有包含敏感資料的表
配置審核:
- 查看角色定義和指派
- 尋找權限過高的帳戶
- 檢查孤立權限(已指派但未使用)
第 10 部分:操作注意事項
10.1.部署策略
分階段推出:
第 1 階段 — 基礎(第 1-2 個月):
- 部署組織單位層級結構模型
- 透過角色繼承實現基本 RBAC
- 在關鍵表上啟用 RLS
第 2 階段 — 強化(第 3-4 個月):
- 全面的審計日誌記錄
- SOD 約束
- 敏感資料加密
- 安全測試
第 3 階段 — 高級(第 5-6 個月):
- 複雜場景的ABAC
- 現場級門禁控制
- 自助服務權限請求
- 分析和異常檢測
10.2.處理邊緣情況
無組織單位的使用者: 預設拒絕。在存取資料之前,必須為使用者分配組織單位。
具有多個組織單位的使用者: 可存取資料的聯合。需要仔細設計以避免混亂。
組織單位重組: 計劃停機時間或實施逐步遷移。溝通變化。
緊急通道: 緊急情況下的「打破玻璃」程序。大量記錄,需要理由,自動過期。
孤立數據: 屬於該組織部門的資料已被刪除。定義策略:存檔、遷移或刪除。
10.3.監控和健康檢查
要追蹤的指標:
- 授權決策延遲(P50、P95、P99)
- 快取命中率
- 訪問被拒絕事件的數量
- RLS策略執行時間
- 會話上下文設定失敗
健康檢查:
- 在所有必要的表上啟用 RLS 策略
- 為所有請求正確設定會話上下文
- IdP 連接
- 審計日誌攝取率
警報閾值:
- 授權延遲 > 100ms (P95)
- 訪問拒絕率峰值 > 200% 基線
- RLS策略評估錯誤
- 審計日誌差距
10.4.災難復原
備份要求:
- 具有 RLS 策略的資料庫
- IdP 配置(角色、群組、映射)
- 應用授權配置
- 審核日誌(對於合規性至關重要)
恢復程序:
- 恢復資料庫並驗證 RLS 策略完好無損
- 驗證 IdP 同步
- 使用已知場景測試授權
- 檢查審計日誌是否有缺陷
緊急程序:
- 快速撤銷所有存取權限的程序(以防違規)
- 恢復特定使用者存取權限的過程
- 升級聯絡人
結論:要記住的原則
為分層結構建構去中心化系統是一個複雜的問題,但可以透過正確的原則來解決:
縱深防禦: 不要完全信任任何層。 API網關+應用程式+資料庫RLS建立多層保護。
最小權限: 授予最低限度的必要權限。新增權限比撤銷授予的權限更容易。
關注點分離: 分離角色(function)和範圍(scope)。角色定義“可以做什麼”,範圍定義“在哪裡做”。
層次繼承: 利用樹狀結構自動派生權限。上級繼承下級的查看權。
水平隔離: 對等單位必須完全隔離。沒有到兄弟姊妹的訪問路徑。
審核一切: 日誌夠詳細,可以重構「誰、何時、何地做了什麼」。這是合規和調查的要求。
測試陰性案例: 不僅驗證“可訪問”,還驗證“不可訪問”。陰性檢測常常被忽視,但卻至關重要。
變革計畫: 組織結構將會改變。彈性設計:輕鬆新增單元、移動單元、重整層次結構。
透過這些原則和建議的架構(分層 RBAC + 子租戶 + RLS + 綜合審計),您可以為任何去中心化組織建立強大、可擴展且安全的去中心化系統。
程式碼演示在這裡 https://github.com/xdev-asia-labs/spring-multitenant-rbac