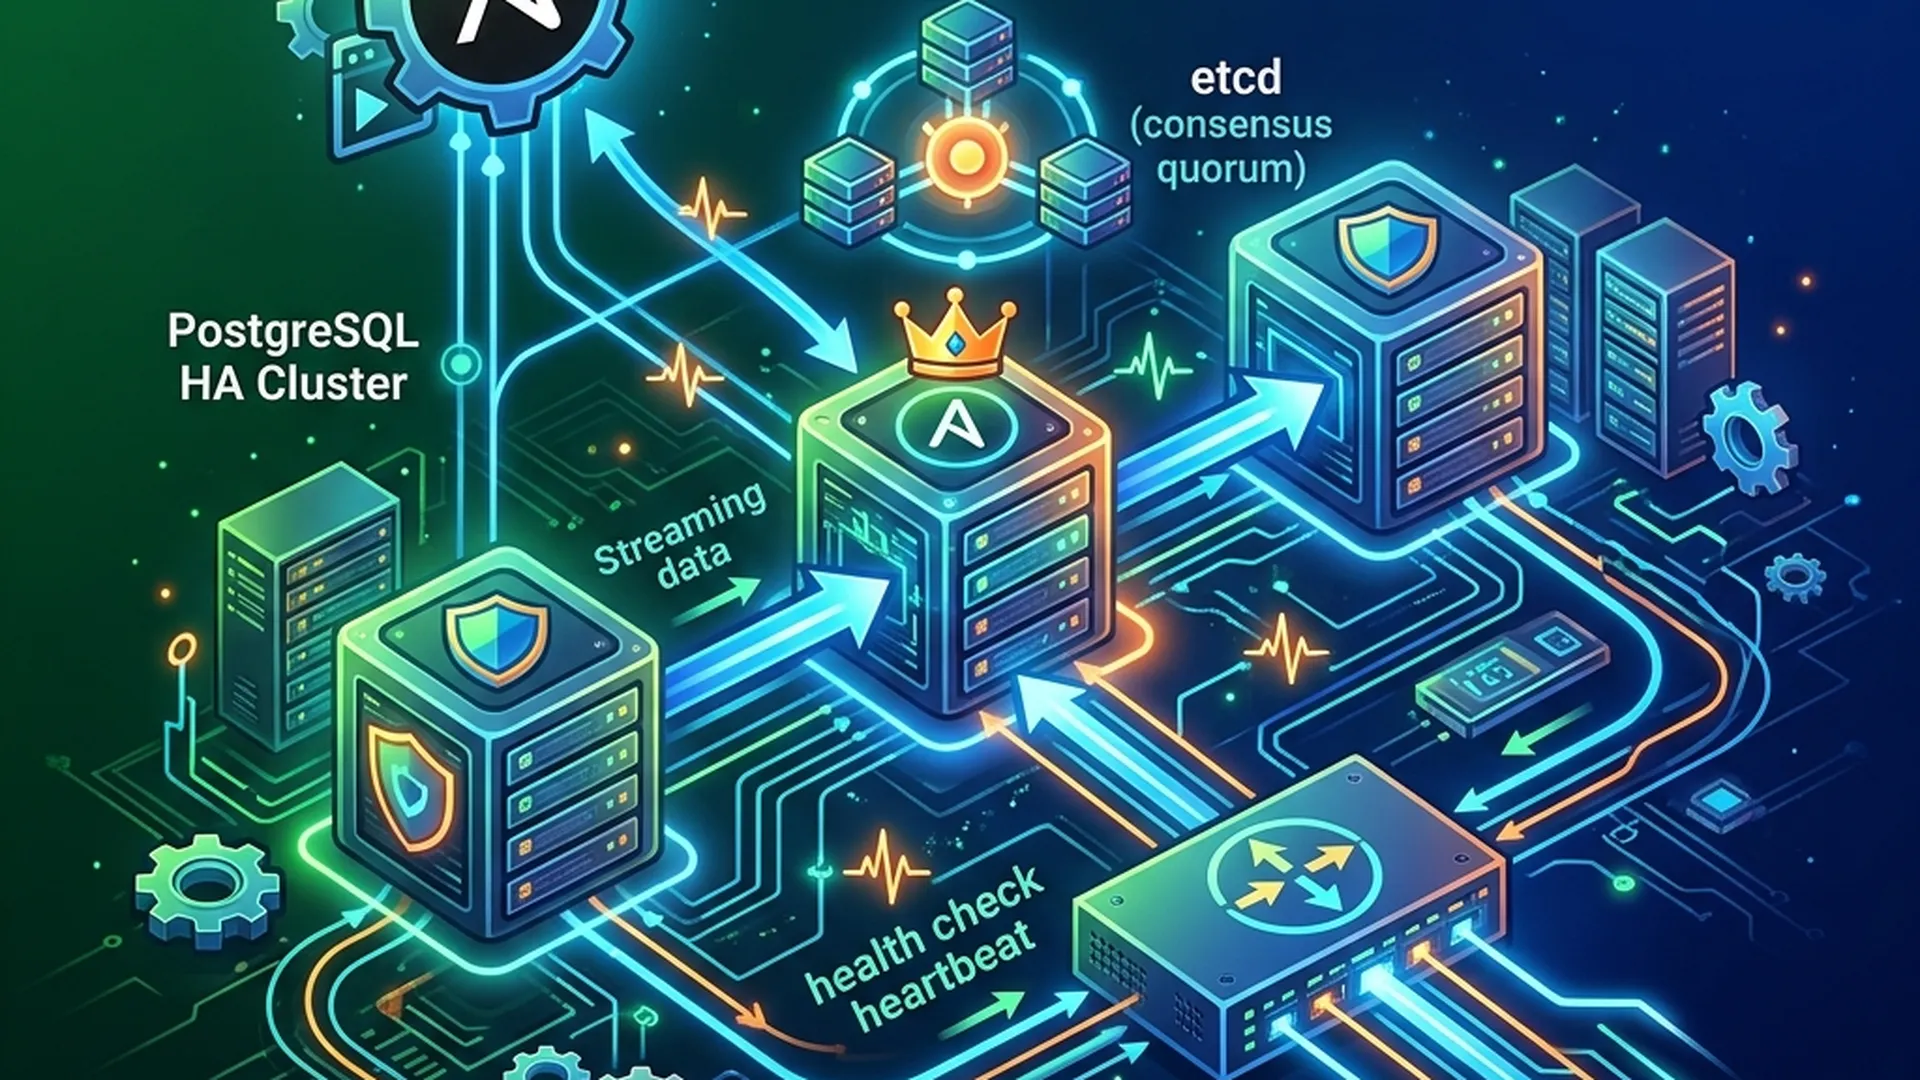
はじめに
高可用性 (HA) は、実稼働環境のデータベース システムにとって必須の要件です。ただし、PostgreSQL HA クラスターを最初からデプロイするには多くの場合、多くの調査時間が必要となり、手動構成中にエラーが発生しやすく、環境間で一貫性を維持するのが困難です。
この記事では、PostgreSQL HA クラスターを迅速かつ確実にデプロイするのに役立つ、Ansible を使用した完全な自動化ソリューションの開発における私たちの経験を共有します。運用環境での使用に成功した後、このソリューションをコミュニティにオープンソースとして公開することにしました。
リポジトリ: postgres-patroni-etcd-install
主な特長
自動化と導入
- 単一のコマンドでクラスター全体を自動的にデプロイします
- 70 を超える一元管理された環境変数を使用したコードとしての構成
- 複数環境のサポート (開発、ステージング、実稼働)
高可用性
- Patroni による自動フェイルオーバー (変換時間 30 ~ 45 秒)
- PostgreSQL 18.1 によるストリーミング レプリケーション
- pg_rewind を使用して障害が発生したノードを自動的に復元する
パフォーマンスとスケーラビリティ
- PgBouncerによる接続プーリング(多重化比13:1)
- 読み取りクエリの負荷分散をサポート
- 16GB ~ 64GB+ の RAM を搭載したシステム向けに最適化
DevOpsの統合
- GitHub Actions を使用した CI/CD パイプライン
- 自動化されたテストと検証
- 統合されたセキュリティスキャン
コンテキストと開発のダイナミクス
現実的な問題
本番運用中、午前 2 時に PostgreSQL サーバーでハードウェア エラーが発生するという重大なインシデントが発生しました。その結果、アプリケーション全体が動作を停止し、バックアップからの復元に 45 分かかりました。この事件は収益の損失を引き起こしただけでなく、評判と顧客の信頼にも影響を与えました。
HA実装時の課題
このインシデントの後、私たちは高可用性ソリューションを実装することを決定しました。ただし、手動構成では次のような多くの困難に直面します。
高い複雑性: PostgreSQL レプリケーション、Patroni、etcd、およびそれらの間の相互作用についての深い理解が必要です。調査と構成のプロセスは、経験豊富なエンジニアであれば 2 ~ 3 日かかります。
エラーのリスク: 手動構成ではノード間で不整合が発生しやすく、デバッグが困難な問題が発生します。構成ファイルに小さな間違いがあると、クラスター全体が正しく機能しなくなる可能性があります。
維持が難しい: 構成を更新したり、クラスターをスケールしたりする必要がある場合は、各ノードで手動で行う必要がありますが、これは時間がかかり、エラーが発生しやすくなります。
文書の不足: セットアップ プロセスに関する詳細なドキュメントがないため、新しいオンボード エンジニアがプロジェクトに参加することが困難になっています。
解決策
上記の問題を解決するために、一連の Ansible Playbook を開発しました。
コードとしてのインフラストラクチャ: すべての構成はバージョン管理されており、必要に応じて簡単に確認してロールバックできます。
反復可能な展開: ファイルを変更するだけで、多くの異なる環境 (開発、ステージング、運用) に同一のクラスターをデプロイできます。 .env。
自己文書化: Ansible コードは明確であり、詳細な README が付属しているため、新しいチームでも理解しやすく、使用しやすくなっています。
CI/CDの統合: 導入前に構成を自動的に検証し、エラーのリスクを最小限に抑えます。
実稼働環境で 6 か月間以上正常に使用した後、このソリューションをオープンソースにしてコミュニティと共有することにしました。
システムアーキテクチャ
技術スタック
このソリューションは、コミュニティで実証済みのテクノロジーを使用します。
| コンポーネント | バージョン | 役割 |
|---|---|---|
| PostgreSQL | 18.1 | メインデータベースエンジン |
| パトローニ | 4.1.0 | HA オーケストレーションと自動フェイルオーバー |
| etcd | 3.5.25 | 分散構成ストア |
| Pgバウンサー | 1.25.0 | 接続プーリング層 |
| アンシブル | 2.12+ | インフラストラクチャの自動化 |
一般的なアーキテクチャ
┌─────────────────────────────────────┐
│       Application Layer             │
│  (Spring Boot / Django / Node.js)   │
└──────────────┬──────────────────────┘
               │ Port 6432 (PgBouncer)
        ┌──────┴──────┬──────────┐
        ▼             ▼          ▼
   ┌────────┐    ┌────────┐   ┌────────┐
   │PgBouncer│   │PgBouncer│  │PgBouncer│
   │Node 1   │   │Node 2   │  │Node 3   │
   └────┬───┘    └────┬───┘   └────┬───┘
        │ Port 5432   │             │
   ┌────▼────┐   ┌───▼────┐   ┌────▼────┐
   │PostgreSQL│  │PostgreSQL│ │PostgreSQL│
   │ PRIMARY │  │ REPLICA  │ │ REPLICA  │
   │Read/Write│  │Read Only│ │Read Only │
   └────┬────┘   └────┬────┘  └────┬────┘
        │ Port 8008   │             │
   ┌────▼────┐   ┌────▼────┐  ┌────▼────┐
   │ Patroni │   │ Patroni │  │ Patroni │
   │HA Mgr   │   │HA Mgr   │  │ HA Mgr  │
   └────┬────┘   └────┬────┘  └────┬────┘
        │ Port 2379   │             │
        └──────┬──────┴─────────────┘
               ▼
        ┌──────────────────┐
        │   etcd Cluster   │
        │ (Leader Election)│
        └──────────────────┘
成分説明
PgBouncer レイヤー: 接続プーリングを提供するために各ノードにデプロイされます。アプリケーションは任意のノードに接続できるため、単一障害点とネットワーク遅延が削減されます。
PostgreSQL クラスター: 1 つのプライマリ ノード (読み取り/書き込み) と 2 つのレプリカ ノード (読み取り専用) でストリーミング レプリケーションを使用します。 Patroni はクラスターのライフサイクル全体を管理します。
パトローニ: HA オーケストレーターとして機能し、継続的なヘルスチェックを実行し、プライマリに障害が発生した場合は自動的にフェイルオーバーし、分散コンセンサスを通じてデータの一貫性を確保します。
etcdクラスタ: クラスター構成を保存し、リーダーの選出を実行します。スプリット ブレイン シナリオを回避するために、一度にプライマリ ノードが 1 つだけ存在するようにします。
なぜ 3 ノードなのか?
HA クラスターの最小数は 3 ノードです。次の理由からです。
- 定員会: etcd はクォーラム (2/3) を達成するために少なくとも 3 つのノードを必要とし、1 つのノードの障害を許容します
- 費用対効果の高い: インフラストラクチャに多額の費用をかけずに HA を確保するには十分です
- 実証済みのパターン: PostgreSQL および etcd コミュニティによって推奨される標準の数です。
実装ガイド
システム要件
ハードウェア (ノードごと)
ラボ/開発環境の最小要件:
- CPU:2コア
- RAM: 4GB
- ディスク: 20 GB (OS) + 20 GB (データ)
- ネットワーク: 1 Gbps
本番環境に推奨されるもの:
- CPU:4~8コア
- RAM: 16-32 GB
- ディスク: 50 GB SSD (OS) + 100+ GB NVMe SSD (データ)
- ネットワーク: 10 Gbps
ソフトウェア
制御ノード (Ansible を実行しているマシン):
- Ansible >= 2.12
- Python >= 3.9
ターゲットノード:
- Ubuntu 22.04 LTS / Debian 12 / Rocky Linux 9
- root または sudo 権限による SSH アクセス
- Python 3.xがインストールされている
実装手順
ステップ 1: リポジトリを準備する
git clone https://github.com/xdev-asia-labs/postgres-patroni-etcd-install.git
cd postgres-patroni-etcd-install
ステップ 2: 環境の構成
テンプレートから構成ファイルを作成します。
cp .env.example .env
重要なパラメータを編集します。
# Địa chỉ IP của các nodes NODE1_IP=10.0.0.11 NODE2_IP=10.0.0.12 NODE3_IP=10.0.0.13Mật khẩu PostgreSQL (bắt buộc phải thay đổi)
POSTGRESQL_SUPERUSER_PASSWORD=your_strong_password_here POSTGRESQL_REPLICATION_PASSWORD=your_replication_password_here
Performance tuning (ví dụ cho server 16GB RAM)
POSTGRESQL_SHARED_BUFFERS=4GB POSTGRESQL_EFFECTIVE_CACHE_SIZE=12GB POSTGRESQL_MAX_CONNECTIONS=100 PGBOUNCER_MAX_CLIENT_CONN=1000
ステップ 3: インベントリの構成
編集 インベントリ/hosts.yml:
all:
children:
postgres:
hosts:
pg-node1:
ansible_host: 10.0.0.11
patroni_name: node1
ステップ 4: クラスターのデプロイ
# Load environment variables set -a && source .env && set +aDeploy cluster
ansible-playbook playbooks/site.yml -i inventory/hosts.yml
ステップ 5: 確認する
ssh [email protected] "patronictl -c /etc/patroni/patroni.yml list"
優れた機能
コードとしての構成
すべての構成はファイルで管理されます .env 70 を超える変数を使用すると、次のことが可能になります。
- 構成の管理と監査が簡単
- ファイルを交換するだけで環境を切り替えることができます
.env - より優れたセキュリティ
.gitignore機密データ用 - 開発者にとって使いやすく、Ansible を深く理解する必要はありません
接続プーリング
PgBouncer は接続を最適化するように構成されています。
- 13:1 の多重化比 (3000 クライアント → 225 バックエンド接続)
- マルチホストサポートによる自動フェイルオーバー
- PostgreSQL のメモリと CPU オーバーヘッドを削減する
ゼロダウンタイムオペレーション
計画的な切り替え: 計画されたプライマリ ノードの移行では、ダウンタイムはわずか 2 ~ 5 秒です。
自動フェイルオーバー: プライマリに障害が発生した場合、30 ~ 45 秒で自動フェイルオーバーします。
ローリングアップデート: サービスの可用性に影響を与えずに構成またはバージョンを更新します。
CI/CD パイプライン
自動検証
GitHub Actions は各変更を自動的に検証します。
- YAML構文チェック
- Ansible プレイブックの検証
- セキュリティ スキャン (Trivy、TruffleHog)
- コードの品質チェック
リリースオートメーション
新しいタグ (v1.0.0) を作成すると、GitHub Actions は自動的に次のことを行います。
- git 履歴から変更ログを生成する
- リリースアーカイブを作成する
- ドキュメントを含む GitHub リリースを公開する
パフォーマンス
3 ノード (16GB RAM、ノードあたり 5 コア) のテスト環境:
- 読み取りQPS: 50,000-100,000
- 書き込みQPS: 10,000-20,000
- フェイルオーバー時間: 30 ~ 45 秒
- 接続容量: 3,000クライアント
- クエリ遅延: <5ms (単純なクエリ)
学んだ教訓
1. 実績のあるツールを使用する
独自に開発する代わりに、Patroni、etcd、PgBouncer などの実績のあるテクノロジーを使用します。これにより、車輪の再発明ではなく自動化に重点を置くことができます。
2. コードとしての構成
構成の外部化 .env Playbook でハードコードする代わりにファイルを使用することで、さまざまな環境に合わせたカスタマイズと保守が容易になります。
3. セキュリティ第一
最初から常にセキュリティを優先します。
- 使用する
.gitignore機密ファイル用 - 強力なパスワードを生成する
- ファイアウォールルールを自動的に構成する
- セキュリティスキャンをCIに統合する
4. 文書化に関する事項
適切なドキュメントはオンボーディング時間を短縮し、プロジェクトのプロフェッショナリズムを実証します。当社では完全なドキュメントを英語とベトナム語の両方で管理しています。
ロードマップ
開発中の機能:
- 統合された Prometheus/Grafana モニタリング
- pgBackRest による自動バックアップ
- クラウド展開のための Terraform サポート
- Docker/Kubernetes導入オプション
- マルチリージョンレプリケーション
いつ使用するべきですか?
以下に適しています:
- アプリケーションには高可用性 (稼働時間 > 99.9%) が必要です。
- システムは長時間にわたるダウンタイムを許容できません
- 複数の同時接続を備えたマルチテナント アプリケーション
- Teams はコードとしてのインフラストラクチャを適用します
次の場合は必要ありません。
- 開発・テスト環境がシンプル
- 低トラフィックのアプリケーション
- アプリケーションは時折のダウンタイムを許容する場合があります
- 予算の制約 (少なくとも 3 台のサーバーが必要)
結論
適切なツールとアプローチを使用すれば、PostgreSQL 高可用性クラスターの構築はもはや大きな課題ではなくなります。このソリューションは実稼働環境で実証されており、多くの重要なシステムの稼働時間を確保するのに役立ちます。
この一連の Ansible Playbook を使用すると、本番環境に対応したクラスターを 10 分でデプロイし、99.9% を超える稼働率を達成し、Infrastructure as Code メソッドに従ってインフラストラクチャを管理できます。
貢献する
プロジェクトが役立つと思われる場合:
- ⭐ スターリポジトリ
- 🐛 問題を報告する
- 💬 フィードバックを共有する
- 🤝 コードを提供する
- 📢 コミュニティと共有する