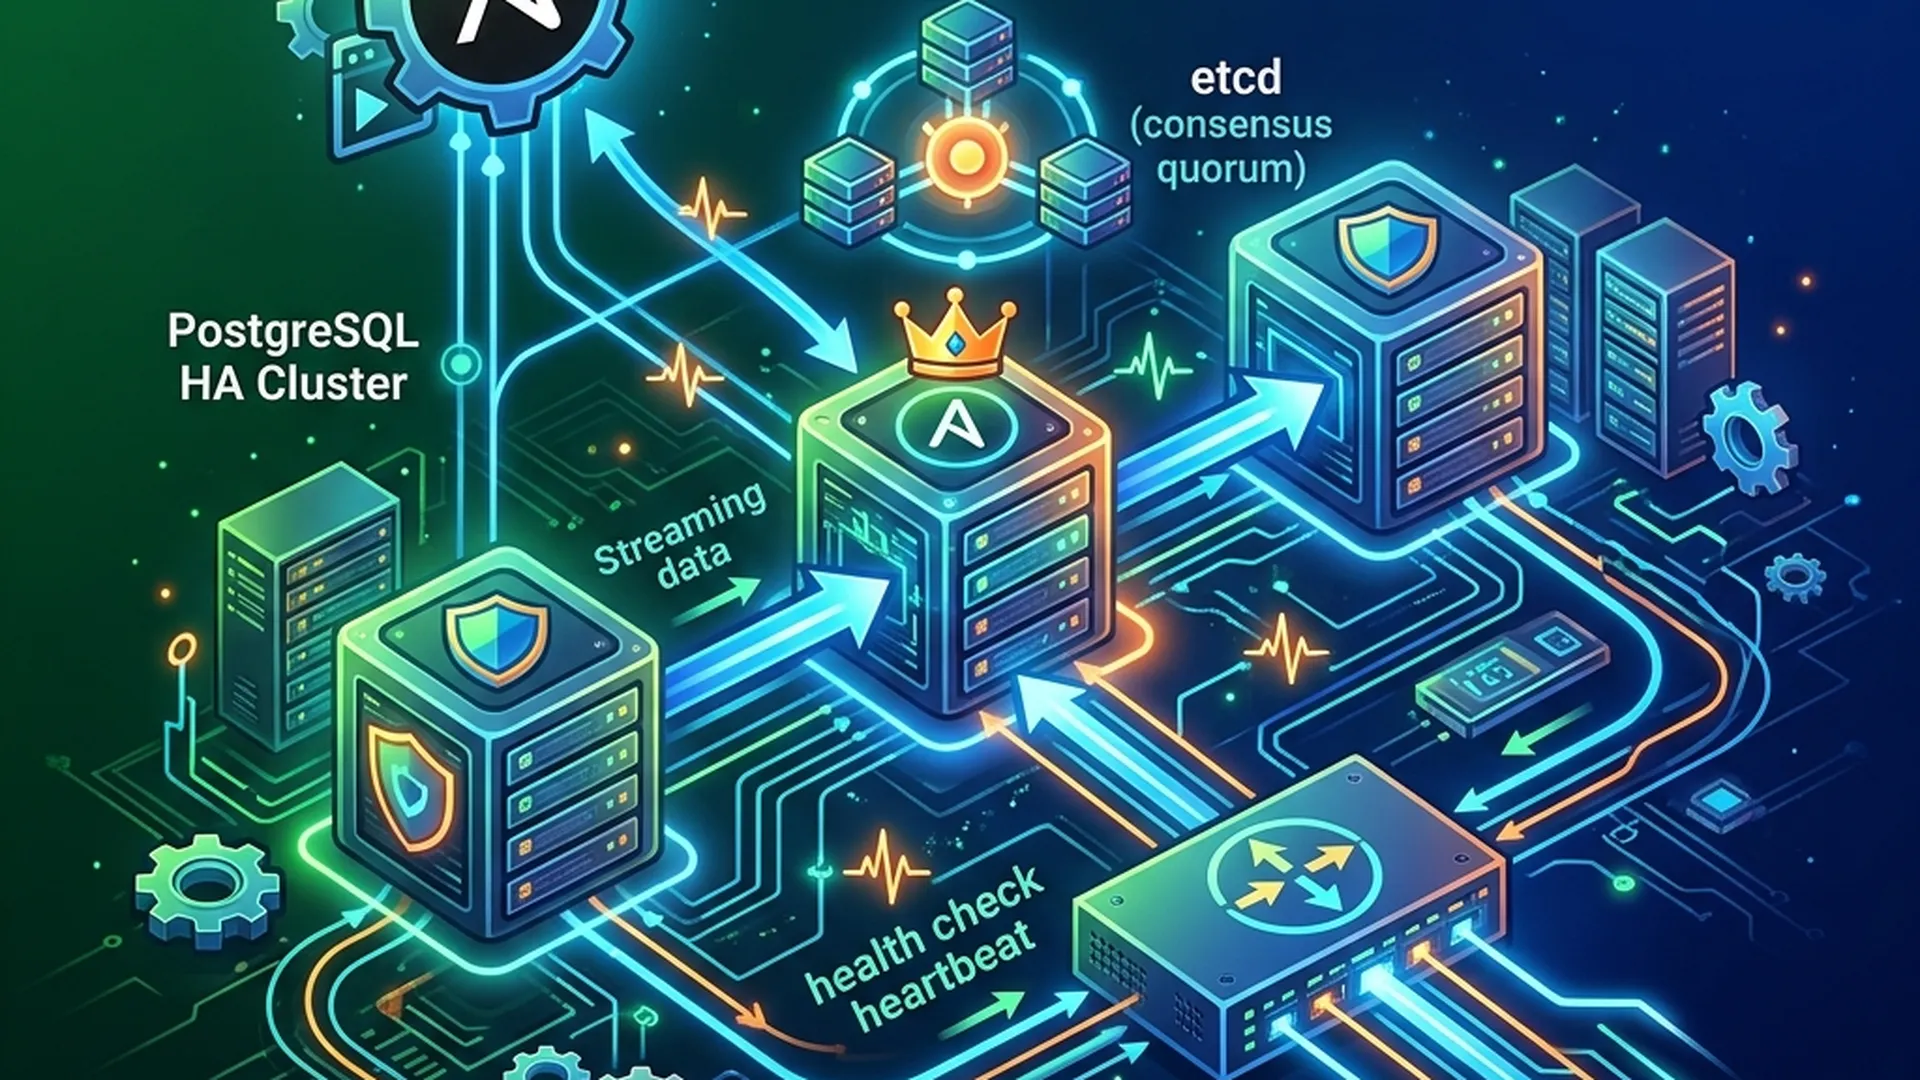
簡介
高可用性(HA)是生產環境中任何資料庫系統的基本要求。然而,從頭開始部署PostgreSQL HA叢集往往需要大量的研究時間,手動設定時容易出錯,難以保持跨環境的一致性。
本文分享了我們使用 Ansible 開發完整自動化解決方案的經驗,有助於快速可靠地部署 PostgreSQL HA 叢集。在生產中成功使用後,我們決定向社群開源解決方案。
主要特點
自動化與部署
- 使用單一命令自動部署整個集群
- 配置即程式碼,具有 70 多個集中管理的環境變數
- 多環境支援(開發、暫存、生產)
高可用性
- 使用 Patroni 自動故障轉移(轉換時間 30-45 秒)
- 使用 PostgreSQL 18.1 進行串流複製
- 使用 pg_rewind 自動恢復失敗的節點
性能和可擴展性
- 與 PgBouncer 的連線池(複用比 13:1)
- 支援讀取查詢的負載平衡
- 針對 RAM 從 16GB 到 64GB+ 的系統進行了最佳化
開發營運集成
- 帶有 GitHub Actions 的 CI/CD 管道
- 自動化測試和驗證
- 整合安全掃描
背景和發展動態
實際問題
在生產作業過程中,我們經歷了一次嚴重的事件,PostgreSQL 伺服器在凌晨 2 點出現硬體錯誤。結果,整個應用程式停止工作,並且需要 45 分鐘才能從備份還原。該事件不僅造成收入損失,也影響聲譽和客戶信任。
實施 HA 時的挑戰
事件發生後,我們決定實施高可用性解決方案。然而,手動配置面臨許多困難:
高複雜度:需要深入了解 PostgreSQL 複製、Patroni、etcd 以及它們之間的交互作用。對於經驗豐富的工程師來說,研究和配置過程需要 2-3 天。
錯誤風險:手動配置容易導致節點之間不一致,造成難以調試的問題。設定檔中的一個小錯誤可能會導致整個叢集無法正常運作。
維護困難:當需要更新配置或擴展叢集時,必須在每個節點上手動完成,既耗時又容易出錯。
缺乏文檔:沒有關於設定過程的詳細文檔,導致新的工程師很難加入專案。
解決方案
我們開發了一套 Ansible playbook 來解決上述問題:
基礎設施即程式碼:所有配置均受版本控制,易於在需要時查看和回滾。
可重複部署:只需更改文件即可在許多不同的環境(開發、登台、生產)上部署相同的叢集 .env。
自我記錄:Ansible程式碼清晰,附有詳細的README,方便新團隊瞭解與使用。
持續集成/持續交付集成:在部署之前自動驗證配置,最大限度地減少錯誤風險。
在生產中成功使用該解決方案超過 6 個月後,我們決定開源解決方案以與社區分享。
系統架構
技術堆疊
該解決方案使用了社區中成熟的技術:
| 組件 | 版本 | 角色 |
|---|---|---|
| PostgreSQL | 18.1 | 主資料庫引擎 |
| 派特羅尼 | 4.1.0 | HA 編排與自動故障轉移 |
| 等 | 3.5.25 | 分散式配置儲存 |
| 保鑣 | 1.25.0 | 連接池層 |
| 安西布爾 | 2.12+ | 基礎設施自動化 |
整體架構
┌─────────────────────────────────────┐
│       Application Layer             │
│  (Spring Boot / Django / Node.js)   │
└──────────────┬──────────────────────┘
               │ Port 6432 (PgBouncer)
        ┌──────┴──────┬──────────┐
        ▼             ▼          ▼
   ┌────────┐    ┌────────┐   ┌────────┐
   │PgBouncer│   │PgBouncer│  │PgBouncer│
   │Node 1   │   │Node 2   │  │Node 3   │
   └────┬───┘    └────┬───┘   └────┬───┘
        │ Port 5432   │             │
   ┌────▼────┐   ┌───▼────┐   ┌────▼────┐
   │PostgreSQL│  │PostgreSQL│ │PostgreSQL│
   │ PRIMARY │  │ REPLICA  │ │ REPLICA  │
   │Read/Write│  │Read Only│ │Read Only │
   └────┬────┘   └────┬────┘  └────┬────┘
        │ Port 8008   │             │
   ┌────▼────┐   ┌────▼────┐  ┌────▼────┐
   │ Patroni │   │ Patroni │  │ Patroni │
   │HA Mgr   │   │HA Mgr   │  │ HA Mgr  │
   └────┬────┘   └────┬────┘  └────┬────┘
        │ Port 2379   │             │
        └──────┬──────┴─────────────┘
               ▼
        ┌──────────────────┐
        │   etcd Cluster   │
        │ (Leader Election)│
        └──────────────────┘
成分說明
PgBouncer層:部署在每個節點上,提供連線池。應用程式可以連接到任何節點,減少單點故障和網路延遲。
PostgreSQL 叢集:使用具有一個主節點(讀/寫)和兩個副本節點(唯讀)的串流複製。 Patroni 管理集群的整個生命週期。
派特羅尼:充當HA編排器,執行持續的健康檢查,當主伺服器發生故障時自動進行故障轉移,並透過分散式共識確保資料一致性。
etcd集群:儲存叢集配置並執行領導者選舉。確保一次只有一個主節點,避免出現裂腦狀況。
為什麼是 3 個節點?
3 個節點的數量是 HA 群集的最少數量,因為:
- 法定人數:etcd 至少需要 3 個節點才能達到法定人數 (2/3),並且可以容忍 1 個節點故障
- 成本效益:足以保證HA,無需在基礎設施上花費太多
- 經過驗證的模式: 是 PostgreSQL 和 etcd 社群推薦的標準數量
實施指南
系統需求
硬體(每個節點)
實驗室/開發環境的最低要求:
- CPU:2核心
- 記憶體:4GB
- 磁碟:20 GB(作業系統)+ 20 GB(資料)
- 網路:1 Gbps
推薦用於生產:
- CPU:4-8核
- 記憶體:16-32 GB
- 磁碟:50 GB SSD(作業系統)+ 100+ GB NVMe SSD(資料)
- 網路:10 Gbps
軟體
控制節點(運行 Ansible 的機器):
- 安塞布爾 >= 2.12
- Python >= 3.9
目標節點:
- Ubuntu 22.04 LTS / Debian 12 / Rocky Linux 9
- 使用 root 或 sudo 權限進行 SSH 訪問
- 已安裝 Python 3.x
實施步驟
第 1 步:準備儲存庫
git clone https://github.com/xdev-asia-labs/postgres-patroni-etcd-install.git
cd postgres-patroni-etcd-install
步驟2:配置環境
從範本建立設定檔:
cp .env.example .env
編輯重要參數:
# Địa chỉ IP của các nodes NODE1_IP=10.0.0.11 NODE2_IP=10.0.0.12 NODE3_IP=10.0.0.13Mật khẩu PostgreSQL (bắt buộc phải thay đổi)
POSTGRESQL_SUPERUSER_PASSWORD=your_strong_password_here POSTGRESQL_REPLICATION_PASSWORD=your_replication_password_here
Performance tuning (ví dụ cho server 16GB RAM)
POSTGRESQL_SHARED_BUFFERS=4GB POSTGRESQL_EFFECTIVE_CACHE_SIZE=12GB POSTGRESQL_MAX_CONNECTIONS=100 PGBOUNCER_MAX_CLIENT_CONN=1000
第 3 步:配置庫存
編輯 庫存/hosts.yml:
all:
children:
postgres:
hosts:
pg-node1:
ansible_host: 10.0.0.11
patroni_name: node1
第四步:部署集群
# Load environment variables set -a && source .env && set +aDeploy cluster
ansible-playbook playbooks/site.yml -i inventory/hosts.yml
第 5 步:驗證
ssh [email protected] "patronictl -c /etc/patroni/patroni.yml list"
突出特點
配置即程式碼
所有設定都在文件中管理 .env 具有 70 多個變量,有助於:
- 輕鬆管理和審核配置
- 只需交換文件即可在環境之間切換
.env - 更好的安全性
.gitignore對於敏感數據 - 對開發人員友好,無需深入了解 Ansible
連接池
PgBouncer 配置為優化連線:
- 13:1 復用比(3000 個客戶端 → 225 個後端連接)
- 具有多主機支援的自動故障轉移
- 減少 PostgreSQL 上的記憶體和 CPU 開銷
零停機操作
計畫切換:規劃主節點遷移,停機時間僅2-5秒。
自動故障轉移:當主資料庫發生故障時,30-45 秒內自動進行故障轉移。
捲動更新:更新配置或版本而不影響服務可用性。
持續集成/持續交付管道
自動驗證
GitHub Actions 自動驗證每個變更:
- YAML 語法檢查
- Ansible 劇本驗證
- 安全掃描(Trivy、TruffleHog)
- 代碼品質檢查
發布自動化
建立新標籤(v1.0.0)時,GitHub Actions 會自動:
- 從 git 歷史記錄產生變更日誌
- 建立發布檔案
- 發布帶有文件的 GitHub 版本
效能
在具有 3 個節點的測試環境中(16GB RAM,每個節點 5 個核心):
- 讀取QPS:50,000-100,000
- 寫入QPS:10,000-20,000
- 故障轉移時間:30-45秒
- 連線容量:3,000 個客戶端
- 查詢延遲:<5ms(簡單查詢)
經驗教訓
1.使用經過驗證的工具
我們沒有發展自己的技術,而是使用經過驗證的技術,例如 Patroni、etcd 和 PgBouncer。這有助於專注於自動化,而不是重新發明輪子。
2. 配置即程式碼
外部化配置 .env 檔案而不是劇本中的硬編碼可以輕鬆針對不同環境進行自訂和維護。
3.安全第一
從一開始就始終優先考慮安全性:
- 使用
.gitignore對於敏感文件 - 產生強密碼
- 自動配置防火牆規則
- 將安全掃描整合到 CI 中
4. 文件事宜
良好的文件可以減少入職時間並展示專案的專業性。我們保留英語和越南語的完整文件。
路線圖
開發中的特點:
- 整合 Prometheus/Grafana 監控
- 使用 pgBackRest 自動備份
- Terraform 支援雲端部署
- Docker/Kubernetes 部署選項
- 多區域複製
什麼時候應該使用它?
適合:
- 應用程式需要高可用性(正常運行時間 > 99.9%)
- 系統不能容忍長時間停機
- 具有多個並發連接的多租戶應用程式
- 團隊應用基礎架構即程式碼
在以下情況下不需要:
- 開發/測試環境簡單
- 低流量應用
- 應用程式可以接受偶爾的停機
- 預算限制(至少需要 3 台伺服器)
結論
使用正確的工具和方法,建立 PostgreSQL 高可用性叢集不再是一個巨大的挑戰。該解決方案已在生產中得到驗證,有助於確保許多重要係統的正常運作時間。
借助這套 Ansible playbook,您可以在 10 分鐘內部署一個生產就緒的集群,實現超過 99.9% 的正常運行時間,並根據基礎設施即程式碼方法管理基礎設施。
貢獻
如果您發現該項目有用:
- ⭐ 明星庫
- 🐛 報告問題
- 💬 分享回饋
- 🤝 貢獻程式碼
- 📢 與社區分享