Kubernetes アーキテクチャ: 概要から詳細まで__HTMLTAG_1___
Kubernetes は、明確なマスター/ワーカー アーキテクチャを備えた分散モデルで設計されています。 Kubernetes を効果的に使用するには、特に問題が発生した場合にデバッグするには、各コンポーネントが何を行うのか、コンポーネントがどのように通信するのか、そしてなぜそのように設計されているのかを理解する必要があります。このレッスンでは、containerd 2.0 の重要な変更、kube-proxy の nftables モード、cgroup v2 ロードマップを含む Kubernetes 1.32 以降のアーキテクチャについて詳しく説明します。
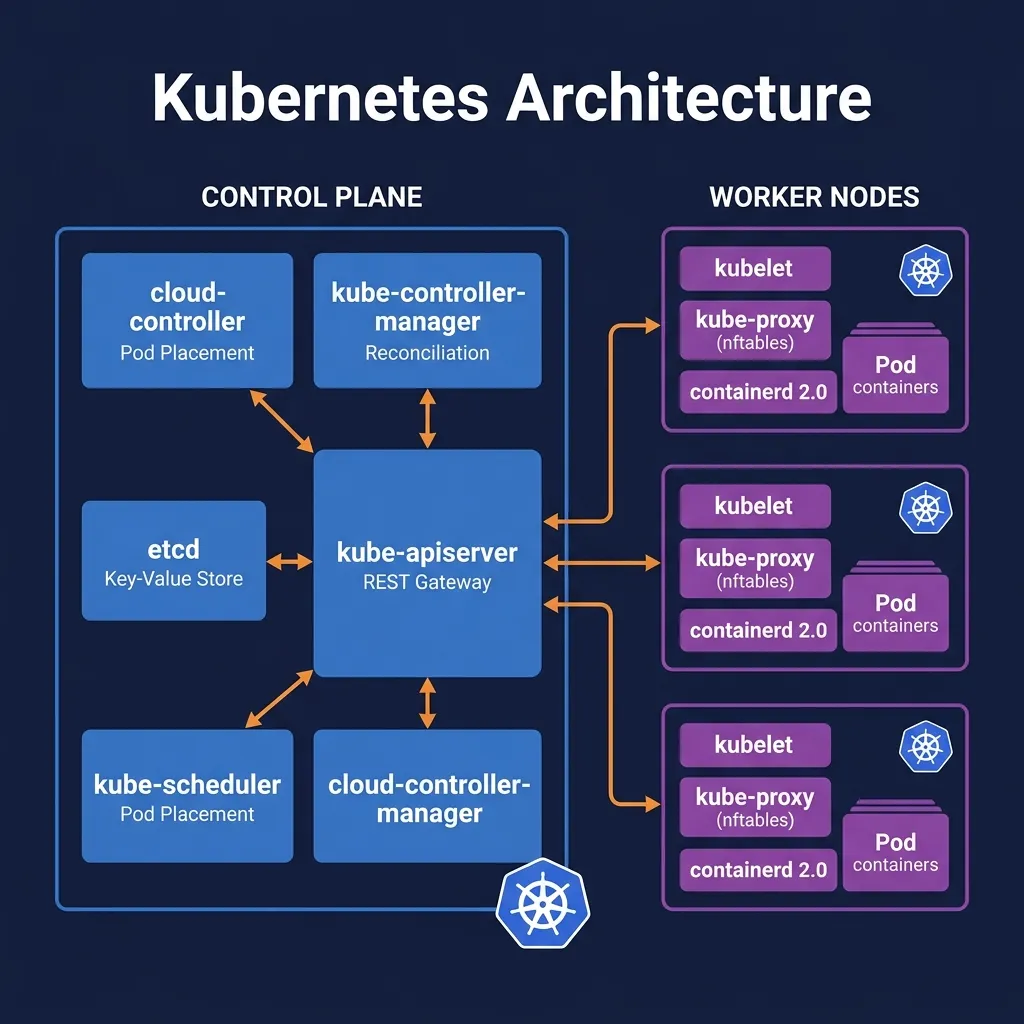
1.アーキテクチャの概要: コントロール プレーンとワーカー ノード
Kubernetes クラスターは、機能ノードの 2 つのグループに分割されます:
- コントロール プレーン (マスター ノード): クラスターの頭脳。ポッドを実行する場所のスケジュール設定、クラスター イベントの検出と応答、望ましい状態の維持など、グローバルな意思決定を担当します。
- ワーカー ノード: ワークロードが実際に実行される場所。各ノードには、ランタイム コンテナー、コントロール プレーンと通信する kubelet、ネットワークを処理する kube-proxy が含まれています。
実稼働環境では、高可用性 (HA) を確保するために、コントロール プレーンは通常、少なくとも 3 つの個別のノードにデプロイされます。 Kubernetes 1.32 以降では、GKE、EKS、AKS などのマネージド Kubernetes サービスはコントロール プレーンを完全に非表示にし、API 経由でのみ対話します。
コードブロック_0
2.コントロール プレーン コンポーネント
2.1. kube-apiserver — 単一インターフェイス
kube-apiserver は、コントロール プレーンの中心的なコンポーネントです。クラスター内のすべての通信 (開発者の kubectl、ワーカー ノードの kubelet、コントローラーから) は API サーバーを経由する必要があります。 kube-apiserver を除き、コンポーネントは etcd と直接通信できません。
kube-apiserver の主な機能:
- REST API ゲートウェイ: Kubernetes API グループ標準 (
core/v1、__HTMLTAG_37___apps/v1、networking.k8s.io/v1...) - 認証: ID 認証 — クライアント証明書、ベアラー トークン、OIDC、Webhook トークン認証をサポート__HTMLTAG_45___
- 認可: RBAC (ロールベースのアクセス制御)、ABAC、または Webhook モード経由でアクセス権を確認します
- アドミッション コントロール: オブジェクトが etcd に書き込まれる前に適用される、一連のアドミッション Webhook — 検証と変更 — が適用されます。
- API 集約: カスタム API サーバー (メトリクス サーバー、カスタム CRD) を使用した API 拡張を許可
コードブロック_1
Kube-apiserver はステートレスです。状態は保存されず、etcd に対して読み取り/書き込みのみが行われます。これにより、ロード バランサの背後で複数の API サーバー インスタンスを実行することにより、水平方向のスケーリングが可能になります。
2.2. etcd — クラスター メモリ
etcd は、Raft コンセンサス アルゴリズムを使用した分散型 Key-Value ストアです。これは、クラスターの状態全体が保存される唯一の場所です。すべての Pod、Service、ConfigMap、Secret、Node は、シリアル化された protobuf オブジェクトとしてここに保存されます。
Kubernetes の etcd の重要な機能:
- 強い一貫性: Raft は etcd クラスター内のすべてのノードが値に一致することを保証します - 「スプリット ブレイン」なし
- Watch API: クライアント (kube-apiserver を含む) は主要な変更を監視できます。これは Kubernetes が反応するための中心的なメカニズムです
- クォーラム要件: クラスターが動作するには過半数 (⌊in/2⌋ + 1) のアクティブ ノードが必要です。 etcd ノードが 3 つある場合、1 つのノードは許容されます。 5 つのノードを使用すると、2 つのノードの損失に耐えることができます
- etcd v3: etcd 3.5+ を使用した Kubernetes 1.32 で、パフォーマンスとリースベースの改善が施されています TTL
コードブロック_2
重要な注意: etcd データは定期的にバックアップする必要があります。 etcd の損失 = クラスター全体の状態の損失。マネージド Kubernetes では、クラウド プロバイダー自体がこれを処理します。
2.3. kube-scheduler — ポッド割り当てアルゴリズム
kube-scheduler は、どのポッドをどのノードで実行するかを決定する責任があります。ポッドを作成すると、kube-apiserver はステータス Pending (ノードがまだ割り当てられていません) でポッドを etcd に書き込みます。スケジューラはこれらのポッドを監視し、一致するノードを見つけます。
スケジュール設定プロセスは 2 つのステップで構成されます:
- フィルタリング (述語): 要件を満たさないノードを削除します - 十分な CPU/メモリが不足している、Pod が許容しない汚染のあるノード、一致しない NodeSelector、Pod アフィニティ/アンチアフィニティ制約...
- スコアリング (優先度): 多くの基準に従って残りのノードにスコアを付けます。リソースの使用量が最も少ないノード、必要なイメージを既に備えているノード (プル時間の短縮)、ポッド レプリカを均等に分散しているノード...
コードブロック_3
Kubernetes 1.32 以降は、__HTMLTAG_112___スケジューラー プロファイル をサポートしています。これにより、同じクラスター内の多様なワークロードに適した、異なるプラグイン セットを使用して複数のスケジューリング プロファイルを構成できます。
2.4. kube-controller-manager — 制御ループ
kube-controller-manager は一連のコントローラーを実行します。各コントローラーはクラスターの現在の状態を監視し、望ましい状態に戻すアクションを実行する制御ループです。これは、Kubernetes 宣言モデルの中心である__HTMLTAG_120___調整ループ パターン の実現です。
最も重要なコントローラ:
- _ReplicaSet コントローラー: ポッド レプリカの数が仕様と一致していることを確認します。ポッドが停止した場合、コントローラーは新しいポッドを作成します。
- デプロイメント コントローラー: デプロイメントのローリング アップデートの管理、ReplicaSet の作成/削除
- EndpointSlice コントローラー: ポッドの準備ができた/準備ができていないときに EndpointSlice を更新します (古い Endpoints コントローラーを置き換えます — Endpoints API は K8s 1.33 で非推奨になりました)
- _名前空間コントローラー: 名前空間が削除されたときにリソースをクリーンアップ
- ServiceAccount コントローラー: 新しい名前空間ごとにデフォルトの ServiceAccount を自動的に作成
- ノード コントローラー: ノードの健全性を監視し、到達不能な場合はノードを汚染し、猶予期間後にポッドを削除します
- ジョブ コントローラー: バッチ ジョブを管理し、完了を確認
- CronJob コントローラー: cron 式に従ってジョブをスケジュール
コードブロック_4
2.5。クラウド コントローラー マネージャー
kube-controller-manager とは別に、__HTMLTAG_162___cloud-controller-managerクラウド プロバイダー API と統合するコントローラーが含まれています:
- ノード コントローラー: クラウド プロバイダーをチェックしてノードが存在することを確認し、クラウド領域、インスタンス タイプなどのメタデータを取得します
- ルート コントローラー: クラウド インフラストラクチャでのネットワーク ルートの構成
- サービス コントローラー: サービス タイプ LoadBalancer を作成するときにクラウド ロード バランサーを作成/更新/削除します
オンプレミスまたはベアメタルを使用する場合、クラウドコントローラーマネージャーは必要ありません。
3.ワーカー ノード コンポーネント
3.1. kubelet — ノードごとのエージェント
kubelet は、各ワーカー ノードで実行されるエージェントです。 kubelet の仕事は、PodSpec を受信し、そこに記述されているコンテナが実行中で正常であることを確認することです。
_Kubelet は次のメカニズムに従って動作します:
- kube-apiserver を監視してノードに割り当てられた PodSpecs を受信
- __HTMLTAG_195___CRI (コンテナ ランタイム インターフェイス) — 標準化された gRPC インターフェイス__HTMLTAG_197___ を介してランタイム コンテナと通信します。
- ノードのステータスとポッドのステータスを API サーバーに報告します
- liveness/readiness/startup プローブを実行
- ボリュームのマウント、イメージのプル、ネットワーク名前空間のセットアップ__HTMLTAG_203___
- cgroup v2 を通じてリソース制限を管理
コードブロック_5
3.2. kube-proxy — ネットワーク ルール エンジン (nftables モード)
kube-proxy は各ノードで実行され、Kubernetes Services ネットワーキングの実装を担当します。サービス VIP へのトラフィックが正しいポッド バックエンドに転送されるようにします。
kube-proxy モードの歴史:
- iptables モード (レガシー): iptables ルール チェーンを使用します。問題: 数千のサービスがあるため、iptables ルールは非常に大きく、更新が遅い
- IPVS モード: カーネル内のレイヤー 4 ロード バランサー。 IPVS モード Kubernetes 1.35 では非推奨 であり、将来削除される予定
- nftables モード (K8s 1.31 以降の現在のデフォルト): nftables を使用します — iptables を置き換える新しい Linux フレームワーク。より効率的で、デバッグが容易で、最新のカーネルでのサポートが向上
コードブロック_6
注: 最新のクラスターの多くは、Cilium などの CNI プラグインを使用して kube-proxy を完全に置き換えており (Cilium の kube-proxy の置き換えには eBPF が使用されています)、パフォーマンスと可観測性が向上しています。
3.3.コンテナ ランタイム —containerd 2.0
_コンテナ ランタイムは、コンテナを実際に作成して実行するコンポーネントです。 Kubernetes は、__HTMLTAG_238___CRI (コンテナ ランタイム インターフェイス).
を介してランタイムと通信します。_Docker を使用してみませんか?
Docker Engine はバージョン 1.24 の Kubernetes から削除されました (dockershim は削除されました)。 Docker は CRI をネイティブに実装していません。Kubernetes はブリッジングに shim レイヤー (dockershim) を使用する必要があります。代わりに:
- containerd: 公式ランタイム、Docker プロジェクトからフォーク、ネイティブ CRI サポート
- CRI-O: ランタイムの軽量化、Kubernetes の使用例に重点を置いた
containerd 2.0 (2024 年リリース) は重要な改善をもたらします:
- __HTMLTAG_263___cgroup v2 (Kubernetes 1.36 から必須) のネイティブ サポート
- サンドボックス API によるサンドボックス管理の改善
- より効率的な画像管理のための転送サービス
- 拡張カスタマイズ用の NRI (ノード リソース インターフェイス) プラグイン
- Zstd 画像圧縮のサポート — プルが大幅に高速化
- Windows コンテナを使用するとさらに効果的
コードブロック_7
3.4. cgroup v2 — 最新のリソース管理
cgroups (コントロール グループ) は、プロセス グループのリソース使用量を制限、優先順位付け、測定するための Linux カーネル機能です。 Kubernetes は cgroup を使用して、ポッドとコンテナに CPU/メモリ制限を適用します。
- cgroup v1: レガシー、各リソースには独自の階層 (CPU、メモリ、blkio...) があり、複雑で多くのエッジケースがあります__HTMLTAG_287___
- cgroup v2: 統合された階層、単一の cgroup ツリー、memory.oom.group によるメモリ管理の改善、圧力ストール情報 (PSI)
重要なスケジュール:
- Kubernetes 1.25: cgroup v2 安定版
- Kubernetes 1.35: cgroup v1 非推奨
- Kubernetes 1.36: cgroup v2 必須、cgroup v1 は削除
- Ubuntu 22.04+、RHEL 9+、Debian 11+ はデフォルトで cgroup v2 を使用します
コードブロック_8
4.ポッド作成フロー: kubectl からコンテナ
実際的な方法でアーキテクチャを理解するために、__HTMLTAG_314___kubectl apply -f pod.yaml:
を実行するときに発生するフローを追跡しましょう。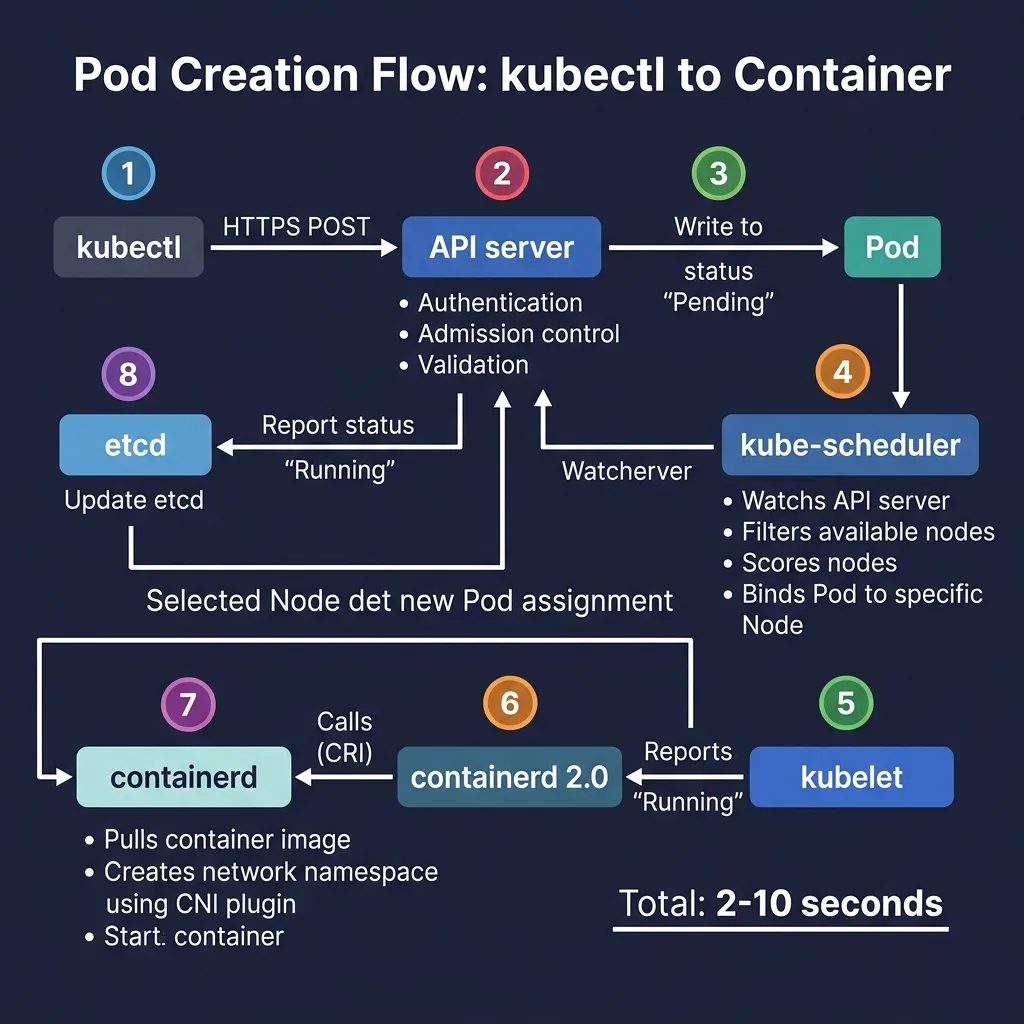
コードブロック_9
__HTMLTAG_319___kubectl apply の瞬間からコンテナが実際に実行される瞬間までのこのプロセス全体には、画像がキャッシュされているかどうかとネットワーク速度に応じて通常 2 ~ 10 秒かかります。
5.重要なアドオン
5.1. CoreDNS — サービスディスカバリ
CoreDNS はクラスター内で実行されている DNS サーバーであり、ポッドが IP:
ではなくドメイン名を使用してサービスや他のポッドを検索できるようにします。- 名前空間
my-svcのサービスmy-nsは、__HTMLTAG_336___my-svc.my-ns.svc.cluster.local で解決できます。
- ポッド間の DNS:
pod-ip.namespace.pod.cluster.local - _CoreDNS は必須の Kubernetes アドオンです — クラスターは DNS なしでは適切に機能しません
コードブロック_10
5.2. CNI プラグイン — コンテナ ネットワーク インターフェイス
CNI プラグインはポッド ネットワーキングを実装します。これにより、各ポッドが独自の IP を持ち、他のポッドと通信できるようになります。 Kubernetes にはネットワークが組み込まれていないため、CNI プラグインをインストールする必要があります。
2026 年の人気の CNI:
- Cilium: eBPF ベース、最高のパフォーマンス、組み込みのハッブル可観測性、kube プロキシの代替、高度なネットワーク ポリシー。これは、多くのマネージド K8s サービスのデフォルトの選択です。
- フランネル: シンプルで軽量、学習環境や開発環境に適しています
- _Calico: ルーティングに BGP を使用する強力なネットワーク ポリシー。オンプレミスの企業で人気
- Weave Net: シンプルなセットアップ、メッシュ ネットワーク
コードブロック_11
5.3. metrics-server — リソース メトリック
metrics-server は、各ノードの kubelet から CPU とメモリのメトリクスを収集し、水平ポッド オートスケーラー (HPA) とコマンド kubectl top.
コードブロック_12
6.高可用性コントロール プレーン
運用環境では、単一障害点を回避するためにコントロール プレーンに HA が必要です:
- 3 または 5 つのコントロール プレーン ノードkube-apiserver、kube-scheduler、kube-controller-manager を実行
- ロード バランサー kube-apiservers (HAProxy、クラウド LB、またはキープアライブを備えた仮想 IP) の前に
- etcd クラスター クォーラム (少なくとも 3 ノード) — スタック (同じコントロール プレーン ノード上) または外部 (別のノード上) で実行可能
- kube-scheduler と kube-controller-manager は リーダー選挙 を使用します — 一度に 1 つのインスタンスのみがアクティブになり、残りのインスタンスはスタンバイ__HTMLTAG_398___
コードブロック_13
7.概要と重要なポイント
Kubernetes アーキテクチャは重要な設計原則を反映しています:
- 関心事の分離: 各コンポーネントには明確な責任があり、標準 API を介して通信します。
- 宣言モデル: 望ましい状態を宣言すると、コントローラーがその状態への到達を処理します
- _唯一の信頼できる情報源: etcd は状態を保存する唯一の場所であり、すべてのコンポーネントがサーバー API を監視
- 拡張性: CRI、CNI、CSIは、コンポーネント(ランタイム、ネットワーク、ストレージ)の置き換えを可能にするインターフェースです
- 復元力: HA 設計により、ノードに障害が発生してもクラスターは動作し続けます
次の記事では、containerd 2.0、cgroup v2、および 2026 年の開発に必要なツールを備えた Kubernetes クラスターをインストールすることで、このアーキテクチャの知識を実践します。
コードブロック_14