Kiến Trúc Kubernetes: Từ Tổng Quan Đến Chi Tiết
Kubernetes được thiết kế theo mô hình phân tán với kiến trúc master-worker rõ ràng. Để sử dụng Kubernetes hiệu quả — và đặc biệt để debug khi có sự cố — bạn cần hiểu từng thành phần làm gì, giao tiếp với nhau ra sao, và tại sao chúng được thiết kế theo cách đó. Bài học này đi sâu vào kiến trúc Kubernetes 1.32+ với những thay đổi quan trọng trong containerd 2.0, nftables mode cho kube-proxy, và lộ trình cgroup v2.
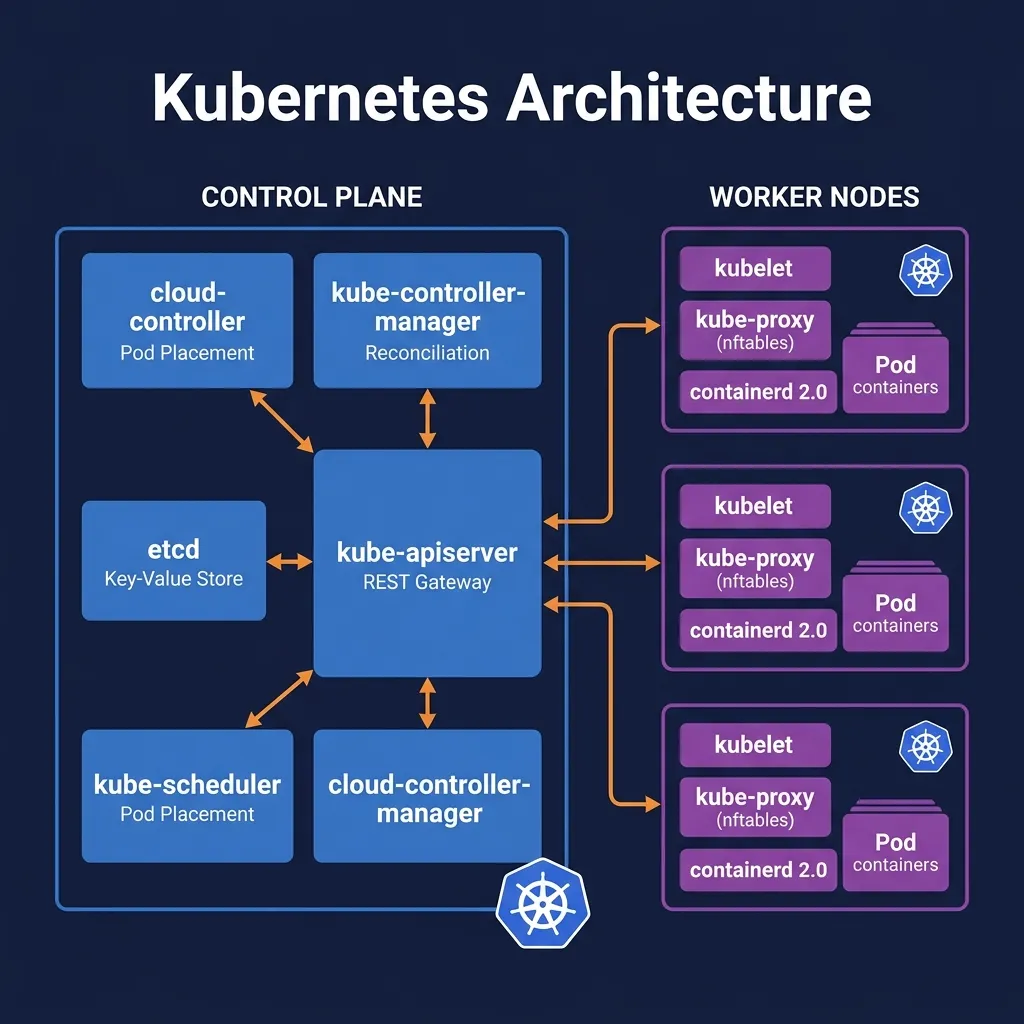
1. Tổng Quan Kiến Trúc: Control Plane và Worker Nodes
Một Kubernetes cluster được chia thành hai nhóm node chức năng:
- Control Plane (Master Node): Não bộ của cluster. Chịu trách nhiệm ra quyết định toàn cục — lên lịch chạy Pod ở đâu, phát hiện và phản hồi sự kiện cluster, duy trì trạng thái mong muốn.
- Worker Nodes: Nơi workload thực sự chạy. Mỗi node chứa container runtime, kubelet để giao tiếp với Control Plane, và kube-proxy để xử lý network.
Trong môi trường production, Control Plane thường được triển khai trên ít nhất 3 node riêng biệt để đảm bảo high availability (HA). Với Kubernetes 1.32+, các managed Kubernetes services như GKE, EKS, AKS đều ẩn hoàn toàn Control Plane — bạn chỉ tương tác qua API.
┌─────────────────────────────────────────────────────────────────┐
│                        CONTROL PLANE                            │
│                                                                 │
│  ┌─────────────────┐  ┌──────────┐  ┌──────────────────────┐   │
│  │  kube-apiserver │  │   etcd   │  │  kube-scheduler      │   │
│  │  (REST Gateway) │  │  (State) │  │  (Pod Placement)     │   │
│  └────────┬────────┘  └────┬─────┘  └──────────────────────┘   │
│           │               │                                     │
│  ┌────────┴───────────────┴──────────────────────────────────┐  │
│  │            kube-controller-manager                        │  │
│  │  (Replication / Endpoints / Namespace / SA controllers)   │  │
│  └───────────────────────────────────────────────────────────┘  │
│                                                                 │
│  ┌─────────────────────────────────────────────────────────┐    │
│  │          cloud-controller-manager (optional)            │    │
│  └─────────────────────────────────────────────────────────┘    │
└─────────────────────────────────────────────────────────────────┘
              │                    │                    │
     ┌────────┴──────┐    ┌────────┴──────┐    ┌───────┴───────┐
     │  WORKER NODE  │    │  WORKER NODE  │    │  WORKER NODE  │
     │               │    │               │    │               │
     │  kubelet      │    │  kubelet      │    │  kubelet      │
     │  kube-proxy   │    │  kube-proxy   │    │  kube-proxy   │
     │  containerd   │    │  containerd   │    │  containerd   │
     │  ┌─────────┐  │    │  ┌─────────┐  │    │  ┌─────────┐  │
     │  │  Pod A  │  │    │  │  Pod B  │  │    │  │  Pod C  │  │
     │  └─────────┘  │    │  └─────────┘  │    │  └─────────┘  │
     └───────────────┘    └───────────────┘    └───────────────┘
2. Control Plane Components
2.1. kube-apiserver — Cổng Giao Tiếp Duy Nhất
kube-apiserver là thành phần trung tâm của Control Plane. Mọi giao tiếp trong cluster — từ kubectl của developer, từ kubelet trên worker node, từ các controller — đều phải đi qua API server. Không có thành phần nào được phép giao tiếp trực tiếp với etcd, trừ kube-apiserver.
Các chức năng chính của kube-apiserver:
- REST API Gateway: Cung cấp RESTful API theo chuẩn Kubernetes API Groups (
core/v1,apps/v1,networking.k8s.io/v1...) - Authentication: Xác thực danh tính — hỗ trợ client certificates, Bearer tokens, OIDC, webhook token authentication
- Authorization: Kiểm tra quyền truy cập qua RBAC (Role-Based Access Control), ABAC, hoặc Webhook mode
- Admission Control: Một chuỗi các admission webhooks — validating và mutating — được áp dụng trước khi object được ghi vào etcd
- API Aggregation: Cho phép extend API bằng custom API servers (metrics-server, custom CRDs)
# Kiểm tra trạng thái kube-apiserver
kubectl get componentstatuses

# Xem logs của kube-apiserver (trên cluster tự quản lý)
kubectl logs -n kube-system kube-apiserver-controlplane

# Kiểm tra version API
kubectl api-versions | head -20

# Xem tất cả API resources
kubectl api-resources --sort-by=kind
Kube-apiserver là stateless — nó không lưu trữ state, chỉ đọc/ghi vào etcd. Điều này cho phép scale horizontal bằng cách chạy nhiều instance API server phía sau một load balancer.
2.2. etcd — Bộ Nhớ Của Cluster
etcd là distributed key-value store dùng thuật toán đồng thuận Raft. Đây là nơi duy nhất lưu trữ toàn bộ state của cluster — mọi Pod, Service, ConfigMap, Secret, Node, đều được lưu ở đây dưới dạng serialized protobuf objects.
Đặc điểm quan trọng của etcd trong Kubernetes:
- Strong consistency: Raft đảm bảo mọi node trong etcd cluster đồng ý về giá trị — không có "split brain"
- Watch API: Clients (bao gồm kube-apiserver) có thể watch key changes — đây là cơ chế cốt lõi để Kubernetes reactive
- Quorum requirement: Cần majority (⌊n/2⌋ + 1) nodes active để cluster hoạt động. Với 3 node etcd, chịu được mất 1 node; với 5 node, chịu được mất 2 node
- etcd v3: Kubernetes 1.32 dùng etcd 3.5+ với improvements về performance và lease-based TTL
# Xem etcd pod
kubectl get pod -n kube-system etcd-controlplane -o wide

# Backup etcd (critical trong production!)
ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot.db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# Kiểm tra etcd health
ETCDCTL_API=3 etcdctl endpoint health \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
Lưu ý quan trọng: etcd data phải được backup thường xuyên. Mất etcd = mất toàn bộ cluster state. Trong managed Kubernetes, cloud provider tự lo việc này.
2.3. kube-scheduler — Thuật Toán Phân Bổ Pod
kube-scheduler chịu trách nhiệm quyết định Pod nào sẽ chạy trên Node nào. Khi bạn tạo Pod, kube-apiserver ghi Pod vào etcd với trạng thái Pending (chưa có node được assign). Scheduler watch những Pod này và tìm node phù hợp.
Quá trình scheduling gồm hai bước:
- Filtering (Predicates): Loại bỏ các node không đáp ứng yêu cầu — không đủ CPU/Memory, node có taint mà Pod không tolerate, nodeSelector không khớp, Pod affinity/anti-affinity constraints...
- Scoring (Priorities): Chấm điểm các node còn lại theo nhiều tiêu chí — node có ít resource sử dụng nhất, node đã có image cần thiết (giảm pull time), node phân bổ đều các Pod replicas...
# Xem scheduler logs
kubectl logs -n kube-system kube-scheduler-controlplane

# Xem events liên quan đến scheduling
kubectl get events --field-selector reason=Scheduled

# Xem tại sao Pod không được schedule
kubectl describe pod  | grep -A 10 Events

# Kiểm tra resource usage trên nodes
kubectl describe nodes | grep -A 5 "Allocated resources"
Kubernetes 1.32+ hỗ trợ Scheduler Profiles — cho phép cấu hình nhiều scheduling profiles với plugin sets khác nhau, phù hợp cho workload đa dạng trong cùng cluster.
2.4. kube-controller-manager — Vòng Lặp Điều Khiển
kube-controller-manager chạy một tập hợp các controllers — mỗi controller là một control loop theo dõi state hiện tại của cluster và thực hiện hành động để đưa về state mong muốn (desired state). Đây là hiện thực hóa của reconciliation loop pattern — trái tim của Kubernetes declarative model.
Các controller quan trọng nhất:
- ReplicaSet Controller: Đảm bảo số lượng Pod replicas đúng với spec. Nếu Pod chết, controller tạo Pod mới.
- Deployment Controller: Quản lý rolling updates cho Deployments, tạo/xóa ReplicaSets
- EndpointSlice Controller: Cập nhật EndpointSlices khi Pod ready/not-ready (thay thế Endpoints controller cũ — Endpoints API deprecated K8s 1.33)
- Namespace Controller: Dọn dẹp resources khi namespace bị xóa
- ServiceAccount Controller: Tự động tạo default ServiceAccount cho mỗi namespace mới
- Node Controller: Monitor node health, taint nodes khi unreachable, evict Pods sau grace period
- Job Controller: Quản lý batch jobs, đảm bảo completion
- CronJob Controller: Schedule Jobs theo cron expression
# Xem controller-manager logs
kubectl logs -n kube-system kube-controller-manager-controlplane

# Xem events do controllers tạo ra
kubectl get events -A --sort-by='.lastTimestamp' | tail -20
2.5. cloud-controller-manager
Tách biệt khỏi kube-controller-manager, cloud-controller-manager chứa các controllers tích hợp với cloud provider APIs:
- Node Controller: Check cloud provider để xác nhận node có tồn tại không, lấy metadata như cloud region, instance type
- Route Controller: Cấu hình network routes trong cloud infrastructure
- Service Controller: Tạo/cập nhật/xóa cloud load balancers khi bạn tạo Service type LoadBalancer
Khi dùng on-premises hoặc bare metal, không cần cloud-controller-manager.
3. Worker Node Components
3.1. kubelet — Đại Lý Trên Mỗi Node
kubelet là agent chạy trên mỗi Worker Node. Nhiệm vụ của kubelet là nhận PodSpecs và đảm bảo các containers được mô tả trong đó đang chạy và healthy.
Kubelet hoạt động theo cơ chế:
- Watch kube-apiserver để nhận PodSpecs được assign cho node của mình
- Giao tiếp với container runtime qua CRI (Container Runtime Interface) — một gRPC interface chuẩn hóa
- Báo cáo node status và Pod status ngược lại lên API server
- Chạy liveness/readiness/startup probes
- Mount volumes, pull images, setup networking namespace
- Quản lý resource limits thông qua cgroup v2
# Xem trạng thái kubelet service
systemctl status kubelet

# Kubelet logs
journalctl -u kubelet -f

# Xem node conditions do kubelet báo cáo
kubectl describe node  | grep -A 20 Conditions

# Kiểm tra resource capacity và allocatable
kubectl get node  -o jsonpath='{.status.allocatable}'
3.2. kube-proxy — Network Rules Engine (nftables Mode)
kube-proxy chạy trên mỗi node và chịu trách nhiệm implement Kubernetes Services networking — đảm bảo traffic đến Service VIP được forward đến đúng Pod backend.
Lịch sử các mode của kube-proxy:
- iptables mode (legacy): Dùng iptables rules chain. Vấn đề: với hàng nghìn Services, iptables rules rất lớn và slow to update
- IPVS mode: Layer 4 load balancer trong kernel. IPVS mode deprecated trong Kubernetes 1.35 và sẽ bị removed trong tương lai
- nftables mode (current default từ K8s 1.31): Dùng nftables — Linux framework mới thay thế iptables. Hiệu quả hơn, dễ debug hơn, hỗ trợ tốt hơn trên kernel hiện đại
# Xem kube-proxy mode hiện tại
kubectl get configmap -n kube-system kube-proxy -o yaml | grep mode

# Xem kube-proxy logs
kubectl logs -n kube-system -l k8s-app=kube-proxy

# Kiểm tra nftables rules (khi dùng nftables mode)
nft list ruleset | grep -A 5 "KUBE-"

# Xem services và endpoints
kubectl get services -A
kubectl get endpointslices -A
Lưu ý: Nhiều clusters hiện đại dùng CNI plugins như Cilium thay thế hoàn toàn kube-proxy (Cilium's kube-proxy replacement dùng eBPF), cho performance tốt hơn và observability cao hơn.
3.3. Container Runtime — containerd 2.0
Container runtime là thành phần thực sự tạo và chạy containers. Kubernetes giao tiếp với runtime qua CRI (Container Runtime Interface).
Tại sao không dùng Docker?
Docker Engine được remove khỏi Kubernetes trong version 1.24 (dockershim removed). Docker không native implement CRI — Kubernetes phải dùng một shim layer (dockershim) để bridge. Thay vào đó:
- containerd: Runtime chính thức, được tách ra từ Docker project, native CRI support
- CRI-O: Runtime nhẹ hơn, tập trung cho Kubernetes use case
containerd 2.0 (released 2024) mang những cải tiến quan trọng:
- Native support cho cgroup v2 (bắt buộc từ Kubernetes 1.36)
- Improved sandbox management với Sandbox API
- Transfer service cho image management hiệu quả hơn
- NRI (Node Resource Interface) plugins cho extended customization
- Zstd image compression support — pull nhanh hơn đáng kể
- Tốt hơn với Windows containers
# Kiểm tra container runtime trên node
kubectl get node  -o jsonpath='{.status.nodeInfo.containerRuntimeVersion}'

# Xem containers đang chạy qua containerd CLI
crictl ps

# Xem images
crictl images

# Kiểm tra containerd version
containerd --version

# Xem containerd logs
journalctl -u containerd -f
3.4. cgroup v2 — Resource Management Hiện Đại
cgroups (control groups) là Linux kernel feature để giới hạn, ưu tiên, và đo lường resource usage của process groups. Kubernetes dùng cgroups để enforce CPU/memory limits trên Pods và containers.
- cgroup v1: Legacy, mỗi resource có hierarchy riêng biệt (cpu, memory, blkio...), phức tạp và có nhiều edge cases
- cgroup v2: Unified hierarchy, một cgroup tree duy nhất, improved memory management với memory.oom.group, pressure stall information (PSI)
Timeline quan trọng:
- Kubernetes 1.25: cgroup v2 stable
- Kubernetes 1.35: cgroup v1 deprecated
- Kubernetes 1.36: cgroup v2 bắt buộc, cgroup v1 removed
- Ubuntu 22.04+, RHEL 9+, Debian 11+ đã mặc định dùng cgroup v2
# Kiểm tra cgroup version đang dùng
stat -fc %T /sys/fs/cgroup
# Kết quả: "cgroup2fs" = v2, "tmpfs" = v1

# Xem cgroup của một container cụ thể
cat /proc/$(crictl inspect  | jq '.info.pid')/cgroup

# Xem memory stats qua cgroup v2
cat /sys/fs/cgroup/kubepods.slice/memory.stat
4. Luồng Tạo Pod: Từ kubectl Đến Container
Để hiểu kiến trúc một cách thực tế, hãy trace luồng xảy ra khi bạn chạy kubectl apply -f pod.yaml:
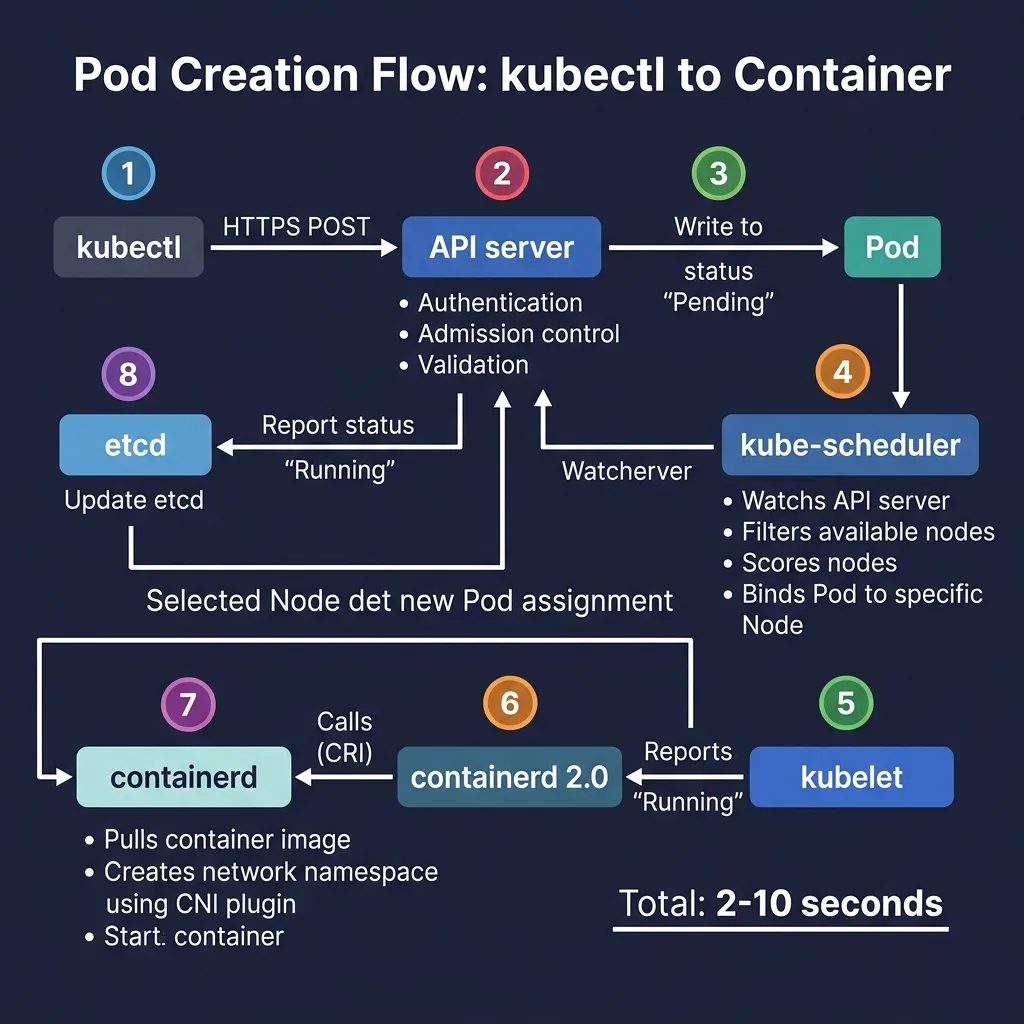
┌──────────┐    1. HTTPS POST /api/v1/pods     ┌────────────────┐
│ kubectl  │ ─────────────────────────────────► │ kube-apiserver │
└──────────┘                                    └───────┬────────┘
                                                        │
                                         2. Auth + Admission + Validate
                                                        │
                                         3. Write Pod (Pending) to etcd
                                                        │
                                                ┌───────▼────────┐
                                                │      etcd      │
                                                └───────┬────────┘
                                                        │
                                         4. API server notifies watchers
                                                        │
                          ┌─────────────────────────────┼──────────────────┐
                          │                             │                  │
                   ┌──────▼───────┐           ┌─────────▼──────────┐      │
                   │ kube-        │           │ kube-controller-   │      │
                   │ scheduler    │           │ manager            │      │
                   └──────┬───────┘           └────────────────────┘      │
                          │                                                │
               5. Filter + Score nodes                                     │
               6. Bind Pod to Node-1                                       │
               7. Write binding to etcd                                    │
                          │                                                │
                   ┌──────▼───────┐                                       │
                   │ kube-apiserver│ (notifies kubelet on Node-1)          │
                   └──────┬───────┘                                       │
                          │                                                │
                   ┌──────▼───────┐                                       │
                   │ kubelet       │ (on Node-1)                          │
                   │ (watches API) │                                       │
                   └──────┬───────┘                                       │
                          │                                                │
               8. kubelet calls containerd via CRI                         │
                          │                                                │
                   ┌──────▼───────┐                                       │
                   │  containerd  │                                       │
                   └──────┬───────┘                                       │
                          │                                                │
               9. Pull image (if not cached)                               │
               10. Create network namespace                                 │
               11. Call CNI plugin to setup networking                     │
               12. Start container process                                  │
                          │                                                │
               13. kubelet reports Pod Running to API server               │
                          │                                                │
                   ┌──────▼───────┐                                       │
                   │ kube-apiserver│ ─── 14. Update Pod status in etcd ──►│
                   └──────────────┘                                       │
Toàn bộ quá trình này, từ lúc kubectl apply đến lúc container thực sự running, thường mất từ 2-10 giây tùy vào việc image đã được cache chưa và tốc độ network.
5. Add-ons Quan Trọng
5.1. CoreDNS — Service Discovery
CoreDNS là DNS server chạy trong cluster, cho phép Pods tìm thấy Services và Pods khác qua tên miền thay vì IP:
- Service
my-svctrong namespacemy-nscó thể được resolve bằng:my-svc.my-ns.svc.cluster.local - Pod-to-Pod DNS:
pod-ip.namespace.pod.cluster.local - CoreDNS là chương trình Kubernetes add-on bắt buộc — cluster không thể hoạt động bình thường mà không có DNS
# Xem CoreDNS pods
kubectl get pods -n kube-system -l k8s-app=kube-dns

# Kiểm tra DNS resolution từ trong Pod
kubectl run dns-test --image=busybox:1.36 --rm -it --restart=Never -- \
  nslookup kubernetes.default.svc.cluster.local

# Xem CoreDNS config
kubectl get configmap -n kube-system coredns -o yaml
5.2. CNI Plugin — Container Network Interface
CNI plugins implement pod networking — đảm bảo mỗi Pod có IP riêng và có thể giao tiếp với Pods khác. Kubernetes không có built-in networking — bạn phải cài một CNI plugin.
Các CNI phổ biến năm 2026:
- Cilium: eBPF-based, performance cao nhất, built-in Hubble observability, kube-proxy replacement, network policies nâng cao. Đây là lựa chọn mặc định của nhiều managed K8s services.
- Flannel: Đơn giản, nhẹ, phù hợp cho học tập và dev environments
- Calico: Network policies mạnh, dùng BGP cho routing, phổ biến trong on-premises enterprise
- Weave Net: Simple setup, mesh networking
# Kiểm tra CNI đang dùng
ls /etc/cni/net.d/
cat /etc/cni/net.d/10-flannel.conflist

# Với Cilium
kubectl get pods -n kube-system -l k8s-app=cilium
cilium status
5.3. metrics-server — Resource Metrics
metrics-server thu thập CPU và memory metrics từ kubelet trên mỗi node, phục vụ cho Horizontal Pod Autoscaler (HPA) và lệnh kubectl top.
# Cài metrics-server
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml

# Sau khi cài, xem resource usage
kubectl top nodes
kubectl top pods -A --sort-by=cpu
6. High Availability Control Plane
Trong production, Control Plane cần HA để tránh single point of failure:
- 3 hoặc 5 control plane nodes chạy kube-apiserver, kube-scheduler, kube-controller-manager
- Load balancer phía trước các kube-apiserver (HAProxy, cloud LB, hoặc virtual IP với keepalived)
- etcd cluster với quorum (ít nhất 3 nodes) — có thể chạy stacked (trên cùng control plane nodes) hoặc external (trên nodes riêng)
- kube-scheduler và kube-controller-manager dùng leader election — chỉ một instance active tại một thời điểm, các instance còn lại standby
# Kiểm tra leader election
kubectl get endpoints -n kube-system kube-scheduler -o yaml
kubectl get endpoints -n kube-system kube-controller-manager -o yaml

# Xem tất cả control plane components
kubectl get pods -n kube-system | grep -E 'apiserver|etcd|scheduler|controller'
7. Tổng Kết và Key Takeaways
Kiến trúc Kubernetes phản ánh các design principles quan trọng:
- Separation of concerns: Mỗi component có trách nhiệm rõ ràng, giao tiếp qua API chuẩn
- Declarative model: Bạn khai báo state mong muốn, controllers lo việc đạt đến state đó
- Single source of truth: etcd là nơi duy nhất lưu state, mọi component đều watch API server
- Extensibility: CRI, CNI, CSI là các interfaces cho phép thay thế components (runtime, network, storage)
- Resilience: HA design cho phép các node fail mà cluster vẫn hoạt động
Trong bài tiếp theo, chúng ta sẽ đưa kiến thức kiến trúc này vào thực tế bằng cách cài đặt một Kubernetes cluster hoàn chỉnh với containerd 2.0, cgroup v2, và các công cụ cần thiết cho phát triển năm 2026.
# Quick health check của một cluster
kubectl get componentstatuses  # Deprecated nhưng vẫn hữu ích
kubectl get nodes -o wide
kubectl get pods -n kube-system
kubectl cluster-info