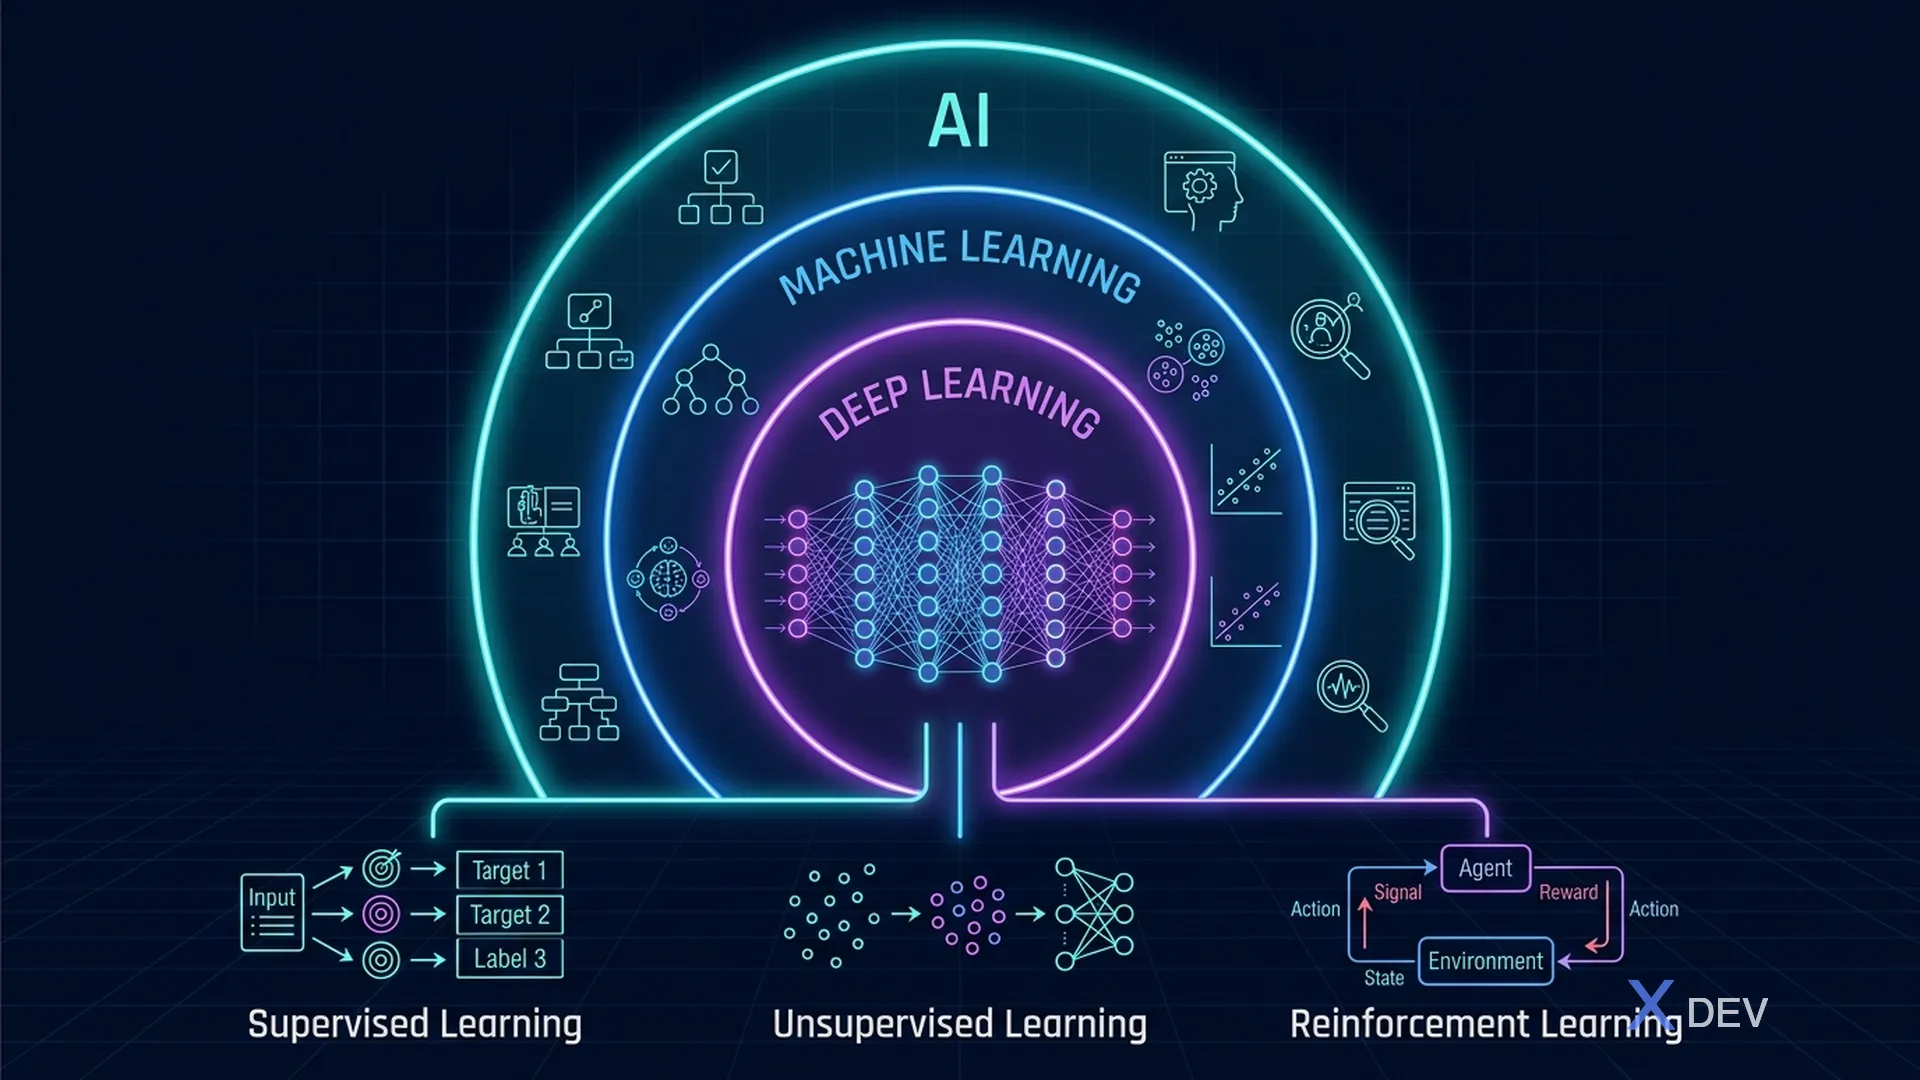
AI、ML、ディープラーニング — 入れ子構造と3つの機械学習パラダイム
ドメイン1の概要
ドメイン1はAIF-C01試験の20%を占めます。AI、ML、ディープラーニングの基本概念を理解する必要があります。コーディングは不要ですが、どのアプローチをいつ使用すべきかを見分けられる必要があります。
試験のコツ:このドメインでは「~に最も適した機械学習の種類はどれか」のような問題がよく出題されます。ユースケースに応じて適切なパラダイムを選択する必要があります。
1. AI vs 機械学習 vs ディープラーニング
これら3つの概念には入れ子の関係があります:
┌─────────────────────────────────────────────┐
│  人工知能(AI)                               │
│  「人間の知能を模倣する機械」                    │
│  ┌───────────────────────────────────────┐   │
│  │  機械学習(ML)                        │   │
│  │  「明示的なプログラミングなしに            │   │
│  │   データから学習」                       │   │
│  │  ┌─────────────────────────────────┐  │   │
│  │  │  ディープラーニング(DL)          │  │   │
│  │  │  「多層のニューラルネットワーク」    │  │   │
│  │  └─────────────────────────────────┘  │   │
│  └───────────────────────────────────────┘   │
└─────────────────────────────────────────────┘
| 概念 | 定義 | 例 |
|---|---|---|
| AI | 広範な分野 — 通常は人間の知能を必要とするタスクを機械が実行 | チャットボット、自動運転車、チェスエンジン |
| ML | AIのサブセット — アルゴリズムがデータからパターンを学習 | スパムフィルター、レコメンドエンジン |
| DL | MLのサブセット — 多層のニューラルネットワーク | 画像認識、言語翻訳 |
試験における主な違い
- 従来のプログラミング:ルール + データ → 出力
- 機械学習:データ + 出力 → ルール(モデルがルールを学習)
- ディープラーニング:生データから自動的に特徴を抽出(手動の特徴量エンジニアリング不要)
2. 3つのMLパラダイム
2.1. 教師あり学習
モデルはラベル付きデータから学習します。各入力には正解の出力(ラベル/ターゲット)が付属しています。
| タスクの種類 | 出力 | ユースケース | アルゴリズム |
|---|---|---|---|
| 分類 | 離散的なカテゴリ | スパム vs 非スパム、不正検出 | ロジスティック回帰、ランダムフォレスト、SVM |
| 回帰 | 連続的な数値 | 住宅価格予測、株価予測 | 線形回帰、XGBoost |
試験のコツ:問題文に「カテゴリを予測」「分類」とあれば → 分類。「数値を予測」とあれば → 回帰。
2.2. 教師なし学習
モデルはラベルなしデータから学習します。データ中のパターンや構造を自ら発見します。
| タスクの種類 | 内容 | ユースケース |
|---|---|---|
| クラスタリング | 類似するデータポイントをグループ化 | 顧客セグメンテーション、文書のグループ化 |
| 次元削減 | 情報を保持しつつ特徴量を削減 | データの可視化、ノイズ除去 |
| 異常検出 | 異常なデータポイントを発見 | 不正検出、機器の故障 |
| アソシエーション | アイテム間のルールを発見 | 「Xを買った顧客はYも買った」 |
2.3. 強化学習(RL)
エージェントが環境内で試行錯誤を通じて学習します。各アクションに対して報酬(正)またはペナルティ(負)を受け取ります。
エージェント → アクション → 環境 → 状態 + 報酬 → エージェント(ループ)
ユースケース:
- ゲームAI(AlphaGo)
- ロボティクスのナビゲーション
- 自動運転
- AWS DeepRacer(自動運転カーシミュレーション)
2.4. 適切なパラダイムの選択 — 試験用決定木
ラベル付きデータがあるか?
├── はい → 教師あり学習
│   ├── カテゴリを予測? → 分類
│   └── 数値を予測? → 回帰
├── いいえ →
│   ├── グループやパターンを発見したい? → 教師なし(クラスタリング)
│   └── 試行錯誤で学習? → 強化学習
3. MLのデータ概念
3.1. データ型
| 型 | 説明 | 例 |
|---|---|---|
| 構造化 | 行と列で整理(表形式) | CSV、データベーステーブル、スプレッドシート |
| 半構造化 | ある程度の構造はあるが柔軟 | JSON、XML、ログファイル |
| 非構造化 | 事前定義されたフォーマットなし | 画像、動画、音声、自由テキスト |
| 時系列 | 時間でインデックスされたデータポイント | 株価、IoTセンサーの読み取り |
3.2. ラベル付き vs ラベルなしデータ
- ラベル付きデータ:各データポイントに正解(ラベル)が付属。例:メール + タグ「スパム」/「非スパム」。教師あり学習に使用。
- ラベルなしデータ:データのみでラベルなし。教師なし学習に使用。
- Amazon SageMaker Ground Truth:データのラベリングを支援するAWSサービス(人間 + ML支援によるラベリング)。
3.3. 訓練・検証・テストセット
┌────────────────────────────────────────────────┐
│              全データセット(100%)                │
├──────────────────┬──────────┬──────────────────┤
│  訓練(70%)      │ 検証(15%)│   テスト(15%)    │
│  モデルがこの     │ ハイパー  │ 最終評価           │
│  データから学習   │ パラメータ│ (訓練中に一度も   │
│                  │ の調整   │  見ていないデータ)  │
└──────────────────┴──────────┴──────────────────┘
- 訓練セット:モデルがこのデータからパターンを学習
- 検証セット:ハイパーパラメータの調整と過学習防止に使用
- テストセット:最終評価 — モデルが一度も見たことのないデータ
4. ニューラルネットワークの基礎
4.1. アーキテクチャ
入力層 → 隠れ層 → 出力層
    x₁ ──┐     ┌── h₁ ──┐
    x₂ ──┼─────┼── h₂ ──┼──── ŷ(予測)
    x₃ ──┘     └── h₃ ──┘

各接続には重み(w)がある
各ニューロンは活性化関数を適用
主要コンポーネント:
- 重み:訓練中にモデルが学習するパラメータ
- バイアス:活性化関数をシフトさせる追加パラメータ
- 活性化関数:ReLU、Sigmoid、Softmax — 非線形性を導入
- 損失関数:モデルの予測がどれだけ間違っているかを測定
- オプティマイザ:損失を最小化するために重みを更新(例:SGD、Adam)
4.2. ニューラルネットワークの種類
| 種類 | 最適な用途 | AWSサービス |
|---|---|---|
| CNN(畳み込みNN) | 画像、動画 | Amazon Rekognition |
| RNN/LSTM(再帰NN) | 系列データ、時系列 | Amazon Forecast |
| Transformer | NLP、テキスト生成 | Amazon Bedrock(LLM) |
| GAN(敵対的生成ネットワーク) | 新しいデータ(画像)の生成 | — |
5. モデル評価の概念
5.1. 過学習 vs 未学習
| 問題 | 訓練精度 | テスト精度 | 原因 | 解決策 |
|---|---|---|---|---|
| 過学習 | 非常に高い | 低い | モデルが訓練データを暗記 | データの追加、正則化、ドロップアウト、早期終了 |
| 未学習 | 低い | 低い | モデルが単純すぎる | 特徴量の追加、より複雑なモデル、訓練時間の延長 |
| 良好なフィット | 高い | 高い | バランスの取れた複雑さ | — |
5.2. バイアス-バリアンスのトレードオフ
- 高バイアス = 未学習(モデルが単純すぎてパターンを見逃す)
- 高バリアンス = 過学習(モデルが複雑すぎてノイズに敏感)
- 目標:バイアスとバリアンスの最適なバランスを見つけること
5.3. 一般的な評価指標
分類の指標:
| 指標 | 計算式 | 使用場面 |
|---|---|---|
| 正解率 | (TP + TN) / 全体 | バランスの取れたクラス |
| 適合率 | TP / (TP + FP) | 「正常なものをスパムと判定しない」 |
| 再現率 | TP / (TP + FN) | 「不正を見逃さない」 |
| F1スコア | 2 × (P × R) / (P + R) | 不均衡なクラス |
| AUC-ROC | ROC曲線下面積 | 二値分類全般 |
回帰の指標:
- RMSE(二乗平均平方根誤差):大きな誤差にペナルティ
- MAE(平均絶対誤差):平均的な誤差の大きさ
- R²:モデルが分散をどれだけ説明できるか(1.0 = 完璧)
6. 重要用語チートシート
| 用語 | 定義(試験用) |
|---|---|
| 特徴量 | 予測に使用される入力変数(データの列) |
| ラベル / ターゲット | モデルに予測させたい答え |
| ハイパーパラメータ | 訓練前に設定する設定値(学習率、エポック数) |
| パラメータ | 訓練中にモデルが学習する値(重み、バイアス) |
| エポック | 訓練データセット全体を1回通過すること |
| バッチサイズ | 重みを更新する前に処理するサンプル数 |
| 推論 | 訓練済みモデルを使って新しいデータの予測を行うこと |
| 転移学習 | 事前訓練済みモデルを新しいタスクに適応させること |
7. 練習問題
Q1:ある企業が、顧客がサブスクリプションを解約するかどうか(はい/いいえ)を予測したいと考えています。最も適切なMLアプローチはどれですか?
- A) 教師なし学習 — クラスタリング
- B) 教師あり学習 — 回帰
- C) 教師あり学習 — 分類 ✓
- D) 強化学習
解説:ラベル付きの履歴データを用いて二値の結果(はい/いいえ)を予測する = 教師あり分類。
Q2:小売企業が購買データを持っていますが、事前定義されたグループはありません。ターゲットマーケティングのために顧客をグループに分けたいと考えています。どのアプローチを使用すべきですか?
- A) 教師あり学習 — 分類
- B) 教師なし学習 — クラスタリング ✓
- C) 強化学習
- D) 教師あり学習 — 回帰
解説:ラベルなし + データ内の自然なグループを発見 = 教師なしクラスタリング。
Q3:あるモデルが訓練データで非常に良いパフォーマンス(精度99%)を示しますが、新しいデータでは低い結果(精度65%)となります。これは何と呼ばれますか?
- A) 未学習
- B) 過学習 ✓
- C) 高バイアス
- D) 正則化
解説:高い訓練精度 + 低いテスト精度 = 過学習(モデルが訓練データを暗記した)。