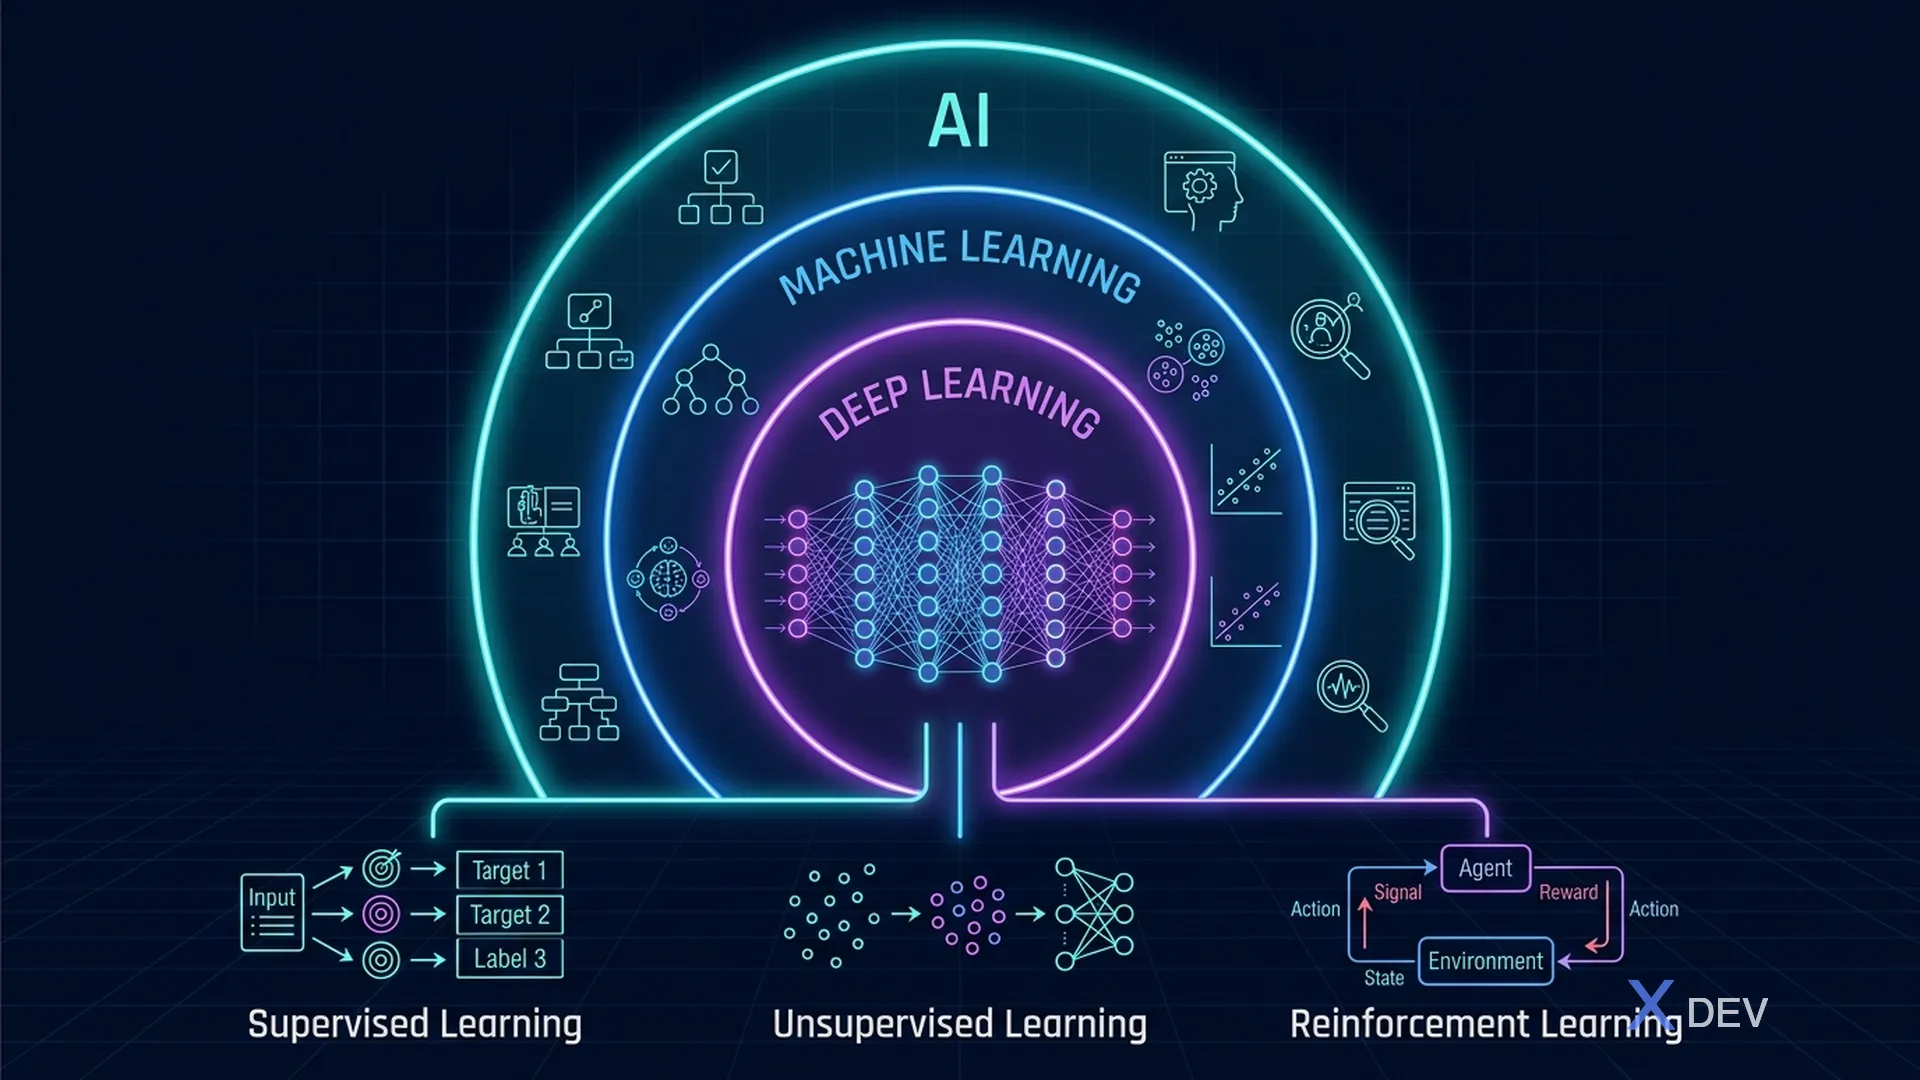
AI、ML與深度學習 — 巢狀關係與三大機器學習範式
領域1概覽
領域1佔AIF-C01考試的20%。您需要理解AI、ML和深度學習的基礎概念 — 不需要編程,但必須能區分何時使用哪種方法。
考試提示:此領域經常出現「哪種機器學習類型最適合...」這類問題 — 要求您為給定的使用案例選擇正確的範式。
1. AI vs 機器學習 vs 深度學習
這三個概念具有巢狀關係:
┌─────────────────────────────────────────────┐
│  人工智慧(AI)                               │
│  「模擬人類智慧的機器」                         │
│  ┌───────────────────────────────────────┐   │
│  │  機器學習(ML)                        │   │
│  │  「無需明確程式設計即可從資料中學習」      │   │
│  │  ┌─────────────────────────────────┐  │   │
│  │  │  深度學習(DL)                  │  │   │
│  │  │  「具有多層的神經網路」            │  │   │
│  │  └─────────────────────────────────┘  │   │
│  └───────────────────────────────────────┘   │
└─────────────────────────────────────────────┘
| 概念 | 定義 | 範例 |
|---|---|---|
| AI | 廣義領域 — 機器執行通常需要人類智慧的任務 | 聊天機器人、自動駕駛車、棋盤引擎 |
| ML | AI的子集 — 演算法從資料中學習模式 | 垃圾郵件過濾器、推薦引擎 |
| DL | ML的子集 — 具有多層的神經網路 | 影像辨識、語言翻譯 |
考試關鍵區別
- 傳統程式設計:規則 + 資料 → 輸出
- 機器學習:資料 + 輸出 → 規則(模型學習規則)
- 深度學習:自動從原始資料中提取特徵(無需手動特徵工程)
2. 三大ML範式
2.1. 監督式學習
模型從標記資料中學習 — 每個輸入都帶有正確的輸出(標籤/目標)。
| 任務類型 | 輸出 | 使用案例 | 演算法 |
|---|---|---|---|
| 分類 | 離散類別 | 垃圾郵件 vs 非垃圾郵件、欺詐偵測 | 邏輯迴歸、隨機森林、SVM |
| 迴歸 | 連續數值 | 房價預測、股票預測 | 線性迴歸、XGBoost |
考試提示:如果題目說「預測類別」或「分類」→ 分類。如果說「預測數值」→ 迴歸。
2.2. 非監督式學習
模型從未標記資料中學習 — 自行發現資料中的模式和結構。
| 任務類型 | 功能 | 使用案例 |
|---|---|---|
| 聚類 | 將相似的資料點分組 | 客戶分群、文件分組 |
| 降維 | 在保留資訊的同時減少特徵 | 資料視覺化、雜訊減少 |
| 異常偵測 | 發現不尋常的資料點 | 欺詐偵測、設備故障 |
| 關聯 | 發現項目之間的規則 | 「買了X的客戶也買了Y」 |
2.3. 強化學習(RL)
代理在環境中通過試錯學習。每個行動獲得獎勵(正面)或懲罰(負面)。
代理 → 行動 → 環境 → 狀態 + 獎勵 → 代理(循環)
使用案例:
- 遊戲AI(AlphaGo)
- 機器人導航
- 自動駕駛
- AWS DeepRacer(自動駕駛車模擬)
2.4. 選擇正確的範式 — 考試決策樹
您有標記資料嗎?
├── 是 → 監督式學習
│   ├── 預測類別?→ 分類
│   └── 預測數值?→ 迴歸
├── 否 →
│   ├── 想尋找分組/模式?→ 非監督式學習(聚類)
│   └── 通過試錯學習?→ 強化學習
3. ML的資料概念
3.1. 資料類型
| 類型 | 描述 | 範例 |
|---|---|---|
| 結構化 | 組織成行列(表格式) | CSV、資料庫表格、試算表 |
| 半結構化 | 有一定組織但靈活 | JSON、XML、日誌檔案 |
| 非結構化 | 無預定義格式 | 影像、影片、音訊、自由文字 |
| 時間序列 | 按時間索引的資料點 | 股價、IoT感測器讀數 |
3.2. 標記 vs 未標記資料
- 標記資料:每個資料點都有對應的答案(標籤)。範例:郵件 + 標記「垃圾郵件」/「非垃圾郵件」。用於監督式學習。
- 未標記資料:只有資料,沒有標籤。用於非監督式學習。
- Amazon SageMaker Ground Truth:幫助標記資料的AWS服務(人工 + ML輔助標記)。
3.3. 訓練集、驗證集、測試集
┌────────────────────────────────────────────────┐
│              完整資料集 (100%)                    │
├──────────────────┬──────────┬──────────────────┤
│  訓練集 (70%)     │ 驗證(15%)│   測試集 (15%)    │
│  模型從此資料      │ 調整     │ 最終評估          │
│  中學習           │ 超參數   │ (訓練中從未見過)  │
└──────────────────┴──────────┴──────────────────┘
- 訓練集:模型從此資料中學習模式
- 驗證集:用於調整超參數和防止過擬合
- 測試集:最終評估 — 模型從未見過此資料
4. 神經網路基礎
4.1. 架構
輸入層 → 隱藏層 → 輸出層
    x₁ ──┐     ┌── h₁ ──┐
    x₂ ──┼─────┼── h₂ ──┼──── ŷ(預測)
    x₃ ──┘     └── h₃ ──┘

每個連接都有一個權重 (w)
每個神經元應用一個啟動函數
關鍵組件:
- 權重:模型在訓練期間學習的參數
- 偏差:用於移動啟動函數的額外參數
- 啟動函數:ReLU、Sigmoid、Softmax — 引入非線性
- 損失函數:衡量模型預測的錯誤程度
- 優化器:更新權重以最小化損失(如SGD、Adam)
4.2. 神經網路類型
| 類型 | 最適用於 | AWS服務 |
|---|---|---|
| CNN(卷積神經網路) | 影像、影片 | Amazon Rekognition |
| RNN/LSTM(循環神經網路) | 序列資料、時間序列 | Amazon Forecast |
| Transformer | NLP、文字生成 | Amazon Bedrock(LLM) |
| GAN(生成對抗網路) | 生成新資料(影像) | — |
5. 模型評估概念
5.1. 過擬合 vs 欠擬合
| 問題 | 訓練準確率 | 測試準確率 | 原因 | 解決方案 |
|---|---|---|---|---|
| 過擬合 | 非常高 | 低 | 模型記住了訓練資料 | 更多資料、正則化、dropout、早停 |
| 欠擬合 | 低 | 低 | 模型太簡單 | 更多特徵、更複雜的模型、更長的訓練 |
| 良好擬合 | 高 | 高 | 複雜度平衡 | — |
5.2. 偏差-方差權衡
- 高偏差 = 欠擬合(模型太簡單,遺漏模式)
- 高方差 = 過擬合(模型太複雜,對雜訊敏感)
- 目標:找到偏差與方差之間的最佳平衡點
5.3. 常用指標
分類指標:
| 指標 | 公式 | 何時使用 |
|---|---|---|
| 準確率 | (TP + TN) / 總數 | 類別平衡 |
| 精確率 | TP / (TP + FP) | 「不要將正常郵件標記為垃圾郵件」 |
| 召回率 | TP / (TP + FN) | 「不要遺漏任何欺詐」 |
| F1分數 | 2 × (P × R) / (P + R) | 類別不平衡 |
| AUC-ROC | ROC曲線下面積 | 整體二元分類 |
迴歸指標:
- RMSE(均方根誤差):懲罰大的誤差
- MAE(平均絕對誤差):平均誤差幅度
- R²:模型解釋方差的能力(1.0 = 完美)
6. 關鍵術語速查表
| 術語 | 定義(考試用) |
|---|---|
| 特徵 | 用於預測的輸入變數(資料中的欄位) |
| 標籤/目標 | 我們希望模型預測的答案 |
| 超參數 | 訓練前配置的設定(學習率、epoch數) |
| 參數 | 模型在訓練期間學習的值(權重、偏差) |
| Epoch | 對整個訓練資料集的一次完整遍歷 |
| 批次大小 | 更新權重前處理的樣本數 |
| 推論 | 使用訓練好的模型對新資料進行預測 |
| 遷移學習 | 使用預訓練模型並將其適應到新任務 |
7. 練習題
Q1:一家公司想要預測客戶是否會取消訂閱(是/否)。哪種ML方法最合適?
- A) 非監督式學習 — 聚類
- B) 監督式學習 — 迴歸
- C) 監督式學習 — 分類 ✓
- D) 強化學習
解說:使用標記的歷史資料預測二元結果(是/否)= 監督式分類。
Q2:一家零售公司有客戶購買資料,但沒有預定義的分組。他們想將客戶分為幾個群組以進行精準行銷。應該使用哪種方法?
- A) 監督式學習 — 分類
- B) 非監督式學習 — 聚類 ✓
- C) 強化學習
- D) 監督式學習 — 迴歸
解說:沒有標籤 + 尋找資料中的自然分組 = 非監督式聚類。
Q3:一個模型在訓練資料上表現極好(99%準確率),但在新資料上表現不佳(65%準確率)。這叫什麼?
- A) 欠擬合
- B) 過擬合 ✓
- C) 高偏差
- D) 正則化
解說:高訓練準確率 + 低測試準確率 = 過擬合(模型記住了訓練資料)。