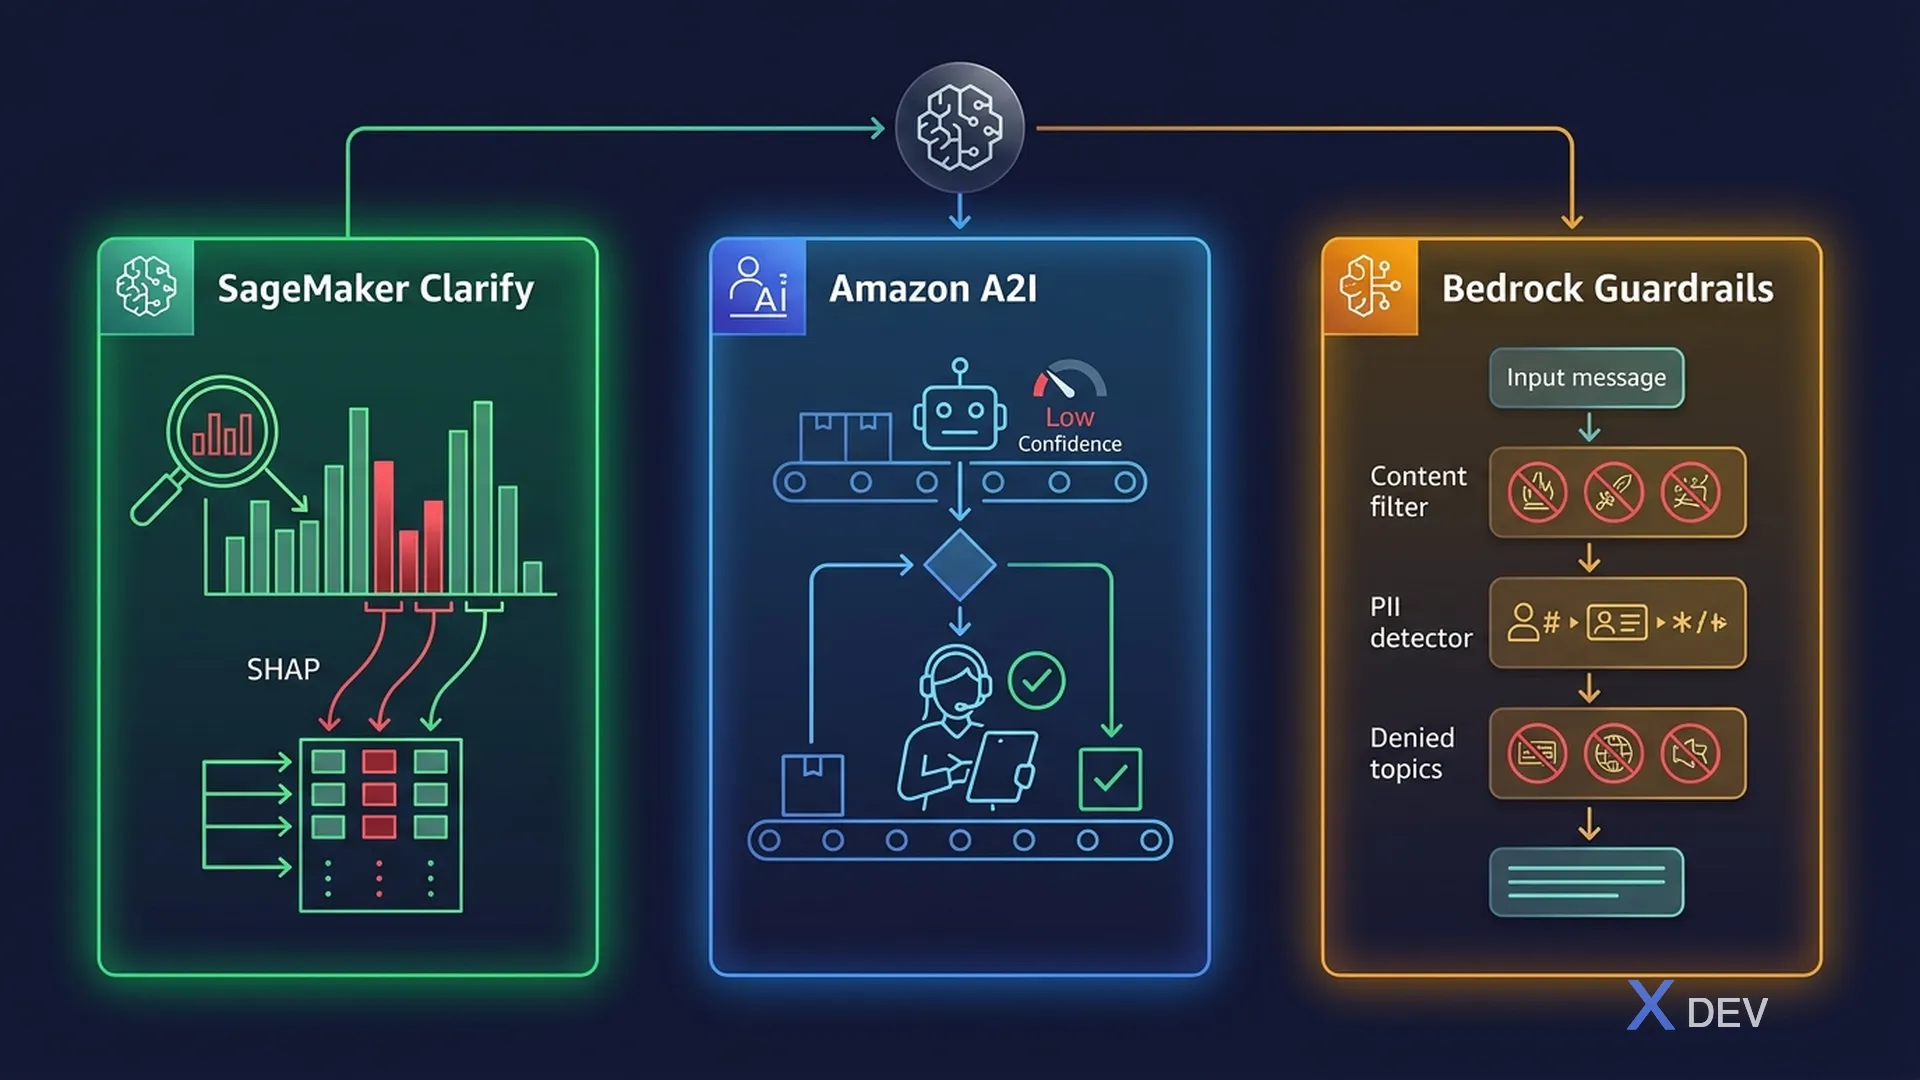
AWS責任あるAIツール:SageMaker Clarify、Amazon A2I、Bedrock Guardrails
1. Amazon SageMaker Clarify
SageMaker Clarifyは、データとモデルのバイアスを検出し、モデルの説明可能性を提供します — 責任あるAIのためのAWSの中核サービスです。
1.1. 3つのコア機能
| 機能 | タイミング | 内容 |
|---|---|---|
| トレーニング前バイアス検出 | トレーニング前 | 人口統計グループ間のトレーニングデータの不均衡を検出 |
| トレーニング後バイアス検出 | トレーニング後 | モデル予測のバイアスを検出(例:グループ間の精度の違い) |
| 説明可能性(SHAP) | トレーニング後 | 各予測への特徴量の寄与を表示 |
1.2. Clarifyの主要バイアス指標
| 指標 | トレーニング前/後 | 測定内容 |
|---|---|---|
| クラス不均衡(CI) | トレーニング前 | グループ間のクラス分布 |
| 比率の差(DPL) | トレーニング前 | グループ間の正ラベルの比率 |
| KLダイバージェンス | トレーニング前 | グループ間の分布の乖離 |
| 不均衡影響(DI) | トレーニング後 | グループ間の正予測の比率 |
| 精度の差(AD) | トレーニング後 | グループ間の精度のギャップ |
| 処遇均等性(TE) | トレーニング後 | グループ間のFPとFNの比率 |
1.3. Clarifyのワークフロー
1. Clarifyジョブの設定
   ├── センシティブ属性を指定(性別、年齢、人種)
   ├── ファセット(比較するグループ)を定義
   └── 計算するバイアス指標を選択

2. トレーニング前分析の実行
   ├── トレーニングデータセットのアップロード
   └── データ分布のバイアスレポートを取得

3. モデルのトレーニング

4. トレーニング後分析の実行
   ├── グループ間の予測を比較
   └── 説明可能性のためのSHAP値を取得

5. SageMaker Model Monitorで監視
   └── 本番環境でのバイアスドリフトを経時的に検出
試験のポイント:「モデルが特定の人種グループに対してより多くのエラーを出しているかどうかを検出するAWSサービスは?」→ SageMaker Clarify(トレーニング後バイアス検出)。
2. Amazon Augmented AI(Amazon A2I)
Amazon A2Iは、AI予測のためのヒューマンインザループ(HITL)ワークフローを提供します — モデルの信頼度が低い場合や重要な判断に特に有用です。
2.1. A2Iの仕組み
A2IによるAI予測フロー:
                                          ┌─────────────┐
ユーザーリクエスト → AIモデル → 確信あり? YES → 結果を返す
                                 │
                                 NO(閾値以下)
                                 ↓
                        ┌──────────────────┐
                        │  人間レビュー     │
                        │  タスクを作成     │
                        │ (A2Iワークフロー)│
                        └────────┬─────────┘
                                 ↓
                        ┌──────────────────┐
                        │  人間のレビューアー│ ← AWS Mechanical Turk
                        │  がレビュー&     │ ← プライベートワークフォース
                        │  修正             │ ← サードパーティベンダー
                        └────────┬─────────┘
                                 ↓
                        人間が検証した結果を返す
2.2. A2Iのコンポーネント
| コンポーネント | 目的 |
|---|---|
| ヒューマンレビューワークフロー | いつ、どのように人間レビューをトリガーするかを定義 |
| ワーカータスクテンプレート | 人間レビューアーが判断するためのUI |
| ワークフォース | レビューする人(プライベート、Mechanical Turk、ベンダー) |
| アクティベーション条件 | 信頼度閾値トリガー(例:< 95%) |
2.3. 組み込みA2I統合
| サービス | A2Iのユースケース |
|---|---|
| Amazon Textract | 低信頼度のドキュメント抽出をレビュー |
| Amazon Rekognition | 低信頼度のコンテンツモデレーションをレビュー |
| カスタムMLモデル | 任意のSageMakerモデルがA2Iをトリガー可能 |
試験のポイント:「ヘルスケア企業がモデルの信頼度が90%未満の場合にAI診断を人間がレビューする必要がある」→ 信頼度 < 90%のアクティベーション条件を設定したAmazon A2I。
3. Amazon Bedrock Guardrails — 詳細解説
3.1. Guardrailポリシー
| ポリシー | 仕組み | 設定 |
|---|---|---|
| コンテンツフィルタ | カテゴリ + 重大度でブロック | 各カテゴリ(ヘイト、侮辱、性的、暴力、不正行為)にNone/Low/Medium/High |
| 禁止トピック | ブロックするトピックを定義 | 自然言語の説明 + サンプルフレーズ |
| ワードフィルタ | 特定の単語をブロック | カスタム単語/フレーズリスト + 冒涜フィルタトグル |
| 機密情報(PII) | PIIを検出してアクション | 各PIIタイプ(SSN、メール、電話、名前、住所等)にBLOCKまたはANONYMIZE |
| コンテキストグラウンディング | 回答がグラウンドされているか確認 | グラウンディング閾値(0-1)+ 関連性閾値 |
3.2. Guardrailsのリクエスト処理フロー
ユーザー入力
    ↓
[入力GUARDRAILS]
    ├── コンテンツフィルタチェック
    ├── 禁止トピックチェック
    ├── ワードフィルタチェック
    ├── PII検出 → BLOCKまたはANONYMIZE
    ↓(すべてのチェックを通過した場合)
基盤モデルがレスポンスを生成
    ↓
[出力GUARDRAILS]
    ├── コンテンツフィルタチェック
    ├── 禁止トピックチェック
    ├── ワードフィルタチェック
    ├── PII検出 → BLOCKまたはANONYMIZE
    ├── コンテキストグラウンディングチェック
    ↓(すべてのチェックを通過した場合)
レスポンスをユーザーに返す

ブロックされた場合 → 設定された「ブロック」メッセージを返す
3.3. Guardrails vs システムプロンプト
| 側面 | システムプロンプト | Guardrails |
|---|---|---|
| 強制力 | ソフト — モデルが無視する可能性 | ハード — プラットフォームが強制 |
| バイパスリスク | プロンプトインジェクションでバイパス可能 | プロンプトではバイパス不可 |
| PII処理 | モデルにPIIを出力しないよう要求 | プログラム的な検出と秘匿化 |
| 監査可能性 | 限定的 | 完全なログとメトリクス |
試験のポイント:「モデルの回答にPIIが含まれないことを保証する必要がある」→ Bedrock Guardrails(バイパス可能なシステムプロンプトではなく)。
4. AWS上のコンテンツモデレーション
| サービス | コンテンツタイプ | ユースケース |
|---|---|---|
| Amazon Rekognition | 画像&動画 | 不適切なコンテンツ、顔、テキストの検出 |
| Amazon Comprehend | テキスト | 毒性検出、感情分析 |
| Bedrock Guardrails | FM入出力 | GenAIアプリでの有害コンテンツのフィルタ |
| Amazon A2I | すべて | エッジケースの人間レビュー |
5. AIガバナンス
5.1. ガバナンスフレームワーク
| 領域 | 実装内容 |
|---|---|
| ポリシー | 組織全体のAI倫理ガイドライン |
| リスク評価 | AIシステムのデプロイ前にリスクを評価 |
| 監視 | バイアス、パフォーマンスドリフトの継続的監視 |
| 監査証跡 | 説明責任のためにすべてのモデル判断を記録 |
| 人間の監視 | 重要な判断へのヒューマンインザループ |
| ドキュメント | モデルカード、AIサービスカード |
5.2. SageMaker MLガバナンス
- SageMakerモデルカード:モデルの詳細と想定される使用方法を文書化
- SageMakerモデルダッシュボード:すべてのモデルステータスの一元的ビュー
- SageMaker Model Monitor:データドリフト、モデル品質劣化の検出
- SageMaker Role Manager:ML用のきめ細かなアクセス制御
6. 練習問題
Q1:保険会社が、保険金請求承認モデルがすべての年齢の顧客を公平に扱うことを確認したいと考えています。モデルの予測における年齢ベースのバイアスを検出するために使用すべきAWSサービスはどれですか?
- A) Amazon Rekognition
- B) Amazon SageMaker Clarify ✓
- C) Amazon Bedrock Guardrails
- D) Amazon Comprehend
解説:SageMaker Clarifyは、Disparate ImpactやAccuracy Differenceなどの指標を使用して、年齢グループ間のモデル予測を比較するトレーニング後バイアス分析を実行できます。
Q2:Amazon Textractを使用したドキュメント処理アプリケーションで、抽出されたデータの信頼度が低い場合に人間のレビューが必要です。この機能を提供するAWSサービスはどれですか?
- A) Amazon SageMaker Ground Truth
- B) Amazon Augmented AI(A2I) ✓
- C) Amazon Mechanical Turkを直接使用
- D) Amazon Bedrock Agents
解説:Amazon A2IはAmazon Textractとの組み込み統合を持ち、抽出信頼度が定義された閾値を下回った場合に自動的に人間レビューワークフローをトリガーできます。
Q3:チャットボットが、ナレッジベースにデータが存在する場合でも、顧客のクレジットカード番号を回答に絶対に表示してはなりません。最も強力な保証を提供するアプローチはどれですか?
- A) システムプロンプトに「クレジットカード番号を出力しない」を追加
- B) PIIを出力しないようにモデルをファインチューニング
- C) PIIフィルタをBLOCKに設定したAmazon Bedrock Guardrailsを使用 ✓
- D) ナレッジベースからクレジットカード番号を削除
解説:PIIフィルタ付きのBedrock Guardrailsは、入力と出力の両方でクレジットカード番号のプログラム的な検出とブロックを提供します — システムプロンプトとは異なり、プロンプトインジェクションでバイパスされません。