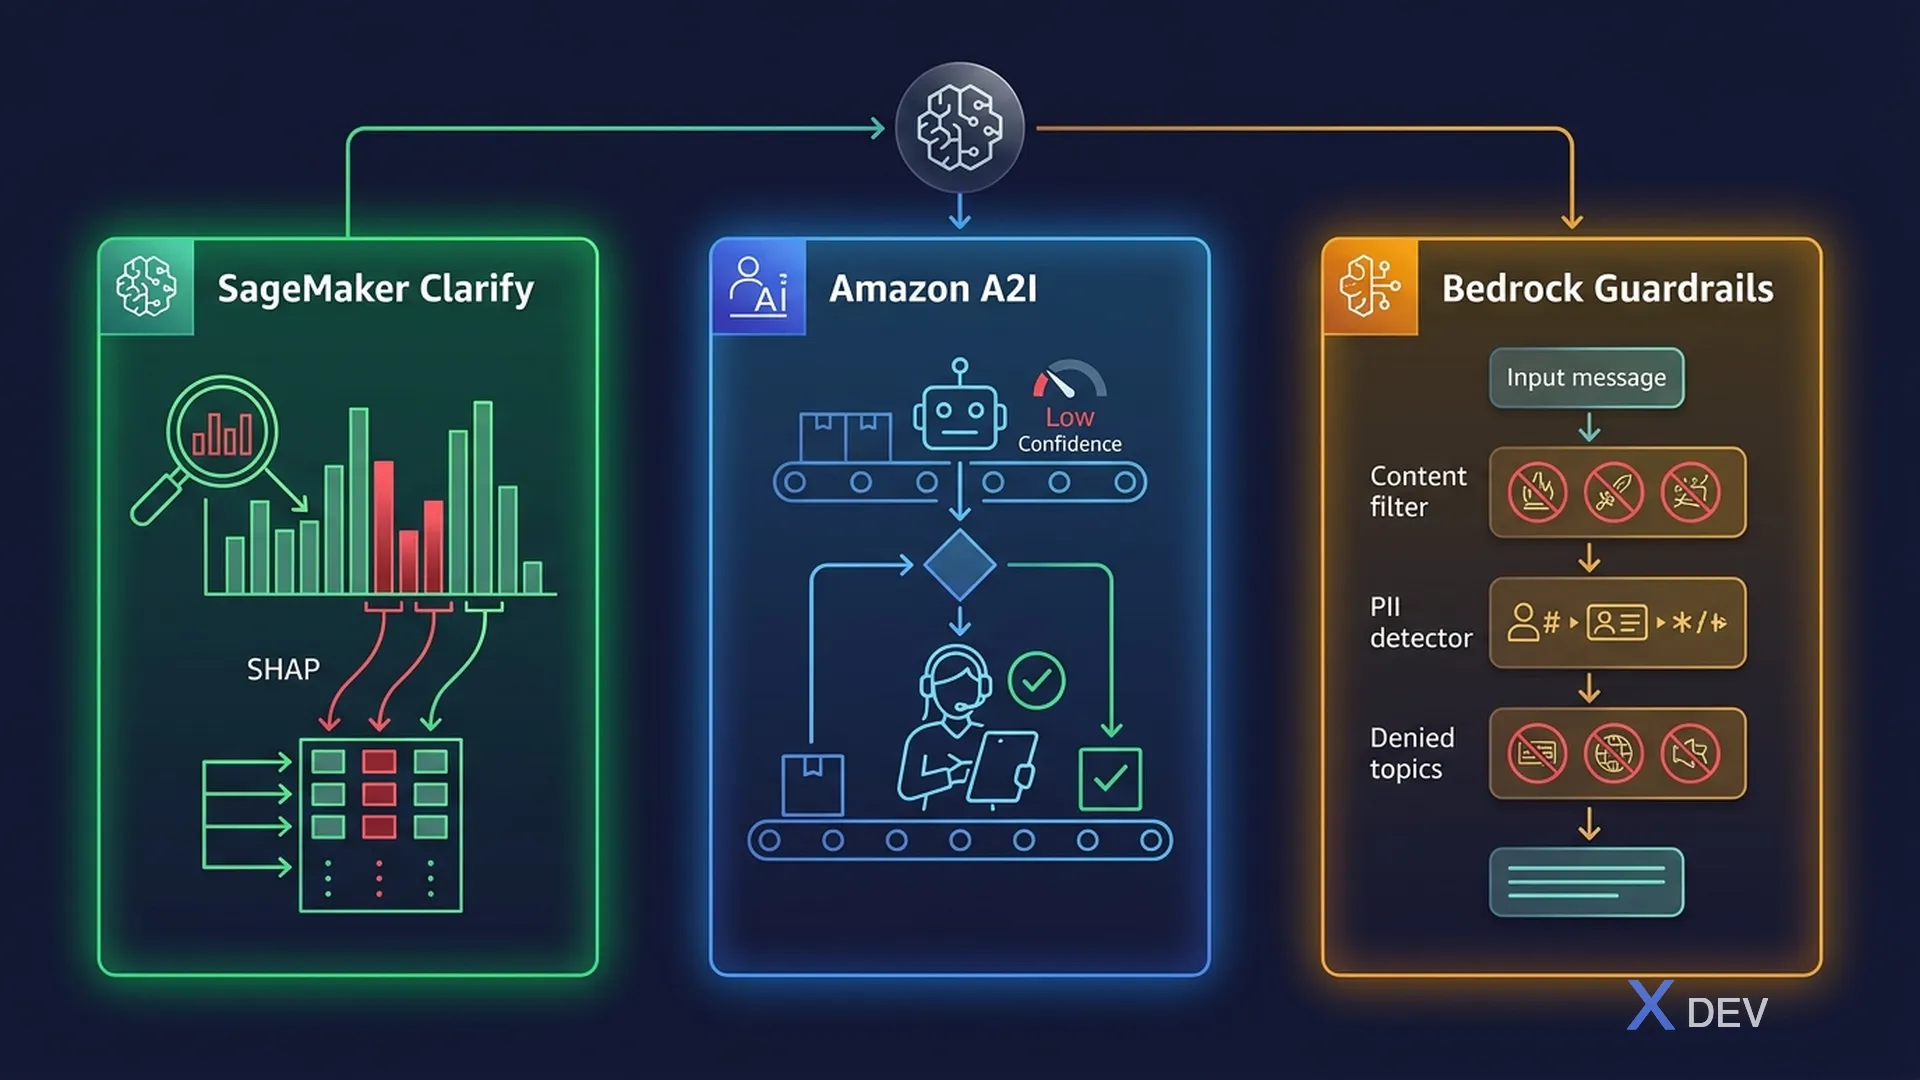
AWS負責任AI工具:SageMaker Clarify、Amazon A2I和Bedrock Guardrails
1. Amazon SageMaker Clarify
SageMaker Clarify幫助偵測資料和模型中的偏差,並提供模型可解釋性——是負責任AI的首選AWS服務。
1.1. 三大核心功能
| 功能 | 時機 | 作用 |
|---|---|---|
| 訓練前偏差偵測 | 訓練前 | 偵測訓練資料中各人口群體的不平衡 |
| 訓練後偏差偵測 | 訓練後 | 偵測模型預測中的偏差(例如各群體之間準確率不同) |
| 可解釋性(SHAP) | 訓練後 | 顯示每個特徵對各預測的貢獻 |
1.2. Clarify中的關鍵偏差指標
| 指標 | 訓練前/後 | 衡量內容 |
|---|---|---|
| 類別不平衡(CI) | 訓練前 | 各群體中類別的分佈 |
| 比例差異(DPL) | 訓練前 | 各群體中正面標記的比例 |
| KL散度 | 訓練前 | 群體間的分佈偏離 |
| 差異性影響(DI) | 訓練後 | 各群體中正面預測的比率 |
| 準確率差異(AD) | 訓練後 | 群體間的準確率差距 |
| 處理均等(TE) | 訓練後 | 各群體中FP與FN的比率 |
1.3. Clarify工作流程
1. 設定Clarify作業
   ├── 指定敏感屬性(性別、年齡、種族)
   ├── 定義分面(要比較的群體)
   └── 選擇要計算的偏差指標

2. 執行訓練前分析
   ├── 上傳訓練資料集
   └── 取得資料分佈的偏差報告

3. 訓練模型

4. 執行訓練後分析
   ├── 比較各群體的預測
   └── 取得可解釋性的SHAP值

5. 使用SageMaker Model Monitor監控
   └── 偵測生產環境中偏差隨時間的漂移
考試提示:「哪個AWS服務可以偵測模型是否對某個種族群體產生更多錯誤?」→ SageMaker Clarify(訓練後偏差偵測)。
2. Amazon Augmented AI(Amazon A2I)
Amazon A2I為AI預測提供人在迴路(HITL)工作流程——特別重要於模型信心低或高風險決策的場景。
2.1. A2I運作方式
帶有A2I的AI預測流程:
                                          ┌─────────────┐
使用者請求 → AI模型 → 有信心?  是 → 回傳結果
                              │
                              否(低於閾值)
                              ↓
                     ┌──────────────────┐
                     │  建立人工         │
                     │  審查任務         │
                     │  (A2I工作流程)   │
                     └────────┬─────────┘
                              ↓
                     ┌──────────────────┐
                     │  人工審查員       │  ← AWS Mechanical Turk
                     │  審查與           │  ← 私人工作團隊
                     │  修正             │  ← 第三方供應商
                     └────────┬─────────┘
                              ↓
                     回傳人工驗證的結果
2.2. A2I組件
| 組件 | 用途 |
|---|---|
| 人工審查工作流程 | 定義何時及如何觸發人工審查 |
| 工作者任務範本 | 人工審查員做決策的UI |
| 工作團隊 | 由誰進行審查(私人、Mechanical Turk、供應商) |
| 啟動條件 | 信心閾值觸發(例如 < 95%) |
2.3. A2I內建整合
| 服務 | A2I用途 |
|---|---|
| Amazon Textract | 審查低信心的文件擷取 |
| Amazon Rekognition | 審查低信心的內容審核 |
| 自訂ML模型 | 任何SageMaker模型都可觸發A2I |
考試提示:「一家醫療公司需要在模型信心低於90%時由人工審查AI診斷」→ Amazon A2I,啟動條件設為信心 < 90%。
3. Amazon Bedrock Guardrails——深度剖析
3.1. Guardrail策略
| 策略 | 運作方式 | 設定 |
|---|---|---|
| 內容過濾器 | 按類別+嚴重程度封鎖 | 每個類別設定無/低/中/高(仇恨、侮辱、色情、暴力、不當行為) |
| 禁止主題 | 封鎖特定主題 | 自然語言描述+範例短語 |
| 詞彙過濾器 | 封鎖特定詞語 | 自訂詞語/短語列表+不雅詞過濾器開關 |
| 敏感資訊(PII) | 偵測PII並採取行動 | 每種PII類型設定封鎖或匿名化(SSN、電子郵件、電話、姓名、地址等) |
| 上下文基礎 | 檢查回答是否基於上下文 | 基礎閾值(0-1)+相關性閾值 |
3.2. Guardrails處理請求的方式
使用者輸入
    ↓
[輸入Guardrails]
    ├── 內容過濾器檢查
    ├── 禁止主題檢查
    ├── 詞彙過濾器檢查
    ├── PII偵測 → 封鎖或匿名化
    ↓(如果通過所有檢查)
基礎模型生成回應
    ↓
[輸出Guardrails]
    ├── 內容過濾器檢查
    ├── 禁止主題檢查
    ├── 詞彙過濾器檢查
    ├── PII偵測 → 封鎖或匿名化
    ├── 上下文基礎檢查
    ↓(如果通過所有檢查)
回應回傳給使用者

如果被封鎖 → 回傳設定的「封鎖」訊息
3.3. Guardrails vs 系統提示
| 面向 | 系統提示 | Guardrails |
|---|---|---|
| 執行方式 | 軟性——模型可能忽略 | 硬性——由平台強制執行 |
| 繞過風險 | 可透過提示注入繞過 | 無法被提示繞過 |
| PII處理 | 要求模型不輸出PII | 程式化偵測與遮蔽 |
| 可稽核性 | 有限 | 完整的日誌和指標 |
考試提示:「一家公司需要保證PII永遠不會出現在模型回應中」→ Bedrock Guardrails(非系統提示,因為系統提示可以被繞過)。
4. AWS上的內容審核
| 服務 | 內容類型 | 用途 |
|---|---|---|
| Amazon Rekognition | 圖像與影片 | 偵測不當內容、人臉、文字 |
| Amazon Comprehend | 文字 | 毒性偵測、情感分析 |
| Bedrock Guardrails | FM輸入/輸出 | 在生成式AI應用中過濾有害內容 |
| Amazon A2I | 任何 | 邊緣案例的人工審查 |
5. AI治理
5.1. 治理框架
| 領域 | 應實施的內容 |
|---|---|
| 政策 | 組織範圍的AI倫理準則 |
| 風險評估 | 部署AI系統前評估風險 |
| 監控 | 持續監控偏差、效能漂移 |
| 稽核軌跡 | 記錄所有模型決策以確保問責 |
| 人工監督 | 高風險決策採用人在迴路 |
| 文件記錄 | 模型卡片、AI Service Cards |
5.2. SageMaker ML治理
- SageMaker模型卡片:記錄模型詳情和預期用途
- SageMaker模型儀表板:所有模型狀態的集中視圖
- SageMaker Model Monitor:偵測資料漂移、模型品質下降
- SageMaker Role Manager:ML的細粒度存取控制
6. 練習題
Q1:一家保險公司想確保其理賠審核模型公平對待所有年齡的客戶。他們應該使用哪個AWS服務來偵測模型預測中的年齡偏差?
- A) Amazon Rekognition
- B) Amazon SageMaker Clarify ✓
- C) Amazon Bedrock Guardrails
- D) Amazon Comprehend
解說:SageMaker Clarify可以執行訓練後偏差分析,使用差異性影響和準確率差異等指標來比較各年齡群體的模型預測。
Q2:一個使用Amazon Textract的文件處理應用程式,需要在擷取資料信心低時進行人工審查。哪個AWS服務提供此功能?
- A) Amazon SageMaker Ground Truth
- B) Amazon Augmented AI(A2I) ✓
- C) 直接使用Amazon Mechanical Turk
- D) Amazon Bedrock Agents
解說:Amazon A2I與Amazon Textract有內建整合,當擷取信心低於定義的閾值時可自動觸發人工審查工作流程。
Q3:一個聊天機器人必須永遠不在回應中揭露客戶的信用卡號碼,即使資料存在於知識庫中。哪種方法提供最強的保證?
- A) 在系統提示中加入「絕不輸出信用卡號碼」
- B) 微調模型使其不輸出PII
- C) 使用Amazon Bedrock Guardrails並將PII過濾器設為封鎖 ✓
- D) 從知識庫中移除信用卡號碼
解說:Bedrock Guardrails的PII過濾器在輸入和輸出中都提供程式化的信用卡號碼偵測和封鎖——這無法被提示注入繞過,不像系統提示。